경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
“정황 증거는 매우 까다로운 것입니다. 그것은 한 가지를 매우 분명하게 가리키는 것처럼 보일 수 있지만, 관점을 조금만 바꾸면 전혀 다른 것을 가리키고 있음을 발견하게 될 수도 있습니다.” — 셜록 홈즈 (Sherlock Holmes)
이 책의 마지막인 24장에서는 한 걸음 물러서서 더 큰 그림을 봅니다. 단일 연구가 아무리 잘 설계되었어도 연구 하나만으로 인과적 주장을 확립하기는 어렵습니다. 과학적 지식은 단일 연구가 아닌 증거의 축적(accumulation of evidence)으로 구축됩니다.
24장에서는 인과 추론 맥락에서 증거를 평가하고, 여러 연구로부터 일관된 결론을 도출하는 방법을 탐구합니다.
삼각 측량(triangulation)은 서로 다른 방법, 데이터 출처, 가정을 활용해 동일한 인과적 질문에 접근하는 전략입니다. 서로 다른 접근법들이 동일한 결론을 내린다면 그 결론을 더 신뢰할 수 있습니다.
삼각 측량의 논리는 다음과 같습니다. 각 방법은 서로 다른 가정에 의존하며 편향의 원천도 다릅니다. 여러 방법이 같은 결론을 내린다면 그 결론은 특정 가정 위반에 덜 민감하다고 볼 수 있습니다.
library(dplyr)
library(ggplot2)
library(broom)
library(touringplans)
library(propensity)
library(ggokabeito)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  drop_na()

# 방법 1: IPTW (ATE)
ps_model <- glm(
  park_extra_magic_morning ~
    park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9,
  family = binomial()
)

seven_dwarfs_with_wt <- ps_model |>
  augment(type.predict = "response", data = seven_dwarfs_9) |>
  mutate(w_ate = wt_ate(.fitted, park_extra_magic_morning))

iptw_result <- lm(
  wait_minutes_posted_avg ~ park_extra_magic_morning,
  data = seven_dwarfs_with_wt,
  weights = w_ate
) |>
  tidy(conf.int = TRUE) |>
  filter(term == "park_extra_magic_morning") |>
  mutate(method = "IPTW (ATE)")

# 방법 2: IPTW (ATT)
seven_dwarfs_with_att <- ps_model |>
  augment(type.predict = "response", data = seven_dwarfs_9) |>
  mutate(w_att = wt_att(.fitted, park_extra_magic_morning))

att_result <- lm(
  wait_minutes_posted_avg ~ park_extra_magic_morning,
  data = seven_dwarfs_with_att,
  weights = w_att
) |>
  tidy(conf.int = TRUE) |>
  filter(term == "park_extra_magic_morning") |>
  mutate(method = "IPTW (ATT)")

# 방법 3: G-공식 (결과 모델)
outcome_model <- lm(
  wait_minutes_posted_avg ~
    park_extra_magic_morning *
    (park_ticket_season + park_close + park_temperature_high),
  data = seven_dwarfs_9
)

gcomp_ate <- mean(
  predict(outcome_model,
          newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 1)) -
  predict(outcome_model,
          newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 0))
)

gcomp_result <- tibble(
  term = "park_extra_magic_morning",
  estimate = gcomp_ate,
  conf.low = gcomp_ate - 1.96 * 3,  # 근사 SE (설명 목적)
  conf.high = gcomp_ate + 1.96 * 3,
  method = "G-공식"
)

# 방법 4: AIPW (이중 로버스트)
ps_hat <- predict(ps_model, type = "response")
mu1_hat <- predict(outcome_model,
                   newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 1))
mu0_hat <- predict(outcome_model,
                   newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 0))
Y <- seven_dwarfs_9$wait_minutes_posted_avg
A <- seven_dwarfs_9$park_extra_magic_morning

aipw_scores <- (mu1_hat - mu0_hat) +
  A * (Y - mu1_hat) / ps_hat -
  (1 - A) * (Y - mu0_hat) / (1 - ps_hat)

aipw_result <- tibble(
  term = "park_extra_magic_morning",
  estimate = mean(aipw_scores),
  conf.low = mean(aipw_scores) - 1.96 * sd(aipw_scores) / sqrt(length(aipw_scores)),
  conf.high = mean(aipw_scores) + 1.96 * sd(aipw_scores) / sqrt(length(aipw_scores)),
  method = "AIPW (이중 로버스트)"
)

# 결과 통합 및 시각화
all_results <- bind_rows(iptw_result, att_result, gcomp_result, aipw_result) |>
  mutate(method = factor(method, levels = c("IPTW (ATE)", "IPTW (ATT)",
                                            "G-공식", "AIPW (이중 로버스트)")))

ggplot(all_results, aes(x = estimate, y = method, color = method)) +
  geom_point(size = 4) +
  geom_errorbarh(aes(xmin = conf.low, xmax = conf.high), height = 0.2) +
  geom_vline(xintercept = 0, linetype = "dashed", alpha = 0.5) +
  scale_color_okabe_ito() +
  labs(
    x = "추정된 처치 효과 (분)",
    y = NULL,
    color = NULL,
    title = "삼각 측량: 여러 방법의 인과 효과 추정치 비교"
  ) +
  theme(legend.position = "none")
Warning: `geom_errorbarh()` was deprecated in ggplot2 4.0.0.
ℹ Please use the `orientation` argument of
`geom_errorbar()` instead.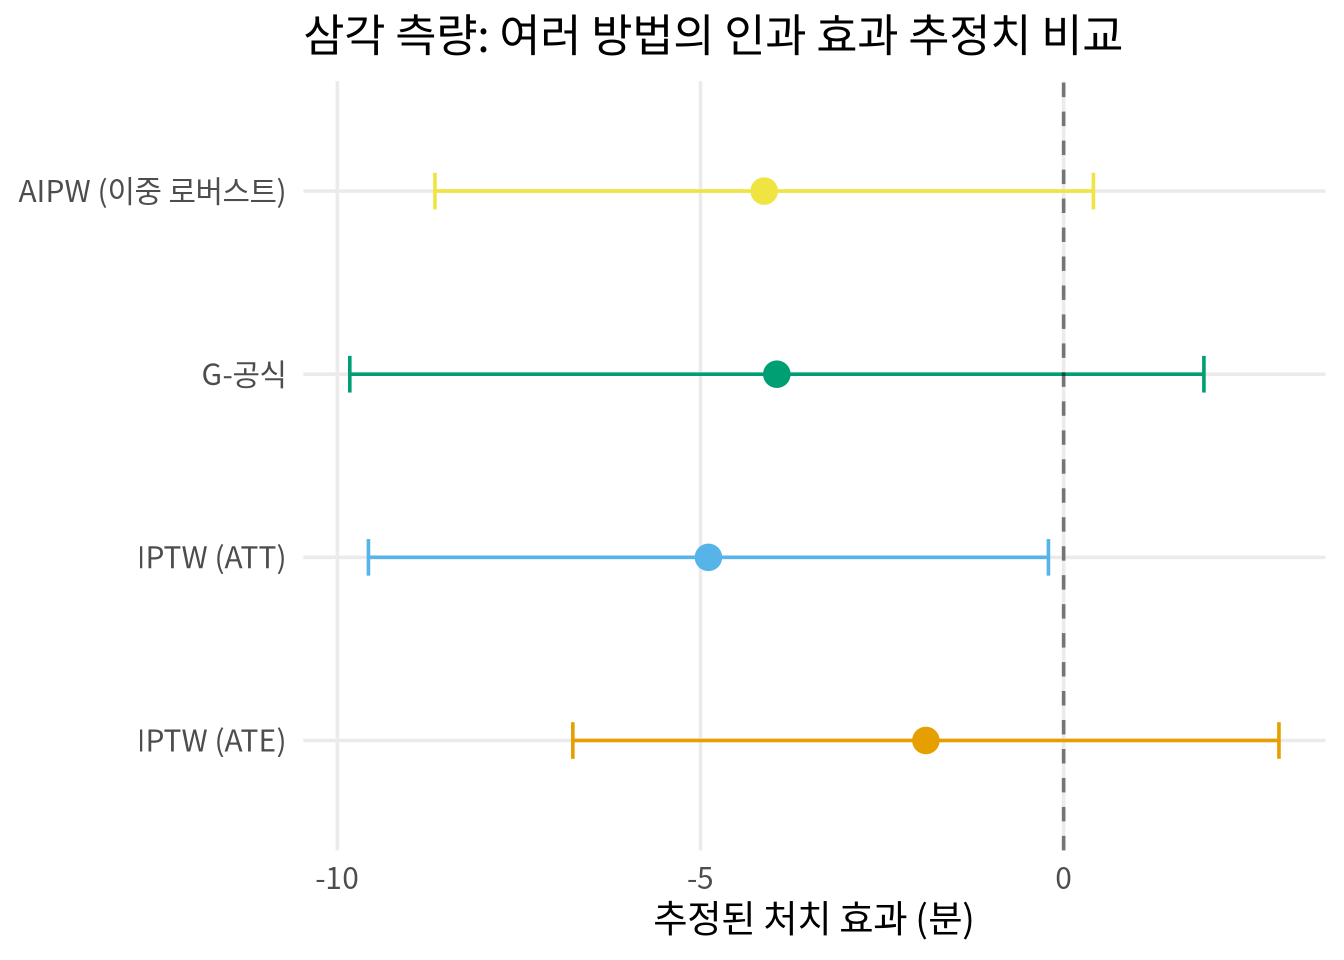
역학에서의 유명한 예시는 흡연과 폐암 사이의 인과관계 규명 과정입니다. 관찰 연구, 동물 실험, 메커니즘 연구, 자연 실험 등 다양한 접근법이 모두 같은 방향을 가리켰을 때, 과학자들은 인과관계를 확신하게 되었습니다.
Hill(1965)의 인과성 기준(Hill’s criteria)은 역학에서 인과성을 판단하는 전통적인 지침입니다:
library(gt)

tibble(
  기준 = c(
    "강도 (Strength)",
    "일관성 (Consistency)",
    "특이성 (Specificity)",
    "시간성 (Temporality)",
    "생물학적 구배\n(Biological gradient)",
    "그럴듯함 (Plausibility)",
    "일관성 (Coherence)",
    "실험 (Experiment)",
    "유사성 (Analogy)"
  ),
  설명 = c(
    "연관성이 강할수록 인과 관계 가능성 높음",
    "여러 연구에서 반복 발견됨",
    "특정 원인이 특정 결과에만 연결됨",
    "원인이 결과보다 시간적으로 선행함",
    "노출량 증가에 따른 결과 변화",
    "생물학적/과학적 메커니즘 존재",
    "역학과 생물학 지식과 모순 없음",
    "무작위 대조 실험 증거",
    "유사한 인과 관계 존재"
  )
) |>
  gt() |>
  tab_header(title = "Hill의 인과성 기준") |>
  cols_label(
    기준 = "기준",
    설명 = "설명"
)| Hill의 인과성 기준 | |
| 기준 | 설명 |
|---|---|
| 강도 (Strength) | 연관성이 강할수록 인과 관계 가능성 높음 |
| 일관성 (Consistency) | 여러 연구에서 반복 발견됨 |
| 특이성 (Specificity) | 특정 원인이 특정 결과에만 연결됨 |
| 시간성 (Temporality) | 원인이 결과보다 시간적으로 선행함 |
| 생물학적 구배 (Biological gradient) | 노출량 증가에 따른 결과 변화 |
| 그럴듯함 (Plausibility) | 생물학적/과학적 메커니즘 존재 |
| 일관성 (Coherence) | 역학과 생물학 지식과 모순 없음 |
| 실험 (Experiment) | 무작위 대조 실험 증거 |
| 유사성 (Analogy) | 유사한 인과 관계 존재 |
단일 연구에서 얻은 인과 효과 추정치는 특정 연구 모집단에서 도출된 것입니다. 이를 다른 집단이나 맥락에 적용하려면 일반화 가능성(generalizability)과 운송 가능성(transportability)을 고려해야 합니다.
연구 표본이 목표 모집단을 대표하지 않을 때 외적 타당성(external validity) 문제가 발생합니다.
library(ggdag)

dagify(
  Y ~ X + C,
  X ~ C,
  S ~ C,  # 표본 포함이 공변량에 의해 결정
  coords = list(
    x = c(X = 0, C = 1, Y = 2, S = 1),
    y = c(X = 0, C = 1, Y = 0, S = -0.5)
  ),
  labels = c(
    X = "노출",
    Y = "결과",
    C = "공변량",
    S = "표본 포함\n(S=1)"
  )
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(aes(x, y, xend = xend, yend = yend, color = status)) +
  geom_dag_edges() +
  geom_dag_point() +
  geom_dag_label_repel(seed = 42) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none")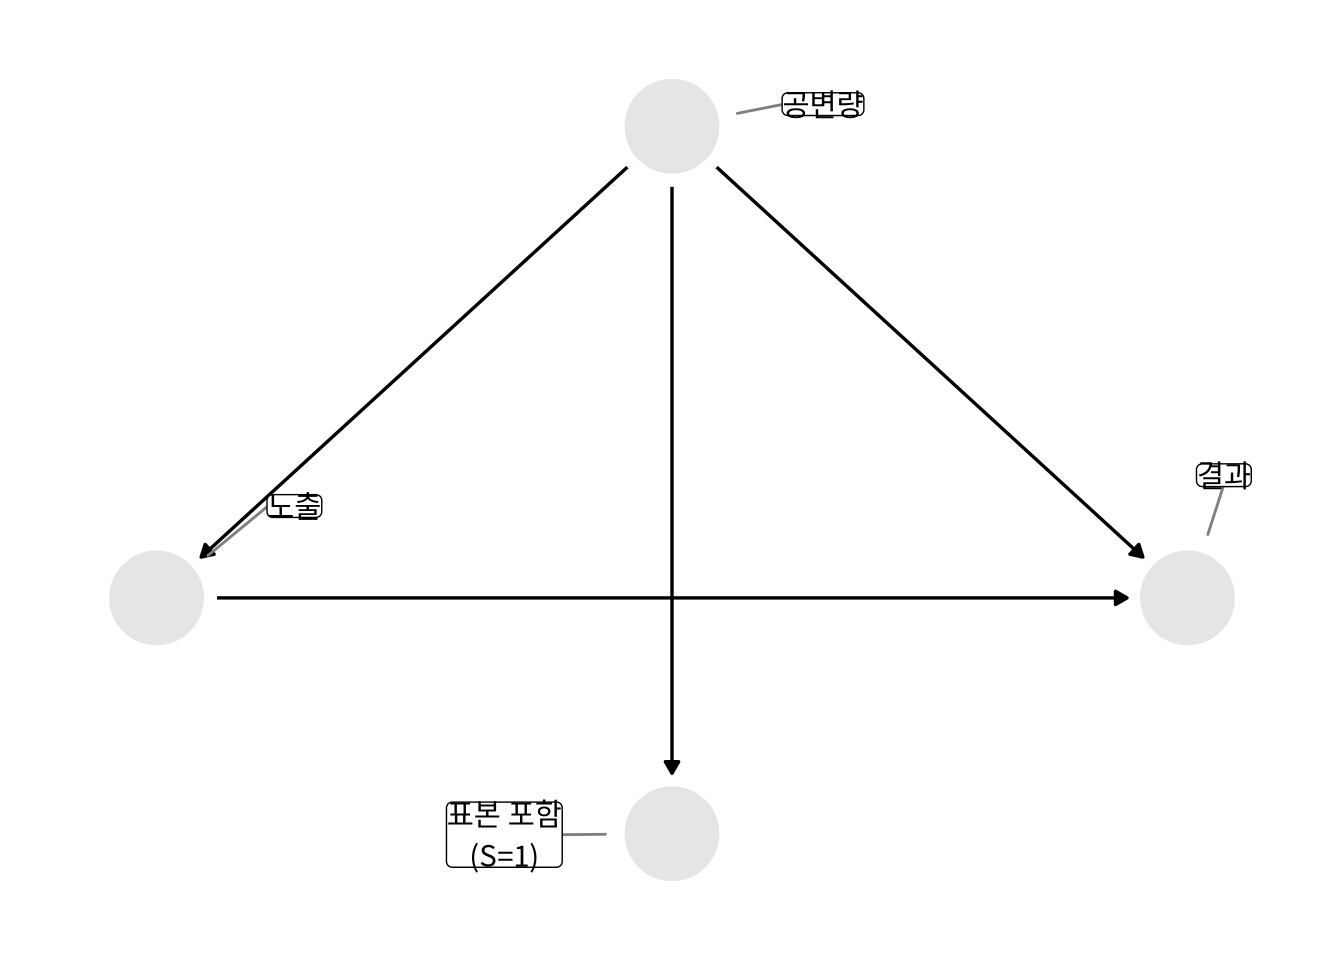
목표 모집단과 연구 표본의 공변량 분포가 다를 때, 역확률 샘플링 가중치(Inverse Probability of Sampling Weights, IPSW)를 활용해 효과를 운송할 수 있습니다.
# 시뮬레이션: 여름 시즌 데이터로 연구했지만, 연간 효과를 추정하고 싶은 경우
# 연구 표본: 여름(peak season) 데이터만 있음
study_sample <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9, park_ticket_season == "peak") |>
  drop_na() |>
  mutate(in_study = 1)

# 목표 모집단: 전체 연간 데이터
target_population <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  drop_na() |>
  mutate(in_study = 0)

# 결합된 데이터
combined <- bind_rows(study_sample, target_population)

# 표본 포함 확률 모델
sampling_model <- glm(
  in_study ~ park_close + park_temperature_high,
  data = combined,
  family = binomial()
)

# 연구 표본에서의 가중치 계산
# sampling_model은 combined 데이터로 학습되었으므로
# study_sample에 직접 augment() 불가 → predict()로 예측
study_sample_with_weights <- study_sample |>
  mutate(
    ps_sampling = predict(sampling_model, newdata = study_sample,
                          type = "response"),
    # 운송 가중치: (1 - P(S=1)) / P(S=1)
    transport_weight = (1 - ps_sampling) / ps_sampling
  )

cat("운송 가중치 요약:\n")
운송 가중치 요약:summary(study_sample_with_weights$transport_weight) Min. 1st Qu. Median Mean 3rd Qu. Max.
0.981 2.218 4.136 8.163 5.019 85.447 # 연구 표본(peak season)에서의 효과
ps_study <- glm(
park_extra_magic_morning ~
park_close + park_temperature_high,
data = study_sample,
family = binomial()
)
study_result <- ps_study |>
augment(type.predict = "response", data = study_sample) |>
mutate(w_ate = wt_ate(.fitted, park_extra_magic_morning)) |>
lm(wait_minutes_posted_avg ~ park_extra_magic_morning,
data = _, weights = w_ate) |>
tidy() |>
filter(term == "park_extra_magic_morning") |>
pull(estimate)
# 운송 가중치를 적용한 효과 (연간 효과로 운송)
transported_result <- study_sample_with_weights |>
mutate(
ps_emm = predict(ps_study, newdata = study_sample_with_weights,
type = "response"),
w_combined = wt_ate(ps_emm, park_extra_magic_morning) * transport_weight
) |>
lm(wait_minutes_posted_avg ~ park_extra_magic_morning,
data = _, weights = w_combined) |>
tidy() |>
filter(term == "park_extra_magic_morning") |>
pull(estimate)
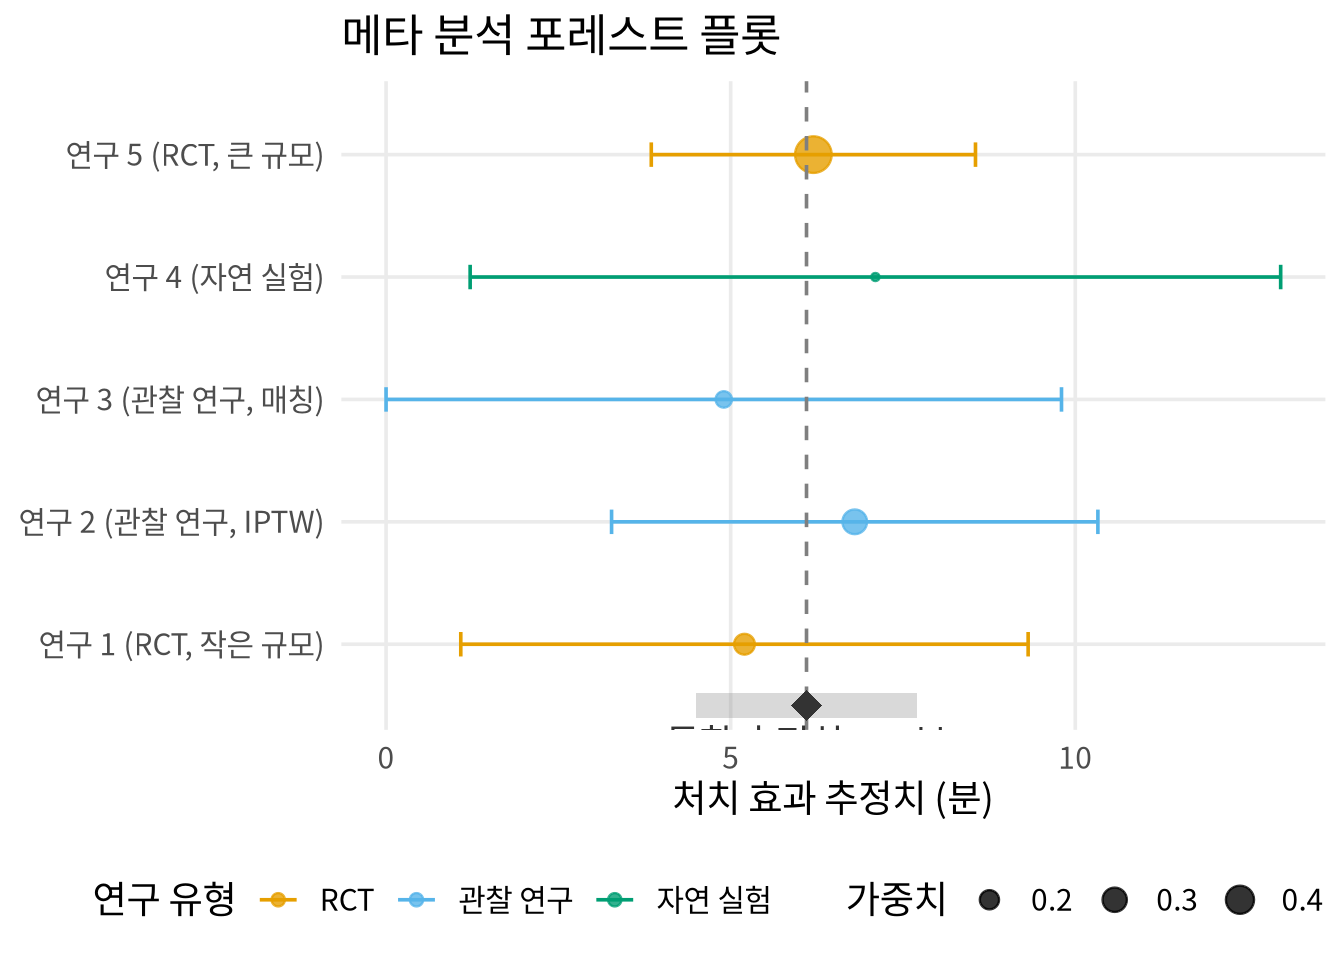
cat("연구 표본(peak season) 효과:", round(study_result, 2), "분\n")연구 표본(peak season) 효과: 10.23 분운송 후(연간 평균) 효과: -2.92 분실제 과학적 작업에서 우리는 완벽한 증거를 가지는 경우가 거의 없습니다. 불완전한 근거(ragged evidence)는 서로 다른 연구들이 서로 다른 추정 대상을 사용하고, 서로 다른 가정을 만들고, 서로 다른 측면을 측정하며, 심지어 서로 다른 결론에 도달할 수 있음을 의미합니다.
메타 분석(meta-analysis)은 여러 연구의 결과를 통합하는 표준적인 방법이지만, 인과 추론에서는 몇 가지 주의점이 있습니다:
# 가상의 여러 연구 결과
meta_results <- tibble(
  study = c(
    "연구 1 (RCT, 작은 규모)",
    "연구 2 (관찰 연구, IPTW)",
    "연구 3 (관찰 연구, 매칭)",
    "연구 4 (자연 실험)",
    "연구 5 (RCT, 큰 규모)"
  ),
  estimate = c(5.2, 6.8, 4.9, 7.1, 6.2),
  se = c(2.1, 1.8, 2.5, 3.0, 1.2),
  type = c("RCT", "관찰 연구", "관찰 연구", "자연 실험", "RCT")
) |>
  mutate(
    conf.low = estimate - 1.96 * se,
    conf.high = estimate + 1.96 * se,
    weight = 1 / se^2
  )

# 역분산 가중 메타 분석 추정치
pooled_estimate <- sum(meta_results$weight * meta_results$estimate) /
  sum(meta_results$weight)
pooled_se <- sqrt(1 / sum(meta_results$weight))

ggplot(meta_results, aes(y = study, x = estimate, color = type)) +
  geom_point(aes(size = weight), alpha = 0.8) +
  geom_errorbarh(aes(xmin = conf.low, xmax = conf.high), height = 0.2) +
  geom_vline(xintercept = pooled_estimate, linetype = "dashed", color = "grey50") +
  annotate("rect",
           xmin = pooled_estimate - 1.96 * pooled_se,
           xmax = pooled_estimate + 1.96 * pooled_se,
           ymin = 0.4, ymax = 0.6,
           fill = "grey50", alpha = 0.3) +
  annotate("point", x = pooled_estimate, y = 0.5,
           shape = 18, size = 5, color = "grey20") +
  annotate("text",
           x = pooled_estimate, y = 0.3,
           label = paste0("통합 추정치: ", round(pooled_estimate, 1), "분"),
           vjust = 1, color = "grey20") +
  scale_color_okabe_ito() +
  labs(
    x = "처치 효과 추정치 (분)",
    y = NULL,
    color = "연구 유형",
    size = "가중치",
    title = "메타 분석 포레스트 플롯"
  )
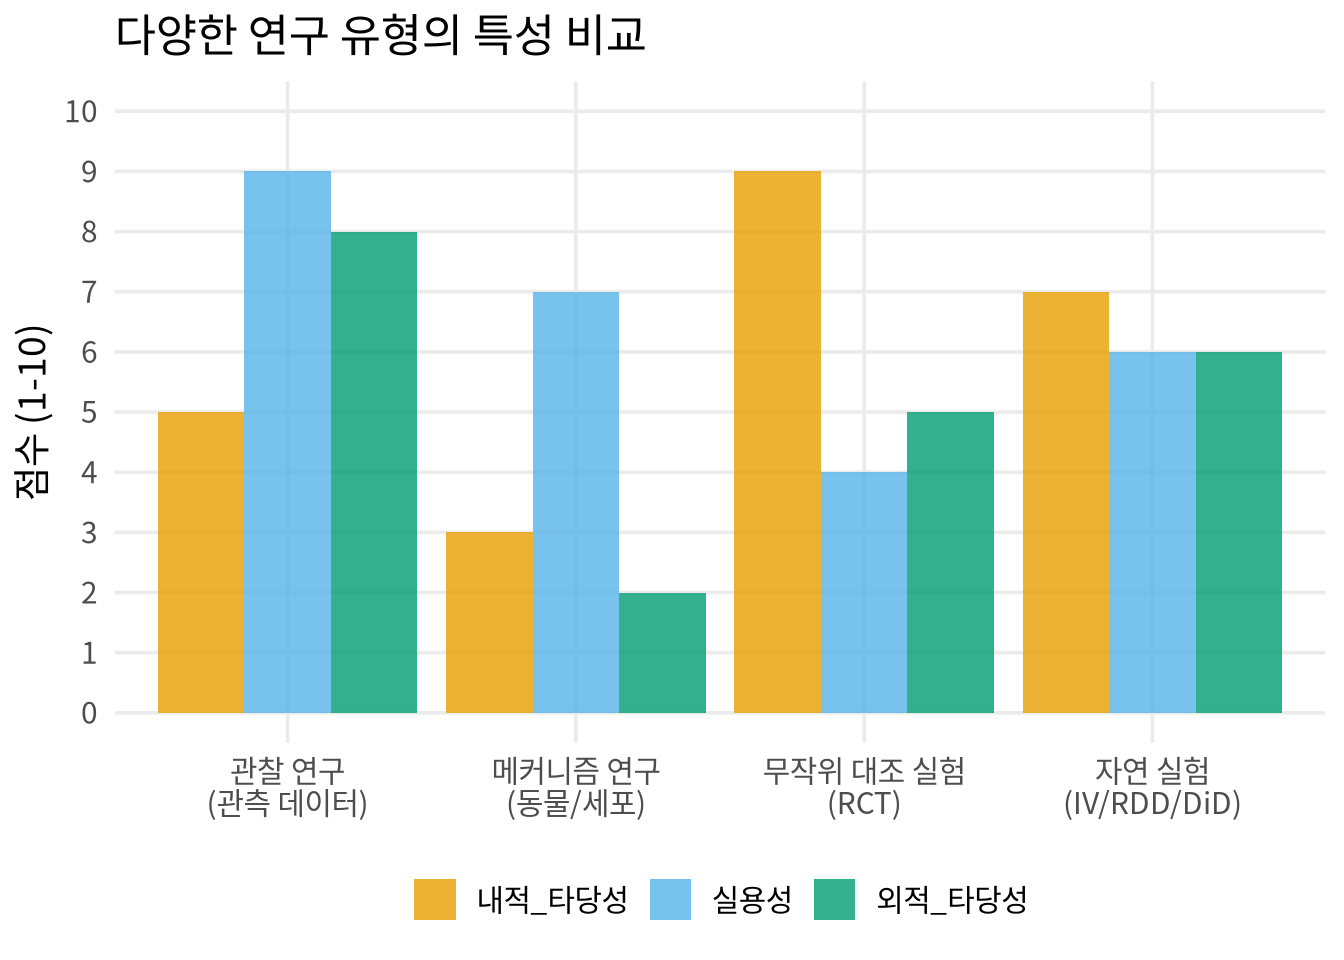
불완전한 증거를 통합할 때는 다음 원칙을 고려하십시오.
evidence_types <- tibble(
  유형 = c("무작위 대조 실험\n(RCT)", "자연 실험\n(IV/RDD/DiD)", "관찰 연구\n(관측 데이터)", "메커니즘 연구\n(동물/세포)"),
  내적_타당성 = c(9, 7, 5, 3),
  외적_타당성 = c(5, 6, 8, 2),
  실용성 = c(4, 6, 9, 7)
) |>
  tidyr::pivot_longer(
    cols = c(내적_타당성, 외적_타당성, 실용성),
    names_to = "차원",
    values_to = "점수"
  )

ggplot(evidence_types, aes(x = 유형, y = 점수, fill = 차원)) +
  geom_col(position = "dodge", alpha = 0.8) +
  scale_fill_okabe_ito() +
  scale_y_continuous(limits = c(0, 10), breaks = 0:10) +
  labs(
    x = NULL,
    y = "점수 (1-10)",
    fill = NULL,
    title = "다양한 연구 유형의 특성 비교"
  )
이 책에서 우리는 인과 추론의 다양한 측면을 탐구했습니다. 올바른 인과 효과 추정을 위한 주요 단계를 정리해 봅시다.
인과 질문 명확히 하기: 내가 답하고 싶은 인과적 질문은 무엇인가?
추정 대상 정의하기: ATE, ATT, ATC 등 어떤 것이 질문에 답하는가?
DAG 그리기: 인과 가정을 명시적으로 표현하고 동료들과 공유해 피드백 받기
적절한 방법 선택하기: 연구 설계와 데이터 구조에 맞는 방법 선택
가정 검증하기: 성향 점수 중첩, 균형, 민감도 분석 등으로 가정 확인
불확실성 정직하게 보고하기: 신뢰 구간, 민감도 분석, 방법의 한계 보고
삼각 측량하기: 단일 분석에 의존하지 말고 여러 방법으로 결과 확인
일반화 가능성 논의하기: 연구 결과가 어떤 집단과 맥락에 적용되는지 명시
인과 추론은 단순한 통계 기술이 아닙니다. 우리가 세계에 대해 알고 있는 것, 알 수 있는 것, 알아야 하는 것에 관한 과학적 사고방식입니다. 셜록 홈즈의 말처럼 증거는 까다롭습니다. 하지만 올바른 도구와 사고방식으로 접근한다면 훨씬 더 믿을 만한 결론에 도달할 수 있습니다.