경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
전통적인 통계 모델은 인과 추론에서 중요한 역할을 해왔지만, 복잡한 고차원 데이터에서는 한계를 보일 수 있습니다. 머신러닝(machine learning)은 복잡한 비선형 관계를 포착할 수 있는 강력한 도구를 제공하지만, 그 자체로는 인과적 추론에 직접 사용할 수 없습니다.
이 장에서 머신러닝과 인과 추론을 결합하는 방법을 살펴봅니다: 1. 예측과 인과 추론의 근본적인 차이 다시 살펴보기 2. 이중 로버스트 추정량(장 20)과 머신러닝 결합하기 3. 교차 적합(cross-fitting)의 중요성
sec-casual-to-causal에서 예측과 인과 추론의 차이를 처음 소개했습니다. 여기서 이 차이를 머신러닝 맥락에서 다시 살펴봅니다.
머신러닝 모델의 목표는 주어진 입력에서 결과를 최대한 정확하게 예측하는 것입니다. 반면 인과 추론의 목표는 개입 효과를 편향 없이 추정하는 것입니다. 둘은 근본적으로 목표가 다릅니다.
library(dplyr)
library(broom)
library(touringplans)
library(ggplot2)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  drop_na()

# 예측 정확도가 높은 복잡한 모델이 반드시 좋은 인과 추정치를 주지 않습니다
# 예시: 교란 요인을 과적합하면 성향 점수가 불안정해짐

# 단순 성향 점수 모델
ps_simple <- glm(
  park_extra_magic_morning ~
    park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9,
  family = binomial()
)

# 복잡한 모델 (많은 상호작용 포함)
ps_complex <- glm(
  park_extra_magic_morning ~
    park_ticket_season * park_close * park_temperature_high,
  data = seven_dwarfs_9,
  family = binomial()
)

# 두 모델의 성향 점수 분포 비교
seven_dwarfs_9 |>
  mutate(
    ps_simple = predict(ps_simple, type = "response"),
    ps_complex = predict(ps_complex, type = "response")
  ) |>
  tidyr::pivot_longer(
    cols = starts_with("ps_"),
    names_to = "모델",
    values_to = "성향점수"
  ) |>
  mutate(모델 = ifelse(모델 == "ps_simple", "단순 모델", "복잡한 모델")) |>
  ggplot(aes(x = 성향점수, fill = 모델)) +
  geom_histogram(bins = 30, alpha = 0.7, position = "dodge") +
  facet_wrap(~ 모델) +
  labs(
    title = "단순 vs 복잡한 성향 점수 모델의 분포",
    x = "성향 점수",
    y = "빈도"
  ) +
  theme(legend.position = "none")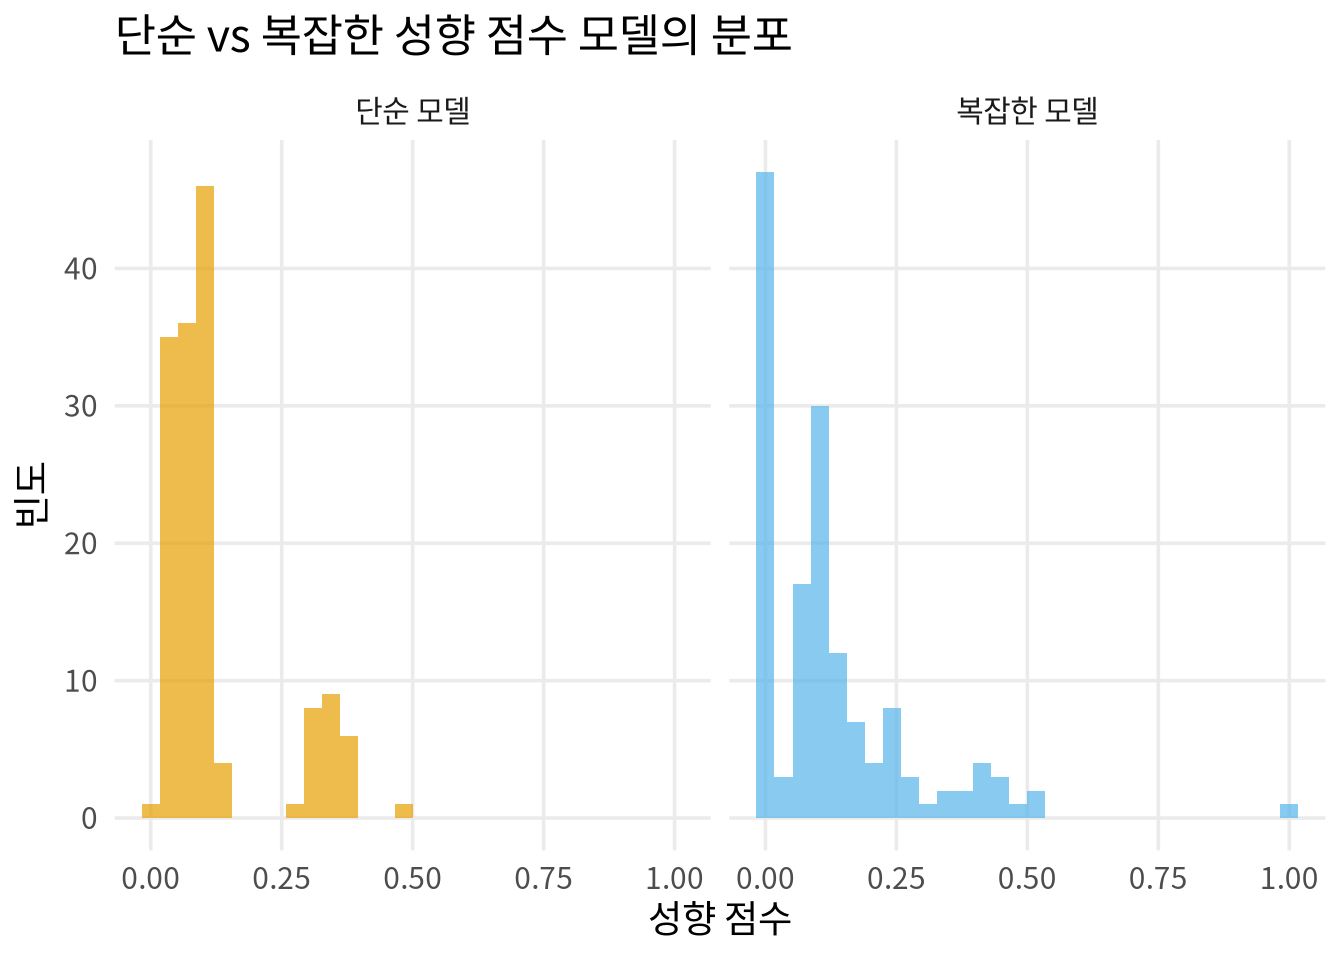
복잡한 모델은 예측 성능이 더 좋을 수 있지만, 성향 점수가 0 또는 1에 근접한 극단적인 값을 가질 위험이 있습니다. 이는 IPTW 가중치를 매우 불안정하게 만들고, 결국 인과 추정치의 분산을 크게 증가시킵니다.
머신러닝에서 정규화(regularization)는 과적합을 방지하는 데 도움이 됩니다. 예를 들어 LASSO는 불필요한 변수 계수를 0으로 만들어 모델을 단순화합니다.
그러나 인과 추론에서 중요한 교란 요인 계수가 정규화로 0이 되면 편향이 발생합니다. 따라서 머신러닝을 인과 추론에 적용할 때는 각별히 주의해야 합니다.
sec-dr에서 소개한 AIPW는 성향 점수와 결과 모델을 모두 사용합니다. Super Learner라는 앙상블 머신러닝 방법과 결합하면 이중 로버스트 추정량을 더욱 강력하게 만들 수 있습니다.
Super Learner는 여러 머신러닝 알고리즘의 예측을 최적으로 결합하여 단일 최상의 예측을 제공하는 앙상블 방법입니다.
# Super Learner를 사용한 AIPW (개념 설명)
# 실제 구현에서는 SuperLearner 또는 sl3 패키지 사용

library(propensity)

# 성향 점수 모델: 여러 방법으로 시도 후 비교
# 방법 1: 로지스틱 회귀
ps_logistic <- glm(
  park_extra_magic_morning ~
    park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9,
  family = binomial()
)

# 방법 2: 랜덤 포레스트 (ranger 패키지)
# 실제 사용 시 아래 코드를 활성화
# library(ranger)
# ps_rf <- ranger(
#   park_extra_magic_morning ~
#     park_ticket_season + park_close + park_temperature_high,
#   data = seven_dwarfs_9,
#   probability = TRUE
# )

# 여기서는 로지스틱 회귀만 사용하여 AIPW 구현 보여줌
outcome_model <- lm(
  wait_minutes_posted_avg ~
    park_extra_magic_morning *
    (park_ticket_season + park_close + park_temperature_high),
  data = seven_dwarfs_9
)

# AIPW 추정
ps_hat <- predict(ps_logistic, type = "response")
mu1_hat <- predict(outcome_model,
                   newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 1))
mu0_hat <- predict(outcome_model,
                   newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 0))

Y <- seven_dwarfs_9$wait_minutes_posted_avg
A <- seven_dwarfs_9$park_extra_magic_morning

aipw_scores <- (mu1_hat - mu0_hat) +
  A * (Y - mu1_hat) / ps_hat -
  (1 - A) * (Y - mu0_hat) / (1 - ps_hat)

aipw_ate <- mean(aipw_scores)
aipw_se <- sd(aipw_scores) / sqrt(length(aipw_scores))

cat("AIPW ATE 추정치:", round(aipw_ate, 3), "분\n")
AIPW ATE 추정치: -4.123 분표준 오차: 2.313 95% CI: [ -8.656 , 0.41 ]sec-dr에서 소개한 TMLE는 머신러닝과 결합했을 때 특히 강력합니다. TMLE + Super Learner 조합은 현대 인과 추론에서 표준적인 접근법이 되고 있습니다.
머신러닝을 사용할 때 중요한 기술은 교차 적합(cross-fitting) 또는 이중 기계 학습(Double Machine Learning, DML)입니다.
교차 적합이 필요한 이유: 같은 데이터로 성향 점수/결과 모델을 훈련하고 AIPW를 계산하면, 과적합으로 인한 “과잉 적합 편향(overfitting bias)”이 발생할 수 있습니다.
# 교차 적합 AIPW 구현
library(rsample)

# K-겹 교차 적합
k_folds <- 5
set.seed(2024)
cv_splits <- vfold_cv(seven_dwarfs_9, v = k_folds)

# 각 폴드에서 교차 적합 수행
compute_aipw_fold <- function(split) {
  # 훈련 데이터와 검증 데이터 분리
  train_data <- training(split)
  test_data  <- testing(split)

  # 훈련 데이터로 모델 적합
  ps_fold <- glm(
    park_extra_magic_morning ~
      park_ticket_season + park_close + park_temperature_high,
    data = train_data,
    family = binomial()
  )

  outcome_fold <- lm(
    wait_minutes_posted_avg ~
      park_extra_magic_morning *
      (park_ticket_season + park_close + park_temperature_high),
    data = train_data
  )

  # 검증 데이터에서 AIPW 점수 계산
  ps_test <- predict(ps_fold, newdata = test_data, type = "response")
  mu1_test <- predict(outcome_fold,
                      newdata = mutate(test_data, park_extra_magic_morning = 1))
  mu0_test <- predict(outcome_fold,
                      newdata = mutate(test_data, park_extra_magic_morning = 0))

  Y_test <- test_data$wait_minutes_posted_avg
  A_test <- test_data$park_extra_magic_morning

  aipw_test <- (mu1_test - mu0_test) +
    A_test * (Y_test - mu1_test) / ps_test -
    (1 - A_test) * (Y_test - mu0_test) / (1 - ps_test)

  tibble(aipw_score = aipw_test, fold = split$id)
}

# 모든 폴드에서 AIPW 점수 계산
cv_aipw_scores <- map_dfr(cv_splits$splits, compute_aipw_fold)

# 교차 적합 AIPW ATE
cf_ate <- mean(cv_aipw_scores$aipw_score)
cf_se  <- sd(cv_aipw_scores$aipw_score) / sqrt(nrow(cv_aipw_scores))

cat("교차 적합 AIPW ATE:", round(cf_ate, 3), "분\n")
교차 적합 AIPW ATE: -18.22 분표준 오차: 17.82 95% CI: [ -53.15 , 16.71 ]Chernozhukov et al.(2018)이 개발한 이중 기계 학습(DML)은 교차 적합 AIPW와 유사한 아이디어를 사용하지만, 부분선형 모델(partially linear model)에 초점을 맞춥니다.
DML의 핵심 아이디어는 잔차화(residualization)입니다:
# DML 부분 선형 모델 구현 (교차 적합 포함)
compute_dml_fold <- function(split) {
  train_data <- training(split)
  test_data  <- testing(split)

  # 노출 모델: E[X | C]
  x_model <- lm(
    park_extra_magic_morning ~
      park_ticket_season + park_close + park_temperature_high,
    data = train_data
  )

  # 결과 모델: E[Y | C] (노출 제외)
  y_model <- lm(
    wait_minutes_posted_avg ~
      park_ticket_season + park_close + park_temperature_high,
    data = train_data
  )

  # 검증 데이터에서 잔차 계산
  x_resid <- test_data$park_extra_magic_morning -
    predict(x_model, newdata = test_data)
  y_resid <- test_data$wait_minutes_posted_avg -
    predict(y_model, newdata = test_data)

  tibble(x_resid = x_resid, y_resid = y_resid)
}

dml_residuals <- map_dfr(cv_splits$splits, compute_dml_fold)

# 잔차에 대한 선형 회귀 = DML 추정치
dml_fit <- lm(y_resid ~ x_resid - 1, data = dml_residuals)
tidy(dml_fit, conf.int = TRUE)
# A tibble: 1 × 7
term estimate std.error statistic p.value conf.low
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 x_resid -4.25 4.00 -1.06 0.290 -12.2
# ℹ 1 more variable: conf.high <dbl>머신러닝을 인과 추론에 사용하면 유리한 상황:
머신러닝 사용 시 주의사항: - 항상 교차 적합 사용 - 이중 로버스트 추정량과 결합 - 성향 점수의 극단값 확인 (positivity 가정) - 결과가 직관과 크게 다르면 의심해봐야 함