노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
노란 숲 속에 두 갈래 길이 나 있었습니다.
나는 두 길을 다 가지 못하는 것을 안타깝게 생각하며,
오랫동안 서서 한쪽 길이 굽어 꺾여 내려간 데까지,
바라다볼 수 있는 데까지 멀리 바라다보았습니다.
— 로버트 프로스트(Robert Frost)
2022년, 미국 래퍼이자 Law and Order: SVU의 핀(Fin)으로 잘 알려진 아이스티(Ice-T)는 Split Decision: Life Stories라는 책을 공동 집필했습니다 (Century 2022). 이 책에서 아이스티는 범죄의 삶에서 명성과 성공에 이르기까지의 극적인 여정을 들려주며, 자신의 전 범죄 파트너이자 공동 저자인 스파이크(Spike)의 운명과 대조합니다. 두 사람 모두 로스앤젤레스의 갱단이 지배하는 동네에서 자랐으며 함께 보석 강도 사건을 저질렀습니다. 그들의 삶은 아이스티가 클럽에서 랩을 하다가 발굴되면서 갈라졌습니다. 이를 계기로 그는 범죄의 과거를 뒤로하고 음악, 영화, 텔레비전 분야에서 성공적인 경력을 쌓기 시작했습니다. 반면 스파이크는 보석 강도 현장에서 잡혀 3년 동안 수감되었습니다. 그는 범죄의 삶을 계속했고, 결국 실패한 강도 사건으로 인해 35년에서 종신형에 처하는 징역형을 선고받았습니다. 책의 홍보 문구는 “서로 다른 삶을 사는 두 남자가 만약 다른 선택을 했더라면 그들의 경로가 어떻게 완전히 뒤바뀌었을지”를 설명합니다.
이 매력적인 전제는 우리가 반사실(counterfactuals)을 관찰하고 있음을 암시합니다. 하나의 결정(강도질을 계속할 것인지, 아니면 음악가로 성공할 것인지)이 두 사람을 갈라놓기 전까지 동일한 궤적을 따르던 두 삶을 보여줍니다. 한 삶은 감옥행이고 다른 삶은 성공과 명성입니다. 이 책은 아이스티와 그의 친구 스파이크가 이 분기점 이전에 얼마나 비슷했는지(예: 둘 다 로스앤젤레스에서 자랐고, 갱단에 연루되었으며, 함께 보석 강도를 계획함)를 설명하며 시작합니다. 그러다 분기점이 찾아옵니다. 아이스티는 범죄의 삶을 버렸고, 스파이크는 반대로 계속하기로 결정합니다. 이후 아이스티는 명성과 부를 얻었지만 스파이크는 35년에서 종신형을 선고받고 감옥에 갇힙니다. 이 책은 사건 전에는 같았지만 사건 후에는 달라진 두 사람을 다루는 소규모 연구와 같습니다. 스파이크의 결과는 아이스티의 결과에 대한 반사실 역할을 합니다.
flowchart LR
A{Ice-T} --> |관찰됨| B(범죄의 삶을 버림)
A -.-> |누락된 반사실| C(한 번 더 강도질을 함)
C -.-> D[35년의 징역형]
B --> E[명성과 부]

classDef grey fill:#ddd
class D,C grey
flowchart LR
A{Spike} -.-> |누락된 반사실| B(범죄의 삶을 버림)
A --> |관찰됨| C(한 번 더 강도질을 함)
C --> D[35년의 징역형]
B -.-> E[명성과 부]
classDef grey fill:#ddd
class E,B grey
우리는 아이스티가 강도질을 계속했거나 스파이크가 범죄를 피했을 때 어떤 일이 일어났을지 알지 못합니다. 아이스티는 범죄를 떠나고 스파이크는 그러지 않은 단 하나의 실제 세계에 살고 있기 때문입니다. 하지만 두 사람이 서로의 반사실적 결과에 대한 대리인(proxy)이 될 수 있다는 점은 알 수 있습니다. 인과 추론 기술은 이와 비슷하게 관찰된 데이터를 사용하여 반사실을 시뮬레이션하려 시도합니다. 무작위 시험조차 단 하나의 실제 세계로 제한되므로, 서로 다른 노출을 가진 유사한 그룹들의 평균 효과를 비교하는 방식을 취합니다.
그럼에도 이러한 추론에서 몇 가지 문제가 즉시 눈에 띕니다. 첫째, 이 책은 두 사람이 갈라지기 전까지 비슷했다고 암시하지만 실제로는 어떠했을지 추측해 볼 수 있습니다. 강도질을 한 번 더 했다고 해서 아이스티가 정말 감옥에 갔을까요? 이 관점에서는 스파이크를 좋은 반사실로 보기 쉽습니다. 반대로 스파이크가 범죄를 그만두었다면 그도 유명한 음악가나 배우가 되었을까요? 아이스티가 범죄의 삶을 떠난 것이 성공의 유일한 요인은 아니었습니다. 그는 이를 직업으로 삼을 만큼 충분한 재능이 있었습니다. 스파이크도 아이스티 같은 재능이 있었을까요? 같은 선택을 했다고 해서 그의 삶도 똑같이 풀렸을 것이라고 단정할 수 있을까요? 범죄를 떠나기로 한 아이스티의 결정이 미래 결과에 미치는 인과 효과를 진정으로 추정하고 싶다면, 결정을 내리기 전후의 궤적을 모두 관찰해야 합니다. 마찬가지로 스파이크는 측정하기 어려운 면에서 아이스티와 다를 수 있으며, 이는 그를 반사실에 대한 대리인으로 부적합하게 만듭니다. 그래서 단일 개인 대신 많은 사람에게 의존하곤 합니다. 많은 개인을 무작위로 배정하여 범죄를 떠나게 하거나 남게 한 뒤 결과에 어떤 영향을 미치는지 살펴보는 실험을 수행할 수 있습니다(물론 이는 윤리적 문제가 있어 관찰 데이터가 흥미로운 이유가 되기도 합니다). 어떤 경우든 관찰된 데이터로부터 관찰 불가능한 반사실을 구축하려면 통계적 기술이 필요합니다.
실제 결과(factual outcomes)와 반사실적 결과(counterfactual outcomes)는 잠재적 결과의 두 가지 실현입니다. 원인이 발생하기 전 잠재적 결과는 어떤 노출을 받느냐에 따라 일어날 수 있는 모든 가능성을 의미합니다. 여기서는 1980년대 특정 시점에 강도질을 그만둘지 계속할지 결정하는 것을 원인으로, 감옥행 여부를 결과로 봅니다.
노출 수준은 두 가지입니다:
\(X=continue\): 보석 강도질을 계속함
\(X=quit\): 보석 강도질을 그만둠
이 시나리오에서 잠재적 결과는 두 가지입니다:
잠재적 결과 중 단 하나만이 실현되며, 이것이 실제로 발생한 노출에 해당하는 실제적 결과입니다. 따라서 개인별로 오직 하나의 잠재적 결과만 관찰할 수 있습니다. 노출은 특정 시점에 정의되므로 한 개인에게는 하나만 일어날 수 있기 때문입니다. 이진 노출이라면 하나의 잠재적 결과는 관찰 가능해지지만 다른 하나는 누락됩니다. 초기 인과 추론 방법은 이를 결측 데이터 문제(missing data problems)로 보기도 했습니다. 발생하지 않은 노출에 해당하는 잠재적 결과인 누락된 반사실에 대해 특정한 가정이 필요한 이유입니다. 우리가 관심을 갖는 인과 효과는 종종 \(Y(continue) - Y(quit)\)와 같은 잠재적 결과의 차이(예: 강도질 지속 여부에 따른 감옥행 확률 차이)입니다. 아이스티와 스파이크 사례에서는 개별 인과 효과에 주목합니다:
여기서 우리는 \(Y_{Ice-T}(continue)\)와 \(Y_{Spike}(quit)\)를 알 수 없으므로 이 값을 직접 계산할 수 없습니다. 실무에서는 관찰된 데이터를 누락된 잠재적 결과의 대리인으로 사용하며, 대개 특정 인구 집단에 대해 평균화합니다. 하지만 단순히 관찰 데이터에 통계학을 적용하는 것만으로는 부족합니다. 관찰 데이터에 잠재적 결과의 의미를 부여하고 분석 결과에 인과 효과의 의미를 담으려면 특정 인과적 가정을 충족해야 합니다.
이 책에서 우리는 잠재적 결과(potential outcomes)와 반사실(counterfactuals)이라는 용어를 거의 상호 교환적으로 사용하지만, 그 의미가 기술적으로 동일한 것은 아닙니다. 반사실은 잠재적 결과의 한 유형으로, 실현되지 않아 관찰 불가능한 잠재적 결과를 의미합니다. 반사실의 정의는 실제로 발생한 노출에 따라 달라집니다. 반면 잠재적 결과는 관찰된 노출과는 무관하며, 노출이 일어나기 전에도 잘 정의되는 경우가 많습니다. 그럼에도 불구하고 우리는 대개 노출이 발생한 후의 데이터로 작업하므로, 하나의 실현된 잠재적 결과와 적어도 하나의 사실과 반대되는(counter to the fact) 잠재적 결과를 갖게 됩니다. 일부 완고한 이들은 한 용어만을 고집하기도 하지만, 우리는 두 용어 모두 유용하다고 생각합니다.
다른 예시를 고려해 봅시다: 아이스크림이 행복도에 미치는 효과입니다.
1에서 10까지의 범위를 갖는 어떤 행복 지수가 존재한다고 가정해 봅시다. 우리는 초콜릿 아이스크림을 먹는 것이 바닐라를 먹는 것에 비해 행복도를 높이는지 평가하고 싶습니다. 우리에게는 각 개인에 대해 두 가지 잠재적 결과가 있는 10명의 개인이 있습니다. 하나는 초콜릿 아이스크림을 먹었을 때의 행복도(아래 코드에서 y_chocolate으로 정의됨)이고, 다른 하나는 바닐라 아이스크림을 먹었을 때의 행복도(y_vanilla)입니다. 우리는 각 개인에 대해 초콜릿 아이스크림을 먹는 것(바닐라와 비교하여)의 진정한 개별 인과 효과를 두 값의 차이로 정의할 수 있습니다 (표 3.2).
library(gt)
data |>
  gt::gt() |>
  gt::cols_label(
    id = "ID",
    y_chocolate = gt::md("$$Y_{\\text{id}}(\\text{chocolate})$$"),
    y_vanilla = gt::md("$$Y_{\\text{id}}(\\text{vanilla})$$"),
    causal_effect = gt::md("$$Y_{\\text{id}}(\\text{chocolate}) - Y_{\\text{id}}(\\text{vanilla})$$")
  ) |>
  gt::fmt_markdown(
    columns = c(y_chocolate, y_vanilla, causal_effect)
  ) |>
  gt::tab_header(
    title = gt::md("**잠재적 결과와 인과 효과**")
  ) |>
  gt::tab_spanner(
    label = "잠재적 결과",
    columns = c(y_chocolate, y_vanilla)
  ) |>
  gt::tab_spanner(
    label = "인과 효과",
    columns = causal_effect
)| 잠재적 결과와 인과 효과 | |||
| ID |
잠재적 결과
|
인과 효과
|
|
|---|---|---|---|
| \[Y_{\text{id}}(\text{chocolate})\] | \[Y_{\text{id}}(\text{vanilla})\] | \[Y_{\text{id}}(\text{chocolate}) - Y_{\text{id}}(\text{vanilla})\] | |
| 1 | 4 | 1 | 3 |
| 2 | 4 | 3 | 1 |
| 3 | 6 | 4 | 2 |
| 4 | 5 | 5 | 0 |
| 5 | 6 | 5 | 1 |
| 6 | 5 | 6 | -1 |
| 7 | 6 | 8 | -2 |
| 8 | 7 | 6 | 1 |
| 9 | 5 | 3 | 2 |
| 10 | 6 | 5 | 1 |
예를 들어 표 3.2 를 살펴보면, 개인 4에 대해 초콜릿 아이스크림을 먹는 것(바닐라 대비)의 인과 효과는 0인 반면, 개인 9에 대한 인과 효과는 2입니다.
초콜릿을 먹은 후의 평균 잠재적 행복도는 5.4이고, 바닐라를 먹은 후의 평균 잠재적 행복도는 4.6입니다. 이 연구에 참여한 10명에 대해 초콜릿(바닐라 대비) 아이스크림을 먹는 것의 평균 처치 효과는 5.4 - 4.6 = 0.8입니다.
# A tibble: 1 × 3
  avg_chocolate avg_vanilla avg_causal_effect
          <dbl>       <dbl>             <dbl>
1           5.4         4.6               0.8
실제로 우리는 어떤 주어진 순간에 두 가지 잠재적 결과를 모두 관찰할 수 없습니다; 우리 연구의 각 개인은 연구가 수행되는 시점에 오직 한 가지 맛의 아이스크림만 먹을 수 있습니다1. 우리가 각 참가자에게 두 가지 맛 중 하나를 무작위로 주었다고 가정해 봅시다. 이제 우리가 관찰하는 것은 표 3.3 에 나와 있습니다. 우리는 오직 하나의 잠재적 결과(참가자가 실제로 받은 노출과 관련된 결과)만을 알 수 있습니다. 우리는 다른 하나를 알 수 없으며, 결과적으로 개별 인과 효과도 알 수 없습니다.
## 우리는 무작위적인 일을 하고 있으므로,
## 코드를 실행할 때마다 항상 동일한 결과를 관찰할 수 있도록
## 시드를 설정합니다.
set.seed(11)
data_observed <- data |>
  mutate(
    # 노출을 무작위로 변경합니다. 각 그룹에 속할 확률이 0.5인
    # 이항 분포로부터 생성됩니다.
    exposure = if_else(
      rbinom(n(), 1, 0.5) == 1, "chocolate", "vanilla"
    ),
    observed_outcome = case_when(
      exposure == "chocolate" ~ y_chocolate,
      exposure == "vanilla" ~ y_vanilla
    )
)library(gt)
avg_chocolate <- data_observed |>
filter(exposure == "chocolate") |>
pull(observed_outcome) |>
mean()
avg_vanilla <- data_observed |>
filter(exposure == "vanilla") |>
pull(observed_outcome) |>
mean()
data_observed |>
mutate(
y_chocolate = if_else(exposure == "chocolate", y_chocolate, NA),
y_vanilla = if_else(exposure == "vanilla", y_vanilla, NA),
causal_effect = NA_real_
) |>
select(-observed_outcome, -exposure) |>
gt::gt() |>
gt::cols_label(
id = "ID",
y_chocolate = gt::md("$$Y_{\\text{id}}(\\text{chocolate})$$"),
y_vanilla = gt::md("$$Y_{\\text{id}}(\\text{vanilla})$$"),
causal_effect = gt::md("$$Y_{\\text{id}}(\\text{chocolate}) - Y_{\\text{id}}(\\text{vanilla})$$")
) |>
gt::fmt_markdown(columns = c(y_chocolate, y_vanilla, causal_effect)) |>
gt::sub_missing(
columns = c(y_chocolate, y_vanilla, causal_effect),
missing_text = gt::md("---") # Format missing values as blank
) |>
gt::tab_header(
title = gt::md("**잠재적 결과와 숨겨진 인과 효과**")
) |>
gt::tab_spanner(
label = "잠재적 결과",
columns = c(y_chocolate, y_vanilla)
) |>
gt::tab_spanner(
label = "인과 효과",
columns = causal_effect
)| 잠재적 결과와 숨겨진 인과 효과 | |||
| ID |
잠재적 결과
|
인과 효과
|
|
|---|---|---|---|
| \[Y_{\text{id}}(\text{chocolate})\] | \[Y_{\text{id}}(\text{vanilla})\] | \[Y_{\text{id}}(\text{chocolate}) - Y_{\text{id}}(\text{vanilla})\] | |
| 1 | — | 1 | — |
| 2 | — | 3 | — |
| 3 | 6 | — | — |
| 4 | — | 5 | — |
| 5 | — | 5 | — |
| 6 | 5 | — | — |
| 7 | — | 8 | — |
| 8 | — | 6 | — |
| 9 | 5 | — | — |
| 10 | — | 5 | — |
이제 초콜릿 아이스크림을 먹은 사람들 사이에서 관찰된 평균 결과는 5.3인 반면, 바닐라를 먹은 사람들 사이에서 관찰된 평균 결과는 4.7입니다. 비록 지금은 반사실적 결과가 누락되었음에도 불구하고, 이 값들은 실제 평균에 가깝습니다. 추정된 평균 인과 효과는 5.3 - 4.7 = 0.6입니다. 표본 크기가 작아서 약간의 오차가 있지만, 표본 크기가 커질수록 더 정확한 답을 얻을 수 있을 것입니다.
# A tibble: 2 × 2
exposure avg_outcome
<chr> <dbl>
1 chocolate 5.33
2 vanilla 4.71더 이상 진정한 인과 효과를 계산할 수 없음에도 불구하고 왜 이 방식이 작동할까요? 알고 보니, 무작위 배정은 우리가 관찰된 데이터에 대한 인과적 가정을 충족하는 데 필요한 속성들을 가지고 있습니다. 이러한 가정들이 충족되기 때문에, 우리는 관찰된 평균을 두 잠재적 결과의 평균에 대한 대리인(proxies)으로 사용할 수 있습니다.
그 이유가 무엇인지, 그리고 이러한 가정들이 위배될 때 어떤 일이 일어나는지 알아봅시다.
우리는 이 책 전반에 걸쳐 많은 방법론을 논의할 것입니다. 각 방법론에는 결과를 인과적으로 해석하기 위해 필요한 검증 불가능한 가정들이 수반됩니다. 이러한 가정들은 한 가지 목표를 가지고 있습니다: 관찰된 데이터를 사용하여 관찰 불가능한 반사실을 표현할 수 있게 하는 것입니다. 우리가 이를 수행하기 위해 필요한 것은 무엇일까요?
인과 추론을 위해 우리가 해야 하는 대부분의 가정은 “사과 대 사과” 비교를 하기 위한 것입니다: 우리는 서로의 반사실에 대해 합리적인 대리인 역할을 할 수 있는 유사한 개인들을 비교하고 싶어 합니다.
“사과 대 사과(apples-to-apples)”라는 표현은 서로 비교할 수 없는 두 가지를 비교한다는 뜻의 “사과와 오렌지를 비교한다(comparing apples to oranges)”는 속담에서 유래했습니다.
이는 한 가지 표현 방식일 뿐입니다. 전 세계적으로 많은 변형이 있습니다. 다음은 사람들이 비교하려고 해서는 안 되는 다른 것들입니다:
책의 약 4분의 3 정도까지 우리는 소위 비교란(unconfoundedness) 방법론들을 다룰 것입니다. 이 방법론들은 모두2 세 가지를 가정합니다: 교환 가능성(exchangeability), 긍정성(positivity), 그리고 일관성(consistency)입니다. 지금은 이 세 가지 가정에 집중하겠지만, 도구 변수 분석(장 22)이나 이중 차분법(장 23)과 같은 다른 방법론들은 다른 인과적 가정을 합니다. 방법론의 가정을 아는 것은 그것을 올바르게 사용하는 데 필수적이지만, 여러분이 해결하려는 문제에 대해 다른 방법론의 가정이 더 타당한지 고려해 볼 가치도 있습니다.
이러한 가정들은 인과 추정치를 식별하기 위해 필요하기 때문에 때때로 식별 조건(identifiability conditions)이라고 불리기도 합니다. 마찬가지로, 특정 인과 효과가 “식별 가능한지(identifiable)” 여부를 논의하는 것을 가끔 볼 수 있을 것입니다.
교환 가능성 가정은 역확률 가중치 부여 및 회귀 조정과 같은 비교란 방법론의 핵심입니다. 여기서 우리는 각 노출군이 평균적으로 동일한 잠재적 결과를 갖는다고 가정합니다. 따라서 “초콜릿” 아이스크림에 배정된 그룹은 바닐라 그룹이 (초콜릿에 배정되었을 경우 가졌을) 초콜릿에 대한 행복도와 동일한 잠재적 결과를 갖습니다. 수학적으로 교환 가능성은 \(Y(x) \perp\!\!\!\perp X\) 로 표기됩니다. 노출 상태는 잠재적 결과와 독립적입니다. 예를 들어, 초콜릿 그룹에 속한다는 사실이 바닐라 그룹에 속했을 때와 비교하여 여러분의 잠재적 결과 y(chocolate)를 변화시키지 않습니다. 이 가정이 성립할 때,리는 그림 3.1 에서처럼 바닐라 그룹을 초콜릿 그룹의 y(vanilla)에 대한 대리인으로, 그 반대의 경우도 마찬가지로 취급할 수 있습니다.
plot_data <- data_observed |>
select(starts_with("y"), exposure) |>
mutate(id = row_number()) |>
prepare_plot_data(
pivot_prefix = "y_",
potential_outcome_transform = \(x) paste0("potential outcome: y(", x, ")"),
transform_exposure = \(exp) if_else(exp == "vanilla", "실제로 바닐라를 먹음", "실제로 초콜릿을 먹음"),
id_assignment = FALSE
)
# 그룹 평균 계산 및 레이블 텍스트 추가
avg_labels <- compute_avg_labels(plot_data, c("potential_outcome", "exposure", "observed")) |>
mutate(
exposure_lbl = str_replace_all(exposure, "실제로 |를 먹음", ""),
po_lbl = str_replace_all(potential_outcome, "potential outcome: ", ""),
label = glue("평균 {po_lbl}\n({exposure_lbl} 그룹, {observed})") |> str_wrap(19)
)
# ID 3에 대한 주석 준비
id_annotation <- plot_data |>
filter(id == 3) |>
mutate(label = glue("ID 3의 잠재적 결과\n({observed})") |> str_wrap(15))
# 그룹 평균 간의 교환 가능성 주석
exchangeability_annotation <- tibble(
x = 5.43,
xend = 5.33,
y = 1,
yend = 0.5,
potential_outcome = "potential outcome: y(chocolate)",
label = str_wrap("교환 가능성이 성립하려면, 이 그룹 평균들이 비슷해야 합니다", 19)
)
ggplot(plot_data, aes(happiness, y_id, color = observed, shape = observed)) +
geom_point(aes(fill = observed), size = 3, alpha = 0.8) +
add_avg_layers(avg_labels, observed_col = ggokabeito::palette_okabe_ito(1), unobserved_col = ggokabeito::palette_okabe_ito(2)) +
geom_curve(
data = id_annotation,
mapping = aes(x = happiness + 2.5, xend = happiness + 0.5, y = y_id + 2, yend = y_id),
curvature = -0.2,
arrow = arrow(length = unit(0.02, "npc")),
inherit.aes = FALSE,
color = "grey40"
) +
geom_label(
data = id_annotation,
mapping = aes(x = happiness + 2, y = y_id + 1.5, label = label),
hjust = 0,
inherit.aes = FALSE,
color = "grey40",
size = 3.75,
label.size = NA
) +
geom_curve(
data = exchangeability_annotation,
mapping = aes(x = x + 0.5, xend = xend + 0.2, y = y + 0.5, yend = yend),
curvature = 0.1,
arrow = arrow(length = unit(0.02, "npc")),
inherit.aes = FALSE,
color = "grey40"
) +
geom_label(
data = exchangeability_annotation,
mapping = aes(x = x + 0.05, y = y, label = label),
inherit.aes = FALSE,
hjust = "left",
nudge_x = 0.5,
color = "grey40",
size = 4,
label.size = NA
) +
facet_wrap(~ potential_outcome) +
scale_y_continuous(
breaks = c(unique(plot_data$y_id), min(plot_data$y_id) - 1),
labels = c(unique(plot_data$id), expression(bold("Avg")))
) +
scale_shape_manual(
name = NULL,
values = c(19, 21)
) +
scale_fill_manual(
name = NULL,
values = c("observed" = ggokabeito::palette_okabe_ito(1), "unobserved" = "white")
) +
scale_color_manual(
name = NULL,
values = c("observed" = ggokabeito::palette_okabe_ito(1), "unobserved" = ggokabeito::palette_okabe_ito(2))
) +
scale_x_continuous(
breaks = seq(0, 12, by = 2.5),
limits = c(NA, 12)
) +
po_themeWarning: The `label.size` argument of `geom_label()` is
deprecated as of ggplot2 3.5.0.
ℹ Please use the `linewidth` argument instead.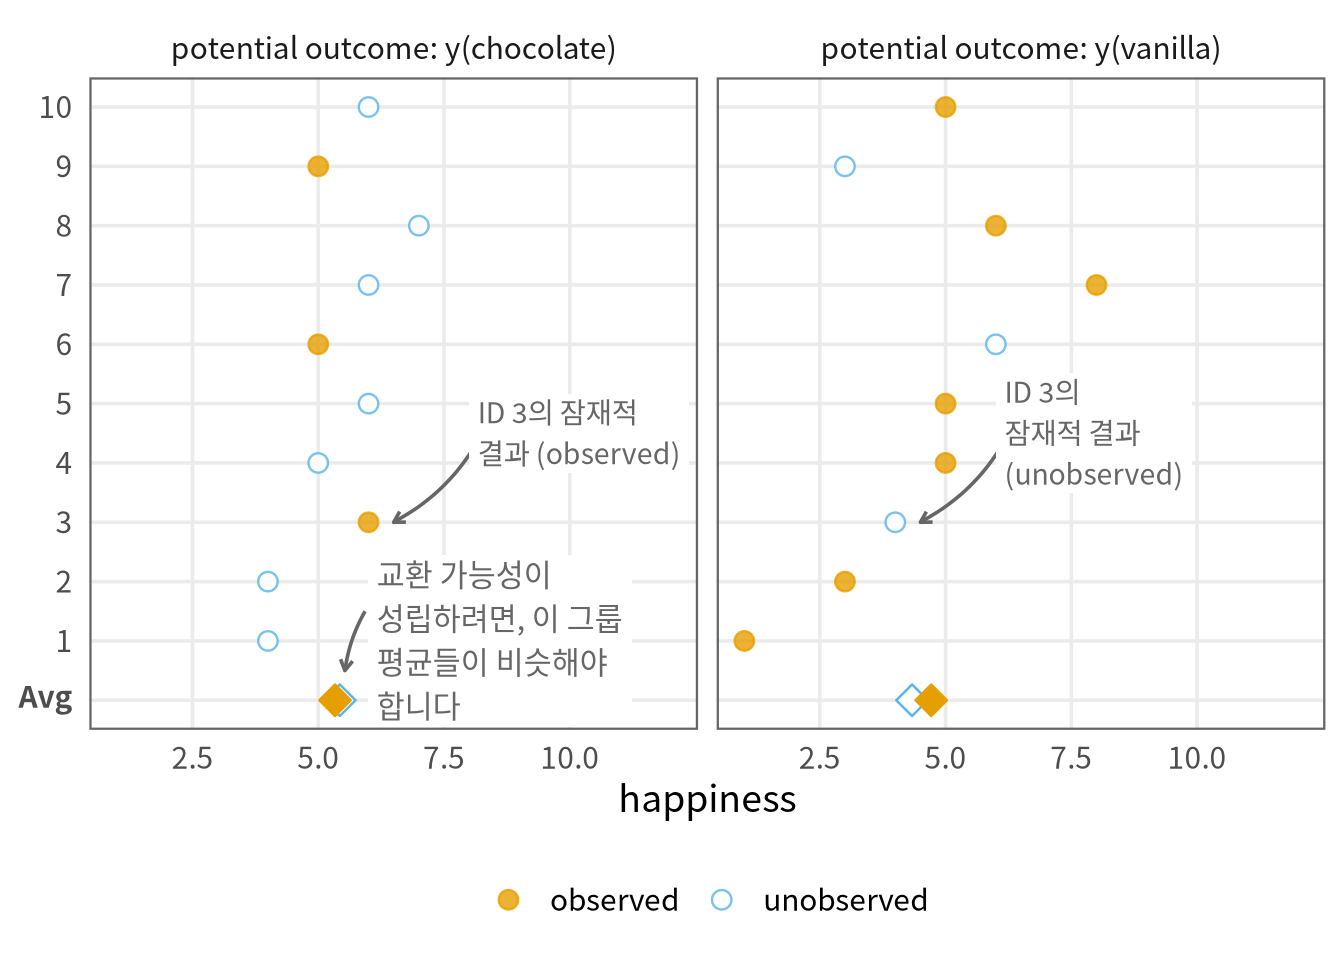
교환 가능성은 때때로 “교란 없음(no confounding)” 또는 “비교란(unconfoundedness)” 가정이라고 불리기도 합니다. 또한 때때로 “무시 가능성(ignorability)”이라고 불리기도 합니다.
교환 가능성은 앞서 아이스크림 맛 사례처럼 노출을 무작위로 배정할 때 보장됩니다. 무작위 배정 과정을 통해 교환 가능성을 생각하면 그 이름이 어디에서 유래했는지 알 수 있습니다. 누가 어떤 맛을 받았는지 레이블이 섞여서 “바닐라” 그룹에 실수로 초콜릿을 주고 “초콜릿” 그룹에 바닐라를 주었다고 가정해 봅시다. 맛 배정이 잠재적 결과와 독립적이므로 이러한 실수는 중요하지 않습니다. 할당을 뒤바꿈으로써 그룹을 교환했지만, 여전히 올바른 인과 효과를 감지할 수 있습니다3.
set.seed(11)
mix_up <- function(flavor) {
if_else(flavor == "chocolate", "vanilla", "chocolate")
}
data_observed <- data |>
mutate(
exposure = if_else(
rbinom(n(), 1, 0.5) == 1, "chocolate", "vanilla"
),
exposure = mix_up(exposure),
observed_outcome = case_when(
exposure == "chocolate" ~ y_chocolate,
exposure == "vanilla" ~ y_vanilla
)
)
data_observed |>
  group_by(exposure) |>
  summarise(avg_outcome = mean(observed_outcome))
# A tibble: 2 × 2
exposure avg_outcome
<chr> <dbl>
1 chocolate 5.43
2 vanilla 4.33그렇다면 교환 가능성이 위배된다는 것은 무엇을 의미할까요? 대신 각 참가자가 자신의 아이스크림 맛을 직접 선택하도록 허용했다고 가정해 봅시다. 80%의 경우 참가자들은 자신을 가장 행복하게 만드는 맛, 즉 자신의 선호도를 선택했습니다.
set.seed(113)
data_observed_exch <- data |>
  mutate(
    prefer_chocolate = y_chocolate > y_vanilla,
    exposure = case_when(
      # 초콜릿을 더 좋아하는 사람들은 80%의 확률로 그것을 선택했습니다
      prefer_chocolate ~ if_else(
        rbinom(n(), 1, 0.8) == 1,
        "chocolate",
        "vanilla"
      ),
      # 바닐라를 더 좋아하는 사람들은 80%의 확률로 그것을 선택했습니다
      !prefer_chocolate ~ if_else(
        rbinom(n(), 1, 0.8) == 1,
        "vanilla",
        "chocolate"
      )
    ),
    observed_outcome = case_when(
      exposure == "chocolate" ~ y_chocolate,
      exposure == "vanilla" ~ y_vanilla
    )
  )
이제 바닐라가 여러분을 더 행복하게 만드는 것처럼 보입니다!
# A tibble: 2 × 2
  exposure  avg_outcome
  <chr>           <dbl>
1 chocolate        5.29
2 vanilla          5.67
왜 이런 일이 일어날까요? 우리는 장 4 와 그 이후에서 이 문제를 더 깊이 탐구하겠지만, 가정의 관점에서 보면 교환 가능성이 더 이상 성립하지 않기 때문입니다. 두 노출군에 대해 잠재적 결과가 평균적으로 더 이상 동일하지 않습니다. y(chocolate)의 평균값은 여전히 꽤 가깝지만, y(vanilla)는 그룹별로 상당히 다릅니다. 바닐라 그룹은 더 이상 초콜릿 그룹의 잠재적 결과에 대한 좋은 대리인 역할을 하지 못하며, 우리는 편향된 결과를 얻게 됩니다. 여기서 우리가 보는 것은 실제로는 y(flavor, preference)에 대한 잠재적 결과입니다. 개별 인과 효과가 0이 아닌 개인들이 존재하기 때문에 이는 항상 사실입니다. 바뀐 점은 잠재적 결과가 더 이상 개인이 어떤 flavor를 가졌는지와 독립적이지 않다는 것입니다: 그들의 선호도가 맛의 선택과 잠재적 결과 모두에 영향을 미칩니다. 그림 3.2 에서 볼 수 있듯이, 우리 그룹들은 더 이상 교환 가능하지 않습니다; 그들은 y(vanilla)에 대해 평균적으로 동일한 잠재적 결과를 갖지 않습니다.
data_observed_exch |>
  select(starts_with("y"), exposure) |>
  pivot_longer(
    starts_with("y"),
    names_prefix = "y_",
    names_to = "potential_outcome",
    values_to = "happiness"
  ) |>
  mutate(
    observed = if_else(exposure == potential_outcome, "observed", "unobserved"),
    potential_outcome = paste0("잠재적 결과: y(", potential_outcome, ")"),
    exposure = if_else(exposure == "vanilla", "실제로 바닐라를\n먹음", "실제로 초콜릿을\n먹음")
  ) |>
  ggplot(aes(happiness, exposure, color = observed, fill = observed, shape = observed)) +
  stat_summary(
    fun = "mean",
    size = 3.5,
    geom = "point",
    shape = 23,
    position = position_nudge(y = 0.033)
  ) +
  stat_summary(
    fun = "mean",
    geom = "text",
    aes(label = round(after_stat(x), 1)),
    vjust = 1.8,
    show.legend = FALSE
  ) +
  facet_wrap(~ potential_outcome) +
  theme(
    panel.grid.major.y = element_blank(),
    panel.border = element_rect(color = "grey40", fill = NA, linewidth = 0.8),
    axis.title.y = element_blank()
  ) +
  labs(
    y = "실제 노출",
    color = NULL,
    shape = NULL,
    fill = NULL
  ) +
  coord_cartesian(clip = "off") +
  scale_shape_manual(values = c(19, 21)) +
  scale_fill_manual(values = c(observed = ggokabeito::palette_okabe_ito(1), unobserved = "white")) +
scale_x_continuous(breaks = seq(0, 12, by = 2.5), limits = c(-2, 12)) 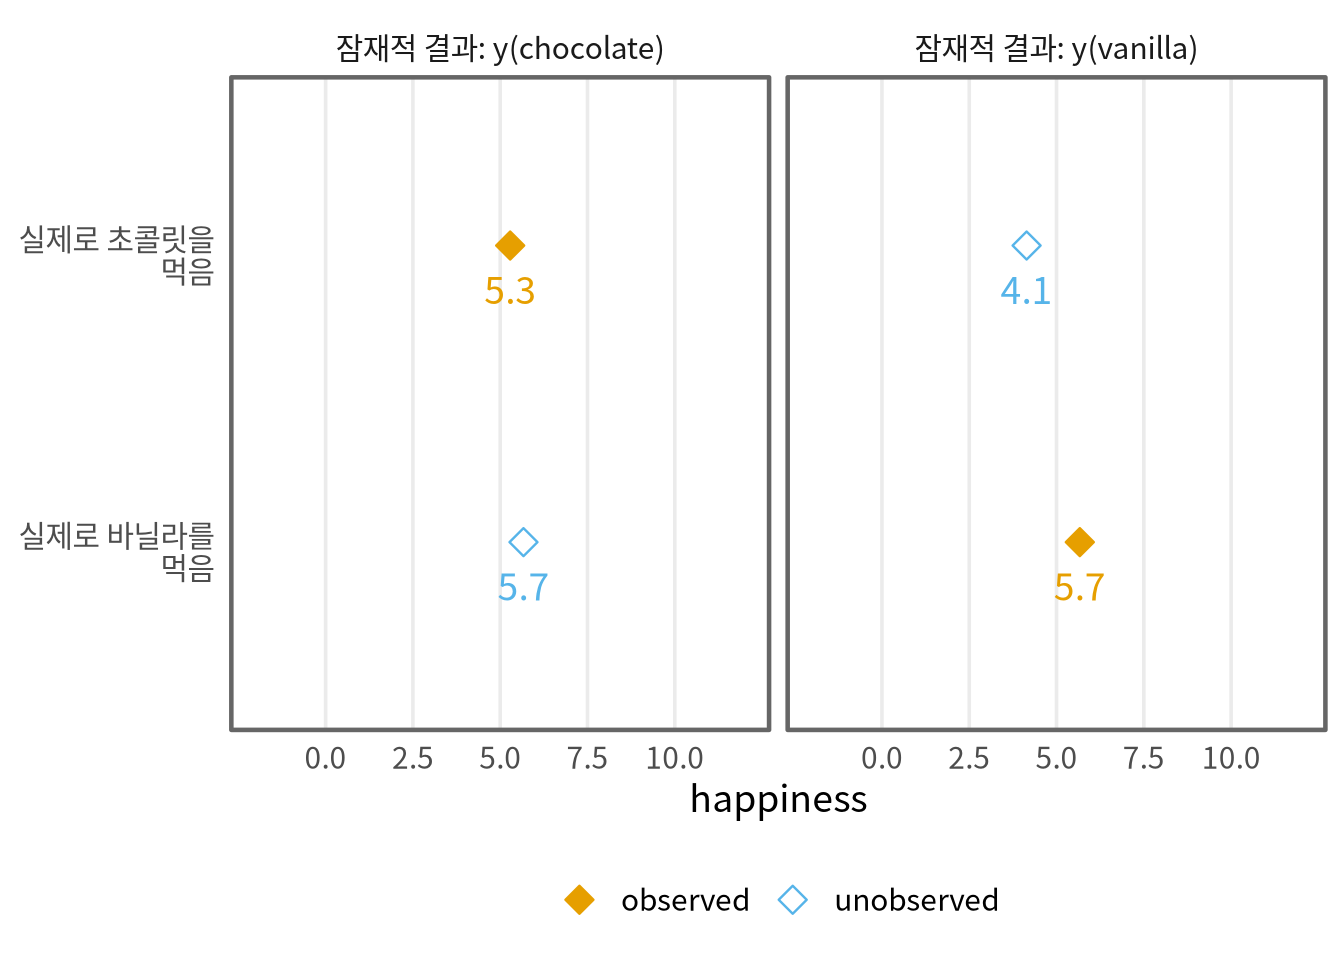
교환 가능성이 위배될 때 우리는 무엇을 할 수 있을까요? 책 전반에 걸쳐 우리는 이 문제에 많은 시간을 할애할 것입니다. 하지만 해결책의 핵심은, 때때로 다른 변수의 수준 내에서 여전히 교환 가능성을 달성할 수 있다는 점입니다. 이를 조건부 교환 가능성(conditional exchangeability)이라고 부릅니다: \(Y(x) \perp\!\!\!\perp X \mid Z\). 이 사례에서는 prefer_chocolate의 수준 내에서 교환 가능성이 필요합니다.
data_observed_exch |>
  mutate(prefer_chocolate = if_else(
    prefer_chocolate,
    "초콜릿을\n선호함",
    "바닐라를\n선호함"
  )) |>
  pivot_longer(
    starts_with("y"),
    names_prefix = "y_",
    names_to = "potential_outcome",
    values_to = "happiness"
  ) |>
  mutate(
    observed = if_else(exposure == potential_outcome, "observed", "unobserved"),
    potential_outcome = paste0("potential outcome: y(", potential_outcome, ")"),
    exposure = if_else(exposure == "vanilla", "실제로 바닐라를\n먹음", "실제로 초콜릿을\n먹음")
  ) |>

  ggplot(aes(happiness, exposure, color = observed, fill = observed, shape = observed)) +
  stat_summary(
    fun = "mean",
    size = 3.5,
    geom = "point",
    shape = 23,
    position = position_nudge(y = 0.033)
  ) +
  stat_summary(
    fun = "mean",
    geom = "text",
    aes(label = round(after_stat(x), 1)),
    vjust = 1.8,
    show.legend = FALSE
  ) +
  facet_grid(prefer_chocolate ~ potential_outcome) +
  theme(
    panel.grid.major.y = element_blank(),
    panel.border = element_rect(color = "grey40", fill = NA, linewidth = 0.8),
    axis.title.y = element_blank()
  ) +
  labs(
    y = "실제 노출",
    color = NULL,
    shape = NULL,
    fill = NULL
  ) +
  coord_cartesian(clip = "off") +
  scale_shape_manual(values = c(19, 21)) +
  scale_fill_manual(values = c(observed = ggokabeito::palette_okabe_ito(1), unobserved = "white")) +
scale_x_continuous(breaks = seq(0, 12, by = 2.5), limits = c(-2, 12)) 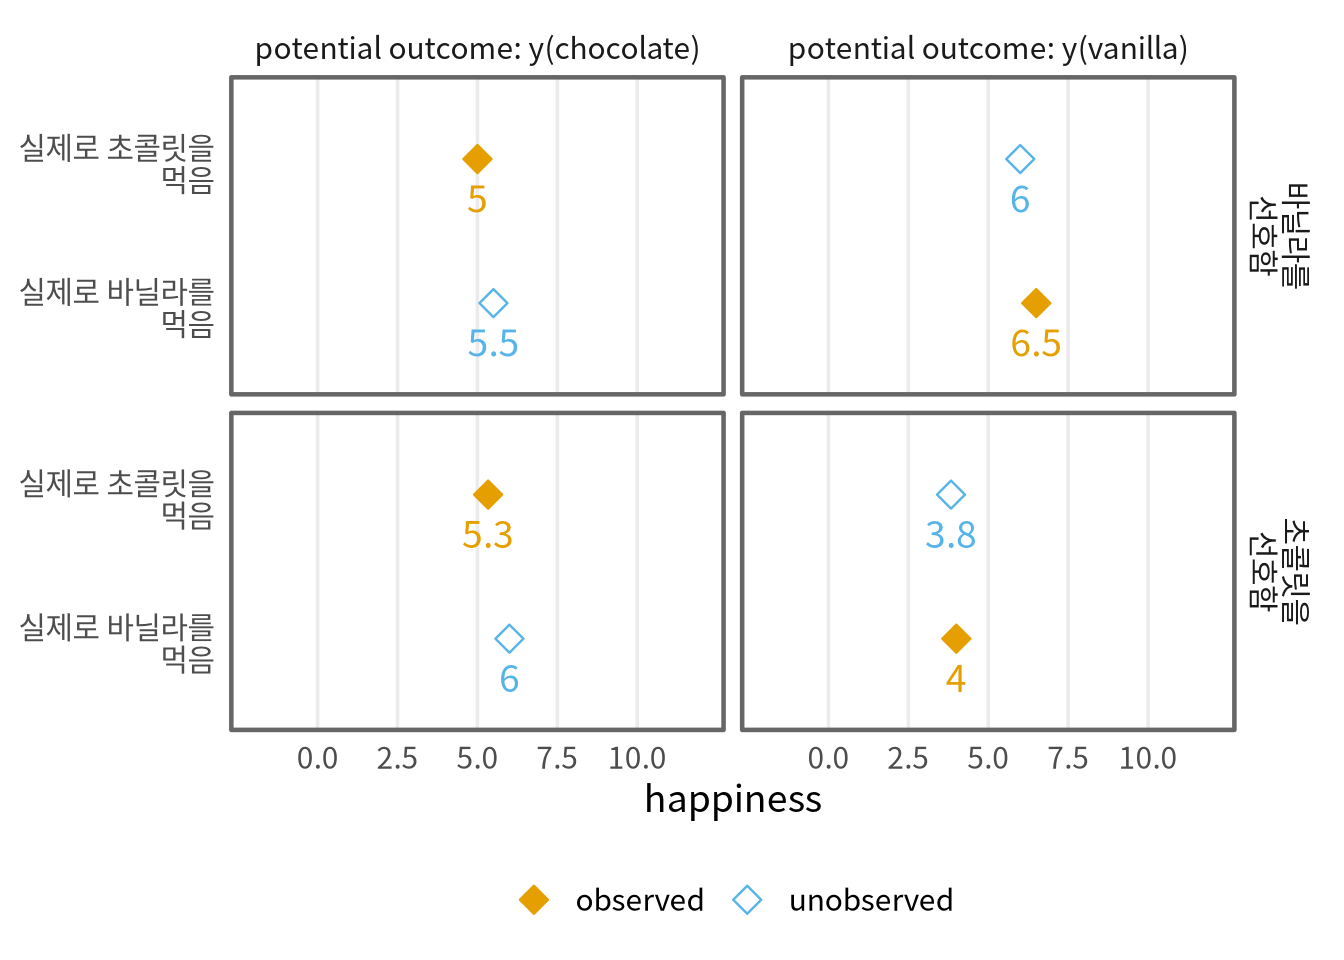
그림 3.3 에서 우리는 이미 차원의 저주를 만나기 시작했습니다: 표본 크기가 너무 작아서 노출과 선호도의 조합에 대한 값이 매우 적습니다. 표본 크기가 커질수록 더 나은 교환 가능성을 달성하겠지만, 좋은 통계 모델 없이는 이것이 금세 어려워집니다.
긍정성 가정은 모든 개인이 각 수준의 노출을 받을 확률이 0보다 크다는 것을 의미합니다. 수학적으로 이는 모든 \(x\) 에 대해 \(P(X = x) > 0\) 임을 의미합니다. 다시 말해, 우리는 하나 이상의 노출 수준이 불가능한 사람이 아무도 없다고 가정합니다. 우리가 이 가정을 필요로 하는 이유는 그것이 주어진 노출 수준에 대한 잠재적 결과를 정의하기 때문입니다. 만약 누군가가 어떤 상황에서도 초콜릿에 노출될 일이 없다면, 그 사람에게 y(chocolate)라는 잠재적 결과는 정의되지 않습니다. 우리는 그들을 이 잠재적 결과에 대한 정보를 제공하는 데 사용할 수 없습니다. 무작위 시험에서 노출 확률은 설계에 의해 알려져 있습니다. 아이스크림 예시에서 모든 사람은 동일한 확률을 가졌습니다: 초콜릿을 받을 확률 50%, 바닐라를 받을 확률 50%입니다. 이러한 가능성들이 두 그룹 모두에 대해 두 잠재적 결과를 모두 정의합니다.
때때로 긍정성은 확률론적 가정(probabilistic assumption)이라고 불리기도 합니다.
긍정성 위배는 두 가지 형태로 나타납니다: 확률적(stochastic) 위배와 구조적(structural) 위배입니다. 확률적 위배는 주어진 노출 수준에 대한 관측치가 하나도 없는 우연한 발생입니다. 참가자의 80%가 자신을 가장 행복하게 만들 아이스크림을 선택하는 예시에서, 표본 크기가 작을 경우 우연히 초콜릿만 선택하는 사람들만 남게 될 수도 있습니다. 당연히, 바닐라에 대한 관측치가 있어야만 바닐라 대 초콜릿의 효과를 계산할 수 있습니다.
긍정성의 미묘한 점은 교환 가능성에 필요한 모든 공변량의 수준 내에서 긍정성이 유지되어야 한다는 것입니다: 모든 \(x\) 와 \(z\) 에 대해 \(P(X = x \mid Z = z) > 0\) 이어야 합니다. 맛이 다양하더라도, prefer_chocolate의 수준 내에서도 다양성이 필요합니다. 이 또한 우연히 실패할 수 있습니다.
set.seed(1)
data_observed_pos <- data |>
  mutate(
    prefer_chocolate = y_chocolate > y_vanilla,
    exposure = case_when(
      prefer_chocolate ~ if_else(
        rbinom(n(), 1, 0.8) == 1,
        "chocolate",
        "vanilla"
      ),
      !prefer_chocolate ~ if_else(
        rbinom(n(), 1, 0.8) == 1,
        "vanilla",
        "chocolate"
      )
    ),
    observed_outcome = case_when(
      exposure == "chocolate" ~ y_chocolate,
      exposure == "vanilla" ~ y_vanilla
    )
  )

data_observed_pos |>
  count(prefer_chocolate, exposure) |>
  complete(
    prefer_chocolate,
    exposure = c("chocolate", "vanilla"),
    fill = list(n = 0)
  )
# A tibble: 4 × 3
prefer_chocolate exposure n
<lgl> <chr> <int>
1 FALSE chocolate 0
2 FALSE vanilla 3
3 TRUE chocolate 7
4 TRUE vanilla 0구조적 긍정성 위배는 개인이 정의상 적어도 하나의 노출 수준을 받을 수 없는 경우입니다. 참가자 중 일부가 바닐라 알레르기가 있다고 가정해 봅시다. 무작위 설정에서도 이 참가자들은 바닐라를 먹을 수 없습니다. 이 경우, 바닐라를 배정받은 바닐라 알레르기 환자는 모두 초콜릿으로 바꾼다고 가정해 봅시다.
set.seed(11)
data_observed_struc <- data |>
  mutate(
    exposure = if_else(
      rbinom(n(), 1, 0.5) == 1,
      "chocolate",
      "vanilla"
    )
  )

set.seed(1)
data_observed_struc <- data_observed_struc |>
  mutate(
    # 알레르기 확률 30%
    allergy = rbinom(n(), 1, 0.3) == 1,
    # 이 경우 `y_vanilla`는 불가능함
    exposure = if_else(allergy, "chocolate", exposure),
    y_vanilla = if_else(allergy, NA, y_vanilla),
    observed_outcome = case_when(
      # 알레르기가 있는 사람들은 항상 초콜릿을 선택함
      allergy ~ y_chocolate,
      exposure == "chocolate" ~ y_chocolate,
      exposure == "vanilla" ~ y_vanilla
    )
  )
이제 우리의 추정치가 꽤 많이 빗나갑니다.
# A tibble: 2 × 2
  exposure  avg_outcome
  <chr>           <dbl>
1 chocolate         5.4
2 vanilla           4
바닐라 알레르기가 있는 사람들에게 y_vanilla는 그림 3.4 에서 보듯이 정의되지 않습니다.
plot_data <- data_observed_struc |>
  mutate(is_missing_y_vanilla = is.na(y_vanilla)) |>
  select(id, starts_with("y"), exposure, is_missing_y_vanilla) |>
  prepare_plot_data(
    pivot_prefix = "y_",
    potential_outcome_transform = \(x) paste0("y(", x, ")"),
    transform_exposure = \(exp) if_else(exp == "vanilla", "실제로 바닐라를 먹음", "실제로 초콜릿을 먹음"),
    id_assignment = FALSE
  )

avg_labels <- compute_avg_labels(plot_data, c("potential_outcome", "exposure", "observed")) |>
  mutate(
    exposure_lbl = str_replace_all(exposure, "실제로 |를 먹음", ""),
    po_lbl = str_replace_all(potential_outcome, "potential outcome: ", ""),
    label = glue("평균 {po_lbl}\n({exposure_lbl} 그룹, {observed})") |> str_wrap(19)
  )

# 초콜릿 쪽에서 누락된 y(vanilla) 지점들
missing_points <- plot_data |>
  filter(is_missing_y_vanilla, exposure == "실제로 초콜릿을 먹음") |>
  select(happiness, y_id) |>
  drop_na()

# 누락된 지점들에 대한 주석
missing_annotation <- tibble(
  x = max(missing_points$happiness, na.rm = TRUE) + 1,
  y = max(missing_points$y_id, na.rm = TRUE) - 1,
  label = "누락된 y(vanilla)\n대응치",
  potential_outcome = "y(chocolate)"
)

# 주석에서 누락된 지점들로 향하는 화살표
missing_arrows <- missing_points |>
  mutate(
    xend = happiness + 0.3,
    yend = y_id - c(-0.3, 0, 0.3),
    x = missing_annotation$x,
    y = missing_annotation$y,
    potential_outcome = "y(chocolate)"
  )

ggplot(
  plot_data,
  aes(
    x = happiness,
    y = y_id,
    color = is_missing_y_vanilla,
    fill = is_missing_y_vanilla,
    shape = observed
  )
) +
  geom_point(
    data = plot_data |> filter(observed == "observed"),
    mapping = aes(fill = is_missing_y_vanilla),
    size = 3,
    shape = 21,
    alpha = 0.8
  ) +
  geom_point(
    data = plot_data |> filter(observed == "unobserved"),
    mapping = aes(x = happiness, y = y_id),
    size = 3,
    shape = 21,
    fill = "white",
    color = "grey70",
    alpha = 0.8,
    inherit.aes = FALSE
  ) +
  add_avg_layers(avg_labels) +
  geom_curve(
    data = missing_arrows,
    mapping = aes(x = x, xend = xend, y = y, yend = yend),
    curvature = 0,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = missing_annotation,
    mapping = aes(x = x, y = y, label = label),
    hjust = 0,
    inherit.aes = FALSE,
    color = "grey40",
    size = 4.5,
    label.size = NA
  ) +
  facet_wrap(~ potential_outcome) +
  scale_y_continuous(
    breaks = c(unique(plot_data$y_id), min(plot_data$y_id) - 1),
    labels = c(unique(plot_data$id), expression(bold("평균(Avg)")))
  ) +
  scale_shape_manual(values = c(19, 21)) +
  scale_fill_manual(
    name = NULL,
    values = c("TRUE" = ggokabeito::palette_okabe_ito(7)),
    labels = c("TRUE" = "누락된 y(vanilla) 대응치"),
    na.value = "grey80"
  ) +
  scale_color_manual(
    name = NULL,
    values = c("TRUE" = ggokabeito::palette_okabe_ito(7)),
    labels = c("TRUE" = "누락된 y(vanilla) 대응치"),
    na.value = "grey80"
  ) +
  scale_x_continuous(breaks = seq(0, 12, by = 2.5), limits = c(NA, 12)) +
  po_theme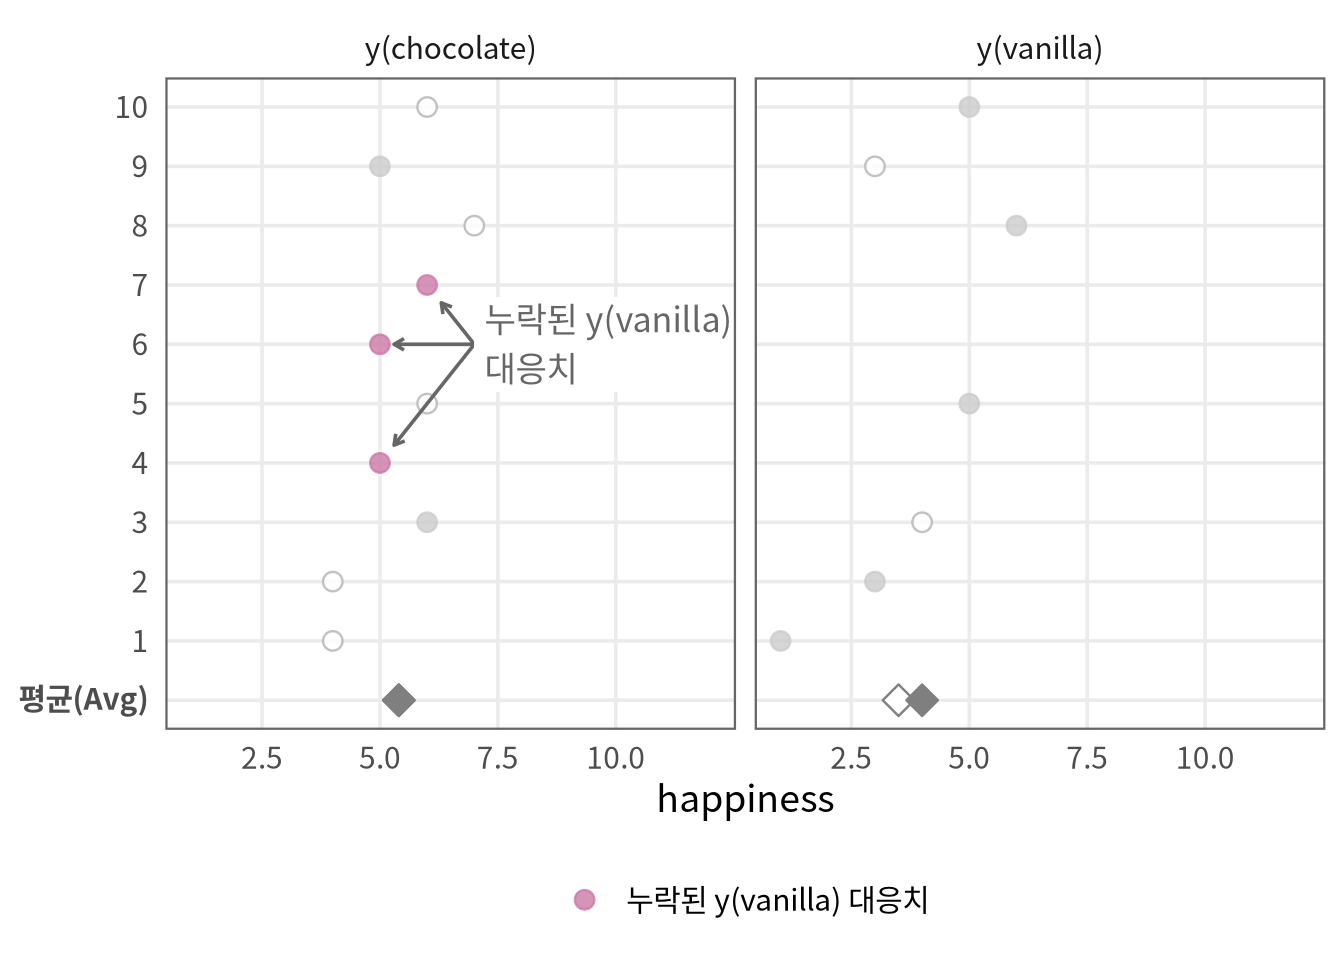
y(vanilla)를 갖지 않습니다.
긍정성 문제를 개선하는 몇 가지 방법이 있습니다. 확률적 긍정성 위배라면 데이터를 더 수집할 수 있습니다. 표본 크기를 늘리면 확률적 위배가 발생할 가능성이 줄어듭니다. 그러나 모든 공변량의 조합 내에서 긍정성이 요구되므로, 종속 데이터 차원을 가로질러 외삽(extrapolate)하기 위해 통계 모델을 사용해야 할 때가 많습니다. 자세한 내용은 장 8장과 장 13장에서 다루겠습니다. 또한 특정 노출 수준이 불가능한 사람을 제외하도록 적격성 기준(eligibility criteria, 섹션 3.4.2 참조)을 명시할 수 있습니다. 특정 교란 요인 내에서 긍정성이 문제라면 해당 요인을 제거하는 것도 고려해 볼 만합니다. 교란 요인을 통제하지 않아 발생하는 편향보다 긍정성 위배로 인한 편향이 작다면 그럴 가치가 있습니다. 마지막으로 추정하려는 인과 추정 대상(causal estimand)을 수정할 수 있습니다. sec-estimands장에서 보겠지만, 인과 효과마다 인과적 가정을 충족하는 엄격함의 정도가 다릅니다.
일관성은 여러분이 답하고 있다고 주장하는 인과적 질문이 여러분이 분석을 통해 실제로 답하고 있는 질문과 일치한다고 가정합니다. 일관성은 우리가 각 그룹에 대해 잠재적 결과 중 하나인 사실적(factual) 결과를 볼 수 있게 해줍니다. 수학적으로 이는 \(Y_{obs} = (X)Y(1) + (1 - X)Y(0)\) 임을 의미합니다. 쉬운 말로 하면, 일관성 가정은 특정 처치 값의 잠재적 결과가 누군가가 그 처치 값을 배정받았을 때 우리가 실제로 관찰하는 값과 동일하다는 것을 말합니다. 이렇게 말하면 거의 우스꽝스러울 정도로 당연해 보입니다. 그게 아니면 또 무엇이겠어요? 하지만 이 문제를 깊이 생각해 보면, 이 가정이 어떤 노출에 대해서든 쉽게 위배될 수 있음을 알게 될 것입니다. 두 가지 일반적인 경우를 고려해 봅시다:
일관성은 때때로 안정적 단위 처치값 가정(stable-unit-treatment-value assumption) 또는 SUTVA라고 불리기도 합니다 (Imbens 와/과 Rubin 2015). 그러나 인과적 일관성은 통계적 일관성(표본 크기가 커짐에 따라 추정량이 참값에 가까워지는 속성)과는 별개의 개념입니다.
일관성 위배는 노출이 제대로 정의되지 않았을 때 흔히 발생합니다. 수술(한 의사가 다른 의사보다 수술 절차에 더 숙련된 경우)부터 소득(모든 소득원이 달러 대 달러로 동일한가? 복권 당첨금이 주급과 같은가?), 교육(교육 연수가 학교의 질에 관계없이 동일한 효과를 갖는가?) 등 많은 분야에서 나타납니다 (Rehkopf, Glymour, 와/과 Osypuk 2016).
두 통의 초콜릿 아이스크림이 있는데 그중 하나가 상했다고 가정해 봅시다. “초콜릿”에 노출된다는 것은 개인이 푼 아이스크림이 어디서 왔느냐(일반 초콜릿 아이스크림인가 아니면 상한 초콜릿 아이스크림인가)에 따라 서로 다른 의미를 가질 수 있습니다; 우리는 이들을 하나의 용어로 묶어서 취급하고 있습니다. 상한 아이스크림을 먹는 것은 여러분이 일반적으로 초콜릿 아이스크림에 대해 어떻게 느끼는지와 관계없이 여러분을 비참하게 만들 것이므로, 이는 동일한 잠재적 결과가 아닙니다.
data <- tibble(
  id = 1:10,
  y_spoiled_chocolate = c(0, 0, 0, 0, 0, 0, 0, 0, 0, 0),
  y_chocolate = c(4, 4, 6, 5, 6, 5, 6, 7, 5, 6),
  y_vanilla = c(1, 3, 4, 5, 5, 6, 8, 6, 3, 5)
) |>
  mutate(causal_effect = y_chocolate - y_vanilla)

set.seed(11)
data_observed_poorly_defined <- data |>
  mutate(
    exposure_unobserved = case_when(
      rbinom(n(), 1, 0.25) == 1 ~ "chocolate (spoiled)",
      rbinom(n(), 1, 0.25) == 1 ~ "chocolate",
      .default = "vanilla"
    ),
    observed_outcome = case_match(
      exposure_unobserved,
      "chocolate (spoiled)" ~ y_spoiled_chocolate,
      "chocolate" ~ y_chocolate,
      "vanilla" ~ y_vanilla
    ),
    exposure = case_match(
      exposure_unobserved,
      c("chocolate (spoiled)", "chocolate") ~ "chocolate",
      "vanilla" ~ "vanilla"
    )
  )
Warning: There was 1 warning in `mutate()`.
ℹ In argument: `observed_outcome = case_match(...)`.
Caused by warning:
! `case_match()` was deprecated in dplyr 1.2.0.
ℹ Please use `recode_values()` instead.우리는 표본에서 (상하지 않은) 초콜릿의 진정한 평균 인과 효과가 0.8라는 것을 알고 있습니다. 하지만 우리의 추정된 인과 효과는 1.1입니다.
# A tibble: 2 × 2
  exposure  avg_outcome
  <chr>           <dbl>
1 chocolate        2.75
2 vanilla          4.67
우리가 추정하고 있다고 생각하는 잠재적 결과는 우리가 실제로 관찰하고 있는 것이 아닙니다. 우리는 신선한 초콜릿 아이스크림과 상한 초콜릿 아이스크림을 동일한 노출로 취급하고 있지만, 그들은 잠재적 결과에 서로 다른 영향을 미칩니다. 노출이 무작위이기 때문에, 우리는 사실 y(chocolate, spoiled = FALSE) | y(chocolate, spoiled = TRUE)의 효과를 추정하는 일을 꽤 잘 해내고 있지만, 그것은 우리가 관심을 갖는 것이 아닙니다. 우리는 단지 y(chocolate, spoiled = FALSE)를 원할 뿐입니다.
plot_data <- data_observed_poorly_defined |>
  mutate(is_spoiled = exposure_unobserved == "chocolate (spoiled)") |>
  pivot_longer(
    cols = starts_with("y"),
    names_prefix = "y_",
    names_to = "potential_outcome",
    values_to = "happiness"
  ) |>
  filter(
    !(is_spoiled & potential_outcome == "chocolate"),
    !(is_spoiled == FALSE & potential_outcome == "spoiled_chocolate")
  ) |>
  mutate(
    potential_outcome = case_when(
      potential_outcome == "spoiled_chocolate" ~ "chocolate",
      TRUE ~ potential_outcome
    ),
    observed = if_else(exposure == potential_outcome, "observed", "unobserved"),
    potential_outcome = paste0("y(", potential_outcome, ")")
  ) |>
  mutate(observed = factor(observed, levels = c("observed", "unobserved"))) |>
  arrange(id) |>
  mutate(y_id = dense_rank(id))

avg_labels <- compute_avg_labels(plot_data, c("potential_outcome", "exposure", "observed"))

# 상한 초콜릿에 대한 주석
spoiled_annotation <- plot_data |>
  filter(is_spoiled, potential_outcome == "y(chocolate)") |>
  slice(1) |>
  mutate(label = "초콜릿이 상했습니다")

spoiled_arrows <- plot_data |>
  filter(is_spoiled, potential_outcome == "y(chocolate)") |>
  mutate(
    xend = happiness + c(0.35, 0.05),
    yend = y_id - c(0, 0.2),
    x = spoiled_annotation$happiness + 1.9,
    y = spoiled_annotation$y_id + 0.5
  )

flawed_avg_annotation <- avg_labels |>
  filter(potential_outcome == "y(chocolate)", exposure == "chocolate", observed == "observed") |>
  mutate(
    label = "두 잠재적 결과의\n평균입니다",
    x = happiness + 2.25,
    y = y_id + .9,
    happiness = happiness + 0.25,
    y_id = y_id + 0.15
  )

unspoiled_annotation <- plot_data |>
  filter(!is_spoiled, exposure == "chocolate", potential_outcome == "y(chocolate)", observed == "observed") |>
  slice(1) |>
  mutate(
    label = "하지만 이들은\n상하지 않았습니다",
    x = happiness + 2,
    y = y_id
  )

unspoiled_arrows <- plot_data |>
  filter(!is_spoiled, exposure == "chocolate", potential_outcome == "y(chocolate)", observed == "observed") |>
  mutate(
    xend = happiness + 0.35,
    yend = y_id - c(0.1, 0.2),
    x = unspoiled_annotation$x,
    y = unspoiled_annotation$y
  )

ggplot(plot_data, aes(x = happiness, y = y_id)) +
  geom_point(
    data = plot_data |> filter(!is_spoiled, observed == "observed"),
    size = 3,
    shape = 21,
    fill = "grey50",
    color = "grey50",
    alpha = 0.8
  ) +
  geom_point(
    data = plot_data |> filter(!is_spoiled, observed == "unobserved"),
    size = 3,
    shape = 21,
    fill = "white",
    color = "grey50",
    alpha = 0.8
  ) +
  geom_point(
    data = plot_data |> filter(is_spoiled, potential_outcome == "y(chocolate)", observed == "observed"),
    size = 3,
    shape = 21,
    fill = ggokabeito::palette_okabe_ito(7),
    color = ggokabeito::palette_okabe_ito(7),
    alpha = 0.8
  ) +
  geom_point(
    data = plot_data |> filter(is_spoiled, potential_outcome == "y(chocolate)", observed == "unobserved"),
    size = 3,
    shape = 21,
    fill = "white",
    color = ggokabeito::palette_okabe_ito(7),
    alpha = 0.8
  ) +
  add_avg_layers(avg_labels) +
  geom_curve(
    data = spoiled_arrows,
    mapping = aes(x = x, xend = xend, y = y, yend = yend),
    curvature = -0.2,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = spoiled_annotation,
    mapping = aes(x = happiness + 2, y = y_id + 0.5, label = label),
    hjust = 0,
    inherit.aes = FALSE,
    color = "grey40",
    size = 4,
    label.size = NA
  ) +
  geom_curve(
    data = flawed_avg_annotation,
    mapping = aes(x = x, xend = happiness, y = y, yend = y_id),
    curvature = 0.2,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = flawed_avg_annotation,
    mapping = aes(x = x, y = y, label = label),
    hjust = 0,
    inherit.aes = FALSE,
    color = "grey40",
    size = 4,
    label.size = NA
  ) +
  geom_curve(
    data = unspoiled_arrows,
    mapping = aes(x = x, xend = xend, y = y, yend = yend),
    curvature = -0.2,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = unspoiled_annotation,
    mapping = aes(x = x, y = y, label = label),
    hjust = 0,
    inherit.aes = FALSE,
    color = "grey40",
    size = 4,
    label.size = NA
  ) +
  facet_wrap(~ potential_outcome) +
  scale_y_continuous(
    breaks = c(unique(plot_data$y_id), min(plot_data$y_id) - 1),
    labels = c(unique(plot_data$id), expression(bold("Avg")))
  ) +
  scale_x_continuous(breaks = seq(0, 12, by = 2.5), limits = c(NA, 12)) +
  labs(y = "실제 노출") +
  po_theme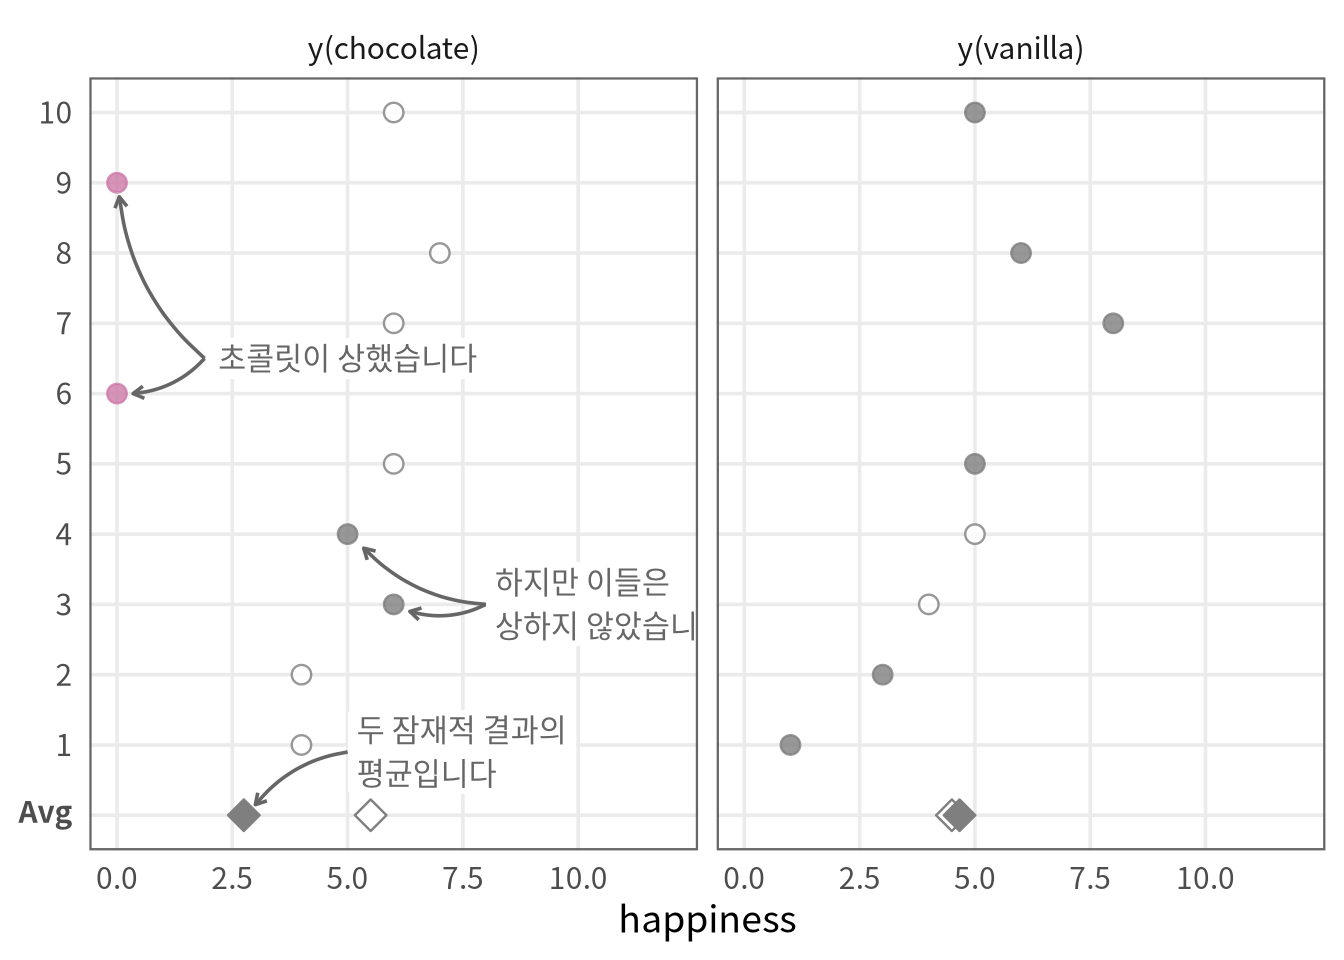
y(chocolate)를 대표하는 것으로 취급하고 있지만, 이는 사실이 아닙니다. 데이터는 서로 다른 잠재적 결과인 y(chocolate, spoiled = FALSE)와 y(chocolate, spoiled = TRUE)의 혼합을 나타냅니다.
우리는 처치 과정에서 미세한 변화가 발생하는 다른 방식들을 상상할 수 있습니다: 고품질 및 저품질 브랜드의 바닐라 아이스크림이 모두 “바닐라”로 분류되는 경우입니다. 한 사람은 아침에 먹고 다른 사람은 오후에 먹는 경우입니다. 누군가는 한 숟가락만 먹고 누군가는 세 그릇을 가득 먹는 경우입니다. 이런 의미에서의 일관성 위배는 거의 항상 어느 정도 존재하기 마련입니다; 우리에게 중요한 질문은 그 위배가 우리가 관찰하는 잠재적 결과와 관련하여 유의미한지 여부입니다. 만약 두 브랜드의 아이스크림이 동일한 행복도를 만들어낸다면, 이러한 변화는 중요하지 않습니다. 만약 차이가 있다면, 그 차이는 얼마나 클까요?
보다 구체적으로 노출을 정의하는 것 외에도 일관성 위배를 해결하는 한 가지 방법은 처치 수준 내에서의 잠재적 편차를 조사하는 것입니다. 실험 후에 아이스크림 통을 테스트하여 아이스크림이 상했는지 여부에 대한 데이터를 확보했다고 가정해 봅시다. 이제 우리는 실제 노출 상태에 따라 그룹을 나눌 수 있습니다.
# A tibble: 3 × 2
  exposure_unobserved avg_outcome
  <chr>                     <dbl>
1 chocolate                  5.5
2 chocolate (spoiled)        0
3 vanilla                    4.67
이제 분석에서 잠재적 결과들을 올바르게 분리했기 때문에 그림 3.6 에서처럼 정답으로 돌아왔습니다.
plot_data <- data_observed_poorly_defined |>
  pivot_longer(
    cols = starts_with("y"),
    names_prefix = "y_",
    names_to = "potential_outcome",
    values_to = "happiness"
  ) |>
  mutate(
    potential_outcome = if_else(potential_outcome == "spoiled_chocolate", "chocolate (spoiled)", potential_outcome),
    observed = if_else(exposure_unobserved == potential_outcome, "observed", "unobserved"),
    potential_outcome = if_else(potential_outcome == "chocolate (spoiled)", "spoiled_chocolate", potential_outcome),
    potential_outcome = paste0("y(", potential_outcome, ")")
  ) |>
  arrange(id) |>
  mutate(y_id = dense_rank(id))

avg_labels <- compute_avg_labels(plot_data, c("potential_outcome", "exposure_unobserved", "observed"))

ggplot(plot_data, aes(x = happiness, y = y_id, color = exposure_unobserved)) +
  geom_point(
    data = plot_data |> filter(observed == "observed"),
    mapping = aes(fill = exposure_unobserved),
    size = 3,
    shape = 21,
    alpha = 0.8
  ) +
  geom_point(
    data = plot_data |> filter(observed == "unobserved"),
    size = 3,
    shape = 21,
    fill = "white",
    alpha = 0.8
  ) +
  geom_point(
    data = avg_labels |> filter(observed == "unobserved"),
    aes(x = happiness, y = y_id, color = exposure_unobserved),
    size = 4,
    shape = 23,
    fill = "white",
    inherit.aes = FALSE
  ) +
  geom_point(
    data = avg_labels |> filter(observed == "observed"),
    aes(x = happiness, y = y_id, fill = exposure_unobserved, color = exposure_unobserved),
    size = 4,
    shape = 23,
    inherit.aes = FALSE
  ) +
  facet_wrap(~ potential_outcome) +
  scale_y_continuous(
    breaks = c(unique(plot_data$y_id), min(plot_data$y_id) - 1),
    labels = c(unique(plot_data$id), expression(bold("Avg")))
  ) +
  scale_fill_manual(values = ggokabeito::palette_okabe_ito(c(1, 2, 7))) +
  scale_color_manual(values = ggokabeito::palette_okabe_ito(c(1, 2, 7))) +
  scale_x_continuous(breaks = seq(0, 12, by = 2.5), limits = c(NA, 12)) +
  labs(
    y = "실제 노출",
    color = NULL,
    fill = NULL
  ) +
  po_theme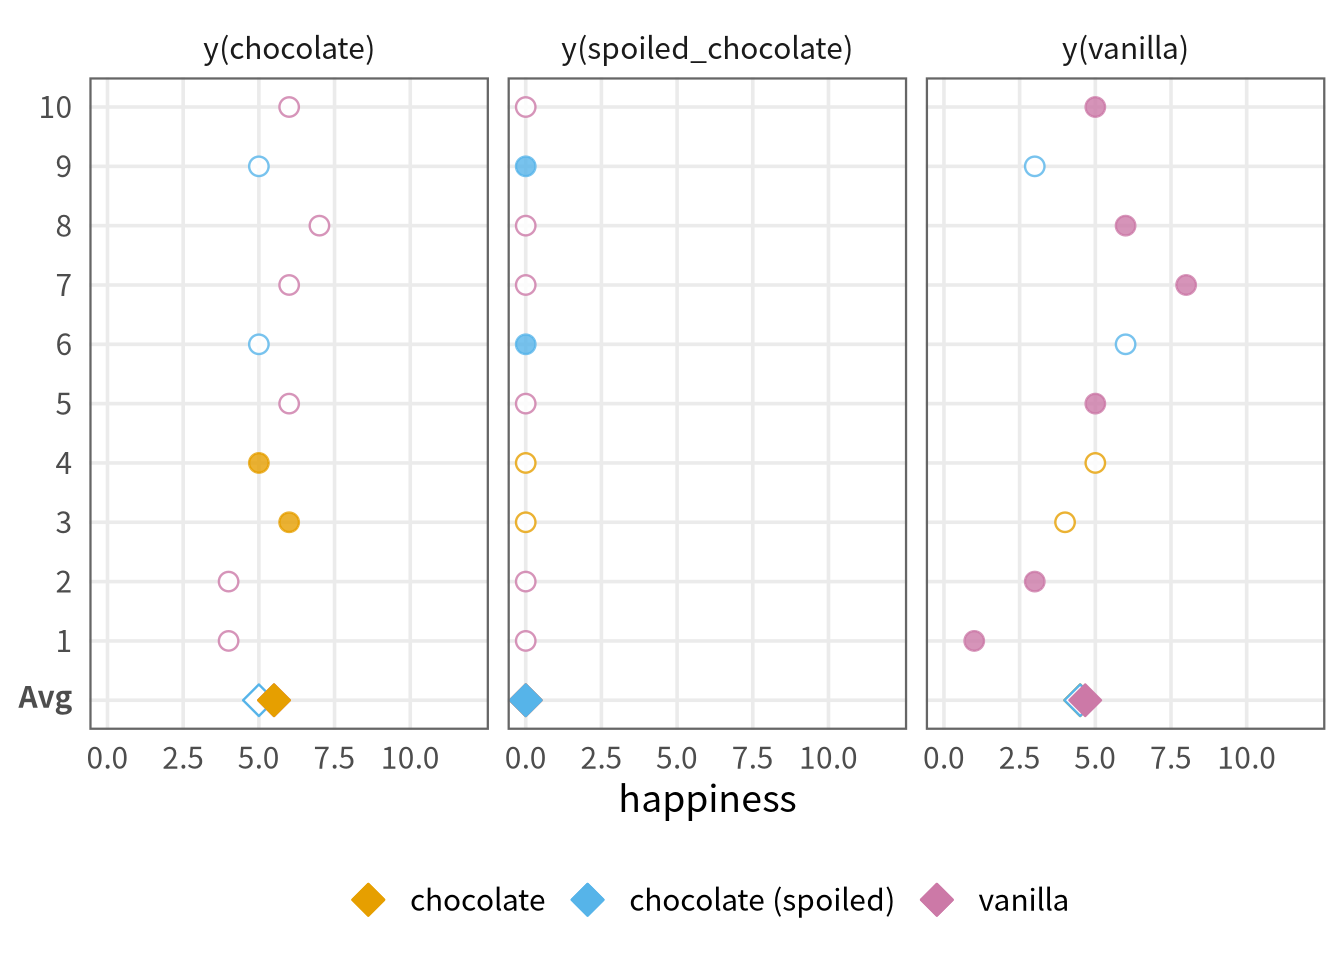
간섭은 개인의 노출이 다른 개인의 잠재적 결과에 영향을 미치는 것을 의미합니다. 간섭은 전염병 분야에서 매우 흔합니다. 백신 접종이나 치료제에 대한 누군가의 노출이 종종 다른 사람의 결과 위험에 영향을 미치기 때문입니다. 그러나 간섭은 소셜 네트워크, 정책 개입, 처치된 단위들의 지리적 근접성 등을 통해서도 다양한 다른 설정에서 발생할 수 있습니다.
우리 아이스크림 연구의 각 개인에게 파트너가 있고, 그들의 잠재적 결과가 자신이 먹은 아이스크림의 맛 뿐만 아니라 파트너가 먹은 맛에도 의존한다고 가정해 봅시다. 아래의 시뮬레이션에서, 다른 맛의 아이스크림을 받은 파트너가 있는 경우 그 사람의 행복도는 2단위 증가합니다.
data <- tibble(
  id = 1:10,
  partner_id = c(1, 1, 2, 2, 3, 3, 4, 4, 5, 5),
  y_chocolate_chocolate = c(4, 4, 6, 5, 6, 5, 6, 7, 5, 6),
  y_vanilla_vanilla = c(1, 3, 4, 5, 5, 6, 8, 6, 3, 5)
) |>
  # 파트너가 다른 맛을 얻었을 때
  # 행복도가 2 증가함
  mutate(
    y_chocolate_vanilla = y_chocolate_chocolate + 2,
    y_vanilla_chocolate = y_vanilla_vanilla + 2
  )

set.seed(37)
data_observed_interf <- data |>
  mutate(
    exposure = if_else(
      rbinom(n(), 1, 0.5) == 1, "chocolate", "vanilla"
    ),
    exposure_partner = if_else(
      rbinom(n(), 1, 0.5) == 1, "chocolate", "vanilla"
    ),
    observed_outcome = case_when(
      exposure == "chocolate" & exposure_partner == "chocolate" ~
        y_chocolate_chocolate,
      exposure == "chocolate" & exposure_partner == "vanilla" ~
        y_chocolate_vanilla,
      exposure == "vanilla" & exposure_partner == "chocolate" ~
        y_vanilla_chocolate,
      exposure == "vanilla" & exposure_partner == "vanilla" ~
        y_vanilla_vanilla
    )
  )
잘못 정의된 노출의 경우와 마찬가지로, 간섭이 있는 상황에서도 우리는 올바른 답을 얻지 못합니다.
# A tibble: 2 × 2
  exposure  avg_outcome
  <chr>           <dbl>
1 chocolate        6.25
2 vanilla          6.33
마찬가지로 문제는 우리가 엉뚱한 잠재적 결과를 추정하고 있다는 점입니다 (그림 3.7). 간섭과 잘못 정의된 노출은 동일한 가정 위배의 서로 다른 발현일 뿐입니다. 우리가 추정하고 있는 잠재적 결과들이 우리가 묻고 있는 인과적 질문과 일치하지 않습니다. 이 사례에서 우리에게는 세 가지 반사실이 있습니다: 한 개인이 가졌던 맛과 파트너가 가지지 않았던 노출의 조합, 그리고 개인이 가지지 않았던 맛과 파트너가 가질 수 있었던 두 가지 맛의 조합입니다. 우리가 계산한 평균들은 이러한 조합 중 어느 것도 추정하고 있는 것 같지 않습니다.
plot_data <- data_observed_interf |>
  pivot_longer(
    cols = starts_with("y_"),
    names_prefix = "y_",
    names_to = "po_combination",
    values_to = "happiness"
  ) |>
  mutate(
    potential_outcome = paste0("y(", str_remove(po_combination, "_.*"), ")"),
    observed = po_combination == paste0(exposure, "_", exposure_partner),
    flavor_match = if_else(exposure == exposure_partner, "같은 맛", "다른 맛"),
    y_id = dense_rank(id)
  ) |>
  filter(
    observed | (potential_outcome != exposure)
  )

# Select two observed points for different flavor matches (Chocolate panel)
flavor_annotation <- plot_data |>
  filter(observed, potential_outcome == "y(chocolate)", id %in% c(3, 5)) |>
  summarize(
    x = max(happiness) + 0.5,
    y = mean(y_id) - 2,
    label = str_wrap("서로 다른 노출 쌍은 서로 다른 잠재적 결과를 낳습니다", 20),
    potential_outcome = "y(chocolate)"
  )

# Generate arrows for the flavor difference annotation
flavor_arrows <- plot_data |>
  filter(observed, potential_outcome == "y(chocolate)", id %in% c(3, 5)) |>
  mutate(
    xend = happiness,
    yend = y_id - .3,
    x = flavor_annotation$x,
    y = flavor_annotation$y,
    potential_outcome = "y(chocolate)"
  )

# Select a single ID with two unobserved potential outcomes (Vanilla panel)
unobserved_id <- 5

unobserved_annotation <- plot_data |>
  filter(!observed, id == unobserved_id, potential_outcome == "y(vanilla)") |>
  summarize(
    x = max(happiness) + 0.75,
    y = mean(y_id) - 0.5,
    label = str_wrap("반대 노출에 대해 두 개의 관찰되지 않은 잠재적 결과가 존재합니다", 20),
    potential_outcome = "y(vanilla)"
  )

# Generate arrows for the unobserved potential outcomes for the selected ID
unobserved_arrows <- plot_data |>
  filter(!observed, id == unobserved_id, potential_outcome == "y(vanilla)") |>
  mutate(
    xend = happiness + c(0.35, 0.15),
    yend = y_id - c(0.1, 0.2),
    x = unobserved_annotation$x,
    y = unobserved_annotation$y,
    potential_outcome = "y(vanilla)"
  )

# Select ID 6's unobserved chocolate potential outcome annotation (Chocolate panel)
chocolate_unobserved_annotation <- plot_data |>
  filter(id == 6, potential_outcome == "y(chocolate)", !observed) |>
  summarize(
    x = min(happiness) - 2.5,
    y = mean(y_id) + .75,
    label = str_wrap("파트너의 다른 맛에 대한 관찰되지 않은 잠재적 결과가 있습니다", 15),
    potential_outcome = "y(chocolate)"
  )

# Generate arrow pointing to the unobserved chocolate potential outcome for ID 6
chocolate_unobserved_arrow <- plot_data |>
  filter(id == 6, potential_outcome == "y(chocolate)", !observed) |>
  mutate(
    xend = happiness - 0.25,
    yend = y_id + 0.1,
    x = chocolate_unobserved_annotation$x,
    y = chocolate_unobserved_annotation$y,
    potential_outcome = "y(chocolate)"
  )

# Create Plot 5
ggplot(plot_data, aes(x = happiness, y = y_id)) +
  geom_point(
    data = plot_data |> filter(observed),
    mapping = aes(fill = flavor_match, color = flavor_match),
    size = 3,
    shape = 21,
    alpha = 0.8
  ) +
  geom_point(
    data = plot_data |> filter(!observed),
    size = 3,
    shape = 21,
    fill = "white",
    color = "grey70",
    alpha = 0.8
  ) +
  geom_curve(
    data = flavor_arrows,
    mapping = aes(x = x, xend = xend, y = y, yend = yend),
    curvature = -0.2,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = flavor_annotation,
    mapping = aes(x = x, y = y, label = label),
    hjust = 0,
    inherit.aes = FALSE,
    color = "grey40",
    size = 3,
    label.size = NA
  ) +
  geom_curve(
    data = unobserved_arrows,
    mapping = aes(x = x, xend = xend, y = y, yend = yend),
    curvature = -0.2,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = unobserved_annotation,
    mapping = aes(x = x, y = y, label = label),
    hjust = 0,
    inherit.aes = FALSE,
    color = "grey40",
    size = 3,
    label.size = NA
  ) +
  geom_curve(
    data = chocolate_unobserved_arrow,
    mapping = aes(x = x, xend = xend, y = y, yend = yend),
    curvature = -0.2,
    arrow = arrow(length = unit(0.02, "npc")),
    inherit.aes = FALSE,
    color = "grey40"
  ) +
  geom_label(
    data = chocolate_unobserved_annotation,
    mapping = aes(x = x, y = y, label = label),
    hjust = 1,
    inherit.aes = FALSE,
    color = "grey40",
    size = 3,
    label.size = NA
  ) +
  facet_wrap(~ potential_outcome) +
  scale_y_continuous(
    breaks = unique(plot_data$y_id),
    labels = unique(plot_data$id)
  ) +
  scale_fill_manual(
    values = c(
      "같은 맛" = ggokabeito::palette_okabe_ito(3),
      "다른 맛" = ggokabeito::palette_okabe_ito(5)
    ),
    name = NULL
  ) +
  scale_color_manual(
    values = c(
      "같은 맛" = ggokabeito::palette_okabe_ito(3),
      "다른 맛" = ggokabeito::palette_okabe_ito(5)
    ),
    name = NULL
  ) +
  scale_x_continuous(breaks = seq(0, 12, by = 2.5), limits = c(NA, 12)) +
  labs(
    x = "행복도",
    y = "ID"
  ) +
  po_theme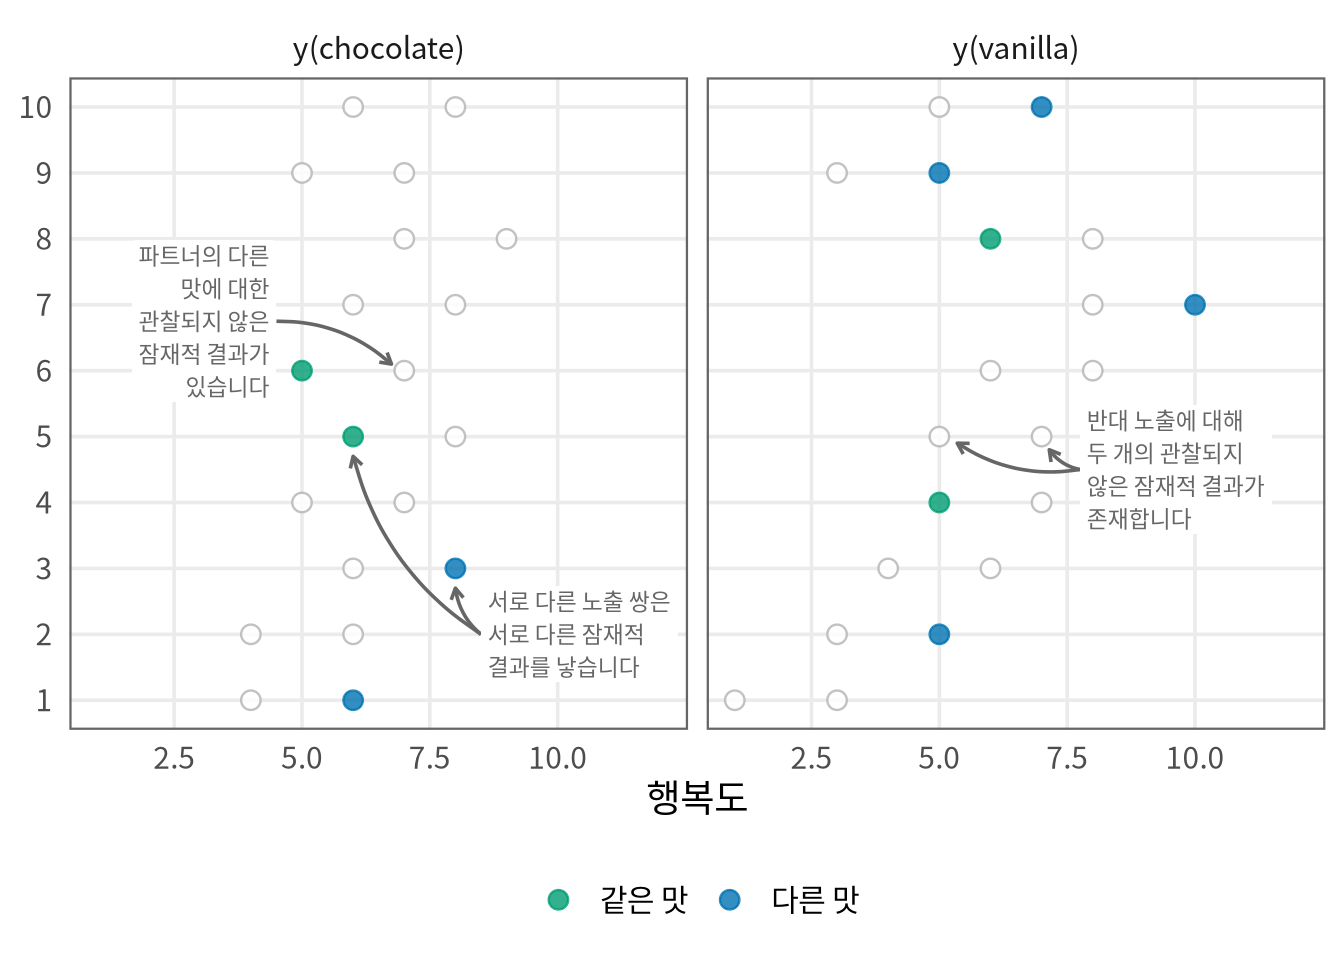
y(vanilla)와 초콜릿 그룹의 y(chocolate)가 올바르지 않습니다. 파트너의 맛에 의한 간섭으로 인해 효과들이 뒤섞여 있기 때문입니다.
이전과 마찬가지로, 우리는 잠재적 결과에 대해 더 구체적으로 명시할 수 있습니다.
# A tibble: 4 × 3
  exposure  exposure_partner avg_outcome
  <chr>     <chr>                  <dbl>
1 chocolate chocolate               5.5
2 chocolate vanilla                 7
3 vanilla   chocolate               6.75
4 vanilla   vanilla                 5.5
간섭에 대처하는 주요 방법 중 하나는 고려 중인 단위(unit)를 변경하는 것입니다. 여기서 각 개인, 즉 각 고유 ID는 하나의 단위로 간주되며 단위 간(즉, 파트너 간) 간섭이 존재합니다. 만약 각 파트너십을 하나의 단위로 간주하고 개인이 아닌 파트너십을 무작위로 배정한다고 가정해 봅시다. 이 경우 서로 다른 파트너십 세트 간에는 간섭이 없으므로 간섭 문제를 해결할 수 있습니다. 이러한 유형의 무작위 배정은 때때로 클러스터 무작위 시험(cluster randomized trial)이라고 불립니다. 각 클러스터 내에서 무엇을 하기로 결정할지는 당면한 인과적 질문에 달려 있습니다. 예를 들어, 두 사람 모두 초콜릿 아이스크림을 먹었을 때와 바닐라를 먹었을 때 어떤 일이 일어날지 알고 싶다면, 아래와 같이 두 파트너 모두에게 초콜릿이나 바닐라를 무작위로 배정하고 싶을 것입니다.
set.seed(11)

## 우리는 이제 개인이 아니라 *파트너십*을 무작위 배정하고 있습니다
partners <- tibble(
  partner_id = 1:5,
  exposure = if_else(
    rbinom(5, 1, 0.5) == 1, "chocolate", "vanilla"
  )
)
partners_observed <- data |>
  left_join(partners, by = "partner_id") |>
  mutate(
    # 모든 파트너십은 동일한 노출을 가집니다
    exposure_partner = exposure,
    observed_outcome = case_when(
      exposure == "chocolate" & exposure_partner == "chocolate" ~
        y_chocolate_chocolate,
      exposure == "vanilla" & exposure_partner == "vanilla" ~
        y_vanilla_vanilla
    )
  )
이제 우리는 올바른 인과 효과를 감지할 수 있습니다.
# A tibble: 2 × 2
  exposure  avg_outcome
  <chr>           <dbl>
1 chocolate        5.5
2 vanilla          4.38
여러 버전의 처치나 간섭이 있는 상황에서 효과를 식별하기 위한 방법들도 존재하지만, 이는 기술적이며 일관성 위배 상황에서 더 제한적입니다 (Tchetgen 와/과 VanderWeele 2010; VanderWeele 와/과 Hernan 2013).
마찬가지로, 파트너에게 같은 맛이나 다른 맛을 배정하여 교차 맛 효과(cross-flavor effect)를 계산할 수도 있습니다. 또 다른 옵션은 간섭 효과가 없도록 파트너를 제외하는 것입니다. 핵심은 무엇을 추정하고 싶은지 생각하고, 해당 질문에 대한 잠재적 결과를 가능한 한 정확하게 표현하려고 노력하는 것입니다.
장 2 에서 우리는 모기장이 말라리아 위험에 미치는 인과 효과를 추정했습니다. 이 질문에 대한 인과적 가정과 실제 분석에서 어떻게 위배될 수 있었을지 고려해 봅시다.
교환 가능성, 긍정성, 일관성은 단순한 가정들이지만, 우리가 보았듯이 쉽게 위배될 수 있습니다. 인과적 방법론을 위한 가정들이 충족되지 않을 때, 우리는 관찰된 데이터를 사용하여 반사실을 시뮬레이션하고 이를 관찰된 결과와 비교할 수 없습니다. 그러나 데이터를 수집하기 전이든, 이미 확보된 관찰 데이터를 다루든 상관없이 신중한 연구 설계를 통해 많은 잠재적 위배 사항을 해결할 수 있습니다.
우리가 보았듯이, 무작위 시험은 우리가 필요로 하는 인과적 가정을 충족하는 측면에서 탁월한 속성을 가지고 있습니다. 극한 상황에서 우리는 교환 가능성을 기대할 수 있는데, 이는 노출의 유일한 원인이 무작위 배정 과정 그 자체이기 때문입니다. 무작위이므로 연구 대상인 잠재적 결과와 완전히 독립적입니다. 마찬가지로 무작위 배정 과정은 아무도 결정론적인 노출을 갖지 않는 한 긍정성을 보장합니다; 우리는 노출을 배정하기 위해 사용하는 확률을 알고 있습니다. 무작위 시험은 또한 일관성, 특히 잘 정의된 노출을 보장하는 데 도움이 되지만 이를 완전히 보장하지는 않습니다. 노출을 실행하기 위해서는 노출이 정의되어야 하기 때문입니다. 하지만 간섭은 여전히 발생할 수 있습니다. 예를 들어, 일부 사람들에게 전염병 백신을 접종하도록 무작위 배정한다면, 그들이 백신을 접종받는 것이 주변 사람들이 병에 걸릴 확률을 낮출 수 있습니다. 노출 확률을 변화시키기 때문입니다. 이는 위의 예시들처럼 클러스터 무작위 배정이나 단위 분리 등 시험 설계에서 추가적인 고려 사항을 필요로 합니다.
우리는 노출이 무작위로 배정되는 분석을 무작위 시험이라고 부릅니다. 때때로 이러한 유형의 무작위 설계는 “어느 것이 더 나은가, A인가 B인가?”라는 의미에서 A/B 테스트라고 불리기도 합니다. A/B 테스트는 산업계에서 흔히 쓰이며, 예를 들어 두 가지 다른 웹사이트 UI 디자인을 테스트하는 경우 등이 있습니다. 하지만 그 본질은 무작위 실험이며, 이 섹션의 모든 내용이 동일하게 적용됩니다.
그러나 이러한 속성들은 이상적인 무작위 시험에 대한 것입니다. 실제 무작위 시험에서는 문제가 생길 수 있습니다. 표본 크기가 너무 작으면 우연히 교환 가능성이 깨질 수 있습니다. 사람들은 또한 지시받은 대로 정확히 행동하지 않을 수도 있습니다; 연구에 참여한 많은 사람들은 배정된 노출을 준수하지 않을 것입니다. 종종 이러한 비준수(non-adherence)의 원인은 교환 가능성의 문제를 야기합니다. 마찬가지로 사람들은 비교환 가능성을 만드는 방식으로 연구에서 탈락(중도 탈락)할 수도 있습니다. 우리는 장 18 과 장 22 에서 이러한 주제들과 그에 대해 우리가 할 수 있는 일들을 더 깊이 다룰 것입니다. 노출 또한 실제 시험에서 일관되지 않을 수 있는데, 이는 구현 과정에서의 문제(위의 수술 예시처럼)이거나 참가자에 의한 것일 수 있습니다. 예를 들어, 참가자가 하루에 두 알의 약을 먹도록 배정받았지만 하루에 한 알만 먹기로 결정할 수 있습니다. 간섭을 방지하려는 시도 또한 실패할 수 있습니다. 예를 들어 잘못된 단위에 대해 무작위 배정을 하거나 단위들이 예상치 못한 방식으로 서로 상호작용하는 경우입니다.
비무작위(관찰) 연구는 이러한 보장이 전혀 없으며, 이상적인 상황에서도 마찬가지입니다. 실제 무작위 시험과 마찬가지로, 관찰 연구 또한 인과 추론에 필요한 가정들을 더 잘 충족하기 위해 신중한 설계와 실행이 필요합니다. 표 3.4 는 이상적인 무작위 시험, 실제 무작위 시험, 그리고 관찰 연구가 각각 교환 가능성, 긍정성, 일관성 기준을 얼마나 잘 충족하는지 요약합니다.
| 가정 | 이상적인 무작위 시험 | 실제 무작위 시험 | 관찰 연구 |
|---|---|---|---|
| 일관성 (잘 정의된 노출) | 😄 | 🤷 | 🤷 |
| 일관성 (간섭 없음) | 🤷 | 🤷 | 🤷 |
| 긍정성 | 😄 | 😄 | 🤷 |
| 교환 가능성 | 😄 | 🤷 | 🤷 |
인과 분석의 설계에는 명확한 인과적 질문이 필요합니다. 그런 다음 우리는 Hernán 와/과 Robins (2016) 이 정의한 목표 시험 프레임워크를 구성하는 다음 7가지 요소로 구성된 프로토콜에 이 질문을 매핑할 수 있습니다:
섹션 1.2 의 다이어그램(그림 1.6)을 다시 떠올려 보십시오; 인과적 질문을 정의하려고 할 때 이러한 프로토콜 요소 중 여러 가지를 이 다이어그램들에 매핑할 수 있습니다.
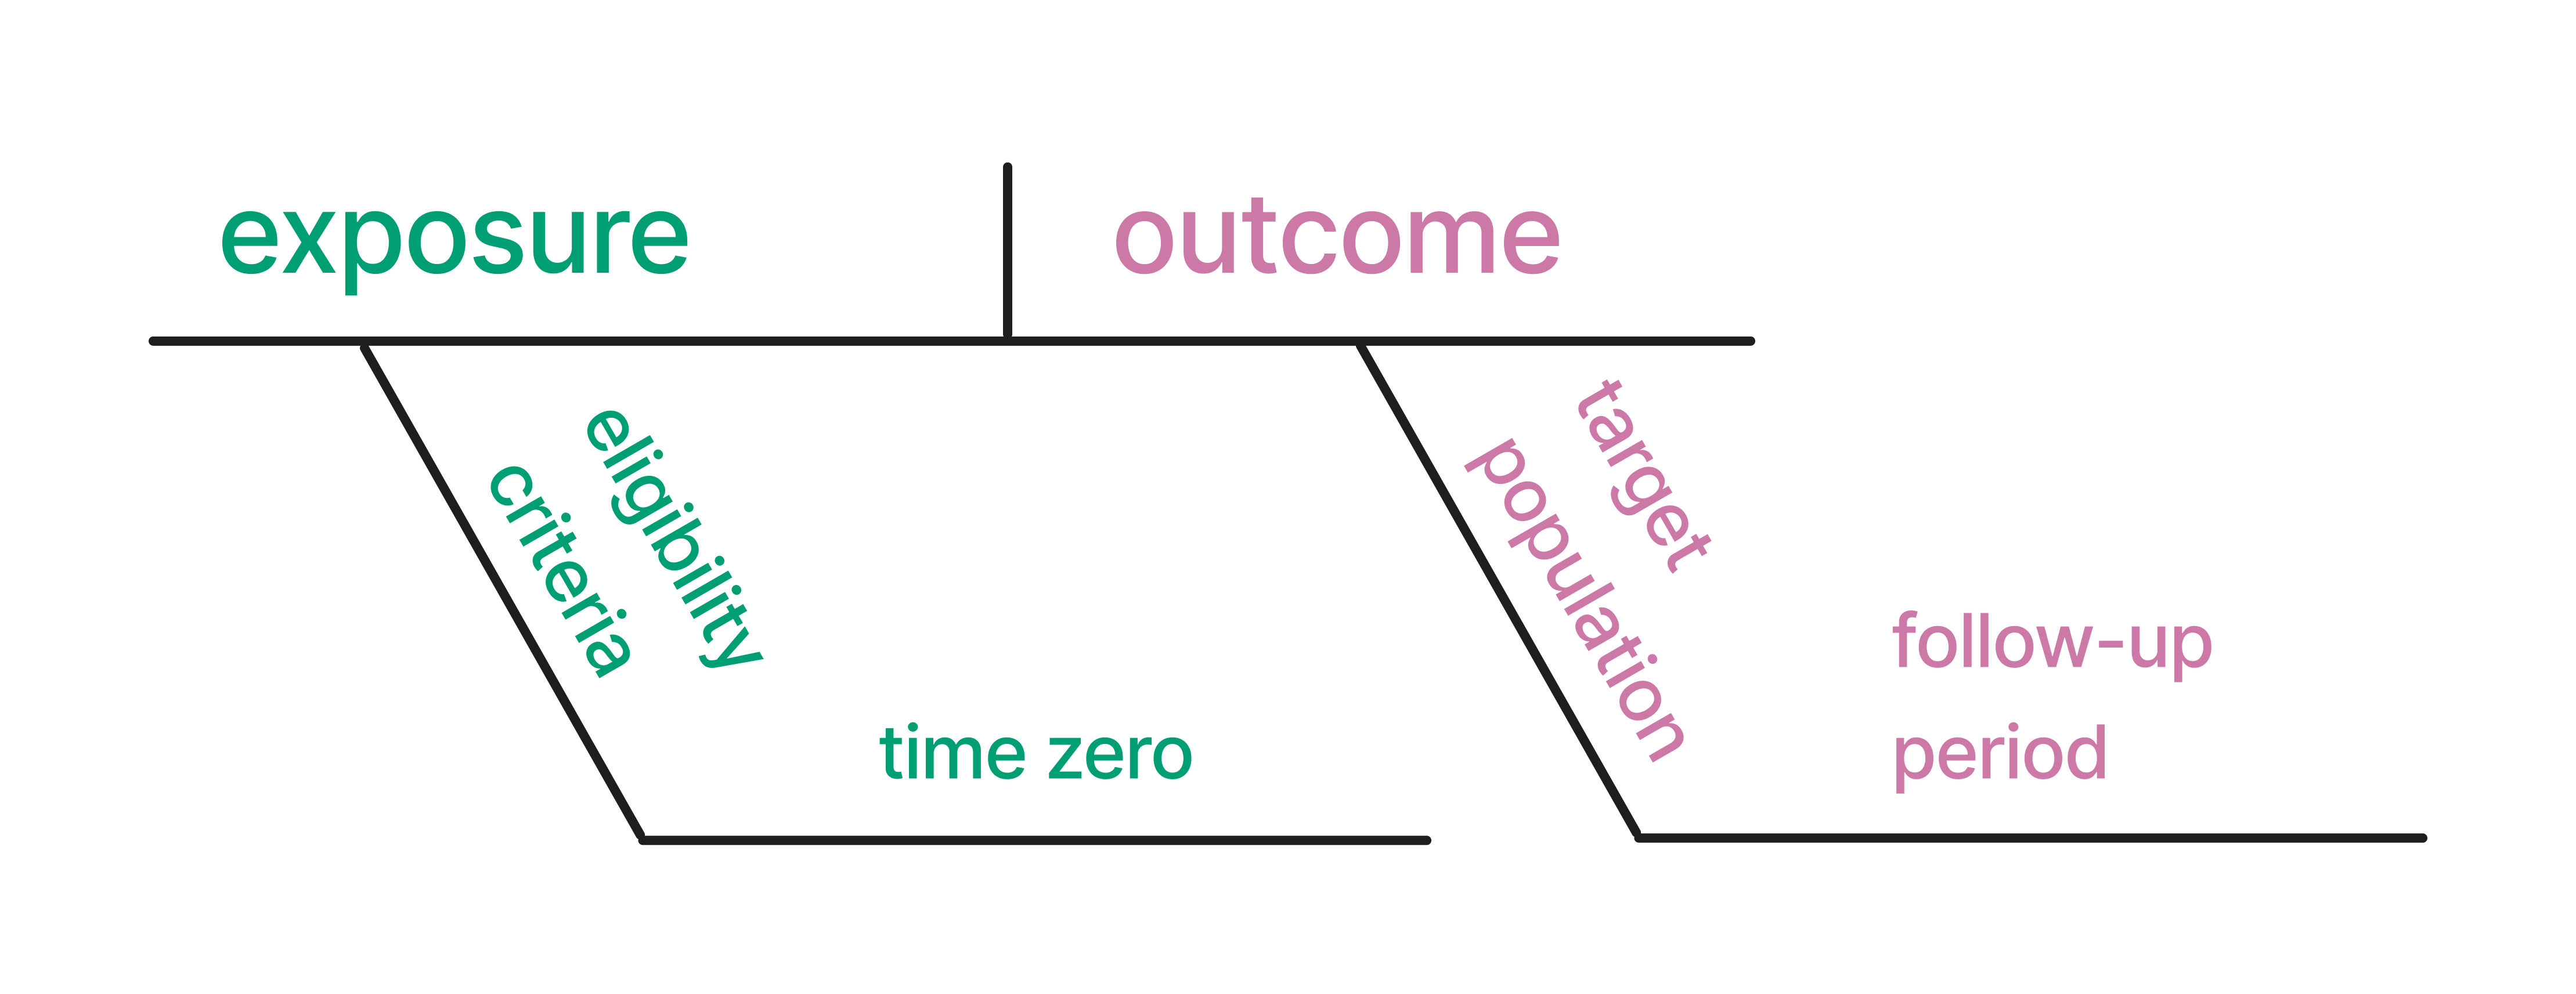
무작위 시험은 인과적 가정을 충족하는 데 도움이 되지만, 장 1 에서 논의했듯이 시간, 비용, 윤리적 고려 사항 등 무작위 배정을 할 수 없는 많은 이유가 있습니다. 또한 무작위 시험이 진행되는 동안 관찰 데이터를 사용하여 예비적인 답을 더 빨리 얻을 수도 있습니다.
무작위 시험을 수행하지 않을 때에도, 그러한 시험이 어떻게 진행될지 상상해보는 것은 관찰 데이터로부터의 추론 품질을 높일 수 있습니다. 이것이 바로 목표 시험 모방(target trial emulation)의 핵심 아이디어입니다: 여러분은 목표 시험(여러분이 실행하고 싶거나 이전에 실행된 적이 있는 무작위 시험)을 명시하고, 관찰 데이터를 사용하여 이 설계를 모방하려고 노력합니다.
설계가 무작위 시험이든 관찰 연구이든 상관없이, 프로토콜을 사용하면 인과적 가정을 충족할 가능성을 높일 수 있습니다. 표 3.5 에서는 이러한 요소들을 각각 해결할 수 있는 해당 가정에 매핑합니다.
| 가정 | 적격성 기준 | 노출 정의 | 배정 절차 | 추적 관찰 기간 | 결과 정의 | 인과적 대비 | 분석 계획 |
|---|---|---|---|---|---|---|---|
| 일관성 (잘 정의된 노출) | ✔️ | ✔️ | ✔️ | ✔️ | |||
| 일관성 (간섭 없음) | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ | ||
| 긍정성 | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ | ||
| 교환 가능성 | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ | ✔️ |
아이스티와 스파이크의 예시에서 목표 시험과 그 모방은 어떤 모습일까요? 우리가 필요한 모든 정보를 가진 데이터베이스를 가지고 있다고 상상해 보십시오. 한 가게에서 동일한 브랜드의 초콜릿 또는 바닐라 아이스크림을 정확히 100g씩 제공합니다. 이 데이터베이스 덕분에 우리는 참가자들의 맛 선택 정보와 입구에서의 측정치(기준점) 및 아이스크림을 먹은 지 30분 후의 측정치(추적 관찰)를 포함하여 행복도(위에서 사용한 것과 동일한 도구로 측정)와 같은 다양한 다른 특성 정보를 가지고 있습니다. 표 3.6 에서는 이 질문에 대한 무작위 시험 아이디어와 이 데이터베이스를 사용하여 이를 모방할 관찰 연구의 프로토콜을 요약합니다. 특히, 우리가 모방할 수 있는 목표 시험은 대개 소위 실용적 시험(pragmatic trial) — 눈가림(blinding)이 없는 시험 — 입니다. 누군가의 노출을 자신으로부터 숨기는 것이 불가능한 경우가 많기 때문입니다.
| 프로토콜 단계 | 설명 | 목표 시험 | 모방 연구 |
|---|---|---|---|
| 적격성 기준 | 누구를 연구에 포함해야 하는가? | 포함 기준: 18세 이상 65세 이하. 제외 기준: 유당 불내증 또는 성분 알레르기가 없음; 연구 기간 내에 가게에 입장함. | 목표 시험과 동일. |
| 노출 정의 | 적격할 때, 연구 대상 단위가 받게 될 정확한 노출은 무엇인가? | 그릇에 담긴 100g의 바닐라 또는 초콜릿 아이스크림 (둘 다 Don and Jerzy 브랜드). | 목표 시험과 동일. |
| 배정 절차 | 적격한 단위가 노출에 어떻게 배정되는가? | 참가자들은 각 맛에 대해 50%의 확률로 무작위 배정됩니다. 배정은 눈가림되지 않습니다. | 참가자들은 자신의 데이터와 일치하는 맛(예: 본인이 선택한 맛)을 배정받습니다. 무작위 배정은 기준점 공변량을 사용하여 모방됩니다. |
| 추적 관찰 기간 | 추적 관찰은 언제 시작하고 끝나는가? | 시작: 적격성 기준을 충족하고 맛이 배정된 시점; 종료: 맛 배정 30분 후. | 목표 시험과 동일. |
| 결과 정의 | 어떤 정확한 결과가 측정될 것인가? | 표준 도구로 측정한 행복도 (1-10점). | 목표 시험과 동일. |
| 관심 있는 인과적 대비 | 어떤 인과 추정 대상이 추정될 것인가? | 평균 처치 효과 (ATE). | 목표 시험과 동일. |
| 분석 계획 | 어떤 통계적 절차가 적용될 것인가? | ATE는 기준점 행복도, 연령, 소득, 교육 수준 등에 대해 가중치를 둔 역확률 가중치 부여를 사용하여 계산됩니다. | ATE는 교란 요인 및 추가적인 예후 변수들에 대해 가중치를 둔 역확률 가중치 부여를 사용하여 계산됩니다. |
표 3.6 의 프로토콜은 다양한 방식으로 인과적 가정을 충족하도록 도와줍니다. 예를 들어, 알레르기나 민감성이 있는 사람들을 제외하면 긍정성이 유지될 가능성이 더 높습니다. 노출이 잘 정의되어 있으면 일관성이 유지될 가능성이 더 높습니다. 만약 간섭이 문제라고 생각된다면, 무작위 배정 절차를 클러스터 설계로 바꾸거나 서로 간섭할 것으로 생각되는 사람들을 제외(예: 그룹당 한 명만 포함)할 수도 있습니다. 또한 IPW를 통해 무작위 배정을 재현함으로써 교환 가능성을 다루려고 노력합니다. 이 인과적 질문에서 우리가 맛 선택과 행복도의 공통 원인이 기준점 행복도, 연령, 그리고 맛 선호도라고 믿습니다. 행동도에 영향을 미치는 추가적인 원인은 연령, 소득, 교육 수준, 신체 활동, 본인이 평가한 신체적/정신적 건강, 관계의 질 등이라고 생각합니다. 우리는 장 4 에서 이 아이디어를 더 자세히 논의할 것입니다. 나중에 더 자세히 다룰 몇 가지 다른 요소들이 여기에 있습니다. 언급했듯이, 장 18 에서 추적 관찰을, 장 10 에서 무작위 시험에 특화된 추정 대상을 포함한 추정 대상을 다룰 것입니다. 또한 무작위 배정을 하더라도 목표 시험을 위해 IPW를 사용합니다. 우리는 섹션 6.3.1 에서 이 방식의 장점에 대해 논의할 것입니다.