노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
이제 우리는 이 책에서 지금까지 암시해 온 내용을 살펴볼 수 있는 도구를 갖추었습니다: 인과 추론은 (단지) 통계적인 문제만은 아닙니다. 물론 우리는 인과적 질문에 답하기 위해 통계학을 사용합니다. 통계가 (무작위 설계에서 자주 그렇듯이) 비록 기초적일지라도 대부분의 질문에 답하는 데 필요합니다. 그러나 통계만으로는 인과 추론의 모든 가정을 다룰 수 없습니다.
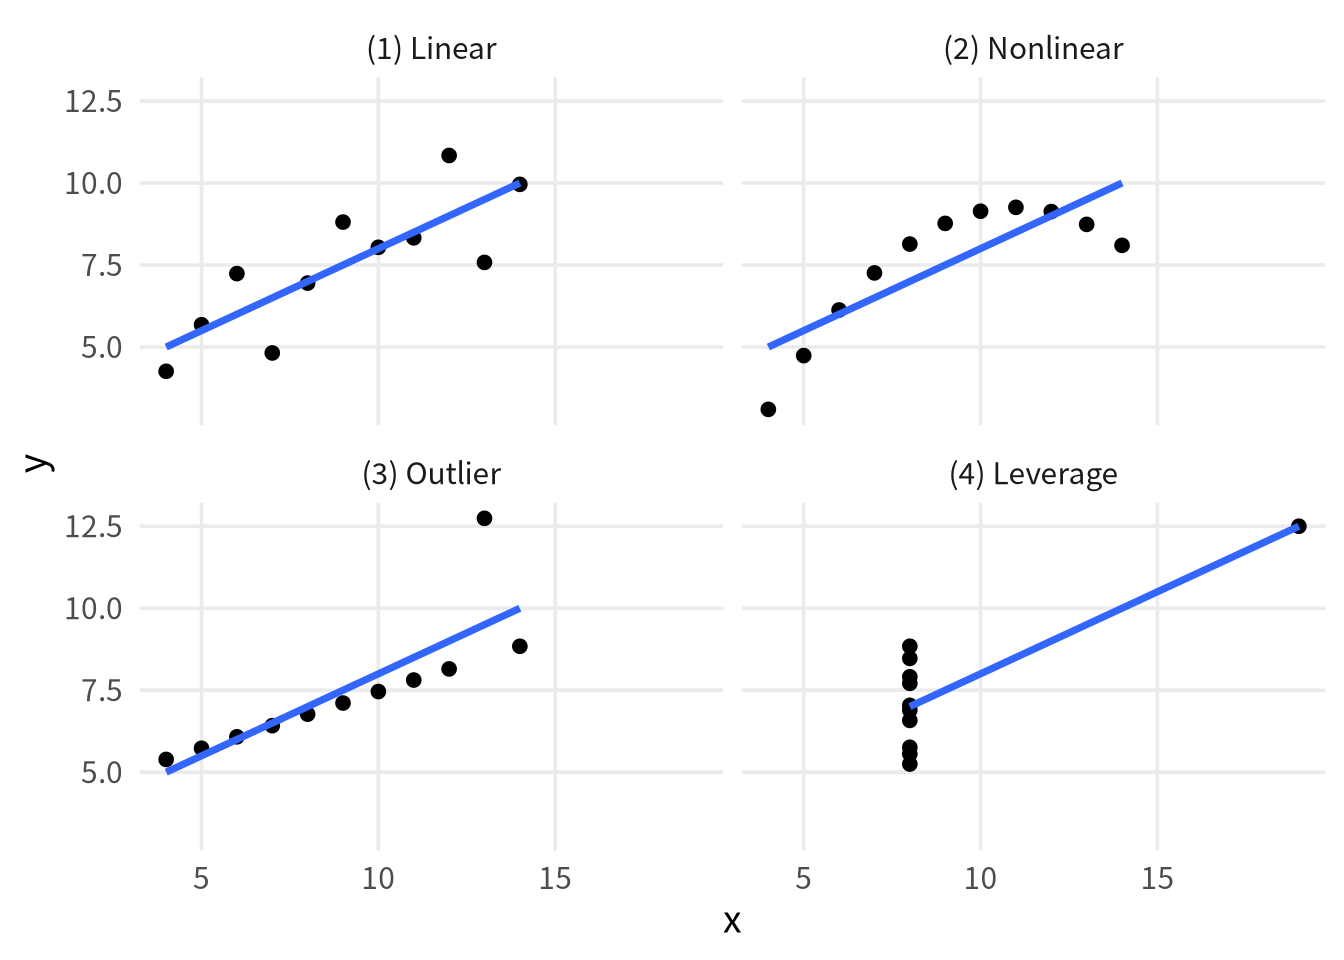
1973년 프랜시스 앤스콤(Francis Anscombe)은 앤스콤의 콰르텟(Anscombe’s Quartet)이라고 불리는 네 개의 데이터셋을 소개했습니다. 이 데이터는 중요한 교훈을 보여주었습니다: 요약 통계만으로는 데이터를 이해할 수 없으며, 반드시 데이터를 시각화해야 한다는 것입니다. 그림 5.1 의 그래프에서 각 데이터셋은 거의 동일한 평균과 상관관계를 포함하여 놀라울 정도로 유사한 요약 통계를 가지고 있습니다.
데이터사우루스 더즌(Datasaurus Dozen)은 앤스콤의 콰르텟을 현대적으로 재해석한 것입니다. 각 데이터셋에서 평균, 표준 편차, 상관관계는 거의 동일하지만 시각화 결과는 매우 다릅니다.
library(datasauRus)

# 각 데이터셋에서 거의 동일한 상관관계
datasaurus_dozen |>
  group_by(dataset) |>
  summarize(cor = round(cor(x, y), 2))
# A tibble: 13 × 2
dataset cor
<chr> <dbl>
1 away -0.06
2 bullseye -0.07
3 circle -0.07
4 dino -0.06
5 dots -0.06
6 h_lines -0.06
7 high_lines -0.07
8 slant_down -0.07
9 slant_up -0.07
10 star -0.06
11 v_lines -0.07
12 wide_lines -0.07
13 x_shape -0.07datasaurus_dozen |>
ggplot(aes(x, y)) +
geom_point() +
facet_wrap(~dataset)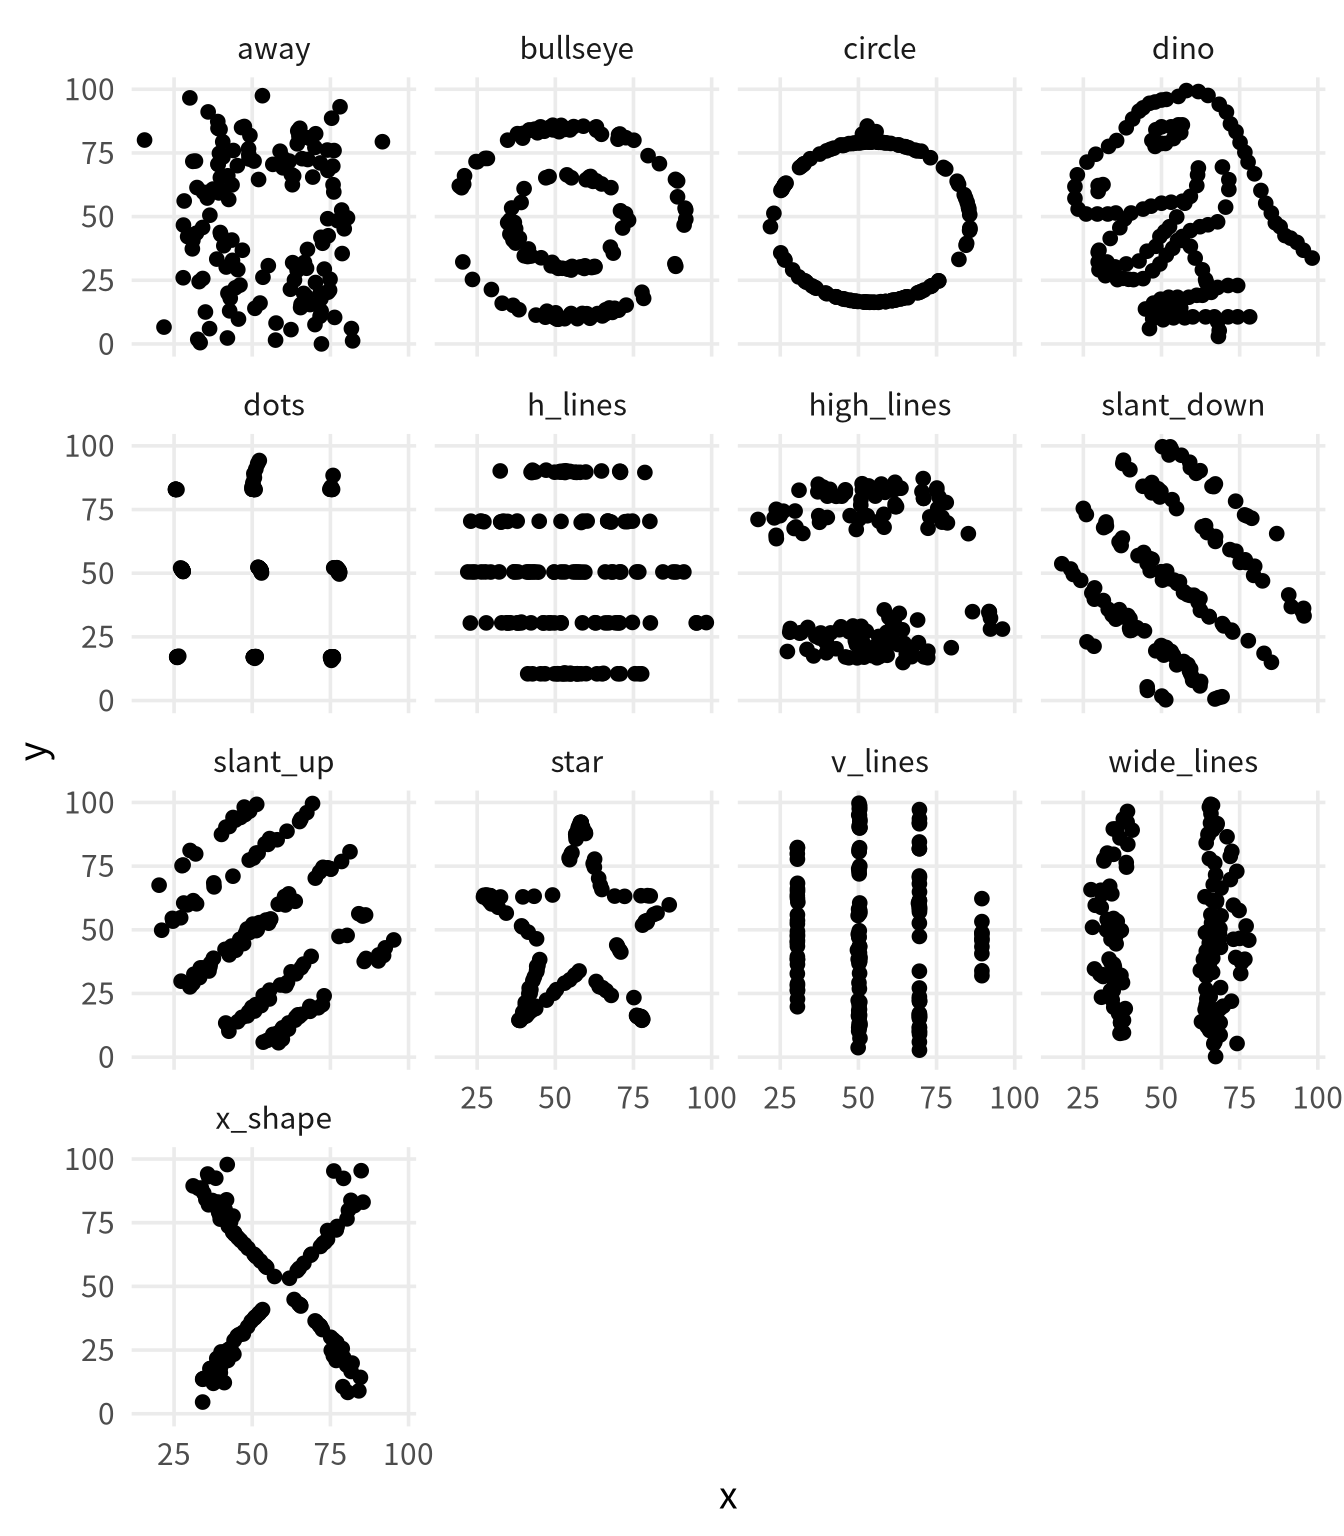
그러나 인과 추론에서는 시각화만으로도 인과 효과를 풀어내기에 충분하지 않습니다. 장 3 와 장 4 에서 보았듯이, 상관관계로부터 인과관계를 추론하려면 배경 지식에 기반한 검증 불가능한 가정이 필요합니다 (Robins 와/과 Wasserman 1999).
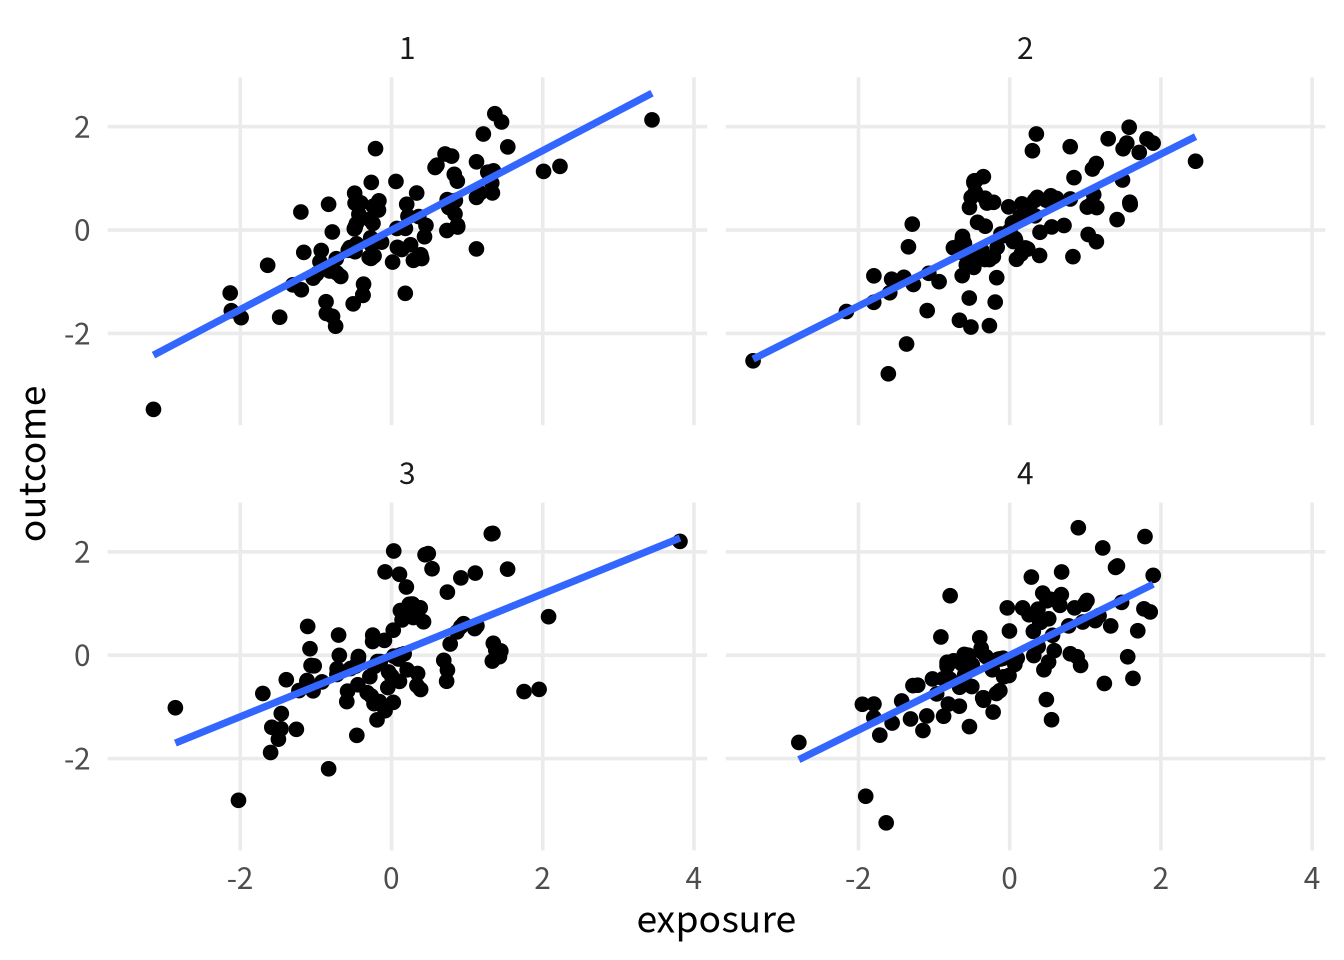
앤스콤의 콰르텟에서 영감을 받은 인과적 콰르텟(Causal Quartet)은 앤스콤의 콰르텟 및 데이터사우루스 더즌과 많은 동일한 특성을 공유합니다: 데이터셋에 있는 변수들의 수치적 요약이 동일합니다 (D’Agostino McGowan, Gerke, 와/과 Barrett 2023). 이러한 데이터들과 달리, 인과적 콰르텟은 서로 모양도 똑같습니다. 차이점은 각 데이터셋을 생성한 인과 구조에 있습니다. 그림 5.3 은 노출(exposure)과 결과(outcome) 사이의 관측된 관계가 사실상 동일한 네 개의 데이터셋을 보여줍니다.
causal_quartet |>
  # 데이터셋 이름을 숨깁니다
  mutate(dataset = as.integer(factor(dataset))) |>
  group_by(dataset) |>
  mutate(exposure = scale(exposure), outcome = scale(outcome)) |>
  ungroup() |>
  ggplot(aes(exposure, outcome)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
facet_wrap(~dataset)이 데이터셋들을 사용하여 답하고자 하는 인과적 질문은 다음과 같습니다: 각 데이터셋에 대한 질문은 세 번째 변수인 covariate(공변량)를 조정할지 여부입니다. covariate는 교란 요인(confounder)일까요? 매개 요인(mediator)일까요? 콜라이더(collider)일까요? 우리는 데이터를 사용하여 이 문제를 해결할 수 없습니다. 표 tbl-quartet_lm에서는 어떤 효과가 맞는지 명확하지 않습니다. 마찬가지로 exposure와 covariate 사이의 상관관계도 도움이 되지 않습니다. 모두 똑같으니까요!
library(gt)
effects <- causal_quartet |>
  nest_by(dataset = as.integer(factor(dataset))) |>
  mutate(
    ate_x = coef(lm(outcome ~ exposure, data = data))[2],
    ate_xz = coef(lm(outcome ~ exposure + covariate, data = data))[2],
    cor = cor(data$exposure, data$covariate)
  ) |>
  select(-data, dataset) |>
  ungroup()

gt::gt(effects) |>
  gt::fmt_number(columns = -dataset) |>
  gt::cols_label(
    dataset = "데이터셋",
    ate_x = gt::md("`covariate`를 조정하지 않음"),
    ate_xz = gt::md("`covariate`를 조정함"),
    cor = gt::md("`exposure`와 `covariate` 사이의 상관관계")
)| 데이터셋 |
covariate를 조정하지 않음 |
covariate를 조정함 |
exposure와 covariate 사이의 상관관계 |
|---|---|---|---|
| 1 | 1.00 | 0.55 | 0.70 |
| 2 | 1.00 | 0.50 | 0.70 |
| 3 | 1.00 | 0.00 | 0.70 |
| 4 | 1.00 | 0.88 | 0.70 |
covariate 조정 여부에 따른 outcome에 대한 exposure의 추정 효과를 포함한 인과적 콰르텟. 조정되지 않은 추정치는 네 데이터셋 모두에서 동일하며, exposure와 covariate 사이의 상관관계도 마찬가지입니다. 조정된 추정치는 서로 다릅니다. 배경 지식 없이는 어느 것이 옳은지 명확하지 않습니다.
10% 규칙은 역학(epidemiology) 및 기타 분야에서 변수가 교란 요인인지 결정하기 위해 흔히 사용되는 기술입니다. 10% 규칙은 변수를 모델에 포함했을 때 효과 추정치가 10% 이상 변한다면 해당 변수를 모델에 포함해야 한다고 말합니다. 문제는, 이 규칙이 작동하지 않는다는 점입니다. 인과적 콰르텟의 모든 예시에서 10% 이상의 변화가 발생합니다. 우리가 알고 있듯이, 이는 일부 데이터셋에서 잘못된 답으로 이어집니다. 반대 기술, 즉 변화가 10% 미만일 때 변수를 제외하는 것 또한 문제를 일으킬 수 있습니다. 많은 사소한 교란 효과들이 합쳐져 더 큰 편향을 만들어낼 수 있기 때문입니다.
effects |>
  mutate(percent_change = scales::percent((ate_x - ate_xz) / ate_x)) |>
  select(dataset, percent_change) |>
  gt::gt() |>
  gt::cols_label(
    dataset = "데이터셋",
    percent_change = "변화율"
)| 데이터셋 | 변화율 |
|---|---|
| 1 | 44.6% |
| 2 | 49.7% |
| 3 | 99.8% |
| 4 | 12.5% |
covariate를 포함했을 때 exposure 계수의 변화율.
covariate와 exposure 사이의 시각적 관계가 데이터셋마다 동일하지는 않지만, 상관관계는 모두 같습니다. 그림 5.4 에서 두 변수 사이의 표준화된 관계는 동일합니다.
causal_quartet |>
  # 데이터셋 이름을 숨깁니다
  mutate(dataset = as.integer(factor(dataset))) |>
  group_by(dataset) |>
  summarize(cor = round(cor(covariate, exposure), 2))
# A tibble: 4 × 2
dataset cor
<int> <dbl>
1 1 0.7
2 2 0.7
3 3 0.7
4 4 0.7exposure와 covariate 사이의 표준화된 관계. 우리는 여전히 covariate가 교란 요인인지, 매개 요인인지, 아니면 콜라이더인지 판단하기 위한 충분한 정보를 가지고 있지 않습니다.
causal_quartet |>
  # 데이터셋 이름을 숨깁니다
  mutate(dataset = as.integer(factor(dataset))) |>
  group_by(dataset) |>
  mutate(covariate = scale(covariate), exposure = scale(exposure)) |>
  ungroup() |>
  ggplot(aes(covariate, exposure)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~dataset)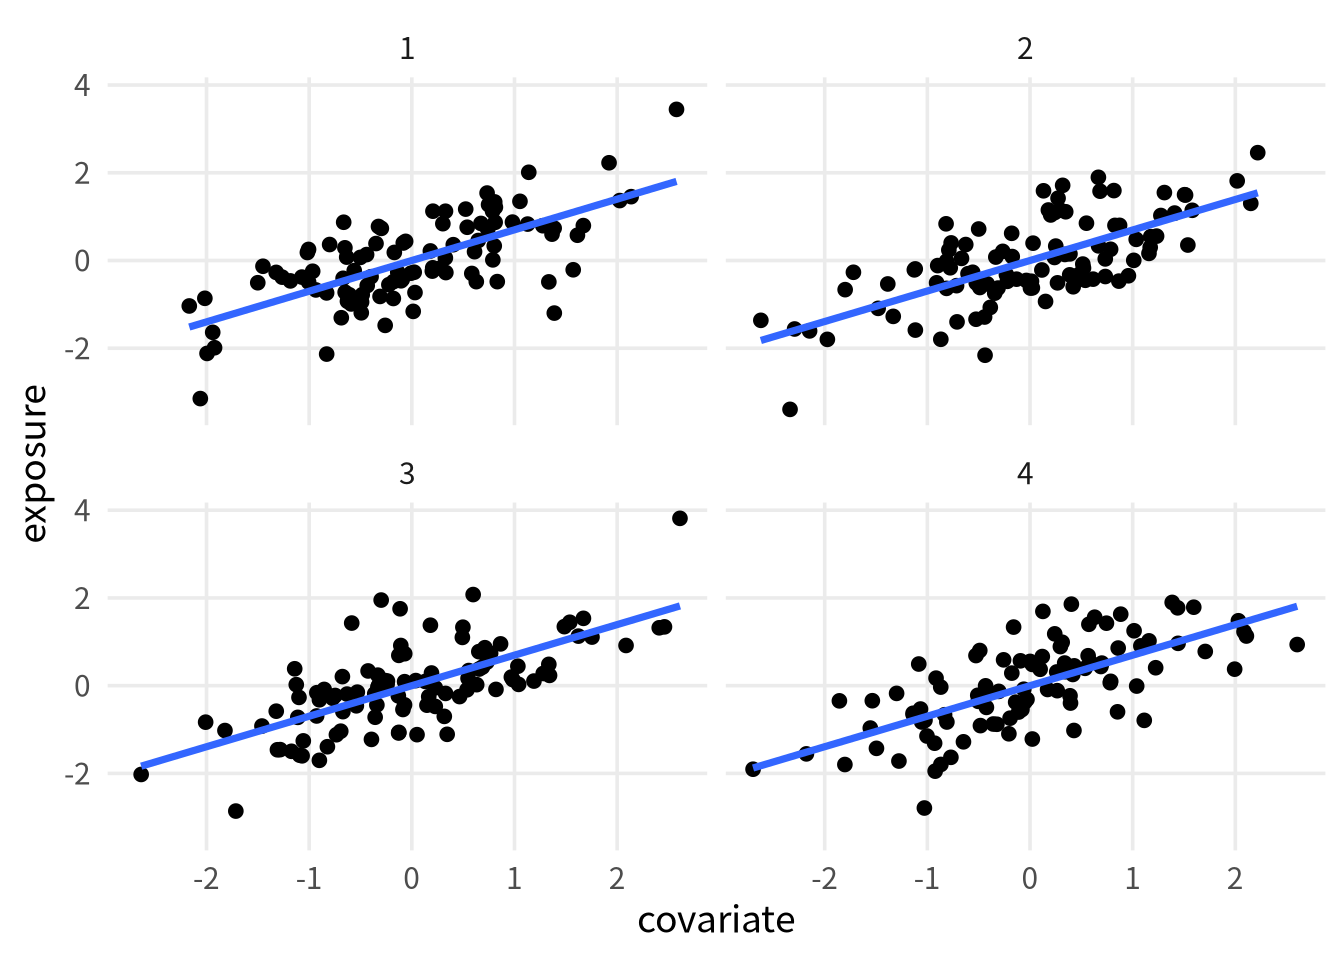
exposure와 covariate 사이의 표준화된 관계. 우리는 여전히 covariate가 교란 요인인지, 매개 요인인지, 아니면 콜라이더인지 판단하기 위한 충분한 정보를 가지고 있지 않습니다.
scale()에 구현된 것처럼 숫자형 변수를 평균이 0이고 표준 편차가 1이 되도록 표준화하는 것은 통계학에서 흔히 쓰이는 기술입니다. 이는 여러 이유로 유용하지만, 여기서는 각 데이터셋에서 covariate와 exposure 사이의 동일한 상관관계를 강조하기 위해 변수들을 스케일링하기로 했습니다. 만약 변수들을 스케일링하지 않았다면 상관관계는 동일하겠지만, 표준 편차가 다르기 때문에 그래프 모양이 다르게 보였을 것입니다. OLS 모델의 베타 계수는 변수의 공분산과 표준 편차 정보를 사용하여 계산되므로, 이를 스케일링하면 계수가 피어슨 상관계수(Pearson’s correlation)와 동일해집니다.
그림 5.5 는 covariate와 exposure 사이의 스케일링되지 않은 관계를 보여줍니다. 이제 몇 가지 차이점이 보입니다: 데이터셋 4는 covariate의 분산이 더 큰 것처럼 보이지만, 이는 실행 가능한 정보(actionable information)가 아닙니다. 사실, 이는 데이터 생성 프로세스의 수학적 산물일 뿐입니다.
causal_quartet |>
  # 데이터셋 이름을 숨깁니다
  mutate(dataset = as.integer(factor(dataset))) |>
  ggplot(aes(covariate, exposure)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~dataset)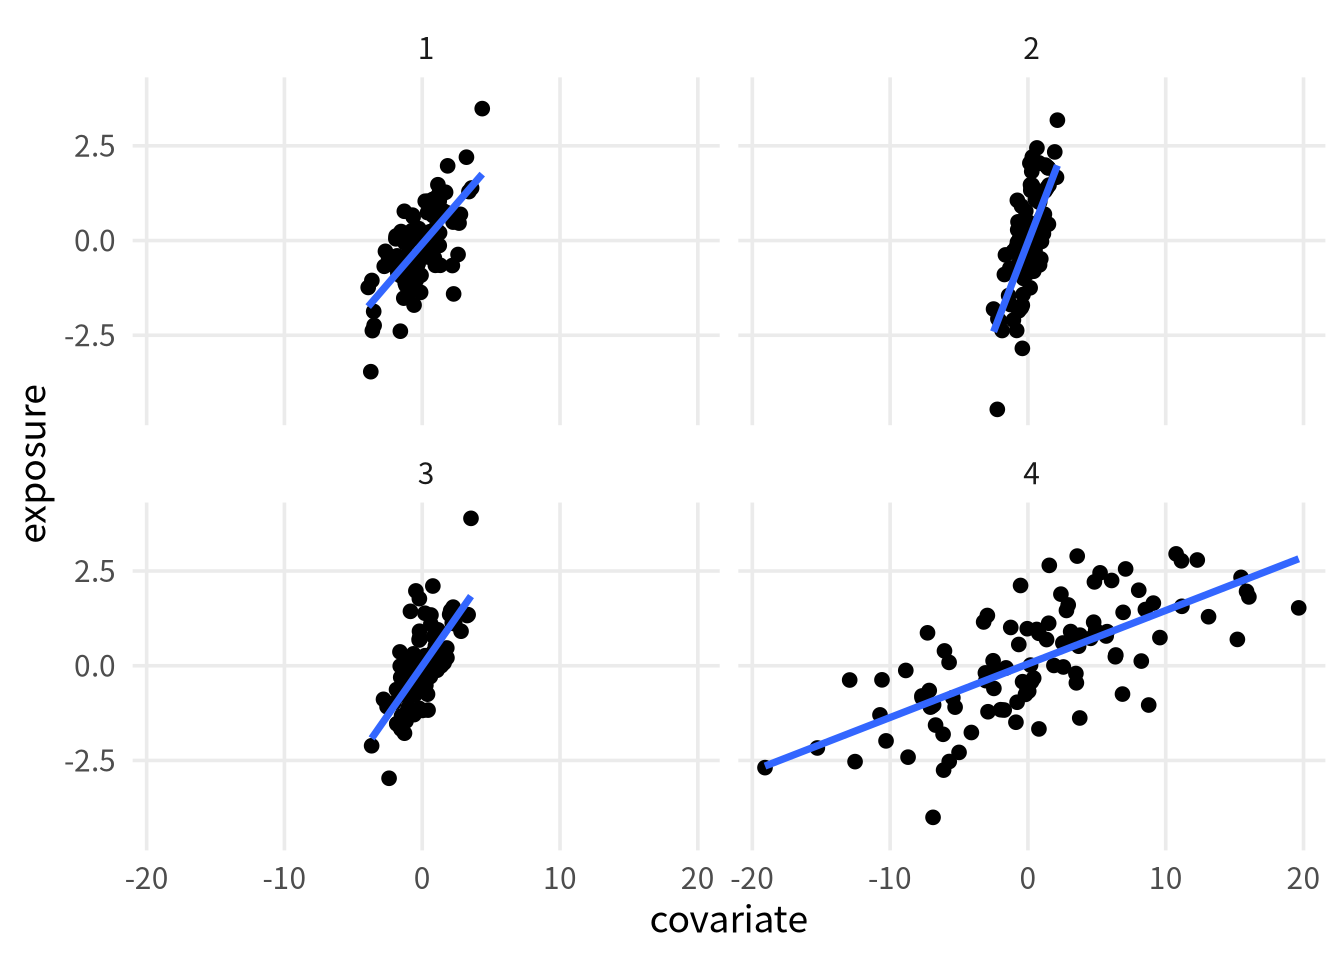
이제 데이터셋의 인과 구조를 나타내는 레이블을 공개해 보겠습니다. 그림 5.6 에서 covariate는 각 데이터셋에서 서로 다른 역할을 합니다. 1번과 4번에서는 콜라이더입니다(조정해서는 안 됩니다). 2번에서는 교란 요인입니다(조정해야 합니다). 3번에서는 매개 요인입니다(연구 질문에 따라 다릅니다).
causal_quartet |>
  ggplot(aes(exposure, outcome)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~dataset)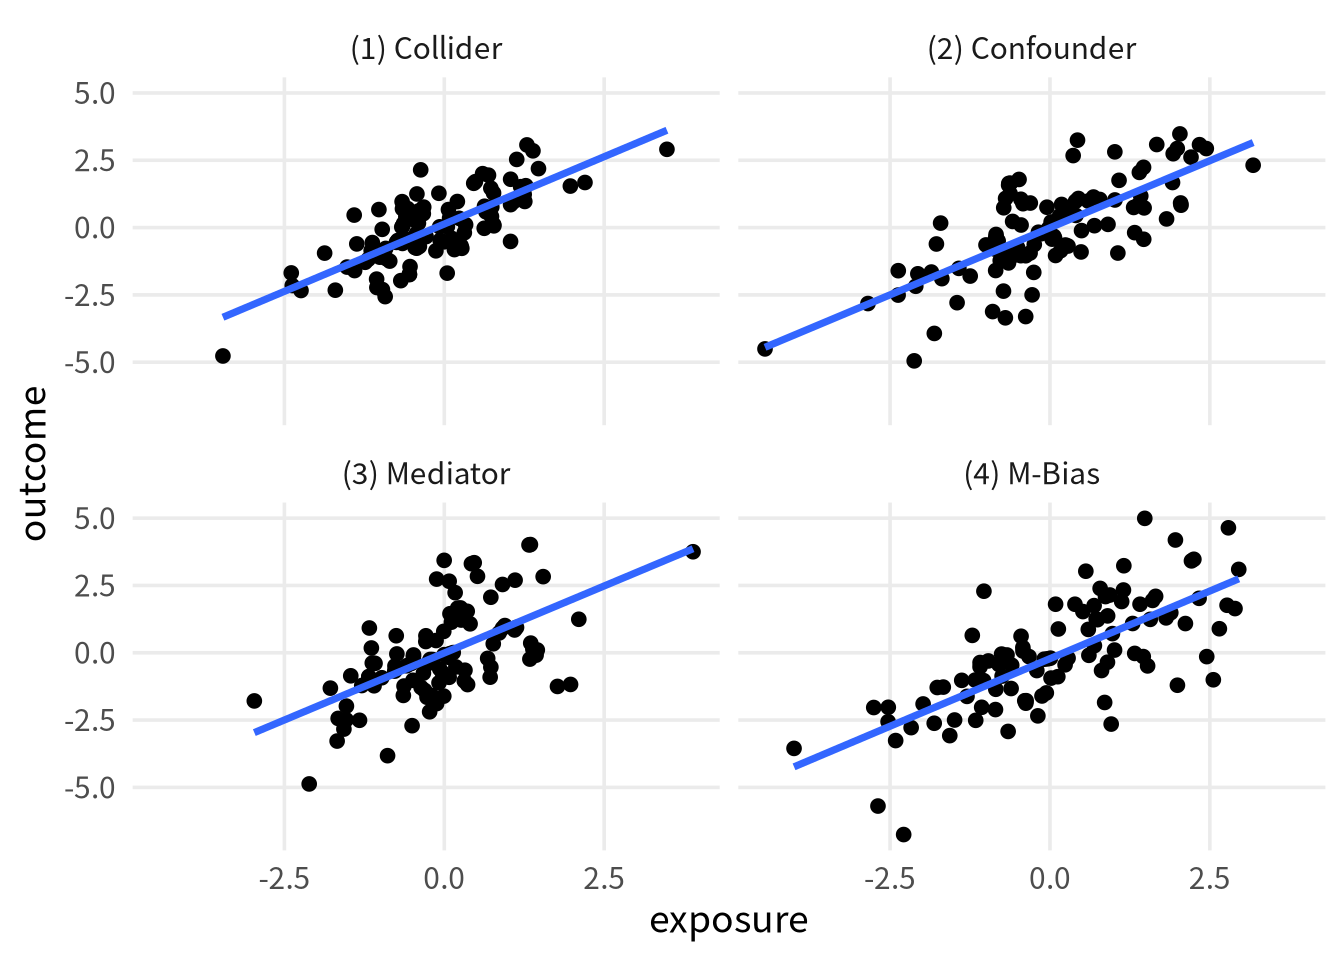
covariate를 통제해서는 안 됩니다. 두 번째 데이터셋에서 covariate는 교란 요인이며, 우리는 이를 통제해야 합니다. 세 번째 데이터셋에서 covariate는 매개 요인이며, 직접 효과를 원한다면 통제해야 하지만 총 효과를 원한다면 통제해서는 안 됩니다.
데이터가 이러한 인과 구조를 구별할 수 없다면 우리는 무엇을 할 수 있을까요? 최선의 답은 데이터 생성 메커니즘에 대해 잘 이해하는 것입니다. 그림 5.7 에서는 각 데이터셋에 대한 DAG를 보여줍니다. 일단 각 데이터셋에 대한 DAG를 작성하면, DAG가 옳다는 가정 하에 올바른 조정 집합을 위해 DAG를 쿼리하기만 하면 됩니다.
library(ggdag)

d_coll <- quartet_collider(x = "e", y = "o", z = "c")

d_conf <- quartet_confounder(x = "e", y = "o", z = "c")

d_med <- quartet_mediator(x = "e", y = "o", z = "c")

d_mbias <- quartet_m_bias(x = "e", y = "o", z = "c", u1 = "u1", u2 = "u2")

p_coll <- d_coll |>
  tidy_dagitty() |>
  mutate(covariate = if_else(label == "c", "covariate", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  theme(legend.position = "bottom") +
  ggtitle("(1) 콜라이더") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "covariate", na.value = "grey70")


p_conf <- d_conf |>
  tidy_dagitty() |>
  mutate(covariate = if_else(label == "c", "covariate", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  theme(legend.position = "bottom") +
  ggtitle("(2) 교란 요인") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "covariate", na.value = "grey70")

p_med <- d_med |>
  tidy_dagitty() |>
  mutate(covariate = if_else(label == "c", "covariate", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  theme(legend.position = "bottom") +
  ggtitle("(3) 매개 요인") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "covariate", na.value = "grey70")


p_m_bias <- d_mbias |>
  tidy_dagitty() |>
  mutate(covariate = if_else(label == "c", "covariate", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  ggtitle("(4) M-편향") +
  theme(legend.position = "bottom") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "covariate", na.value = "grey70")


p_coll
p_conf
p_med
p_m_bias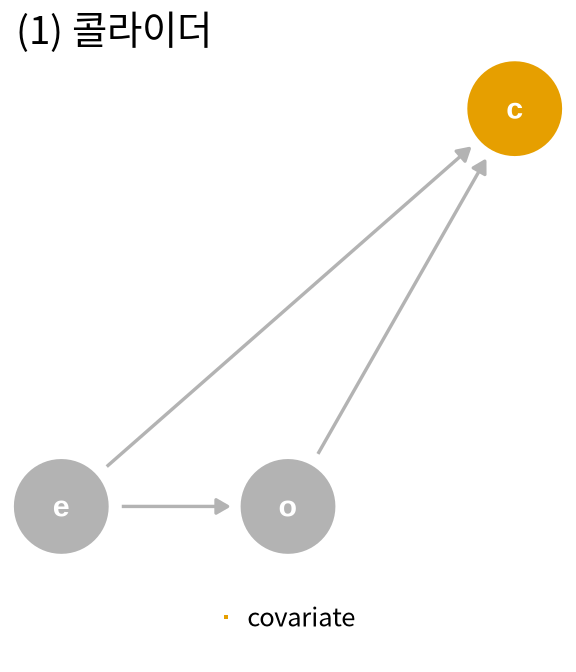
covariate (c)는 콜라이더입니다. 우리는 exposure (e)와 outcome (o)의 후손(descendant)인 covariate를 조정해서는 안 됩니다.
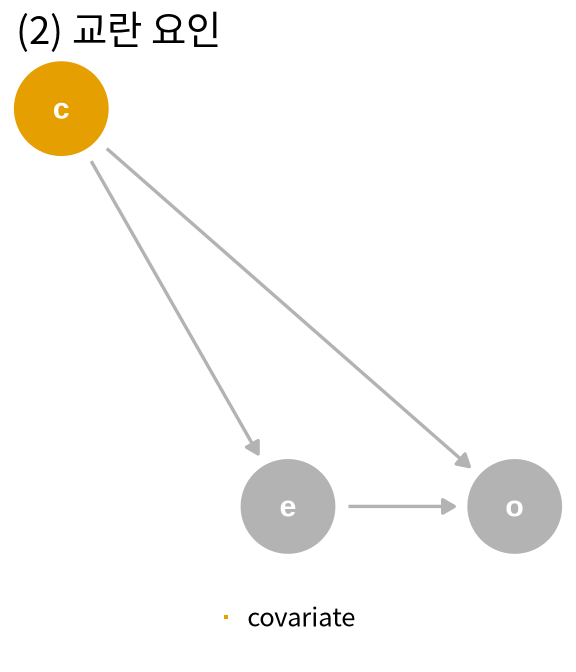
covariate (c)는 교란 요인입니다. covariate는 exposure (e)와 outcome (o)의 공통 원인이며 백도어 경로를 나타내므로, 올바른 답을 얻기 위해 이를 반드시 조정해야 합니다.
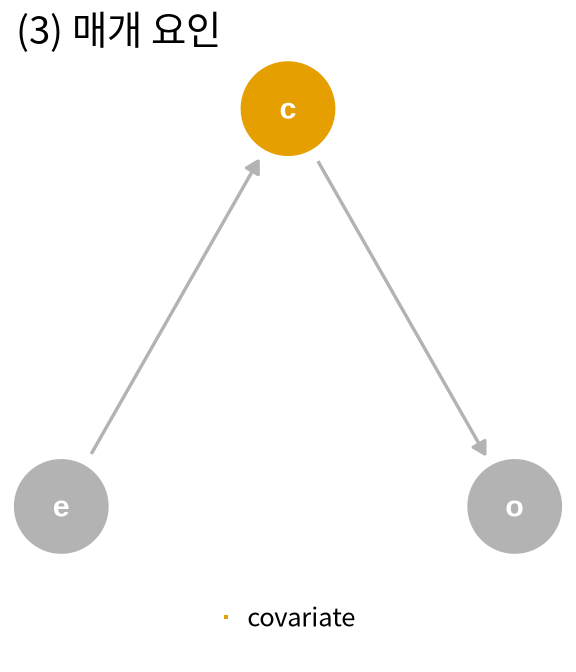
covariate (c)는 매개 요인입니다. covariate는 exposure (e)의 후손이자 outcome (o)의 원인입니다. covariate를 통과하는 경로는 간접 경로이고, exposure를 통한 경로는 직접 경로입니다. 직접 효과를 원한다면 covariate를 조정해야 하지만, 총 효과를 원한다면 조정하지 않습니다.
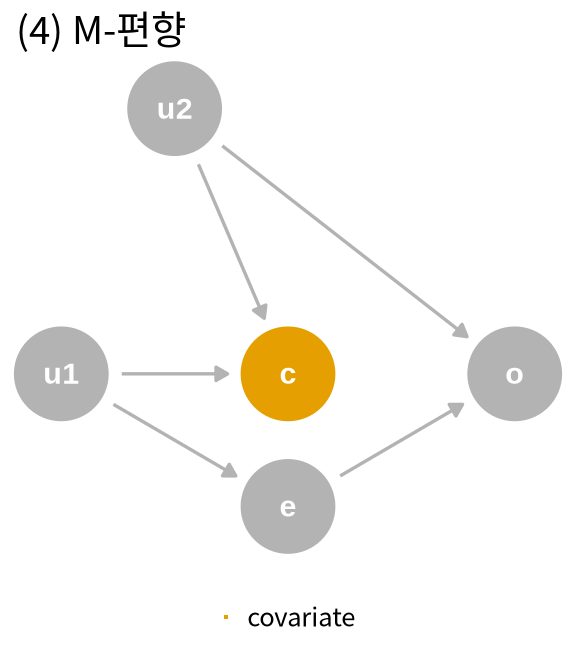
covariate (c)는 M-편향을 통한 콜라이더입니다. covariate가 outcome (o)와 exposure (e)보다 먼저 발생함에도 불구하고 여전히 콜라이더입니다. 우리는 covariate를 조정해서는 안 됩니다. 특히 측정되지 않은 u1과 u2를 통한 편향을 통제할 수 없기 때문입니다.
이 DAG들에서의 데이터 생성 메커니즘1은 실제 데이터셋을 생성한 것과 일치하므로, 우리는 DAG를 사용하여 올바른 효과를 결정할 수 있습니다: 데이터셋 1과 4에서는 조정하지 않은 효과이고, 데이터셋 2에서는 조정한 효과입니다. 데이터셋 3의 경우, 우리가 어떤 매개 효과를 원하는지에 따라 달라집니다: 직접 효과를 위해서는 조정하고, 총 효과를 위해서는 조정하지 않습니다.
| 데이터 생성 메커니즘 | 올바른 인과 모델 | 실제 인과 효과 |
|---|---|---|
| (1) 콜라이더 | outcome ~ exposure | 1 |
| (2) 교란 요인 | outcome ~ exposure + covariate | 0.5 |
| (3) 매개 요인 | 직접 효과: outcome ~ exposure + covariate, 총 효과: outcome ~ exposure | 직접 효과: 0, 총 효과: 1 |
| (4) M-편향 | outcome ~ exposure | 1 |
지금까지 우리는 여러분에게 DAG의 유용성을 충분히 설득했기를 바랍니다. 하지만 올바른 DAG를 구축하는 것은 매우 어려운 일입니다. 인과적 콰르텟에서는 우리가 직접 데이터를 생성했기 때문에 DAG를 알고 있었습니다. 실제 생활에서는 인과 구조를 조립하기 위해 배경 지식이 필요합니다. 어떤 질문들에 대해서는 그러한 배경 지식이 가용하지 않을 수도 있습니다. 또 어떤 경우에는 그림 4.28 에서처럼 변수들이 서로 맞물려 진화할 때 인과 구조의 복잡성을 걱정하게 될 수도 있습니다.
DAG가 불완전하거나 불확실할 때 특히 유용한 휴리스틱(heuristic)이 하나 있는데, 바로 시간입니다. 인과 관계는 시간적이기 때문에, 원인은 반드시 결과보다 먼저 일어나야 합니다. 교란 요인을 조정할지 여부를 결정할 때 발생하는 많은 문제(전부는 아니지만)는 단순히 변수들을 시간 순서대로 배치함으로써 해결됩니다. 시간 순서는 DAG에서 시각화할 수 있는 가장 중요한 가정 중 하나이므로, DAG의 완성도와 상관없이 시작하기에 아주 좋은 지점입니다.
그림 5.8 (a) 을 고려해 봅시다. 이는 covariate가 기준점과 추적 관찰 시점 모두에서 측정된 콜라이더 DAG의 시간 순서 버전입니다. 원래의 DAG는 사실 두 번째 측정을 나타내는데, 여기서 covariate는 결과와 노출 모두의 후손입니다. 하지만 연구 시작 시점에 측정된 동일한 covariate를 통제한다면 (그림 5.8 (b)), 그것은 아직 일어나지 않았기 때문에 추적 관찰 시점의 결과의 후손이 될 수 없습니다. 따라서 covariate의 인과 구조에 대한 배경 지식이 부족할 때, 편향을 피하기 위한 방어적 조치로 시간 순서를 사용할 수 있습니다. 오직 결과보다 먼저 일어난 변수들만 통제하십시오.
d_coll <- quartet_time_collider(
  x0 = "e0", x1 = "e1", x2 = "e2", x3 = "e3",
  y1 = "o1", y2 = "o2", y3 = "o3",
  z1 = "c1", z2 = "c2", z3 = "c3"
)

d_coll |>
  tidy_dagitty() |>
    mutate(covariate = if_else(label == "c3", "공변량\n(추적 관찰)", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  theme(legend.position = "bottom") +
  geom_vline(xintercept = c(2.6, 3.25, 3.6, 4.25), lty = 2, color = "grey60") +
    annotate("label", x = 2.925, y = 0.97, label = "기준점", color = "grey50") +
    annotate("label", x = 3.925, y = 0.97, label = "추적 관찰", color = "grey50") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "공변량\n(추적 관찰)", na.value = "grey70")

d_coll |>
  tidy_dagitty() |>
    mutate(covariate = if_else(label == "c2", "공변량\n(기준점)", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  theme(legend.position = "bottom") +
  geom_vline(xintercept = c(2.6, 3.25, 3.6, 4.25), lty = 2, color = "grey60") +
    annotate("label", x = 2.925, y = 0.97, label = "기준점", color = "grey50") +
    annotate("label", x = 3.925, y = 0.97, label = "추적 관찰", color = "grey50") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "공변량\n(기준점)", na.value = "grey70")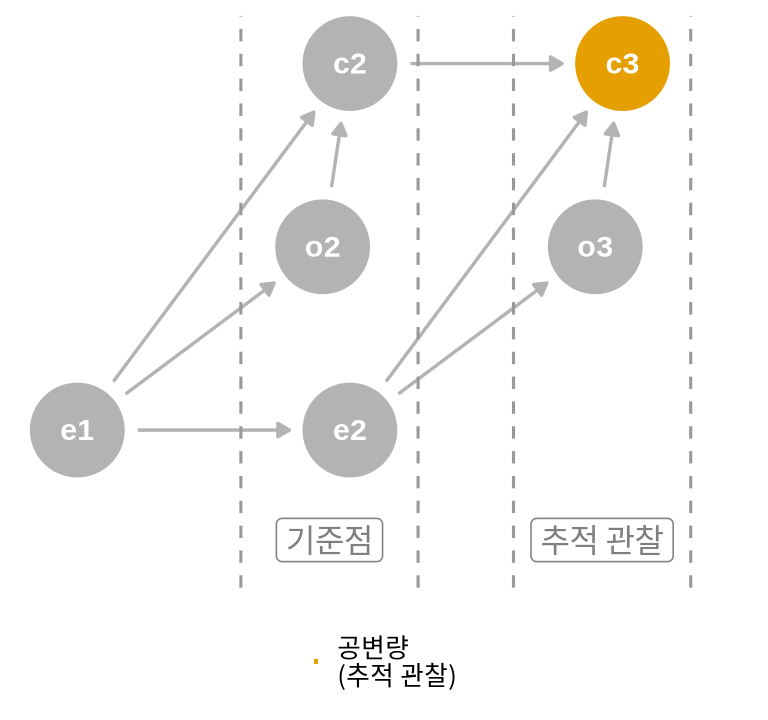
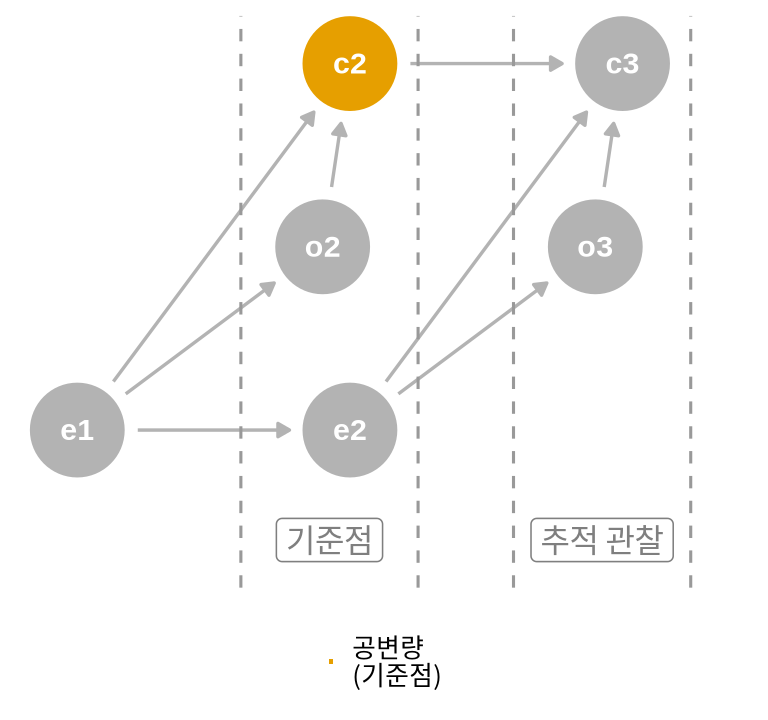
covariate를 통제하는 것은 콜라이더이지만, 기준점 시점의 covariate를 통제하는 것은 그렇지 않습니다.
시간 순서 휴리스틱은 간단한 규칙에 의존합니다: 미래를 조정하지 마십시오.
quartets 패키지의 causal_quartet_time은 네 데이터셋 각각에 대해 각 변수의 시간 순서 측정값을 가지고 있습니다. 각각은 *_baseline(기준점)과 *_followup(추적 관찰) 측정값을 가집니다.
causal_quartet_time# A tibble: 400 × 12
covariate_baseline exposure_baseline
<dbl> <dbl>
1 -0.0963 -1.43
2 -1.11 0.0593
3 0.647 0.370
4 0.755 0.00471
5 1.19 0.340
6 -0.588 -3.61
7 -1.13 1.44
8 0.689 1.02
9 -1.49 -2.43
10 -2.78 -1.26
# ℹ 390 more rows
# ℹ 10 more variables: outcome_baseline <dbl>,
# covariate_followup <dbl>, exposure_followup <dbl>,
# outcome_followup <dbl>, exposure_mid <dbl>,
# covariate_mid <dbl>, outcome_mid <dbl>, u1 <dbl>,
# u2 <dbl>, dataset <chr>outcome_followup ~ exposure_baseline + covariate_baseline 공식을 사용하면 네 데이터셋 중 세 개에서 잘 작동합니다. 비록 covariate_baseline이 두 번째 데이터셋의 조정 집합에만 포함되어 있지만, 다른 두 데이터셋에서도 콜라이더가 아니기 때문에 문제가 되지 않습니다.
causal_quartet_time |>
  nest_by(dataset) |>
  mutate(
    adjusted_effect =
      coef(
        lm(
          outcome_followup ~ exposure_baseline + covariate_baseline,
          data = data
        )
      )[2]
  ) |>
  bind_cols(tibble(truth = c(1, 0.5, 1, 1))) |>
  select(-data, dataset) |>
  ungroup() |>
  set_names(c("데이터셋", "조정된 효과", "참값")) |>
  gt::gt() |>
gt::fmt_number(columns = -데이터셋)| 데이터셋 | 조정된 효과 | 참값 |
|---|---|---|
| (1) Collider | 1.00 | 1.00 |
| (2) Confounder | 0.50 | 0.50 |
| (3) Mediator | 1.00 | 1.00 |
| (4) M-Bias | 0.88 | 1.00 |
exposure_baseline이 outcome_followup에 미치는 조정된 효과. covariate_baseline을 조정한 효과는 네 데이터셋 중 세 개에서 올바릅니다.
이것이 실패하는 곳은 M-편향 예시인 데이터셋 4입니다. 이 사례에서 covariate_baseline은 여전히 콜라이더인데, 그 충돌이 노출과 결과 모두보다 먼저 발생하기 때문입니다. 그러나 섹션 4.3.2.1 에서 논의했듯이, 무언가가 정말로 M-편향인지 의심스럽다면 이를 조정하는 것이 조정하지 않는 것보다 낫습니다. 교란 편향이 더 심각한 경향이 있고, 의미 있는 M-편향은 실제 생활에서 아마도 드물 것이기 때문입니다. 실제 인과 구조가 완벽한 M-편향에서 벗어날수록 편향의 심각성은 감소하는 경향이 있습니다. 따라서 그것이 명확하게 M-편향이라면 해당 변수를 조정하지 마십시오. 명확하지 않다면 조정하십시오.
콜라이더 편향 또한 하나의 열린 경로일 뿐이므로, 특정 상황에서는 콜라이더를 조정함으로써 유발된 편향을 차단하는 것이 가능하다는 점을 기억하십시오. 만약 우리에게 u1과 u2가 있다면, 우리는 잠재적인 콜라이더 편향을 차단하면서 covariate를 통제할 수 있습니다. 즉, 때때로 우리가 경로를 열었을 때, 그것을 다시 닫을 수도 있습니다.
예측 측정치들 또한 네 가지 데이터셋을 구별하는 데 실패합니다. 표 5.5 에서는 모델에 covariate를 추가했을 때 몇 가지 표준 예측 지표의 차이를 보여줍니다. 각 데이터셋에서 covariate는 결과에 대한 연관성 정보를 포함하고 있기 때문에 모델에 정보를 추가합니다 2. RMSE는 낮아져 더 나은 적합도를 나타내고, R2은 높아져 더 많은 변동성이 설명됨을 보여줍니다. covariate의 계수는 그것이 포함하고 있는 outcome에 대한 정보를 나타낼 뿐이며, 그 정보가 인과 구조의 어디에서 기인하는지는 말해주지 않습니다. 상관관계는 인과관계가 아니며, 예측 또한 마찬가지입니다. 콜라이더 데이터셋의 경우, 그것은 노출과 결과 이후에 발생하기 때문에 예측 시점에는 covariate를 가질 수 없으므로 유용한 예측 도구조차 되지 못합니다.
get_rmse <- function(data, model) {
  sqrt(mean((data$outcome - predict(model, data))^2))
}

get_r_squared <- function(model) {
  summary(model)$r.squared
}

causal_quartet |>
  nest_by(dataset) |>
  mutate(
    rmse1 = get_rmse(
      data,
      lm(outcome ~ exposure, data = data)
    ),
    rmse2 =
      get_rmse(
        data,
        lm(outcome ~ exposure + covariate, data = data)
      ),
    rmse_diff = rmse2 - rmse1,
    r_squared1 = get_r_squared(lm(outcome ~ exposure, data = data)),
    r_squared2 = get_r_squared(lm(outcome ~ exposure + covariate, data = data)),
    r_squared_diff = r_squared2 - r_squared1
  ) |>
  select(dataset, rmse = rmse_diff, r_squared = r_squared_diff) |>
  ungroup() |>
  gt::gt() |>
  gt::fmt_number() |>
  gt::cols_label(
    dataset = "데이터셋",
    rmse = "RMSE",
    r_squared = gt::md("R^2^")
)| 데이터셋 | RMSE | R2 |
|---|---|---|
| (1) Collider | −0.14 | 0.12 |
| (2) Confounder | −0.20 | 0.14 |
| (3) Mediator | −0.48 | 0.37 |
| (4) M-Bias | −0.01 | 0.01 |
covariate 포함 여부에 따른 각 데이터셋의 outcome에 대한 예측 지표 차이. 각 데이터셋에서 covariate는 모델에 정보를 추가하지만, 이는 적절한 인과 모델이 무엇인지에 대해서는 거의 안내를 해주지 못합니다.
이와 관련하여, 우리가 관심을 갖는 원인 이외의 변수들에 대한 모델 계수는 해석하기 어려울 수 있습니다. outcome ~ exposure + covariate 모델에서, exposure뿐만 아니라 covariate의 계수도 제시하고 싶은 유혹이 생깁니다. 문제는 섹션 1.1.4 에서 논의했듯이, covariate가 outcome에 미치는 효과에 대한 인과 구조가 exposure가 outcome에 미치는 효과에 대한 구조와 다를 수 있다는 점입니다. 다른 변수들이 포함된 콰르텟 DAG의 변형을 고려해 봅시다.
먼저 교란 요인 DAG부터 시작해 봅시다. 그림 5.9 에서 우리는 covariate가 교란 요인임을 봅니다. 만약 이 DAG가 outcome에 대한 완전한 인과 구조를 나타낸다면, 모델링 과정의 다른 가정들을 충족했다는 전제 하에 outcome ~ exposure + covariate 모델은 exposure가 outcome에 미치는 효과에 대해 편향되지 않은 추정치를 제공할 것입니다. covariate가 outcome에 미치는 효과에 대한 조정 집합은 비어 있으며, exposure는 콜라이더가 아니므로 이를 통제한다고 해서 편향이 유발되지는 않습니다 4. 하지만 다시 한번 보십시오. exposure는 covariate가 outcome에 미치는 효과에 대해 매개 요인입니다; 총 효과의 일부는 exposure를 통해 매개되는 반면, covariate가 outcome에 직접적으로 미치는 효과도 존재합니다. 두 추정치 모두 편향되지 않았지만, 그들은 서로 다른 유형의 추정치입니다. exposure가 outcome에 미치는 효과는 그 관계의 총 효과(total effect)인 반면, covariate가 outcome에 미치는 효과는 직접 효과(direct effect)입니다.
p_conf +
  ggtitle(NULL)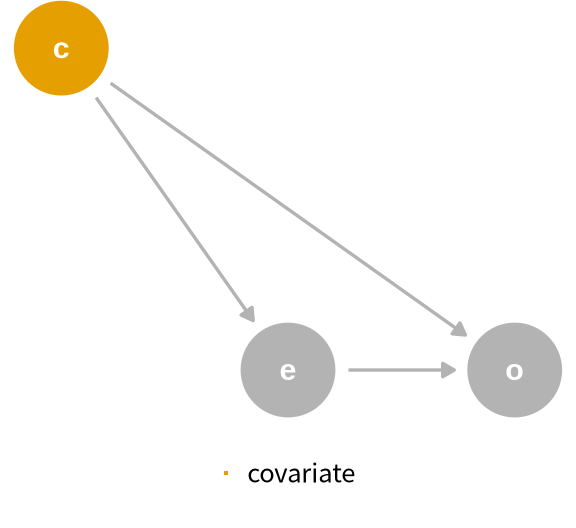
covariate는 교란 요인입니다. 자세히 살펴보면, covariate가 outcome에 미치는 효과의 관점에서 볼 때 exposure는 매개 요인이라는 것을 깨닫게 될 것입니다.
만약 covariate와 outcome의 공동 원인인 q를 추가한다면 어떨까요? 그림 5.10 에서 조정 집합은 여전히 서로 다릅니다. outcome ~ exposure에 대한 조정 집합은 여전히 {covariate}로 동일합니다. 하지만 outcome ~ covariate에 대한 조정 집합은 {q}입니다. 즉, q는 covariate가 outcome에 미치는 효과에 대한 교란 요인입니다. outcome ~ exposure + covariate 모델은 exposure에 대해서는 올바른 효과를 생성하겠지만, covariate의 직접 효과에 대해서는 그렇지 않을 것입니다. 이제 우리는 covariate가 exposure와 다른 유형의 질문에 답할 뿐만 아니라, q의 부재로 인해 편향되어 있는 상황에 놓이게 되었습니다.
coords <- list(
  x = c(X = 1.75, Z = 1, Y = 3, Q = 0),
  y = c(X = 1.1, Z = 1.5, Y = 1, Q = 1)
)

d_conf2 <- dagify(
  X ~ Z,
  Y ~ X + Z + Q,
  Z ~ Q,
  exposure = "X",
  outcome = "Y",
  labels = c(X = "e", Y = "o", Z = "c", Q = "q"),
  coords = coords
)

p_conf2 <- d_conf2 |>
  tidy_dagitty() |>
  mutate(covariate = if_else(name == "Q", "공변량", NA_character_)) |>
  ggplot(
    aes(x = x, y = y, xend = xend, yend = yend)
  ) +
  geom_dag_point(aes(color = covariate)) +
  geom_dag_edges(edge_color = "grey70") +
  geom_dag_text(aes(label = label)) +
  theme_dag() +
  coord_cartesian(clip = "off") +
  theme(legend.position = "none") +
  guides(color = guide_legend(
    title = NULL,
    keywidth = unit(1.4, "mm"),
    override.aes = list(size = 3.4, shape = 15)
  )) +
  scale_color_discrete(breaks = "공변량", na.value = "grey70")

p_conf2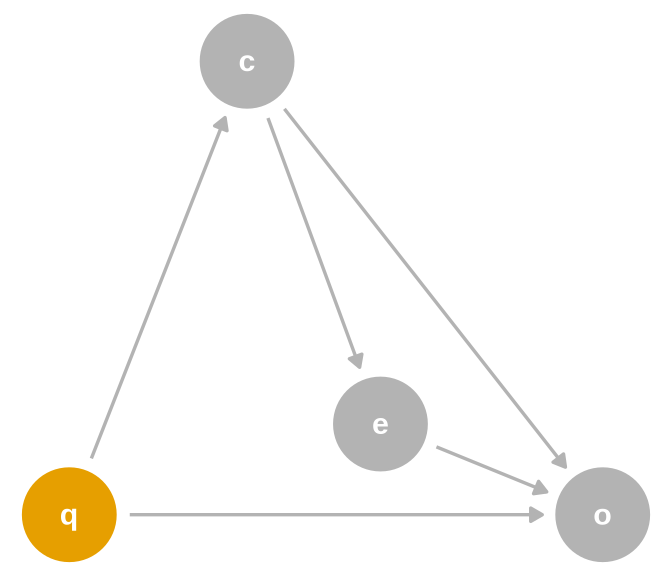
covariate는 교란 요인입니다. 이제 covariate와 outcome 사이의 관계는 q에 의해 교란되는데, q는 exposure가 outcome에 미치는 편향되지 않은 효과를 계산하는 데는 필요하지 않은 변수입니다.
단일 인과 모델을 명시하는 것은 매우 어려운 일입니다. 하나의 모델이 여러 개의 인과적 질문에 답하도록 만드는 것은 기하급수적으로 더 어렵습니다. 만약 그렇게 하려고 시도한다면, 두 질문 모두에 대해 동일한 정밀 조사를 적용하십시오 5. 두 질문에 모두 답할 수 있는 단일 조정 집합을 갖는 것이 가능할까요? 불가능하다면, 두 개의 모델을 명시하거나 질문 중 하나를 포기하십시오. 가능하다면, 각 추정치가 올바른 질문에 답하고 있는지 확인해야 합니다. 우리는 장 14 에서 결합(joint) 인과 효과에 대해서도 논의할 것입니다.
불행히도 여러 노출과 효과 유형에 대한 조정 집합을 찾아내는 알고리즘은 아직 충분히 발달하지 않았으므로, 조정 집합들의 교집합을 결정할 때 인과 구조에 대한 여러분의 지식에 의존해야 할 수도 있습니다.
데이터셋을 생성한 모델들에 대해서는 D’Agostino McGowan, Gerke, 와/과 Barrett (2023) 을 참조하십시오.↩︎
M-편향의 경우, 모델에 covariate를 포함하는 것은 그것이 결과의 원인 중 하나인 u2에 대한 정보를 가지고 있는 만큼 도움이 됩니다. 이 사례에서 데이터 생성 메커니즘은 covariate가 u2보다 u1으로부터 더 많은 정보를 포함하도록 되어 있어서, 예측 가치를 그렇게 많이 추가하지는 않습니다. 무작위 노이즈가 u2가 설명하지 못하는 부분의 대부분을 차지합니다.↩︎
’표 2의 오류(Table Two Fallacy)’는 건강 연구 저널에서 논문의 두 번째 표에 모델 계수 전체 세트를 싣는 경향에서 이름을 따온 것입니다. 이 오류에 대한 자세한 논의는 Westreich 와/과 Greenland (2013) 을 참조하십시오.↩︎
또한, OLS는 가산적(collapsible) 효과를 생성합니다. 오즈비(odds ratio)나 위험비(risk ratio)와 같은 다른 효과들은 비가산적(non-collapsible)인데, 이는 교란이 없을 때조차 조건부 오즈비나 위험비가 한계(marginal) 버전과 다를 수 있음을 의미합니다. 우리는 섹션 11.4.2 에서 비가산성에 대해 논의할 것입니다.↩︎
일상적인(casual) 추론을 하는 사람들은 이런 식으로 단일 모델에서 많은 효과들을 해석하곤 하지만, 우리는 이를 무모한 행동이라고 생각합니다.↩︎