경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
지금까지 살펴본 대부분의 예시는 연속형이나 이진형 결과를 다루었습니다. 그러나 많은 연구에서 관심 있는 결과는 어떤 사건이 발생하기까지의 시간(time-to-event)입니다. 예를 들어, 환자가 치료 후 얼마나 오래 생존하는지, 또는 기계 부품이 고장나기까지 얼마나 오래 작동하는지가 관심 대상일 수 있습니다.
이러한 분석을 생존 분석(survival analysis) 또는 시간-사건 분석(time-to-event analysis)이라고 합니다. 생존 분석에서 인과 추론을 적용하면 처치가 사건 발생 시간에 미치는 인과적 효과를 추정할 수 있습니다.
19장에서는 세 가지 주요 주제를 다룹니다:
시간-사건 분석의 주요 특징은 검열(censoring)입니다. 검열은 관찰 기간이 종료될 때까지 일부 참가자에게 관심 사건이 나타나지 않을 때 생깁니다. 이때 우리는 그 참가자가 검열 시점까지는 사건이 발생하지 않았다는 것만 알 수 있습니다.
생존 데이터는 일반적으로 다음과 같은 형태를 가집니다:
id: 개인 식별자time: 추적 관찰 기간 또는 사건 발생 시간event: 사건 발생 여부 (1 = 사건 발생, 0 = 검열)library(dplyr)
library(tidyr)
library(broom)
# 생존 분석 데이터를 시뮬레이션합니다
# (실제 생존 데이터가 없어 touringplans 데이터를 기반으로 시뮬레이션)
set.seed(2024)
n <- 500
survival_sim <- tibble(
id = 1:n,
# 노출: 처치군(1) vs 대조군(0)
treatment = rbinom(n, 1, 0.5),
# 공변량 (교란 요인)
age_group = sample(c("young", "middle", "old"), n, replace = TRUE),
severity = rnorm(n, 5, 1.5), # 질병 중증도
) |>
mutate(
# 처치가 사건 발생 위험을 감소시킨다고 가정
baseline_hazard = 0.05 * exp(0.3 * (severity - 5)),
hazard = baseline_hazard * exp(-0.5 * treatment),
# 지수 분포에서 생존 시간 생성
true_time = rexp(n, rate = hazard),
# 12개월에서 행정적 검열
admin_censor = 12,
# 무작위 탈락 검열 (처치군과 비교하여 중증도가 높으면 탈락 가능성 증가)
random_censor = rexp(n, rate = 0.02 + 0.01 * (severity - 5)),
# 최종 추적 관찰 시간과 사건 여부
time = pmin(true_time, admin_censor, random_censor),
event = as.integer(true_time <= pmin(admin_censor, random_censor))
) |>
select(id, treatment, age_group, severity, time, event)
cat("데이터 구조:\n")데이터 구조:glimpse(survival_sim)Rows: 500
Columns: 6
$ id <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, …
$ treatment <int> 1, 0, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1,…
$ age_group <chr> "old", "young", "young", "young", "…
$ severity <dbl> 4.744, 6.713, 2.841, 3.168, 6.248, …
$ time <dbl> 0.4328, 2.9311, NaN, 12.0000, 5.392…
$ event <int> 1, 1, NA, 0, 1, NA, 0, 0, 1, 0, 1, …cat("\n사건 발생 요약:\n")
사건 발생 요약:# A tibble: 2 × 5
treatment n events event_rate median_time
<int> <int> <int> <dbl> <dbl>
1 0 242 NA NA NA
2 1 258 NA NA NA풀링된 로지스틱 회귀를 위해 생존 데이터를 각 시간 구간마다 하나의 행이 있는 장기형(long format)으로 변환해야 합니다.
# 생존 데이터를 장기형으로 변환 (purrr::map + tidyr::unnest 방식)
# make_long_rows: interval과 event_at_interval만 반환 (부모 df와 충돌 방지)
make_long_rows <- function(time_int, event) {
  max_t <- pmax(1L, as.integer(time_int))  # 최소 1구간 보장
  tibble(
    interval          = seq_len(max_t),
    event_at_interval = as.integer(seq_len(max_t) == max_t & event == 1)
  )
}

survival_long <- survival_sim |>
  mutate(time_int = ceiling(time)) |>
  filter(!is.na(time_int)) |>        # NA 행 제거
  mutate(
    rows = purrr::pmap(list(time_int, event), make_long_rows)
  ) |>
  tidyr::unnest(rows) |>
  select(id, treatment, age_group, severity, interval, event_at_interval)

cat("장기형 데이터 첫 10행:\n")
장기형 데이터 첫 10행:head(survival_long, 10)# A tibble: 10 × 6
id treatment age_group severity interval
<int> <int> <chr> <dbl> <int>
1 1 1 old 4.74 1
2 2 0 young 6.71 1
3 2 0 young 6.71 2
4 2 0 young 6.71 3
5 4 1 young 3.17 1
6 4 1 young 3.17 2
7 4 1 young 3.17 3
8 4 1 young 3.17 4
9 4 1 young 3.17 5
10 4 1 young 3.17 6
# ℹ 1 more variable: event_at_interval <int>
총 관측 행 수: 3787 풀링된 로지스틱 회귀(pooled logistic regression)는 각 시간 구간에서 사건이 발생할 조건부 확률을 모델링하는 방법입니다. 각 시간 구간에서의 사건 발생 여부를 이진 결과로 취급하고, 로지스틱 회귀를 적합시킵니다.
사건 발생 위험이 충분히 희귀할 때(희귀 사건 가정), 풀링된 로지스틱 회귀는 이산 시간 위험 모델(discrete-time hazard model)로 볼 수 있으며, 연속시간 콕스 비례 위험 모델(Cox proportional hazards model)과 유사한 결과를 제공합니다.
library(splines)

# 풀링된 로지스틱 회귀 (처치, 시간, 공변량 포함)
# 시간의 비선형적 영향을 포착하기 위해 자연 스플라인 사용
pooled_logistic <- glm(
  event_at_interval ~
    treatment +
    ns(interval, df = 3) +  # 시간의 비선형 효과
    age_group + severity,
  data = survival_long,
  family = binomial()
)

tidy(pooled_logistic, exponentiate = TRUE, conf.int = TRUE) |>
  filter(term == "treatment")
# A tibble: 1 × 7
term estimate std.error statistic p.value conf.low
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 treatm… 0.703 0.160 -2.21 0.0274 0.513
# ℹ 1 more variable: conf.high <dbl>처치 효과의 지수화된 계수는 오즈비(odds ratio)로 해석됩니다. 희귀 사건 가정 하에서 이는 위험비(hazard ratio)에 근사합니다.
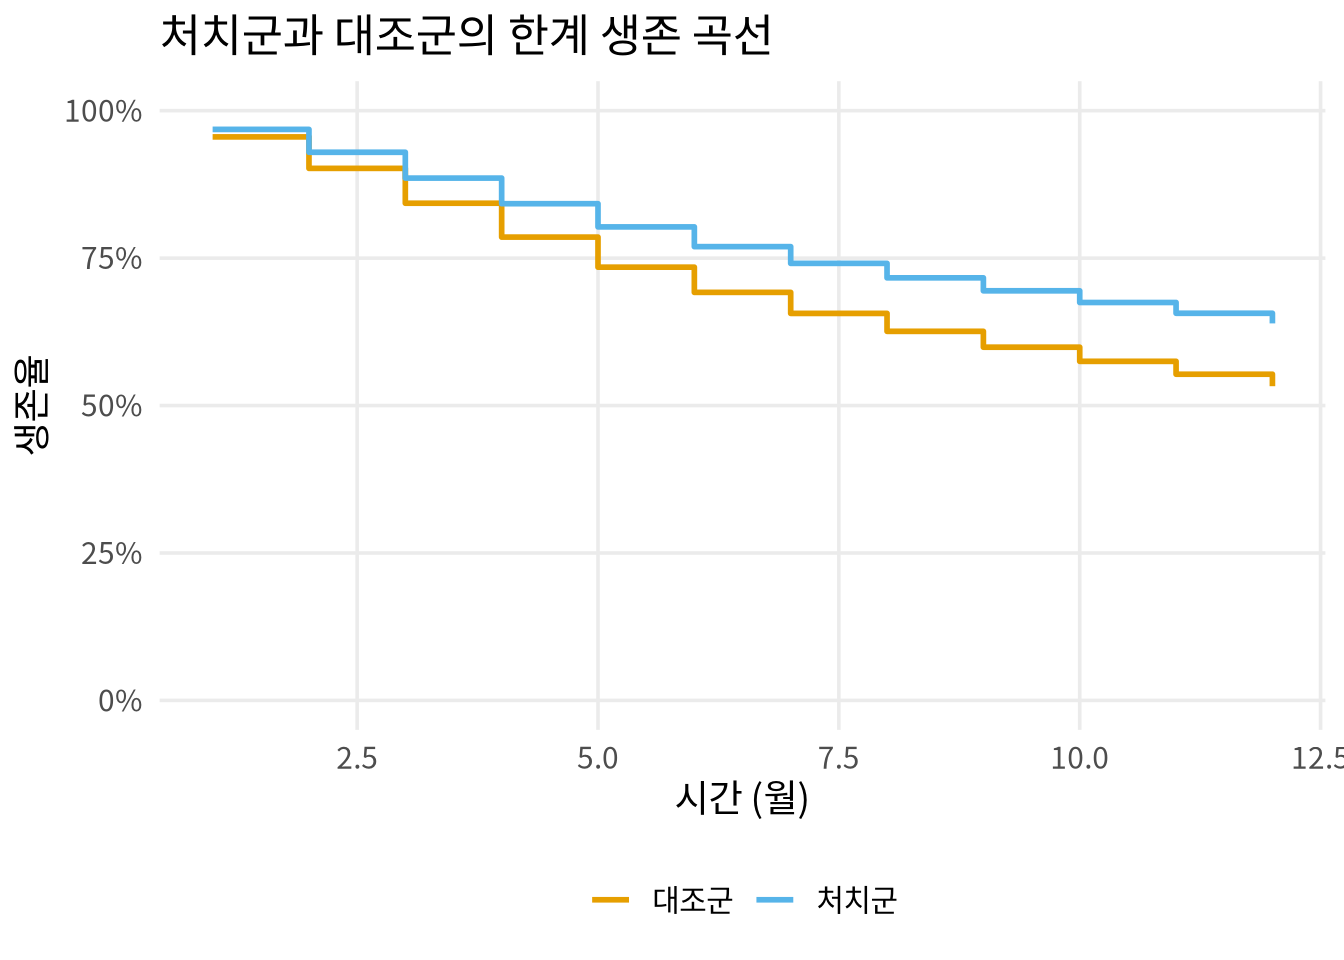
풀링된 로지스틱 회귀 모델을 사용하여 각 처치 조건에서의 한계 생존율(marginal survival curve)을 추정할 수 있습니다. 이는 장 13 에서 소개한 G-공식의 시간-사건 버전입니다.
# 한계 생존 곡선 계산
max_time <- max(ceiling(survival_sim$time))

# 각 처치 조건에서 모든 시간 구간에 대한 사건 확률 예측
predict_marginal_survival <- function(trt_val) {
  # 모든 개인을 동일한 처치값으로 설정
  pred_data <- survival_long |>
    mutate(treatment = trt_val)

  # 각 시간 구간에서의 조건부 사건 확률 예측
  pred_probs <- predict(pooled_logistic, newdata = pred_data, type = "response")

  pred_data |>
    mutate(hazard_predicted = pred_probs) |>
    group_by(interval) |>
    summarize(avg_hazard = mean(hazard_predicted)) |>
    arrange(interval) |>
    mutate(
      survival = cumprod(1 - avg_hazard),
      treatment = trt_val
    )
}

survival_curves <- bind_rows(
  predict_marginal_survival(0),
  predict_marginal_survival(1)
) |>
  mutate(treatment_label = ifelse(treatment == 1, "처치군", "대조군"))

# 생존 곡선 시각화
library(ggplot2)

ggplot(survival_curves, aes(x = interval, y = survival,
                             color = treatment_label,
                             group = treatment_label)) +
  geom_step(linewidth = 1) +
  scale_y_continuous(limits = c(0, 1), labels = scales::percent) +
  labs(
    x = "시간 (월)",
    y = "생존율",
    color = NULL,
    title = "처치군과 대조군의 한계 생존 곡선"
  )
# 특정 시점에서의 효과 추정: 6개월 및 12개월 생존율 차이
time_points <- c(6, 12)

survival_at_time <- survival_curves |>
  filter(interval %in% time_points) |>
  select(interval, treatment_label, survival) |>
  pivot_wider(names_from = treatment_label, values_from = survival) |>
  mutate(
    risk_difference = 처치군 - 대조군,
    risk_ratio = 처치군 / 대조군
  )

cat("시점별 생존율 비교:\n")
시점별 생존율 비교:print(survival_at_time)# A tibble: 2 × 5
interval 대조군 처치군 risk_difference risk_ratio
<int> <dbl> <dbl> <dbl> <dbl>
1 6 0.692 0.769 0.0775 1.11
2 12 0.533 0.639 0.107 1.20풀링된 로지스틱 회귀를 사용한 한계 생존 곡선과 처치 효과의 신뢰 구간은 부트스트랩을 통해 계산할 수 있습니다.
library(rsample)

compute_survival_effect <- function(.split) {
  .df <- as.data.frame(.split)

  # 선택된 샘플에 대한 장기형 데이터 재생성 (make_long_rows 재사용)
  survival_long_boot <- .df |>
    mutate(time_int = ceiling(time)) |>
    filter(!is.na(time_int)) |>
    mutate(
      rows = purrr::pmap(list(time_int, event), make_long_rows)
    ) |>
    tidyr::unnest(rows) |>
    select(id, treatment, age_group, severity, interval, event_at_interval)

  # 풀링된 로지스틱 회귀
  fit <- glm(
    event_at_interval ~
      treatment + ns(interval, df = 3) + age_group + severity,
    data = survival_long_boot,
    family = binomial()
  )

  # 각 처치 조건에서 12개월 생존율 추정
  compute_surv_at_12 <- function(trt) {
    pred_d <- survival_long_boot |> mutate(treatment = trt)
    prbs <- predict(fit, newdata = pred_d, type = "response")
    pred_d |>
      mutate(haz = prbs) |>
      group_by(interval) |>
      summarize(avg_haz = mean(haz)) |>
      arrange(interval) |>
      slice(1:12) |>
      summarize(survival_12m = prod(1 - avg_haz)) |>
      pull(survival_12m)
  }

  s1 <- compute_surv_at_12(1)
  s0 <- compute_surv_at_12(0)

  tibble(
    term = c("treated_12m", "control_12m", "risk_diff_12m"),
    estimate = c(s1, s0, s1 - s0)
  )
}

# 부트스트랩 수행
boots_survival <- bootstraps(survival_sim, times = 200, apparent = TRUE) |>
  mutate(results = map(splits, compute_survival_effect))

# 신뢰 구간 계산
ci_result <- int_pctl(boots_survival, results)

cat("12개월 생존율과 처치 효과의 95% 신뢰 구간:\n")
12개월 생존율과 처치 효과의 95% 신뢰 구간:print(ci_result)# A tibble: 3 × 6
term .lower .estimate .upper .alpha .method
<chr> <dbl> <dbl> <dbl> <dbl> <chr>
1 control_12m 0.457 0.531 0.596 0.05 percent…
2 risk_diff_12m 0.0131 0.108 0.214 0.05 percent…
3 treated_12m 0.577 0.640 0.712 0.05 percent…전통적인 생존 분석에서는 콕스 비례 위험 모델(Cox proportional hazards model)이 많이 사용됩니다. 풀링된 로지스틱 회귀는 몇 가지 장점을 가집니다:
단, 연속 시간 데이터를 이산화해야 하며, 데이터 크기가 증가한다는 단점이 있습니다.