노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
마지막으로, 이 책의 나머지 부분 대부분의 주제인 인과적 질문에 답하는 방법으로 관심을 돌려보겠습니다. 잠재적 결과, 반사실, 그리고 DAG를 활용하여 인과 효과를 추정할 조건을 설정할 수 있었습니다. 이제 이를 추정할 도구가 필요합니다. 이 장은 인과 추론을 더 실행 가능하게 만드는 모델을 탐구하는 전환점입니다.
하지만 모델을 전혀 사용하지 않는 것부터 시작해 봅시다.
group_by()와 summarize()를 활용한 인과 추론우리가 소프트웨어를 만드는 회사의 데이터를 분석하고 있다고 가정해 봅시다. 우리는 소프트웨어 업데이트 빈도가 고객 만족도(모집단 평균 0, 표준 편차 1인 표준화된 점수로 측정)에 미치는 인과 효과를 추정하려고 합니다. 고객은 개별 사용자를 보유한 조직이며, 조직 전체가 주간 또는 일간 업데이트를 받습니다. 업데이트 빈도는 무작위로 배정되지 않았으며, 그림 fig-satisfaction-dag1에 나타난 것처럼 노출과 결과는 공동 원인인 교란 요인 — 고객 유형 — 을 가지고 있습니다. 무료 고객은 주간 업데이트를 받을 가능성이 더 높고, 프리미엄 고객은 일간 업데이트를 받을 가능성이 더 높습니다. 프리미엄 고객은 만족도가 더 높을 가능성이 큽니다. 노출과 결과 사이에 직접적인 관계가 없더라도, customer_type을 통한 updates와 satisfaction 사이의 열린 백도어 경로(backdoor path)로 인해 교란이 예상됩니다. 우리는 단일 이진 교란 요인(single binary confounder)에 의한 교란 상황에 놓여 있습니다.
library(ggdag)

coords1 <- list(
  x = c(customer_type = 1, updates = 2, satisfaction = 3),
  y = c(customer_type = 0, updates = 0, satisfaction = 0)
)

dag1 <- dagify(
  satisfaction ~ customer_type,
  updates ~ customer_type,
  coords = coords1,
  labels = c(
    customer_type = "고객 유형",
    updates = "업데이트\n빈도",
    satisfaction = "고객\n만족도"
  )
)

ggdag(dag1, use_text = FALSE, use_edges = FALSE) +
  geom_dag_text(aes(label = label), nudge_y = c(-.05, -.05, -.05), color = "black") +
  geom_dag_edges_arc(curvature = c(0.07, 0)) +
  theme_dag() +
  ylim(c(.2, -.2))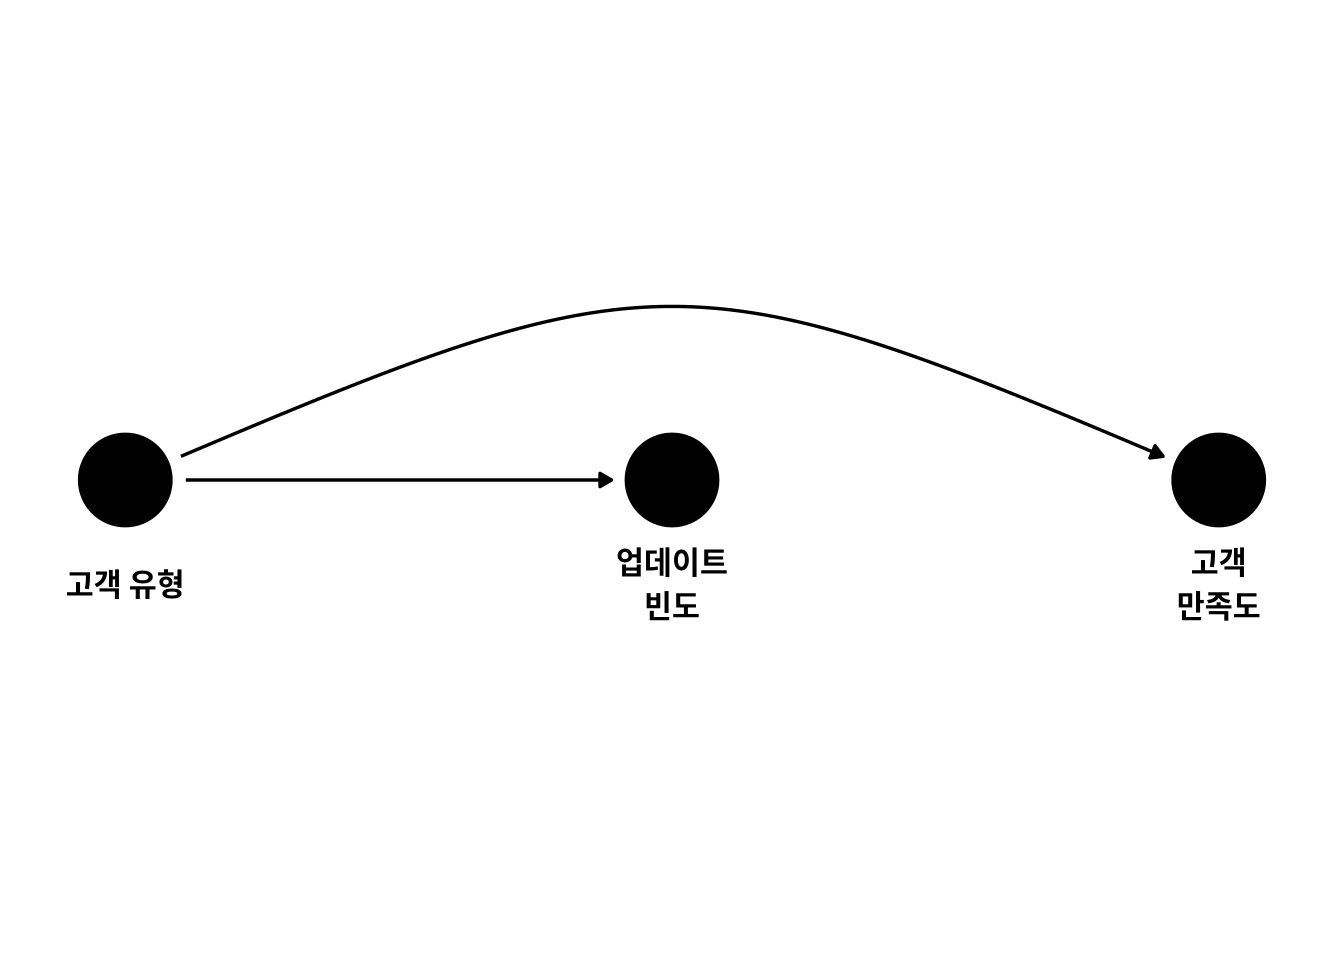
이 데이터 생성 프로세스와 일치하는 몇 가지 데이터를 시뮬레이션해 봅시다. 이 시뮬레이션에서는 satisfaction(weekly)와 satisfaction(daily)에 대한 잠재적 결과를 생성합니다. 이 책의 많은 시뮬레이션은 이 단계를 건너뛰고 관찰된 결과를 직접 시뮬레이션하지만, 인과적 질문에 답하는 단계로 넘어가면서 추론을 하기 위해 어떤 가정을 충족해야 하는지 기억하는 것이 도움이 됩니다.
library(tidyverse)
set.seed(1)
n <- 10000
satisfaction1 <- tibble(
  # 무료 (0) 또는 프리미엄 (1)
  customer_type = rbinom(n, 1, 0.5),
  p_exposure = case_when(
    # 프리미엄 고객은 일간 업데이트를 받을 가능성이 더 높음
    customer_type == 1 ~ 0.75,
    # 무료 고객은 주간 업데이트를 받을 가능성이 더 높음
    customer_type == 0 ~ 0.25
  ),
  # 주간 (0) vs 일간 (1)
  update_frequency = rbinom(n, 1, p_exposure),
  # 0인 진정한 평균 처치 효과 생성
  # 이를 위해 잠재적 결과 생성, 먼저 노출 = 0인 경우
  # `y0` = `satisfaction(weekly)`
  # 아래 방정식에 `update_frequency`가 포함되지 않았음에 주목하십시오
  # 평균 0, 표준 편차 1인 정규 분포를 따르는 무작위 오차항을
  # 추가하기 위해 rnorm(n)을 사용합니다
  y0 = customer_type + rnorm(n),
  # 진정한 효과가 0이므로, 노출 = 1인 경우의 잠재적 결과도 동일함
  y1 = y0,
  # 실무에서는 이들 중 하나만 관찰함
  satisfaction = (1 - update_frequency) * y0 +
    update_frequency * y1,
  observed_potential_outcome = case_when(
    update_frequency == 0 ~ "y0",
    update_frequency == 1 ~ "y1"
  )
) |>
  mutate(
    satisfaction = as.numeric(scale(satisfaction)),
    update_frequency = factor(
      update_frequency,
      labels = c("weekly", "daily")
    ),
    customer_type = factor(
      customer_type,
      labels = c("free", "premium")
    )
  )
satisfaction1 |>
select(update_frequency, customer_type, satisfaction)# A tibble: 10,000 × 3
update_frequency customer_type satisfaction
<fct> <fct> <dbl>
1 weekly free -1.16
2 weekly free -1.39
3 daily premium -0.473
4 daily premium -0.608
5 weekly free -0.891
6 daily premium -0.0145
7 weekly premium 0.185
8 weekly premium 0.881
9 weekly premium 0.234
10 weekly free 0.690
# ℹ 9,990 more rows이제 두 노출 그룹이 교환 가능하다고 가정하고, update_frequency가 satisfaction에 미치는 효과를 추정해 봅시다.
# A tibble: 2 × 2
  update_frequency avg_satisfaction
  <fct>                       <dbl>
1 weekly                     -0.237
2 daily                       0.238
물론 DAG와 잠재적 결과를 시뮬레이션한 방식을 통해, 우리는 두 그룹이 교환 가능하지 않다는 것을 알고 있습니다. 업데이트 빈도 그룹 간의 실제 차이는 0이지만, 평균 만족도에는 차이가 나타납니다. 하지만 장 3 에서 논의했듯이, 우리에게는 여전히 다른 선택지가 있습니다: 교란 요인의 수준 내에서의 교환 가능성입니다. 다시 말해, 유효한 조정 집합의 수준 내에서 교환 가능성이 필요합니다. 이 경우 그러한 집합은 오직 하나, customer_type뿐입니다.
# A tibble: 4 × 3
  customer_type update_frequency avg_satisfaction
  <fct>         <fct>                       <dbl>
1 free          weekly                     -0.458
2 free          daily                      -0.433
3 premium       weekly                      0.452
4 premium       daily                       0.463
고객 유형 수준 내에서 업데이트 빈도가 만족도에 미치는 효과를 추정하기 위해 데이터를 약간 가공해 봅시다. 이제 정답에 훨씬 더 가까워졌습니다: 고객 유형 수준 내에서는 업데이트 빈도에 따른 만족도 차이가 없습니다.
satisfaction_strat_est <- satisfaction_strat |>
  pivot_wider(
    names_from = update_frequency,
    values_from = avg_satisfaction
  ) |>
  reframe(estimate = daily - weekly)

satisfaction_strat_est
# A tibble: 2 × 1
estimate
<dbl>
1 0.0252
2 0.0110우리는 각 고객 유형에 대해 정답(0)에 매우 가까운 두 가지 추정치를 얻었습니다. 그렇다면 전체 모집단에 대한 단일 추정치를 얻으려면 어떻게 해야 할까요? 각 층(stratum)의 추정치를 전체 모집단에서 각 고객 유형이 차지하는 비중에 따라 가중 평균을 내면 됩니다. 무료 고객은 50%이고 프리미엄 고객은 50%이므로 다음과 같이 계산합니다:
# A tibble: 1 × 1
     ate
   <dbl>
1 0.0181
우리는 방금 전체 모집단에 대한 편향되지 않은 추정치를 계산했습니다. 우리가 한 일은 각 층(무료 및 프리미엄 고객) 내에서 효과를 추정한 다음, 이를 전체 모집단 분포에 맞게 다시 합친 것입니다. 이것이 바로 이 책의 나머지 부분에서 논의할 기술들의 핵심 원리입니다.
이제 전체 평균을 낼 수 있으며, 0에 가까운 효과를 얻게 됩니다.
# A tibble: 1 × 1
  estimate
     <dbl>
1   0.0181
이제 이 접근 방식을 두 개의 이진 교란 요인이 있는 경우로 생각해 봅시다. 두 번째 교란 요인이 있다고 가정해 봅시다: 업무 시간(business hours) 여부입니다. 주간 업데이트는 업무 시간 내에 발생할 확률이 더 높고, 일간 업데이트는 업무 시간 이후에 발생할 확률이 더 높습니다. 어떤 고객들은 회사의 업무 시간과 잘 겹치지만 어떤 고객들은 그렇지 않습니다; 겹치지 않는 고객들은 자신의 근무 시간 동안 고객 서비스(customer service)를 이용할 수 없기 때문에 만족도가 더 낮습니다.
dag2 <- dagify(
  satisfaction ~ customer_service + customer_type,
  customer_service ~ business_hours,
  updates ~ customer_type + business_hours,
  coords = time_ordered_coords(),
  labels = c(
    customer_type = "고객\n유형",
    business_hours = "업무\n시간",
    updates = "업데이트\n빈도",
    customer_service = "고객\n서비스",
    satisfaction = "고객\n만족도"
  )
)

ggdag(dag2, use_text = FALSE) +
  geom_dag_text(
    aes(label = label),
    nudge_y = c(-.35, -.35, .35, .35, .35),
    color = "black"
  ) +
  theme_dag()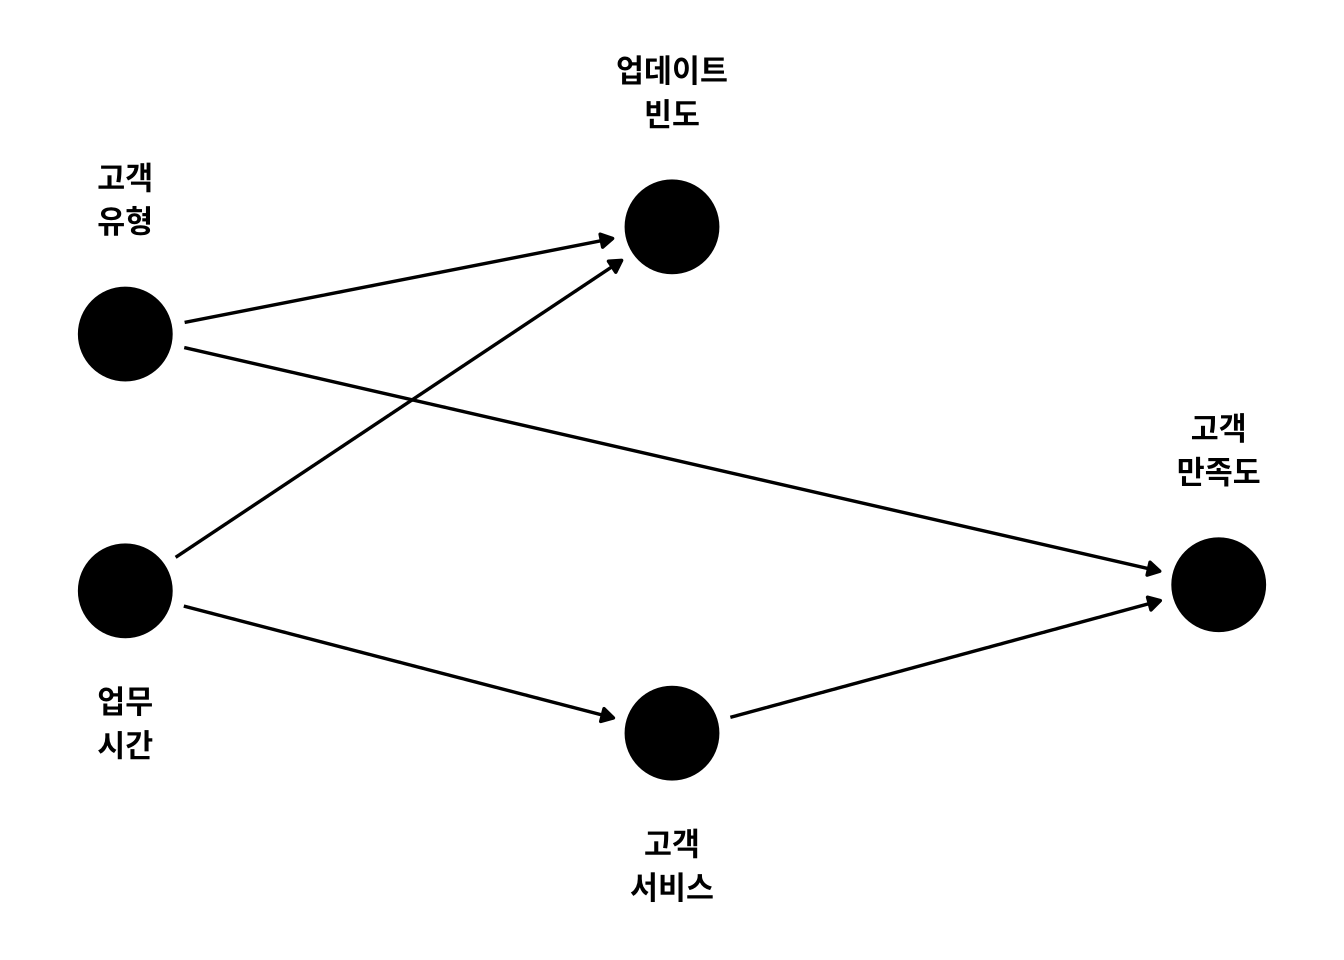
이 데이터를 시뮬레이션해 봅시다:
satisfaction2 <- tibble(
  # 무료(0) 또는 프리미엄(1)
  customer_type = rbinom(n, 1, 0.5),
  # 업무 시간 (예: 1, 아니오: 0)
  business_hours = rbinom(n, 1, 0.5),
  p_exposure = case_when(
    customer_type == 1 & business_hours == 1 ~ 0.75,
    customer_type == 0 & business_hours == 1 ~ 0.9,
    customer_type == 1 & business_hours == 0 ~ 0.2,
    customer_type == 0 & business_hours == 0 ~ 0.1
  ),
  # 주간(0) 대 일간(1)
  update_frequency = rbinom(n, 1, p_exposure),
  # 업무 시간 동안 이용 가능성이 더 높음
  customer_service_prob = business_hours * 0.9 +
    (1 - business_hours) * 0.2,
  customer_service = rbinom(n, 1, prob = customer_service_prob),
  satisfaction = 70 + 10 * customer_type +
    15 * customer_service + rnorm(n),
) |>
  mutate(
    satisfaction = as.numeric(scale(satisfaction)),
    customer_type = factor(
      customer_type,
      labels = c("free", "premium")
    ),
    business_hours = factor(
      business_hours,
      labels = c("no", "yes")
    ),
    update_frequency = factor(
      update_frequency,
      labels = c("weekly", "daily")
    ),
    customer_service = factor(
      customer_service,
      labels = c("no", "yes")
    )
  )
이제 우리는 두 개의 교란 요인 수준 내에서 교환 가능성이 필요합니다. 이 경우, 우리는 두 개의 최소 조정 집합을 갖습니다: customer_type + business_hours와 customer_type + customer_service입니다. 각각을 살펴보겠습니다.
customer_type과 business_hours의 조합 내에서, 업데이트 빈도 그룹들은 매우 유사합니다.
satisfaction2_strat <- satisfaction2 |>
  group_by(customer_type, business_hours, update_frequency) |>
  summarise(
    avg_satisfaction = mean(satisfaction),
    .groups = "drop"
  )

satisfaction2_strat |>
  select(avg_satisfaction, everything())
# A tibble: 8 × 4
avg_satisfaction customer_type business_hours
<dbl> <fct> <fct>
1 -1.14 free no
2 -1.16 free no
3 -0.0216 free yes
4 0.0180 free yes
5 -0.0493 premium no
6 -0.0673 premium no
7 1.13 premium yes
8 1.12 premium yes
# ℹ 1 more variable: update_frequency <fct>이전보다 약간 더 많은 데이터 조작을 거쳐, 전체 추정치를 계산할 수 있습니다.
satisfaction2_strat |>
  pivot_wider(
    names_from = update_frequency,
    values_from = avg_satisfaction
  ) |>
  summarise(estimate = mean(daily - weekly))
# A tibble: 1 × 1
estimate
<dbl>
1 -0.00415우리는 또한 customer_type과 customer_service 수준 내에서도 조건부 교환 가능성을 달성할 수 있습니다. 우리가 고려하기로 선택한 변수들 사이의 우연한 차이 때문에 결과는 약간 다르지만, 두 접근 방식 모두 거의 무효(null)에 가까운 값을 얻습니다.
# A tibble: 1 × 1
  estimate
     <dbl>
1 -0.00196
데이터가 충분하다면, 이 접근 방식은 범주형 교란 요인을 포함하여 많은 교란 요인이 있는 경우로 잘 확장됩니다. 그렇다면 연속형 교란 요인은 어떨까요?
이진 교란 요인 대신, 그림 6.3 와 같이 조직 내 사용자 수라는 하나의 연속형 교란 요인이 있다고 가정해 봅시다.
coords3 <- list(
  x = c(num_users = 1, updates = 2, satisfaction = 3),
  y = c(num_users = 0, updates = 0, satisfaction = 0)
)

dag3 <- dagify(
  satisfaction ~ num_users,
  updates ~ num_users,
  coords = coords3,
  labels = c(
    num_users = "사용자 수",
    updates = "업데이트\n빈도",
    satisfaction = "고객\n만족도"
  )
)

ggdag(dag3, use_text = FALSE, use_edges = FALSE) +
  geom_dag_text(aes(label = label), nudge_y = c(-.05, -.05, -.05), color = "black") +
  geom_dag_edges_arc(curvature = c(0.07, 0)) +
  theme_dag() +
  ylim(c(.2, -.2))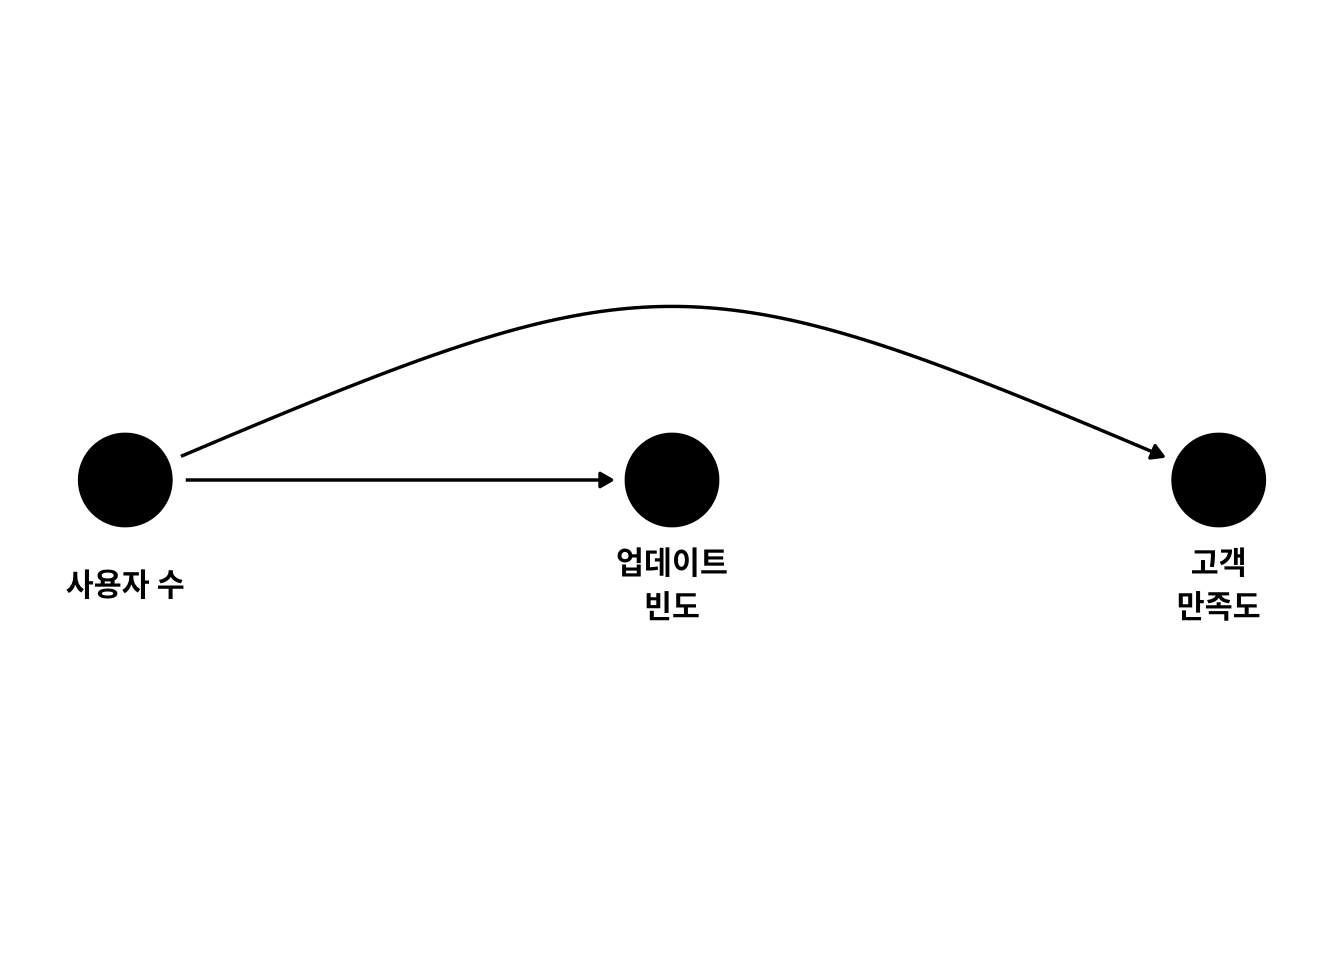
사용자가 많은 조직은 업데이트를 더 많이 받고 만족도 점수는 약간 낮습니다.
satisfaction3 <- tibble(
  # 사용자 수
  num_users = runif(n, min = 1, max = 500),
  # 큰 고객일수록 일간 업데이트를 받을 확률이 높음
  update_frequency = rbinom(n, 1, plogis(num_users / 100)),
  # 사용자가 많을수록 만족도는 낮아짐
  satisfaction = 70 + -0.2 * num_users + rnorm(n)
) |>
  mutate(
    satisfaction = as.numeric(scale(satisfaction)),
    update_frequency = factor(
      update_frequency,
      labels = c("weekly", "daily")
    )
  )
여전히 group_by()와 summarize()를 사용하고 싶다면, 연속형 교란 요인을 구간(bin)으로 나눌 수 있습니다. 예를 들어 5분위수(quintiles)를 사용하여 각 구간 내에서 인과 효과를 추정하는 것입니다:
# A tibble: 10 × 3
   num_users_q update_frequency avg_satisfaction
         <int> <fct>                       <dbl>
 1           1 weekly                    1.41
 2           1 daily                     1.37
 3           2 weekly                    0.725
 4           2 daily                     0.682
 5           3 weekly                    0.0459
 6           3 daily                    -0.00825
 7           4 weekly                   -0.631
 8           4 daily                    -0.689
 9           5 weekly                   -1.36
10           5 daily                    -1.39
나누어진 사용자 수준 내에서 정답에 근접한 값을 얻습니다. 전체 평균을 구해 봅시다:
satisfaction3_strat |>
  ungroup() |>
  pivot_wider(
    names_from = update_frequency,
    values_from = avg_satisfaction
  ) |>
  summarise(estimate = mean(daily - weekly))
# A tibble: 1 × 1
estimate
<dbl>
1 -0.0455이진 또는 범주형 교란 요인과 달리, 연속형 교란 요인을 구간으로 나누어 그룹화하는 것은 해당 변수를 완전히 통제하지 못합니다. 구간이 거칠수록 잔차 교란(residual confounding)이 더 많이 남게 되며, 구간이 세밀할수록 연속형 버전에 더 가까워집니다(하지만 구간당 값의 수는 적어집니다. Tip 6.1 를 참조하십시오).
구간의 수를 늘리면 어떻게 되는지 살펴봅시다. 아래 그림에서 우리는 구간의 수를 텍스트 예시의 5개에서 3개에서 20개 사이로 변경해 보았습니다. 구간의 수가 늘어날수록 편향이 감소하는 것을 확인할 수 있습니다.
update_bins <- function(bins) {
  satisfaction3 |>
    mutate(num_users_q = ntile(num_users, bins)) |>
    group_by(num_users_q, update_frequency) |>
    summarise(
      avg_satisfaction = mean(satisfaction),
      .groups = "drop"
    ) |>
    ungroup() |>
    pivot_wider(
      names_from = update_frequency,
      values_from = avg_satisfaction
    ) |>
    summarise(
      bins = bins,
      estimate = mean(daily - weekly)
    )
}

map(3:20, update_bins) |>
  bind_rows() |>
  ggplot(aes(x = bins, y = abs(estimate))) +
  geom_point() +
  geom_line() +
  labs(y = "Bias", x = "Number of bins")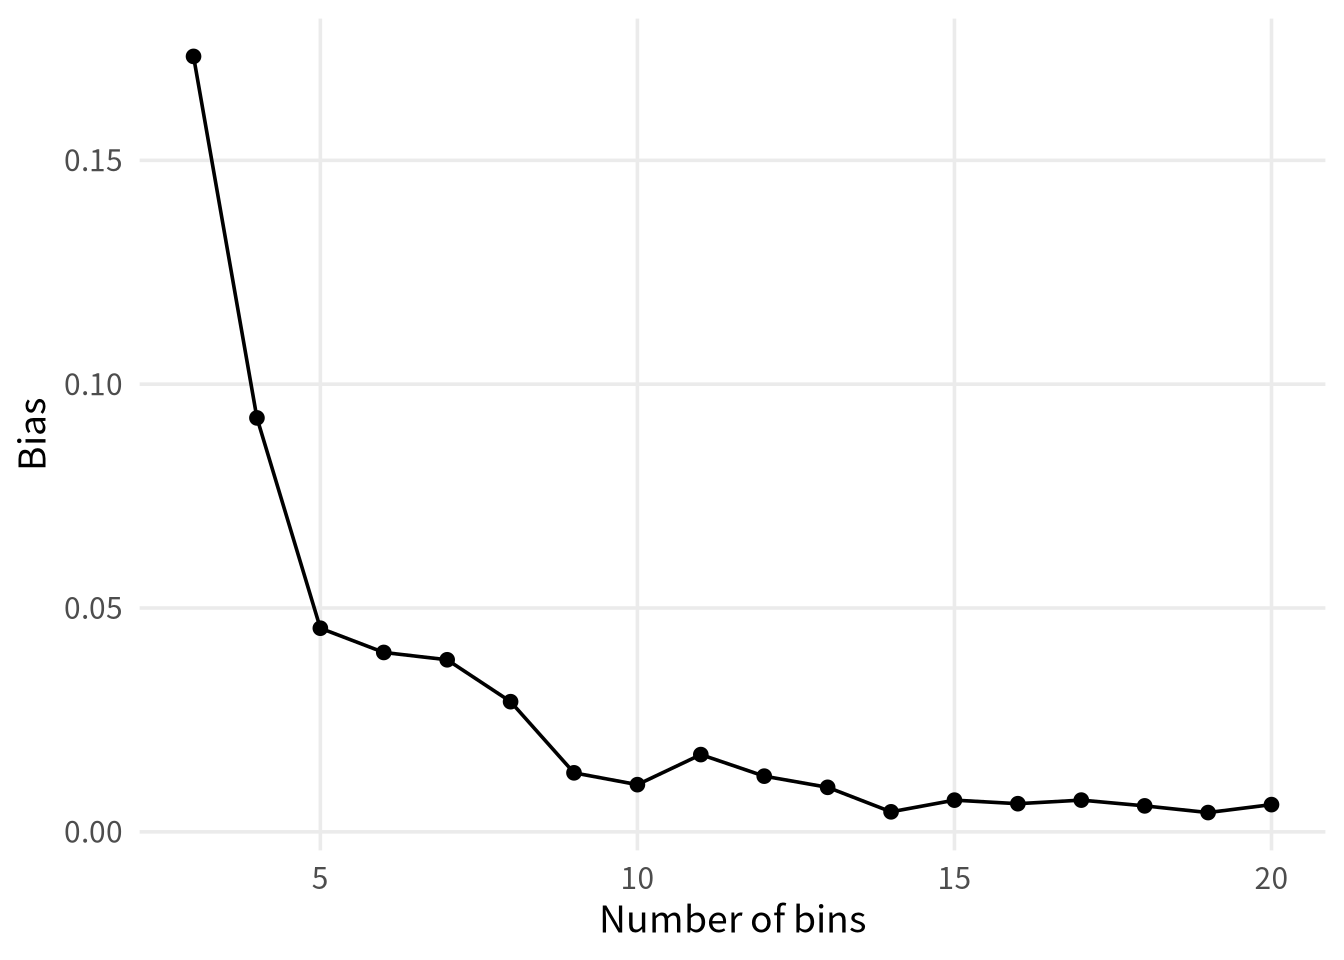
예를 들어, 아래의 출력을 보면 구간이 5개일 때보다 20개일 때 추정치가 실제값(0)에 훨씬 더 가깝다는 것을 알 수 있습니다.
satisfaction3 |>
  mutate(num_users_q = ntile(num_users, 20)) |>
  group_by(num_users_q, update_frequency) |>
  summarise(
    avg_satisfaction = mean(satisfaction),
    .groups = "drop"
  ) |>
  ungroup() |>
  pivot_wider(
    names_from = update_frequency,
    values_from = avg_satisfaction
  ) |>
  summarise(estimate = mean(daily - weekly))
# A tibble: 1 × 1
estimate
<dbl>
1 -0.00609하지만 모든 좋은 일에는 한계가 있듯이, 구간의 수를 늘리는 데에도 한계가 있습니다. 예를 들어 구간을 30개로 늘리면 어떤 일이 일어나는지 봅시다.
satisfaction3 |>
  mutate(num_users_q = ntile(num_users, 30)) |>
  group_by(num_users_q, update_frequency) |>
  summarise(
    avg_satisfaction = mean(satisfaction),
    .groups = "drop"
  ) |>
  ungroup() |>
  pivot_wider(
    names_from = update_frequency,
    values_from = avg_satisfaction
  ) |>
  summarise(estimate = mean(daily - weekly))
# A tibble: 1 × 1
estimate
<dbl>
1 NA추정치가 NA인 이유는 일부 구간에서 노출 그룹 중 하나에 속한 사람이 아무도 없어서 그 차이를 추정할 수 없기 때문입니다. 이제 이 분석은 우리의 긍정성(positivity) 가정을 위배합니다. 이는 확률적(stochastic) 위배입니다; 이는 우리의 표본 크기 10,000 및 구간의 수 30개와 관련이 있습니다. 우연히 30개 구간 중 적어도 하나에서 노출 그룹 중 하나에 아무도 속하지 않게 되었고, 이로 인해 인과 효과를 추정할 수 없게 된 것입니다. 이 비모수적 방법은 유연하지만 표본 크기에 따른 한계가 있습니다. 모수적 모델(parametric models)은 특정 가정 하에 외삽(extrapolate)을 가능하게 해주므로 더 효율적이라는 장점이 있습니다(우리의 가정이 옳다는 전제 하에 말이죠. 섹션 6.2 에서 더 자세히 배워봅시다).
group_by()와 summarize()를 사용하여 수행해 온 이 접근 방식은 흔히 층화(stratification)라고 불립니다. 여러분은 이를 일종의 비모수적 접근 방식으로 생각할 수도 있습니다. 우리는 선형 회귀와 같이 변수의 형태를 제한하기 위해 통계 모델의 어떠한 매개변수화(parameterization)도 사용하지 않기 때문입니다. (이것은 연속형 교란 요인에 대해서는 부분적으로만 사실입니다. 연속형 변수의 모든 값에 대해 층화하는 것은 실질적으로 불가능하기 때문입니다).
층화는 간단한 문제나 데이터가 아주 많을 때 모델 오명시(model misspecification) 문제를 피할 수 있기 때문에 강력한 도구가 될 수 있습니다. 그러나 교란 요인이 많아지면(특히 연속형 변수일 때), 우리는 금세 ’차원의 저주(curse of dimensionality)’에 직면하게 되며, 교란 요인 수준의 조합별로 관측치가 너무 적어 실질적으로 사용하기 불가능해집니다.
층화를 조건부 평균(conditional means)을 계산하는 것으로 생각할 수 있습니다. 조건부 평균의 더 일반적인 확장은 다변량 선형 회귀입니다. 우리가 outcome ~ exposure + confounder1 + confounder2 + ... 형태의 변수들로 lm()을 적합시킬 때, 우리는 이를 결과 모델(outcome model)이라고 부릅니다. 노출과 교란 요인들을 포함하여 결과를 종속 변수로 하여 모델을 적합시키기 때문입니다. 이는 또한 회귀 모델에서 교란 요인들을 직접 조정하기 때문에 직접 조정(direct adjustment) 또는 회귀 조정(regression adjustment)이라고 불리기도 합니다. 두 개의 이진 교란 요인이 있는 예시에서 lm()을 사용하여 효과를 계산해 봅시다:
# A tibble: 1 × 3
  estimate conf.low conf.high
     <dbl>    <dbl>     <dbl>
1 -0.00906  -0.0411    0.0230
연속형 교란 요인에 대해서도 잘 작동하며, 더 이상 정답을 얻기 위해 이를 구간으로 나눌 필요가 없습니다:
lm(
  satisfaction ~ update_frequency + num_users,
  data = satisfaction3
) |>
  tidy(conf.int = TRUE) |>
  filter(term == "update_frequencydaily") |>
  select(estimate, starts_with("conf"))
# A tibble: 1 × 3
estimate conf.low conf.high
<dbl> <dbl> <dbl>
1 0.00153 -0.000595 0.00366하지만 이러한 일반화가 공짜로 얻어지는 것은 아닙니다: 우리는 이제 데이터가 희박한 영역 전반에 걸쳐 추정을 하기 위해 모수적 통계 모델을 도입했습니다. satisfaction ~ update_frequency + num_users 모델에서 얻은 추정치가 정확히 정답인 이유는 lm()의 기저에 깔린 통계 모델이 우리의 시뮬레이션과 완벽하게 일치하기 때문입니다. 예를 들어, satisfaction과 num_users 사이의 관계가 선형이므로, 이 모델을 적합시킬 때 우리는 차원의 문제로 고통받지 않습니다(비록 선형 회귀 또한 행과 열의 수에 따른 자체적인 한계가 있긴 하지만요). 즉, 우리는 이제 모델에 있는 변수들 사이의 관계에 대한 수학적 표현인 올바른 함수 형태(functional form)에 의존하게 된 것입니다 (Tip 6.2 에서 더 자세한 내용을 확인하십시오). 우리는 노출과 교란 요인 모두에 대해 올바른 함수 형태가 필요합니다. 이를 잘 모델링하려면 이러한 변수들과 결과 사이의 관계의 성격에 대한 이해가 필요합니다.
본문에서는 결과와 교란 요인 사이의 관계를 선형으로 시뮬레이션했습니다. 즉, lm()의 기저 가정을 정확히 충족했기 때문에 모수적 모델을 적합시켰을 때 정답을 얻을 수 있었습니다. 만약 우리의 시뮬레이션이 lm()의 기저 가정과 일치하지 않는다면 어떤 일이 일어날까요? 한번 살펴봅시다.
set.seed(11)
satisfaction4 <- tibble(
  # 사용자 수
  num_users = runif(n, 1, 500),
  # 큰 고객일수록 일간 업데이트를 받을 확률이 높음
  update_frequency = rbinom(n, 1, plogis(num_users / 100)),
  # 만족도와 사용자 수 사이의 비선형 관계
  satisfaction = 70 - 0.001 * (num_users-300)^2 - 0.001 * (num_users - 300)^3
) |>
  mutate(
    satisfaction = as.numeric(scale(satisfaction)),
    update_frequency = factor(
      update_frequency,
      labels = c("weekly", "daily")
    )
  )
ggplot(satisfaction4, aes(x = num_users, y = satisfaction)) +
  geom_line()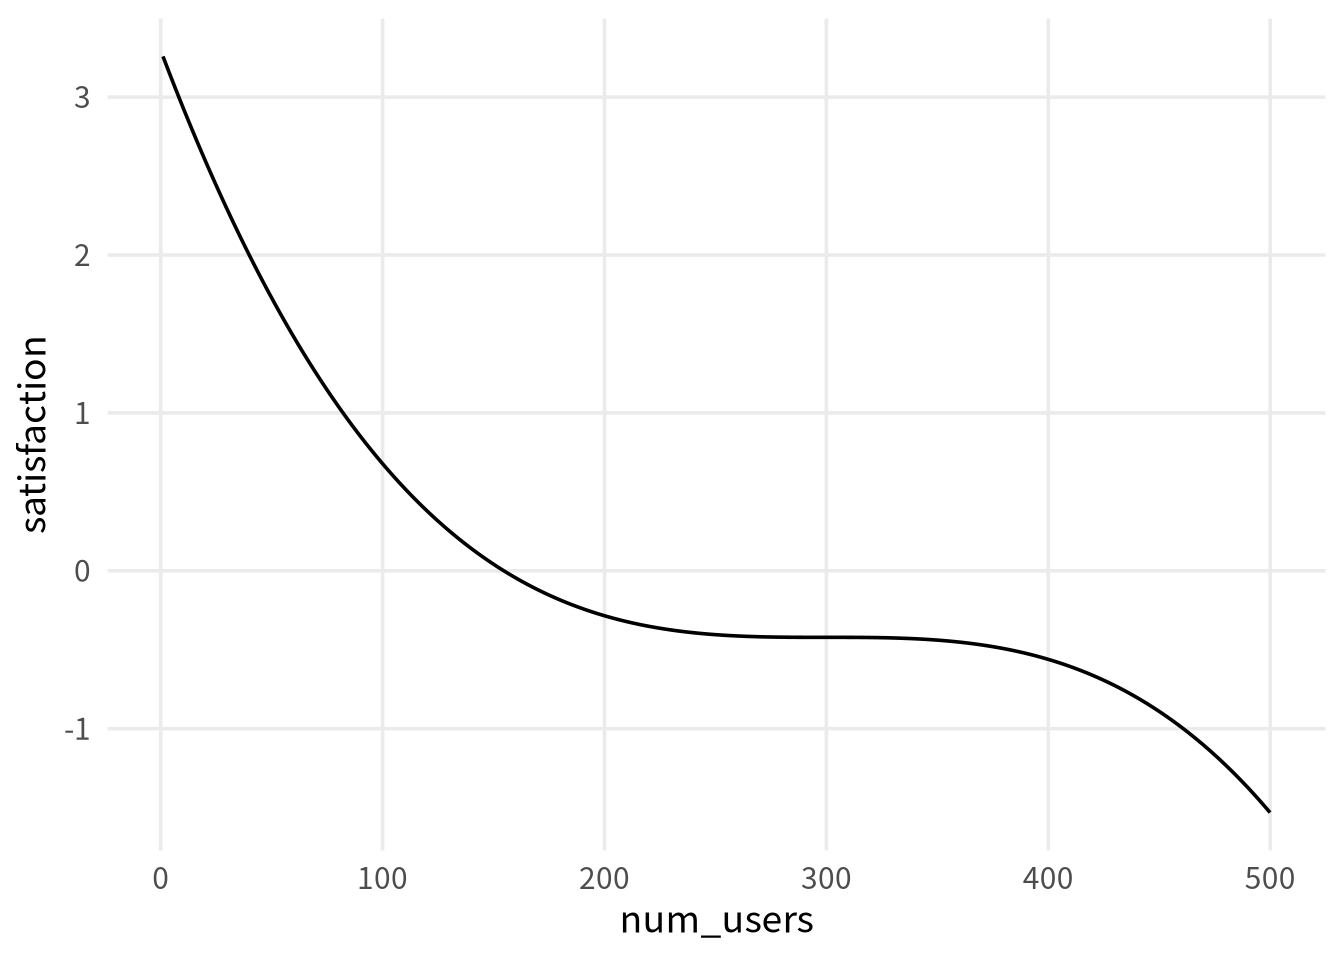
위 그림에서 우리는 이제 교란 요인인 사용자 수와 결과인 만족도 사이에 비선형 관계가 있음을 알 수 있습니다. 이 데이터에 대해 (잘못된) 모수적 모델을 적합시키면 어떤 일이 일어나는지 봅시다.
lm(
  satisfaction ~ update_frequency + num_users,
  data = satisfaction4
) |>
  tidy(conf.int = TRUE) |>
  filter(term == "update_frequencydaily") |>
  select(estimate, starts_with("conf"))
# A tibble: 1 × 3
estimate conf.low conf.high
<dbl> <dbl> <dbl>
1 -0.189 -0.219 -0.159우리의 추정치는 참값(0이어야 함)에서 멀리 떨어져 있습니다; 참값이 신뢰 구간에 포함되어 있지도 않습니다. 무엇이 잘못되었을까요? 우리의 모수적 모델은 사용자 수와 만족도 사이의 관계의 함수 형태가 선형이라고 가정했지만, 우리는 이를 비선형으로 생성했기 때문입니다. 여전히 모수적 모델을 사용할 수 있게 해주는 해결책이 있습니다; 우리가 만약 실제 함수 형태를 알고 있다면, 그것을 사용할 수 있습니다. 어떻게 하는지 살펴봅시다.
Warning in summary.lm(x): essentially perfect fit:
summary may be unreliable
Warning in summary.lm(object, ...): essentially
perfect fit: summary may be unreliable# A tibble: 1 × 3
estimate conf.low conf.high
<dbl> <dbl> <dbl>
1 1.05e-16 7.70e-17 1.33e-16아름답군요! 이제 이 모델은 데이터가 생성된 방식과 정확히 일치하게 적합되었고, 다시 한번 정확한 정답을 얻었습니다. 현실 세계에서는 데이터 생성 메커니즘을 알 수 없는 경우가 많지만, 여전히 유연한 모수적 모델을 적합시킬 수 있습니다. 이를 위한 좋은 방법 중 하나는 자연 큐빅 스플라인(natural cubic splines)을 사용하는 것입니다.
# A tibble: 1 × 3
  estimate conf.low conf.high
     <dbl>    <dbl>     <dbl>
1  0.00216 -0.00258   0.00690
우리의 원래 비모수적 방법도 사용할 수 있습니다. 이를 20개의 구간으로 층화하면 역시 편향이 적은 추정치(즉, 진정한 값인 0에 매우 가까운 값)를 얻을 수 있습니다.
satisfaction4_strat <- satisfaction4 |>
  mutate(num_users_q = ntile(num_users, 20)) |>
  group_by(num_users_q, update_frequency) |>
  summarise(
    avg_satisfaction = mean(satisfaction),
    .groups = "drop"
  )

satisfaction4_strat |>
  ungroup() |>
  pivot_wider(
    names_from = update_frequency,
    values_from = avg_satisfaction
  ) |>
  summarise(estimate = mean(daily - weekly))
# A tibble: 1 × 1
estimate
<dbl>
1 -0.00817나중에 우리는 이 가정을 줄이기 위해 머신러닝과 같은 데이터 적응형 방법(data-adaptive methods)을 사용하는 방법도 탐구할 것입니다 (장 21).
결과 회귀(Outcome regression)는 우리가 모델에 사용하는 추정량(estimator)의 가정을 충족할 때 매우 잘 작동할 수 있습니다. 예를 들어, 결과와 회귀 변수 사이의 관계를 이해하고 모델의 가정, 특히 선형성을 믿는다면 OLS는 매우 유익할 수 있습니다. 통계적으로 매우 효율적입니다(즉, 표준 오차가 작습니다). 또한 부트스트랩(부록 A) 없이도 명목상으로 정확한 신뢰 구간을 얻을 수 있습니다. 데이터를 분석하는 과학자나 다른 사람들도 대개 선형 회귀에 익숙하므로, 인과 효과를 계산하기 위해 여러분이 한 일을 이해하기가 더 쉽습니다. 사실 결과와 노출 사이에 선형 관계가 있고 섹션 3.3 에서 제시한 인과적 가정을 충족한다면, 상관관계가 곧 인과관계라고 말할 수 있습니다.
그렇다면 왜 인과 효과를 계산할 때 항상 결과 모델을 사용하지 않을까요? 첫째, (예를 들어 역확률 모델에서처럼) 결과 대신 노출을 모델링하는 데 더 자신이 있을 수 있습니다. 우리는 장 13 와 장 20 에서 이 아이디어를 더 탐구할 것입니다. 이와 관련하여 이진 결과(binary outcome)가 있을 때, 사건의 수에 따라 하나를 선택하는 것이 합리적일 수 있습니다. 예를 들어 결과는 희귀하지만 노출은 그렇지 않은 경우, 성향 점수 방법을 사용하는 것이 통계적으로 더 효율적일 수 있습니다. 둘째, 결과 모델을 사용하여 우리가 목표로 하는 추정치(정밀한 질문에 대한 답)를 얻는 것이 때때로 어려울 수 있습니다. 이에 대해서는 장 10 에서 더 깊이 살펴볼 것입니다.
이와 관련하여 결과 모델은 우리에게 조건부 효과(conditional effects)를 제공합니다. 즉, 추정된 계수를 설명할 때 우리는 종종 “노출이 한 단위 변화하면 모델의 다른 모든 변수를 일정하게 유지할 때 결과가 계수만큼 변화한다”와 같이 말합니다. 인과 추론에서 우리는 종종 한계 효과(marginal effects)에 관심이 있습니다. 수학적으로 이는 우리가 인과 효과를 추정하고자 하는 특정 모집단의 요인 분포에 대해 관심 효과를 평균화하고 싶다는 것을 의미합니다. 결과가 연속형이고 효과가 선형이며 노출 효과와 모집단에 관한 다른 요인 사이에 상호작용이 없는 경우, 조건부 효과와 한계 효과의 구분은 주로 용어상의 차이일 뿐입니다. 추정치는 동일할 것입니다.
만약 모델에 상호작용이 있다면, 즉 노출이 결과에 미치는 영향이 다른 요인에 따라 달라진다면, 더 이상 해석할 수 있는 단일 계수가 존재하지 않게 됩니다. 우리는 관심 있는 모집단에서 해당 요인의 분포를 고려하여 한계 효과를 추정하고 싶을 수 있습니다. 왜일까요? 우리는 궁극적으로 대상 모집단에 노출을 권장해야 할지 여부를 결정하려고 하므로, 평균적으로 그것이 유익할지 알고 싶기 때문입니다.
업데이트 빈도가 인과 효과를 가지지만, 그 효과가 고객 유형에 따라 달라지는 그림 6.1 의 변형을 고려해 봅시다. 프리미엄 고객의 경우 일간 업데이트가 만족도를 5점 증가시킵니다. 무료 고객의 경우 일간 업데이트가 만족도를 5점 감소시킵니다. 업데이트 빈도를 변경하는 효과는 고객 유형에 따라 이질적(heterogeneous)입니다. 모든 사람에게 업데이트 빈도를 일간으로 늘리는 것이 유익한지 여부는 프리미엄 고객 대 무료 고객 분포에 달려 있습니다.
고객의 50%가 프리미엄이고 50%가 무료라면, 업데이트를 일간으로 전환했을 때의 평균 효과는 다음과 같습니다:
\((0.5 * 5) + (0.5 * -5) = 0\)
고객의 100%가 프리미엄이라면 평균 효과는 다음과 같습니다:
\((1 * 5) + (0 * -5) = 5\)
고객의 100%가 무료라면 평균 효과는 다음과 같습니다:
\((0 * 5) + (1 * -5) = -5\)
한계화(Marginalization)는 데이터에 있는 공변량 분포의 평균 효과를 알려줍니다. 물론 우리는 고객 유형별로 인과 효과를 추정하고 싶을 수도 있습니다. 상호작용 효과는 sec-interaction장에서 자세히 다룰 것입니다.
조건부 효과는 로지스틱 및 콕스(Cox) 회귀 모델에서 훨씬 더 복잡합니다. 섹션 11.4.2 에서 보겠지만, 이러한 모델의 조건부 계수는 모델의 변수에 따라 완전히 다른 질문에 대한 답을 추정하게 됩니다.
결과 모델을 사용할 수 없는 경우도 있습니다. 첫째는 비교란(unconfoundedness) 방법의 가정을 충족할 수 없다고 생각될 때입니다. 이 경우 역확률 가중치 부여나 유사한 방법들도 사용할 수 없습니다. 그러나 도구 변수 분석, 회귀 불연속, 또는 이중 차분법과 같은 다른 방법을 사용할 수 있을지도 모릅니다 (장 22 및 장 23; 아래에서 이 방법들을 요약하겠습니다). 둘째는 시간 가변적(time-varying) 노출과 교란이 있는 경우입니다. 선형 회귀는 편향 없이 이러한 유형의 효과를 추정할 수 없으므로, 이를 올바르게 계산하려면 역확률 가중치 부여나 g-추정(g-computation)과 같은 방법이 필요합니다. 책의 대부분에서 우리는 간단한 전후 데이터를 분석할 것입니다: 기준점 데이터가 있고, 단일 시점에 노출이 발생하며, 노출 후에 결과가 발생합니다. 장 18 및 다른 장들에서 우리는 더 복잡한 질문과 데이터를 다룰 것입니다.
우리가 보았듯이 층화나 다변량 선형 회귀와 같은 간단한 방법으로도 인과 추론을 하는 것이 가능합니다. 하지만 책의 나머지 부분에서는 우리가 던지고 싶은 질문에 더 유연하게 답할 수 있게 해주는 다른 인과 방법론들에 집중할 것입니다. 여기서 다룰 비교란 방법론들에 대한 간략한 요약입니다.
이 책은 주로 비교란 방법론에 초점을 맞추고 있지만, 나중에 다른 가정을 하는 방법들도 다룹니다 (장 22 및 장 23). 교환 가능성을 달성하려고 시도하는 대신 이러한 방법들을 탐구하고 싶을 때에 대한 간략한 요약입니다:
무작위 시험은 인과 추론을 위해 우리가 해야 하는 많은 가정들을 완화해 줍니다. 무작위 배정이 성공했다면 교란 요인이 존재하지 않기 때문에 이를 통제할 필요가 없습니다. 그러나 무작위 노출에 대해서도 인과 방법론은 여전히 유용할 수 있습니다.
업데이트 빈도가 각 고객에게 무작위로 배정되지만, 고객 유형과 업무 시간은 여전히 고객 만족도의 원인인 그림 6.2 의 변형을 고려해 봅시다. 다시 말해, 이들은 결과의 원인이지만 노출의 원인은 아닙니다. 우리는 유효한 효과를 얻기 위해 조정되지 않은 회귀 모델이나 간단한 평균 차이를 사용할 수 있습니다. 하지만 장 4 에서 논의했듯이, 노출의 원인은 아니지만 결과의 원인인 변수들을 포함하는 것은 추정치의 통계적 정밀도를 향상시킬 수 있습니다. 세 가지 접근 방식을 살펴봅시다: 조정되지 않은 OLS 결과 모델, 조정된 OLS 결과 모델(직접 조정), 그리고 역확률 가중 모델입니다. 그림 6.4 에서 세 가지 방법 모두 우리에게 편향되지 않은 효과를 제공합니다. 성향 점수의 효과는 한계적(marginal)인 반면, 결과 모델의 효과는 조건부(conditional)입니다. 우리가 데이터를 시뮬레이션한 방식 때문에 두 가지 유형의 효과는 동일합니다. 그러나 조정되지 않은 방법은 신뢰 구간이 더 넓고, 이와 관련하여 표준 오차도 더 큽니다. 직접 조정 방법과 역확률 가중치 부여는 표준 오차가 더 작고, 따라서 신뢰 구간이 더 좁습니다. 무작위 시험에서 기준점 요인들을 조정하기 위해 이와 같이 성향 점수를 사용하는 것이 조정되지 않은 추정치에 비해 정밀도를 항상 향상시키며, 직접 조정에서 얻는 정밀도 이득과 동등하다는 것이 수학적으로 증명되었습니다 (Williamson, Forbes, 와/과 White 2014).
satisfaction_randomized <- tibble(
  # 무료(0) 또는 프리미엄(1)
  customer_type = rbinom(n, 1, 0.5),
  # 업무 시간 (예: 1, 아니오: 0)
  business_hours = rbinom(n, 1, 0.5),
  # 주간(0) vs 일간(1), 이제 무작위임
  update_frequency = rbinom(n, 1, 0.5),
  # 업무 시간 동안 이용 가능성이 더 높음
  customer_service_prob = business_hours *
    0.9 + (1 - business_hours) * 0.2,
  customer_service = rbinom(n, 1, prob = customer_service_prob),
  satisfaction = 70 + 10 * customer_type +
    15 * customer_service + rnorm(n),
) |>
  mutate(
    satisfaction = as.numeric(scale(satisfaction)),
    customer_type = factor(
      customer_type,
      labels = c("free", "premium")
    ),
    business_hours = factor(
      business_hours,
      labels = c("no", "yes")
    ),
    update_frequency = factor(
      update_frequency,
      labels = c("weekly", "daily")
    ),
    customer_service = factor(
      customer_service,
      labels = c("no", "yes")
    )
  )

plot_estimates <- function(d) {
  unadj_model <- lm(satisfaction ~ update_frequency, data = d) |>
    tidy(conf.int = TRUE) |>
    mutate(term = if_else(
      term == "update_frequencydaily",
      "update_frequency",
      term
    )) |>
    filter(term == "update_frequency") |>
    mutate(model = "조정하지 않음")

  adj_model <- lm(
    satisfaction ~ update_frequency + business_hours +
      customer_type,
    data = d
  ) |>
    tidy(conf.int = TRUE) |>
    mutate(term = if_else(
      term == "update_frequencydaily",
      "update_frequency",
      term
    )) |>
    filter(term == "update_frequency") |>
    mutate(model = "직접 조정")

  df <- d |>
    mutate(across(where(is.factor), as.integer)) |>
    mutate(update_frequency = update_frequency - 1) |>
    as.data.frame()

  x <- PSW::psw(
    df,
    "update_frequency ~ business_hours + customer_type",
    weight = "ATE",
    wt = TRUE,
    out.var = "satisfaction"
  )
  psw_model <- tibble(
    term = "update_frequency",
    estimate = x$est.wt,
    std.error = x$std.wt,
    conf.low = x$est.wt - 1.96 * x$std.wt,
    conf.high = x$est.wt + 1.96 * x$std.wt,
    statistic = NA,
    p.value = NA,
    model = "역확률 가중치 부여"
  )

  models <- bind_rows(unadj_model, adj_model, psw_model) |>
    mutate(model = factor(
      model,
      levels = c(
        "조정하지 않음",
        "직접 조정",
        "역확률 가중치 부여"
      )
    ))

  models |>
    select(model, estimate, std.error, starts_with("conf")) |>
    pivot_longer(
      c(estimate, std.error),
      names_to = "statistic"
    ) |>
    mutate(
      conf.low = if_else(statistic == "std.error", NA, conf.low),
      conf.high = if_else(statistic == "std.error", NA, conf.high),
      statistic = case_match(
        statistic,
        "estimate" ~ "추정치 (95% CI)",
        "std.error" ~ "표준 오차"
      )
    ) |>
    ggplot(aes(value, fct_rev(model))) +
    geom_point() +
    geom_errorbarh(
      aes(xmin = conf.low, xmax = conf.high),
      height = 0
    ) +
    facet_wrap(~statistic, scales = "free_x") +
    theme(axis.title.y = element_blank())
}

plot_estimates(satisfaction_randomized)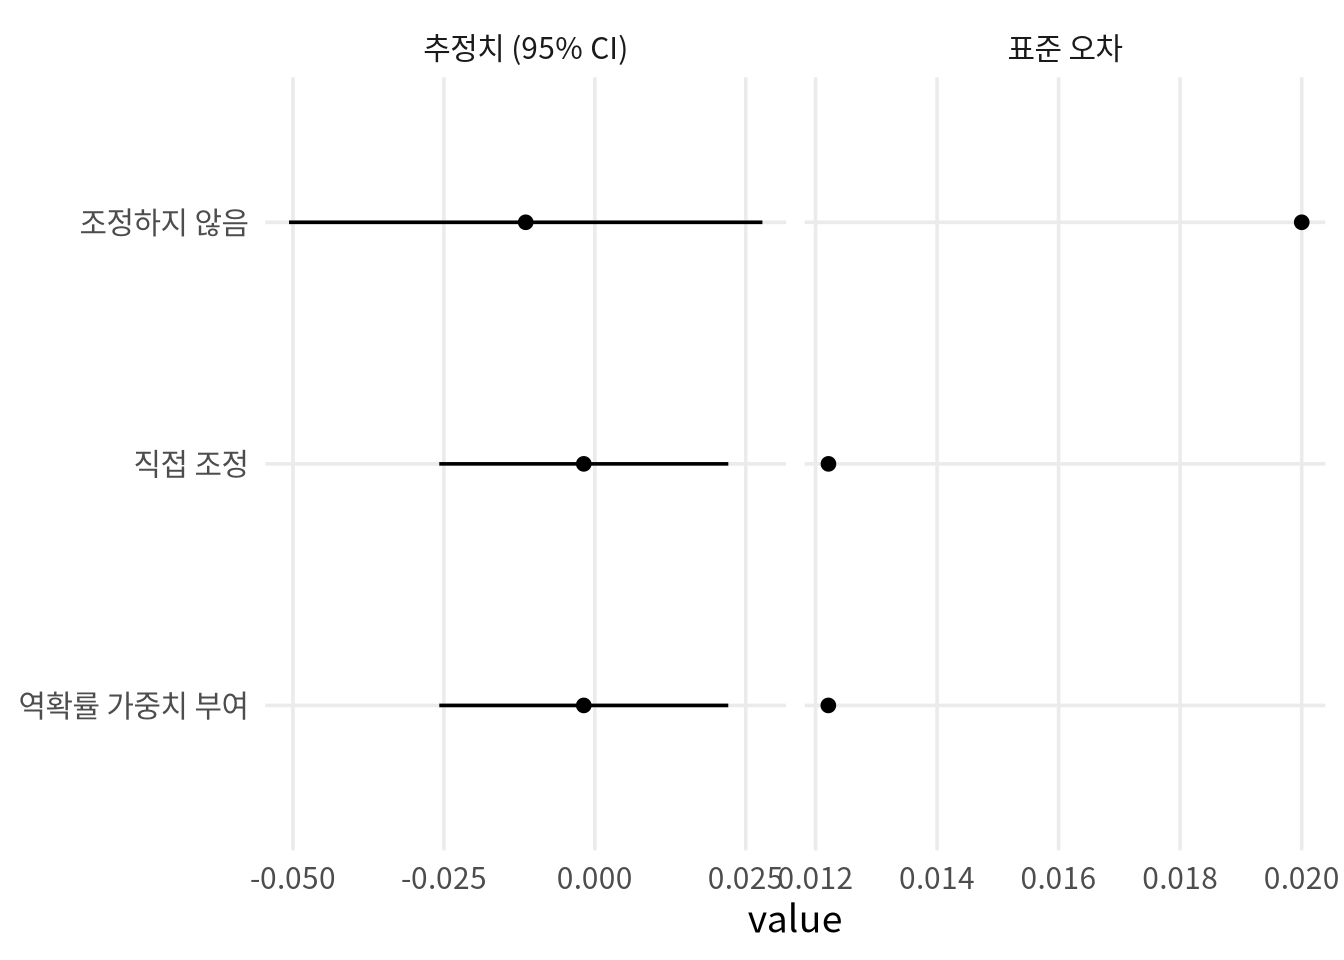
그러나 이 두 가지 조정 접근 방식은 교란 요인을 조정하는 것이 아닙니다. 대신 데이터의 무작위 변동(random variation)을 통제합니다. 직접 조정의 경우, 우리는 결과의 변동을 고려함으로써 이를 수행합니다. 역확률 가중치의 경우, 결과와 관련된 변수들 전반에 걸쳐 처치 그룹들 사이의 우연한 불균형을 고려합니다.
인과적 방법론들은 또한 섹션 3.4 에서 본 실제 무작위 시험에서 나타나는 인과적 가정 위배 사항들을 해결하는 데 도움을 줄 수 있습니다. 우리는 장 18 및 장 22 에서 무작위 시험의 두 가지 흔한 편향 원인인 비순응(non-adherence)과 추적 관찰 소실(loss-to-follow-up)을 이러한 방법들이 어떻게 해결할 수 있는지 탐구할 것입니다.
이제 실제 데이터를 사용한 예시로 관심을 돌려봅시다. 우리는 매칭(matching)과 역확률 가중치 부여와 같은 성향 점수 방법부터 시작할 것입니다. 이 방법들은 특별한 속성을 가지고 있기 때문입니다: 노출과 결과 사이의 관계를 미리 훔쳐보지 않고도 노출과 교란 요인 사이의 관계를 모델링할 수 있게 해줍니다.
인과적 질문에 답하기 위한 여정을 계속해 봅시다.