노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
장 7 에서 제시했듯이, 우리가 답하고자 하는 인과적 질문은 다음과 같습니다: 2018년 매직 킹덤에서 아침에 “엑스트라 매직 아워”가 있었는지 여부와 같은 날 오전 9시에서 10시 사이의 “세븐 드워프 마인 트레인” 어트랙션 평균 대기 시간 사이에 관계가 있는가? 아래는 이 질문에 대해 제안된 DAG입니다.
library(tidyverse)
library(ggdag)
library(ggokabeito)

coord_dag <- list(
  x = c(Season = 0, close = 0, weather = -1, x = 1, y = 2),
  y = c(Season = -1, close = 1, weather = 0, x = 0, y = 0)
)

labels <- c(
  x = "Extra Magic Morning",
  y = "평균 대기 시간",
  Season = "티켓 시즌",
  weather = "과거 최고 기온",
  close = "공원 폐쇄 시간"
)

dag <- dagify(
  y ~ x + close + Season + weather,
  x ~ weather + close + Season,
  coords = coord_dag,
  labels = labels,
  exposure = "x",
  outcome = "y"
) |>
  tidy_dagitty() |>
  node_status()

dag_plot <- dag |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_point() +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off")

dag_plot +
  geom_dag_edges_arc(curvature = c(rep(0, 5), .3, 0)) +
  geom_dag_label_repel(seed = 1630)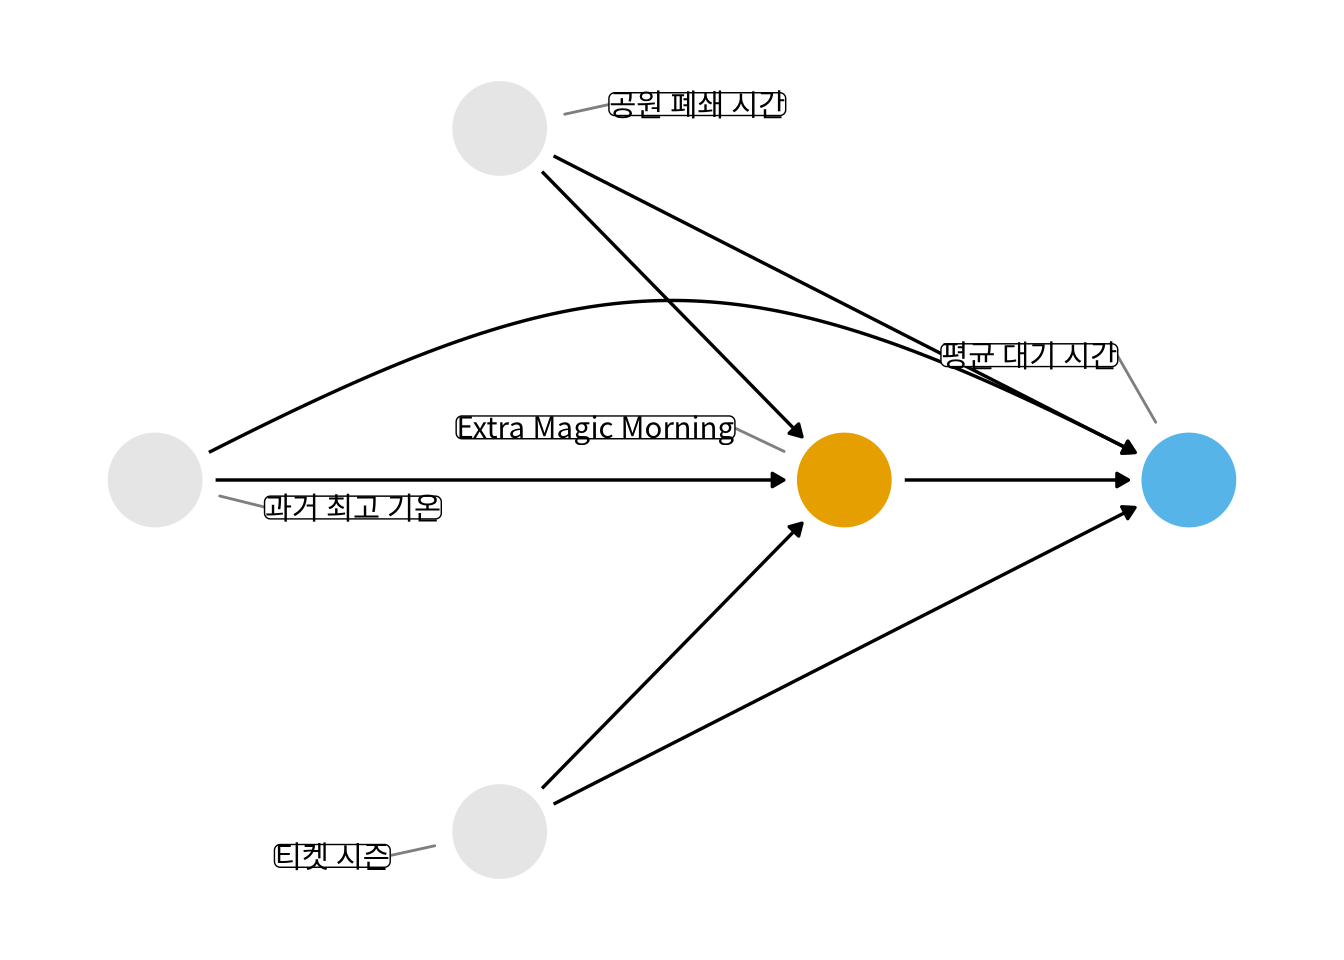
이제 이 데이터에 대한 몇 가지 탐색적 분석을 마쳤으니, 이 질문에 어떻게 답해야 할까요? 우리는 장 4 를 통해 닫아야 할 세 개의 백도어 경로가 있음을 알고 있습니다. 각 경로에는 하나의 변수가 있으며, 결과적으로 세 개의 교란 요인이 존재합니다: 그날의 과거 최고 기온, 공원 폐쇄 시간, 그리고 티켓 시즌(비수기, 평수기, 성수기)입니다. 또한 우리는 이 경로들을 닫을 수 있는 여러 가지 방법이 있다는 것도 알고 있습니다. 층화(stratification)는 차원의 저주(curse of dimensionality) 때문에 여기서 좋은 해결책이 아니므로, 통계 모델을 사용하는 것이 좋습니다. 하지만 어떤 관계를 모델링해야 할까요? 그림 8.2 , 그림 8.3 , 그림 8.4 을 고려해 보십시오.
dag_plot +
  geom_dag_edges_arc(curvature = c(rep(0, 5), .3, 0), edge_color = "grey80") +
  geom_dag_edges_arc(
    data = \(.x) filter(.x, to == "x"),
    curvature = c(0, 0, 0),
    edge_width = 1.1
  )

dag_plot +
  geom_dag_edges_arc(curvature = c(rep(0, 5), .3, 0), edge_color = "grey80") +
  geom_dag_edges_arc(
    data = \(.x) filter(.x, name != "x", to == "y"),
    curvature = c(0, 0, .3),
    edge_width = 1.1
  )

dag_plot +
  geom_dag_edges_link(
    data = \(.x) filter(.x, name == "x", to == "y"),
    edge_color = "grey80"
  ) +
  geom_dag_edges_arc(
    data = \(.x) filter(.x, name != "x"),
    curvature = c(rep(0, 5), .3),
    edge_width = 1.1
  )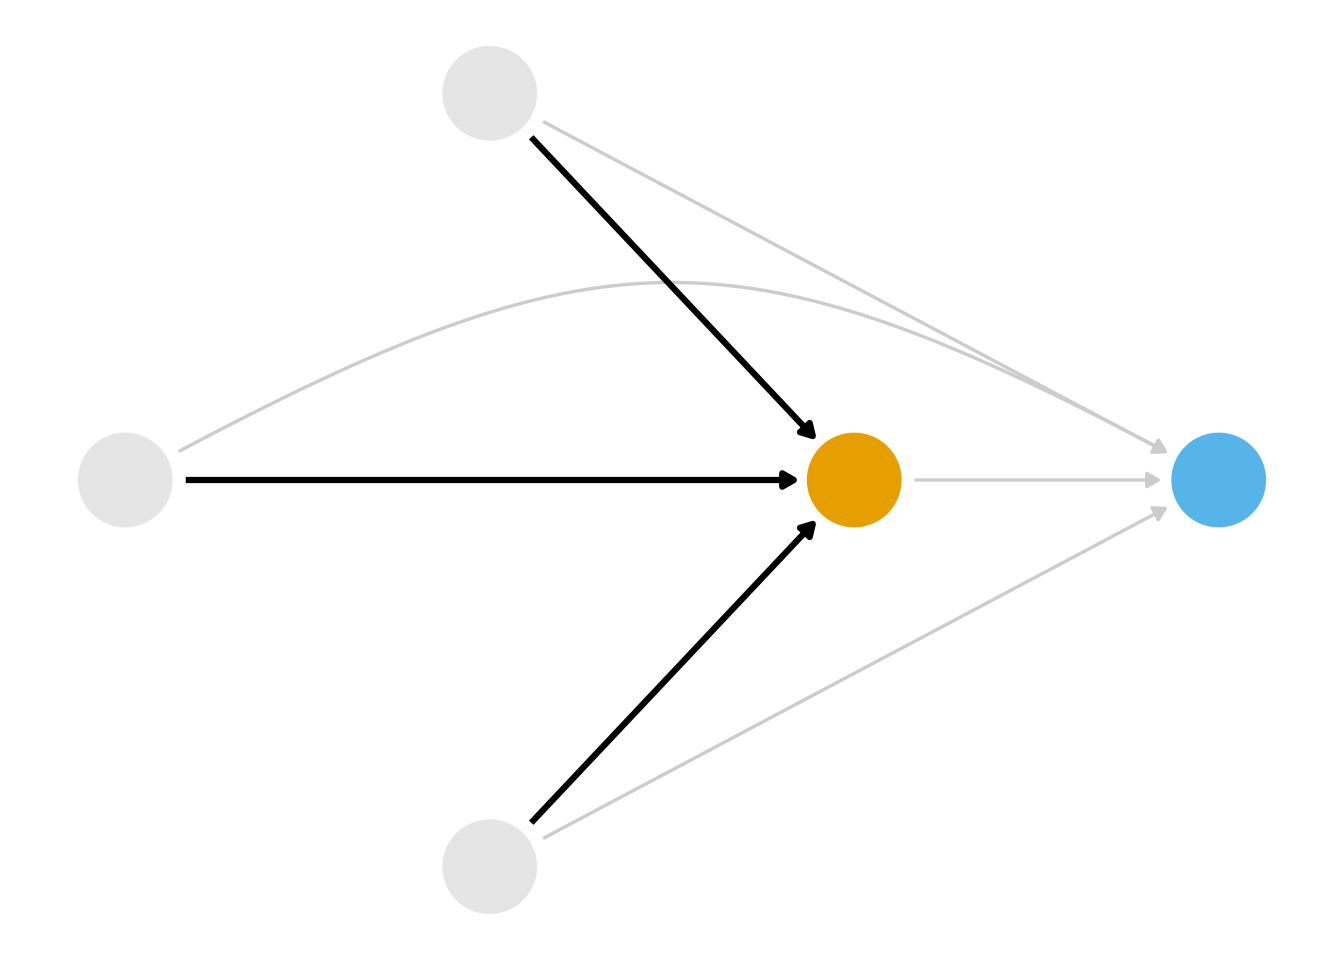
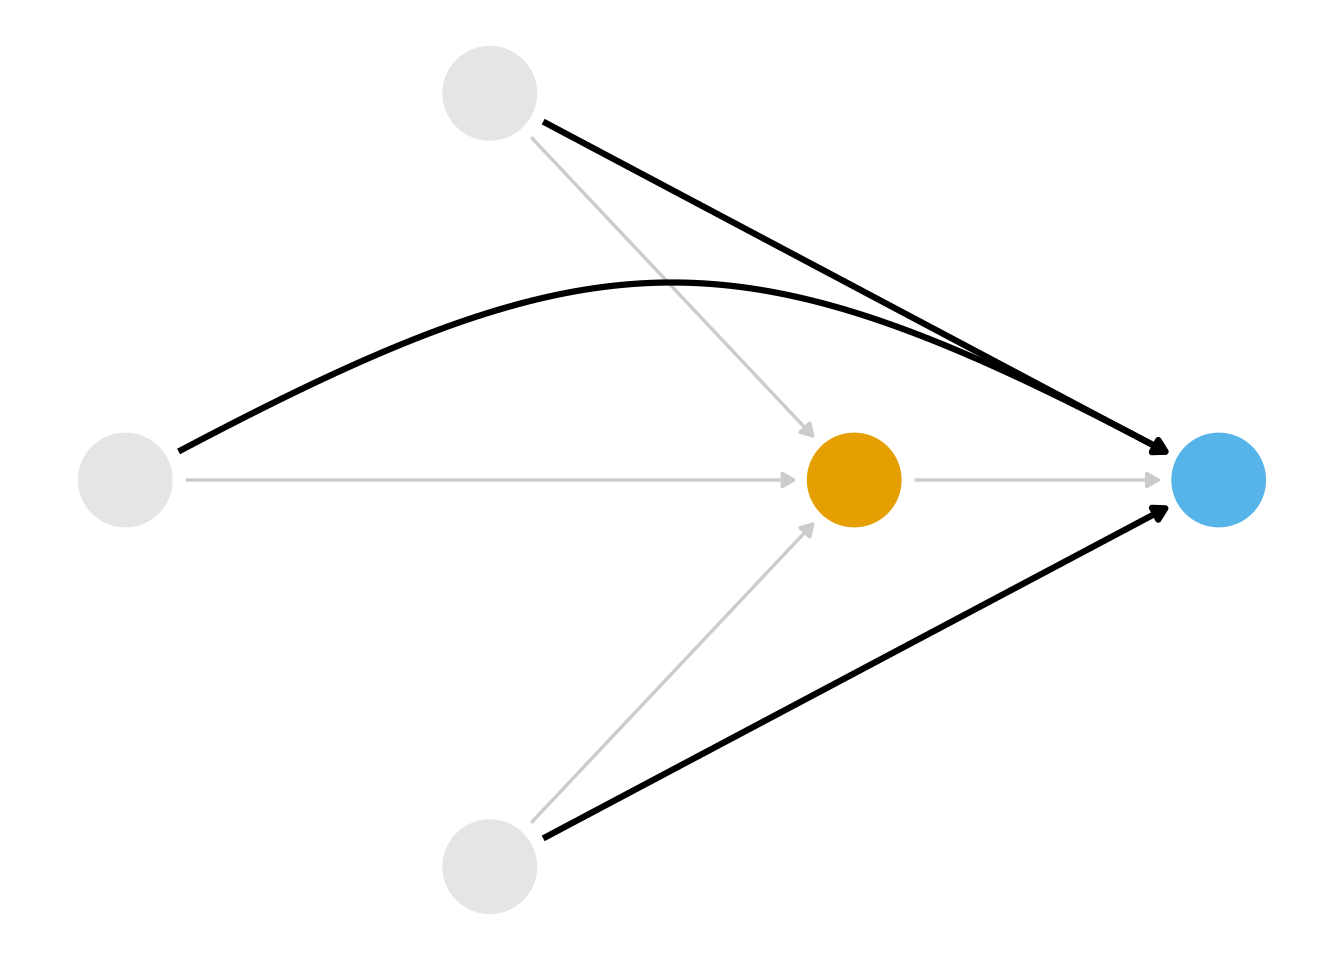
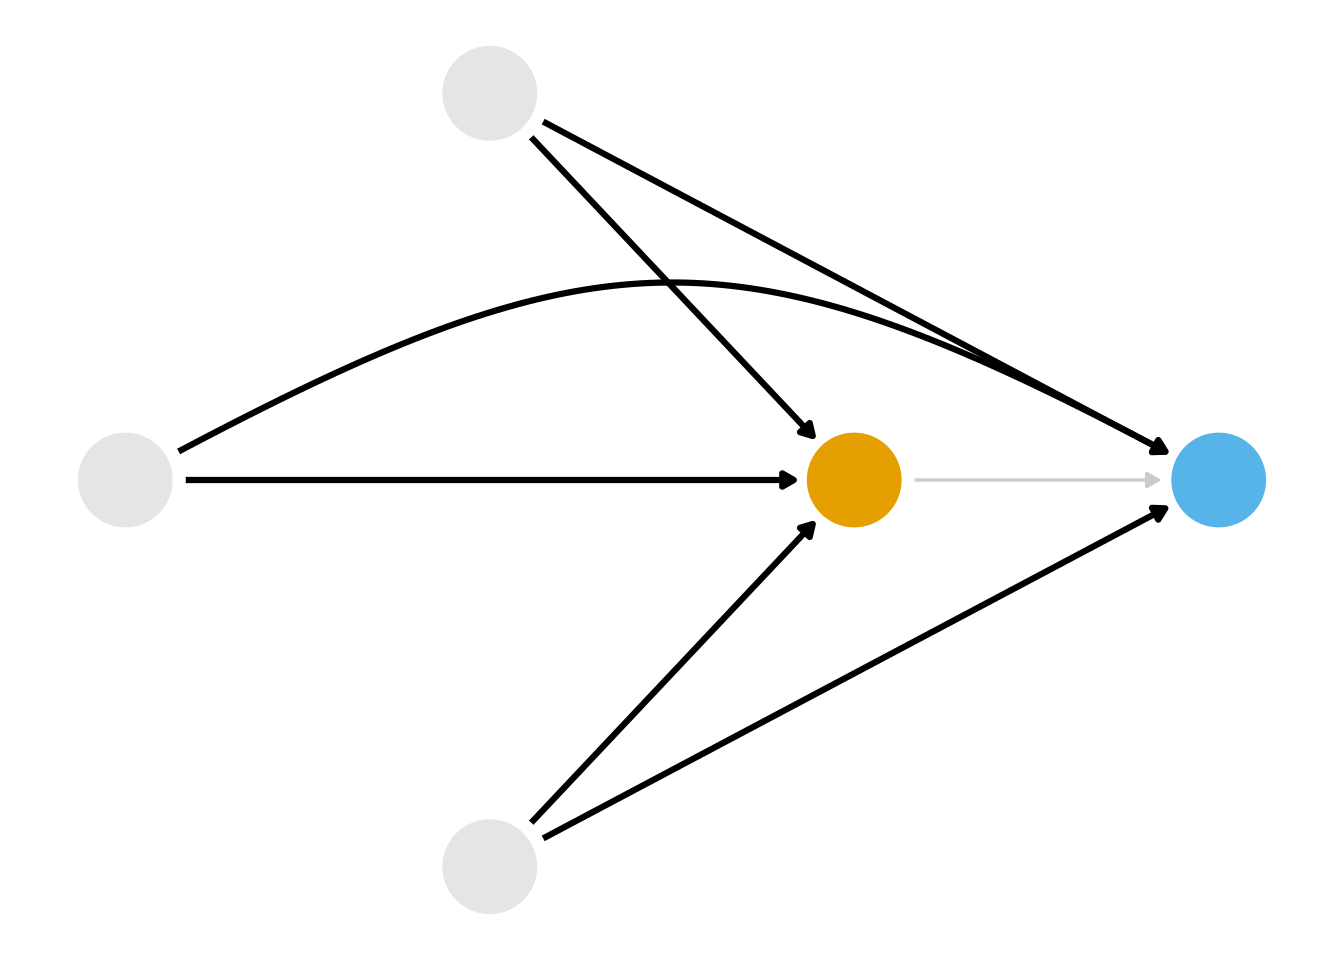
첫째, 그림 fig-dag-close-paths-1에서처럼 교란 요인들과 노출 사이의 관계를 모델링할 수 있습니다. 노출될 확률인 성향 점수(propensity score)를 사용하는 일련의 기술들을 통해 이를 수행할 수 있습니다. 둘째, 그림 fig-dag-close-paths-2에서처럼 교란 요인들과 결과 사이의 관계를 모델링할 수 있습니다. 결과 모델(outcome model)을 사용하는 일련의 기술들을 통해 이를 수행할 수 있습니다. 우리는 sec-strat-outcome장에서 결과 모델을 보았고, sec-g-comp장에서 또 다른 접근 방식을 보게 될 것입니다. 성향 점수와 결과 모델 접근 방식 모두 올바른 DAG를 가지고 관계를 올바르게 모델링했다면 정답을 얻을 수 있게 해줍니다. 대안적으로 그림 fig-dag-close-paths-2에서처럼 두 세트의 관계를 모두 모델링할 수 있습니다. 이중 로버스트(doubly robust) 추정량이라고 불리는 일련의 기술들을 통해 이를 수행할 수 있으며, 이에 대해서는 sec-dr장 및 sec-causal-ml장에서 다시 다룰 것입니다.
다음 몇 장에 걸쳐 그림 fig-dag-close-paths-1을 통해 경로를 차단하는 성향 점수 기술을 다루겠습니다. 먼저 디즈니가 엑스트라 매직 아워 배정을 무작위로 했다면 어떤 모습일지 생각해 봅시다. 각 날짜가 엑스트라 매직 아워에 배정될 확률이 0.5라고 가정하면, 약 절반은 매직 아워가 있고 나머지는 없을 것입니다. 이 경우 그림 fig-dag-close-paths-1에 강조된 화살표는 존재하지 않겠지만 그림 fig-dag-close-paths-2에 강조된 화살표는 남습니다. 결과가 아닌 노출(엑스트라 매직 아워 여부)에만 개입했기 때문입니다. 과거 최고 기온, 공원 폐쇄 시간, 티켓 시즌은 여전히 대기 시간에 영향을 미치지만 엑스트라 매직 아워에는 영향을 주지 않습니다. 여기서 노출 확률인 성향 점수는 매일 0.5입니다. 다시 말해 실험에서는 성향 점수를 미리 알고 있습니다. 주어진 날짜는 rbinom(1, 1, 0.5)를 통해 무작위로 결정됩니다.
디즈니가 더 복잡한 실험을 수행했다고 가정해 봅시다. DAG의 세 변수 수준 내에서 노출을 무작위 배정한 것입니다. 예를 들어 모든 날짜에 기본 확률 0.5를 부여하되, 과거 기온이 화씨 80도 이상이면 확률이 0.1 감소하고, 공원 폐쇄 시간이 오후 10시 이전이면 0.2 증가하며, 성수기 티켓 시즌이면 0.3 감소한다고 합시다. 과거 기온이 86도이고 성수기 티켓 시즌에 오후 9시에 폐장한 날이라면, 그날 아침 엑스트라 매직 아워가 배정될 확률은 \(0.5 - 0.1 + 0.2 - 0.3 = 0.3\)이 됩니다. 이 설계는 여전히 무작위 실험이지만 공변량 수준 내에서 무작위화된 것입니다. 이는 무작위 배정되지 않은 데이터에서 가정해야 하는 조건부 교환 가능성(conditional exchangeability)과 매우 비슷합니다. 날짜들이 공변량 수준 내에서 교환 가능하기 때문입니다.
하지만 우리 사례에서는 이러한 확률을 알 수 없습니다. 만약 이 데이터에서 “숨겨진 실험”을 찾을 수 있다면 어떨까요? 누군가 특정 날짜에 엑스트라 매직 아워를 운영하기로 결정했다는 점을 기억하십시오. 그 의사 결정 과정은 무엇이었을까요? 도메인 지식(처치 배정과 결과 모두에 영향을 주는 요인이 무엇인지 이해하기 위해)과 통계학(조건부 확률을 추정하기 위해)을 결합한다면, 아마도 그 확률을 활용해 교환 가능성을 달성하고 편향되지 않은 인과 효과를 계산할 수 있을 것입니다. (rosenbaum1983central은?) sec-assump장에서 논의한 가정이 충족되는 한, 관찰 연구에서 성향 점수를 조건부화하는 것이 노출 효과의 편향되지 않은 추정으로 이어질 수 있음을 보여주었습니다.
성향 점수를 추정하는 방법은 많습니다. 이진 노출이라면 대개 로지스틱 회귀를 사용하지만 다른 접근 방식도 있습니다. 로지스틱 회귀로 얻은 추정치는 인과적 관점에서 해석하기 어려울 수 있으나(sec-binary장에서 더 자세히 다룹니다), 확률을 예측하는 데는 탁월합니다. 노출을 예측값으로 하고 교란 요인을 공변량으로 하는 로지스틱 회귀는 성향 점수 분석을 시작하기에 좋은 지점입니다.
아래는 로지스틱 회귀를 사용하여 성향 점수 모델을 적합하기 위해 glm()을 사용하는 가상 코드입니다. 첫 번째 인자는 모델로, 왼쪽에는 노출이 있고 오른쪽에는 교란 요인이 있습니다. data 인자는 데이터 프레임을 받고, family = binomial() 인자는 모델이 로지스틱 회귀를 사용하여 적합되어야 함을 나타냅니다. 이와 같은 모델을 적합해 본 적이 있을 텐데, 중요한 세부 사항은 우리가 (결과와 관련된 무엇이 아닌!) 노출 확률을 예측하고 있다는 점과 예측 변수들이 DAG로부터 결정된 교란 요인이라는 점입니다. sec-ci-rct장에서 보았듯이 노출과는 관련이 없지만 결과의 예측 변수인 요인이 있다면, 정밀도를 위해 이들도 포함하는 것이 좋습니다.
우리는 predict()나 fitted()를 사용하여 확률 척도상의 예측값을 추출함으로써 성향 점수를 얻을 수 있습니다. 하지만 {broom} 패키지의 augment() 함수를 사용하면 이러한 성향 점수를 추출하여 원래의 데이터 프레임에 추가하는 과정을 한 번에 수행할 수 있으므로, 이 접근 방식을 사용할 것입니다. 예측값은 기본적으로 선형 로짓(linear logit) 척도로 제공됩니다. type.predict 인자를 "response"로 설정하면 예측값을 확률 척도로 추출하겠다는 의미입니다. data 인자는 원래의 데이터 프레임을 포함합니다. 이를 비워두면 성향 점수 모델에 포함된 변수들만 있는 데이터 프레임이 반환됩니다. 하지만 우리에게는 결과 변수도 필요하므로, 데이터셋에 새로운 날짜가 추가되는 것은 아니더라도 전체 데이터 프레임을 사용하는 것이 편리합니다. 이 코드는 적합된 로지스틱 회귀 모델에 해당하는 6개의 추가 열과 df의 모든 구성 요소로 이루어진 새로운 데이터 프레임을 출력할 것입니다. .fitted 열이 바로 성향 점수입니다. broom의 편리한 세부 사항은 함수에서 반환되는 열들이 R의 여러 모델에 걸쳐 일관되게 유지된다는 점이며, 따라서 이 장의 코드는 많은 유형의 broom 출력물에 대해 작동할 것입니다.
이 방법을 우리 예시에 적용해 봅시다.
우리는 touringplans 패키지의 seven_dwarfs_train_2018 데이터셋을 사용하여 성향 점수 모델을 구축할 수 있습니다. 먼저, 오전 9시에서 10시 사이의 평균 대기 시간만 포함하도록 데이터를 부분 집합화해야 합니다. 그런 다음 glm() 함수를 사용하여 위에서 명시한 세 가지 교란 요인으로 park_extra_magic_morning을 예측하는 성향 점수 모델을 적합시킵니다. augment()를 통해 성향 점수를 데이터 프레임에 추가할 것입니다.
library(broom)
library(touringplans)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9)

ps_mod <- glm(
  park_extra_magic_morning ~ park_ticket_season + park_close +
    park_temperature_high,
  data = seven_dwarfs_9,
  family = binomial()
)

seven_dwarfs_9_with_ps <- ps_mod |>
  augment(type.predict = "response", data = seven_dwarfs_9)
이 성향 점수들을 살펴보겠습니다. 표 8.1 는 데이터셋의 처음 6일에 대한 성향 점수(.fitted 열)와 각 날짜의 노출, 결과, 교란 요인 값을 보여줍니다. 여기서 성향 점수는 관찰된 교란 요인들(이 경우 특정 날짜의 과거 최고 기온, 공원 폐쇄 시간, 티켓 시즌)이 주어졌을 때 해당 날짜에 아침 엑스트라 매직 아워가 있을 확률입니다. 예를 들어, 1월 1일은 티켓 시즌(이 경우 성수기), 공원 폐쇄 시간(오후 11시), 그리고 해당 날짜의 과거 최고 기온(화씨 58.6도)을 고려할 때 매직 킹덤에 엑스트라 매직 아워가 있을 확률이 30.2%였습니다. 이 특정 날짜에는 아침에 엑스트라 매직 아워가 없었습니다 (park_extra_magic_morning 열의 첫 번째 행에 0으로 표시됨). 마찬가지로 1월 5일에도 낮은 확률(18.4%)이 나타났지만, 이 날은 아침에 엑스트라 매직 아워가 있었습니다.
library(gt)
seven_dwarfs_9_with_ps |>
  select(
    park_date,
    park_extra_magic_morning,
    .fitted,
    park_ticket_season,
    park_close,
    park_temperature_high
  ) |>
  head() |>
  gt::gt() |>
  gt::fmt_number(decimals = 3) |>
  gt::fmt_integer(park_extra_magic_morning) |>
  gt::cols_label(
    .fitted = "P(EMM)",
    park_date = "날짜",
    park_extra_magic_morning = "엑스트라 매직 아워",
    park_ticket_season = "티켓 시즌",
    park_close = "폐쇄 시간",
    park_temperature_high = "과거 기온"
)| 날짜 | 엑스트라 매직 아워 | P(EMM) | 티켓 시즌 | 폐쇄 시간 | 과거 기온 |
|---|---|---|---|---|---|
| 2018-01-01 | 0 | 0.302 | peak | 23:00:00 | 58.630 |
| 2018-01-02 | 0 | 0.282 | peak | 24:00:00 | 53.650 |
| 2018-01-03 | 0 | 0.290 | peak | 24:00:00 | 51.110 |
| 2018-01-04 | 0 | 0.188 | regular | 24:00:00 | 52.660 |
| 2018-01-05 | 1 | 0.184 | regular | 24:00:00 | 54.290 |
| 2018-01-06 | 0 | 0.207 | regular | 23:00:00 | 56.250 |
.fitted 열에 성향 점수가 포함된 seven_dwarfs_9_with_ps 데이터셋의 처음 6개 관측치.
노출 그룹별 성향 점수의 분포를 시각화하는 것이 도움이 됩니다. 이를 시각화하는 좋은 방법은 대칭 히스토그램(mirrored histograms)입니다. 이를 만들기 위해 halfmoon 패키지의 geom_mirror_histogram()을 사용할 것입니다. 아래 코드는 두 개의 성향 점수 히스토그램을 생성합니다. 하나는 노출군(아침 엑스트라 매직 아워가 있는 날짜)을 위해 “위”에, 다른 하나는 비노출군을 위해 “아래”에 배치합니다. 또한 scale_y_continuous(labels = abs)를 통해 y축 레이블이 (아래쪽 히스토그램의 경우 음수 값이 아닌) 절대값을 사용하도록 조정할 것입니다.
library(halfmoon)
ggplot(
  seven_dwarfs_9_with_ps,
  aes(.fitted, fill = factor(park_extra_magic_morning))
) +
  geom_mirror_histogram(bins = 50) +
  scale_y_continuous(labels = abs) +
  labs(x = "성향 점수", fill = "엑스트라 매직 아워")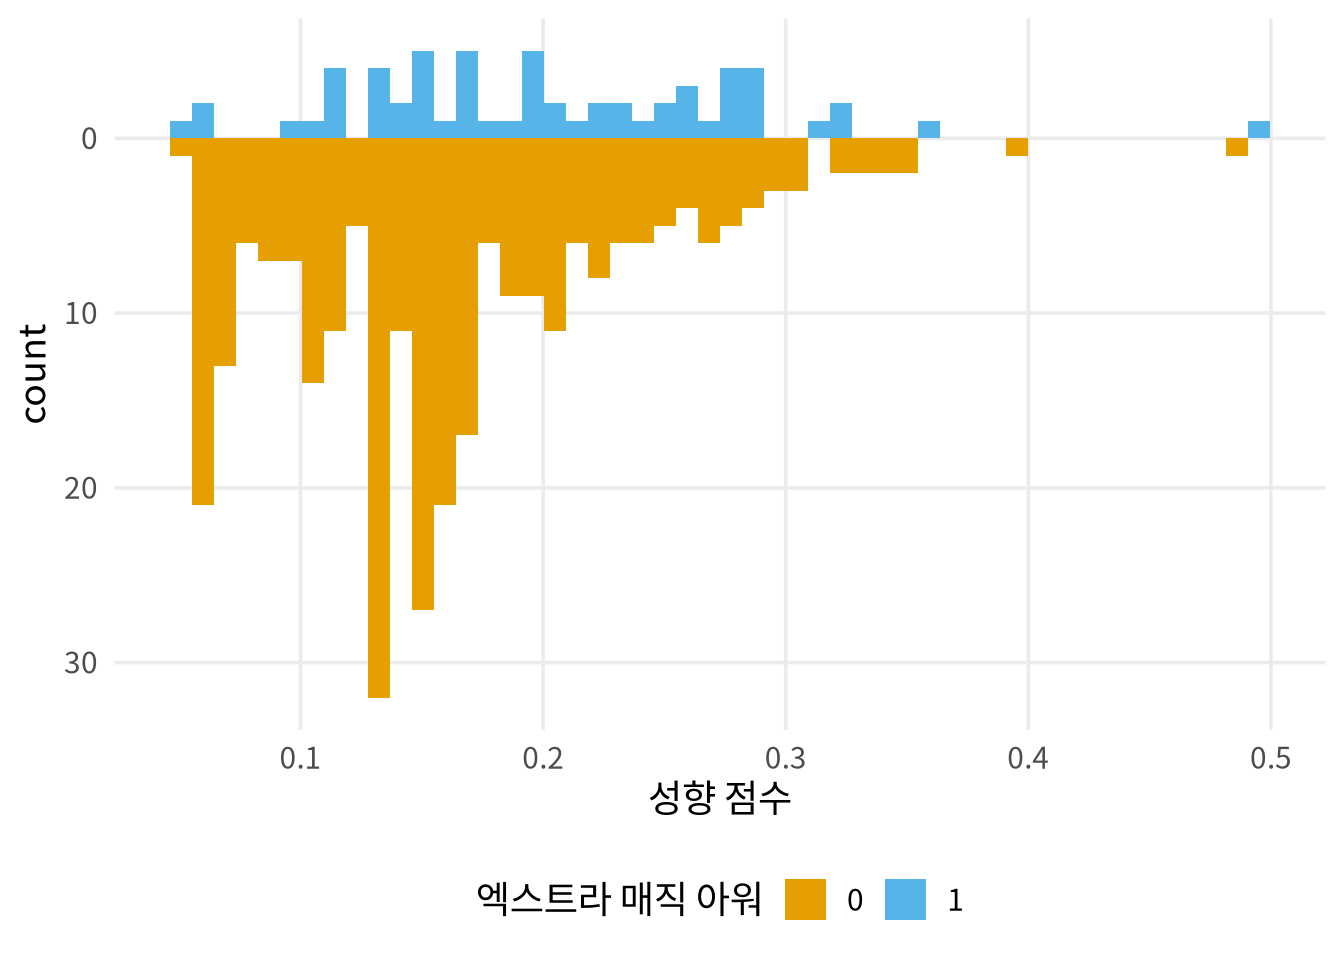
가중치 부여나 매칭과 같은 방법을 적용한 후 성향 점수 모델을 평가하는 방법은 장 9 에서 더 자세히 살펴보겠습니다. 하지만 여기서는 유효한 추론을 위해 필요한 인과적 가정의 관점에서 우리가 보고 있는 것을 생각해 봅시다. 섹션 7.7 에서 우리는 교환 가능성과 긍정성 모두에 문제가 있을 수 있음을 보았습니다. 이 질문에 대해 인과적 일관성은 문제가 되지 않는다고 확신했지만, (가중치나 매칭을 적용하기 전의) 가공되지 않은 성향 점수를 살펴보는 것은 나머지 두 가정에 대한 통찰을 줄 수 있습니다. 데이터가 우리의 가정이 옳고 그름을 결코 증명할 수는 없지만, 몇 가지 증거를 제공하기는 합니다.
긍정성과 교환 가능성을 위해 우리는 두 가지를 찾습니다: 중첩(overlap)과 균형(balance)입니다. 중첩은 노출 그룹별 성향 점수의 범위가 겹치는 것을 의미하며, 때로는 공통 지지 영역(common support)이라고도 불립니다. 중첩은 긍정성과 관련이 있습니다: 성향 점수의 특정 영역에 하나의 노출 그룹만 관측치를 가지고 있다면, 긍정성 위배가 있을 수 있습니다. 다른 하나는 인구 집단 간의 균형입니다. 무작위 설정에서는 노출 가능성이 기준점 공변량들과 무관하기 때문에 두 그룹 간의 분포가 대략적으로 같을 것으로 기대합니다. 이 균형은 “교환 가능하다(exchangeable)”는 단어 선택에 대한 또 다른 관점입니다: 우리는 두 그룹의 노출을 서로 바꾸어 배정하더라도 여전히 올바른 답을 얻으낼 수 있어야 합니다.
그림 8.6 는 좋음, 보통, 그리고 나쁨 수준의 중첩과 균형 상태에서 흔히 보게 되는 분포의 종류들을 시뮬레이션한 시나리오를 보여줍니다. 좋지 않은 균형과 중첩은 편향과 분산을 악화시키고 우리가 내려야 하는 인과적 가정에 대한 확신을 떨어뜨릴 수 있습니다.
library(patchwork)

set.seed(2025)

make_model <- function(n = 1000, intercept, slope) {
  df <- tibble(
    z = rnorm(n),
    exposure = rbinom(n, 1, plogis(intercept + slope * z))
  )
  glm(exposure ~ z, data = df, family = binomial)
}

models_overlap <- list(
  good = make_model(intercept = 0, slope = 0.5),
  moderate = make_model(intercept = 0, slope = 1.5),
  poor = make_model(intercept = 0, slope = 3.0)
)

plot_ps <- function(.x, .y, title = "중첩 (Overlap)") {
  .x |>
    augment(type.predict = "response") |>
    ggplot(aes(.fitted, fill = factor(exposure))) +
    geom_mirror_histogram(bins = 50) +
    scale_y_continuous(labels = abs) +
    labs(
      x = "성향 점수",
      fill = "노출",
      title = paste(str_to_title(.y), title)
    ) +
    theme(legend.position = "none")
}

plots_overlap <- imap(
  models_overlap,
  plot_ps
)

models_balance <- list(
  good = make_model(intercept = 0.0, slope = 1.5),
  moderate = make_model(intercept = log(0.25 / 0.75), slope = 1.5),
  poor = make_model(intercept = log(0.10 / 0.90), slope = 1.5)
)

plots_balance <- imap(
  models_balance,
  plot_ps,
  title = "균형 (Balance)"
)

plots_balance$moderate <- plots_balance$moderate +
  theme(legend.position = "bottom")

(plots_overlap$good + plots_overlap$moderate + plots_overlap$poor) /
  (plots_balance$good + plots_balance$moderate + plots_balance$poor)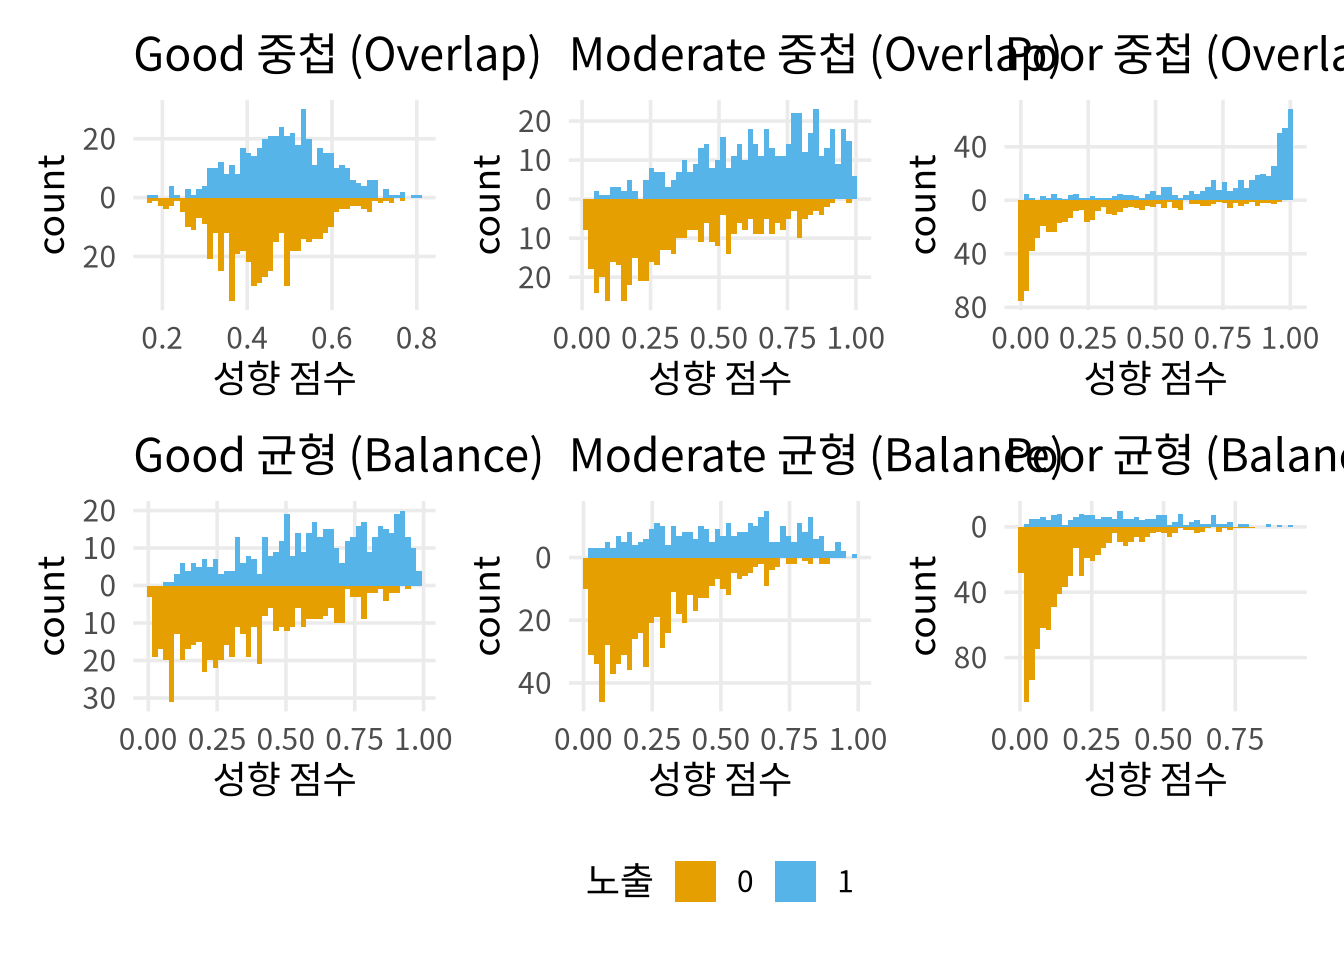
그림 8.5 는 이러한 가정들을 단일 차원(성향 점수)으로 축소하여 보여줍니다. 우리는 확실히 중첩과 균형 문제를 볼 수 있습니다. 분명히 그룹 간의 분포는 모양과 일수 측면에서 다릅니다. 그룹별 성향 점수의 범위도 살펴봅시다.
# A tibble: 4 × 2
  park_extra_magic_morning  range
                     <dbl>  <dbl>
1                        0 0.0547
2                        0 0.482
3                        1 0.0506
4                        1 0.495
그룹 간의 범위가 꽤 가까워 보입니다. 꼬리 부분을 살펴보는 유용한 방법 중 하나는 노출군의 최저 확률보다 더 낮은 확률을 가진 비노출군 관측치 수와, 비노출군의 최고 확률보다 더 높은 확률을 가진 노출군 관측치 수를 확인하는 것입니다.
seven_dwarfs_9_with_ps |>
  mutate(
    support = case_when(
      park_extra_magic_morning == 0 &
.fitted < min(.fitted[park_extra_magic_morning == 1]) ~ "비노출군_범위미만",
      park_extra_magic_morning == 1 &
        .fitted > max(.fitted[park_extra_magic_morning == 0]) ~ "노출군_범위초과",
      .default = "공통_지지_영역내",
      .ptype = factor(levels = c("비노출군_범위미만", "공통_지지_영역내", "노출군_범위초과"))
    )
  ) |>
  count(support, .drop = FALSE)
# A tibble: 3 × 2
support n
<fct> <int>
1 비노출군_범위미만 0
2 공통_지지_영역내 353
3 노출군_범위초과 1하지만 그림 8.5 를 보면, 일부 데이터가 희소한(sparse) 영역이 보이는데, 이는 일부 조합에서 긍정성 위배가 있을 수 있음을 암시합니다. 예를 들어, 확률이 10% 미만인 날들 중에는 아침 엑스트라 매직 아워가 없는 날이 훨씬 더 많습니다.
seven_dwarfs_9_with_ps |>
  count(park_extra_magic_morning, low_prob = .fitted <= .1)
# A tibble: 4 × 3
park_extra_magic_morning low_prob n
<dbl> <lgl> <int>
1 0 FALSE 239
2 0 TRUE 55
3 1 FALSE 56
4 1 TRUE 4우리는 아마도 구조적 긍정성(디즈니의 의사 결정 과정에 따라 어떤 날들은 결코 매직 아워를 갖지 않거나 항상 갖게 됨)과 확률적 위배가 복합적으로 나타나는 것을 보고 있는 것 같습니다. 연간 일수가 제한되어 있고 약 17%의 날들만 아침 엑스트라 매직 아워가 있기 때문에, 어느 정도의 희소성은 예상되는 결과입니다. 예를 들어, 그림 8.7 는 아침 엑스트라 매직 아워가 동일한 노출 비율로 무작위 배정되었을 때 그래프가 어떤 모습일지 보여줍니다. (서로 다른 시드로 시도해 보면, 이 데이터가 그러한 무작위 위배에 취약하다는 것을 알게 될 것입니다.) 성향 점수 방법은 결과 모델 기반 방법이나 일부 이중 로버스트 방법보다 긍정성 위배 문제에 더 민감합니다; 우리는 이 점을 계속 주시해야 할 것입니다.
set.seed(2025)
seven_dwarfs_9 |>
  mutate(randomized_emm = rbinom(n(), 1, .17)) |>
  glm(
    randomized_emm ~ park_ticket_season + park_close + park_temperature_high,
    data = _,
    family = binomial()
  ) |>
  augment(type.predict = "response") |>
  ggplot(
    aes(.fitted, fill = factor(randomized_emm))
  ) +
  geom_mirror_histogram(bins = 50) +
  scale_y_continuous(labels = abs) +
  labs(x = "성향 점수", fill = "엑스트라 매직 아워")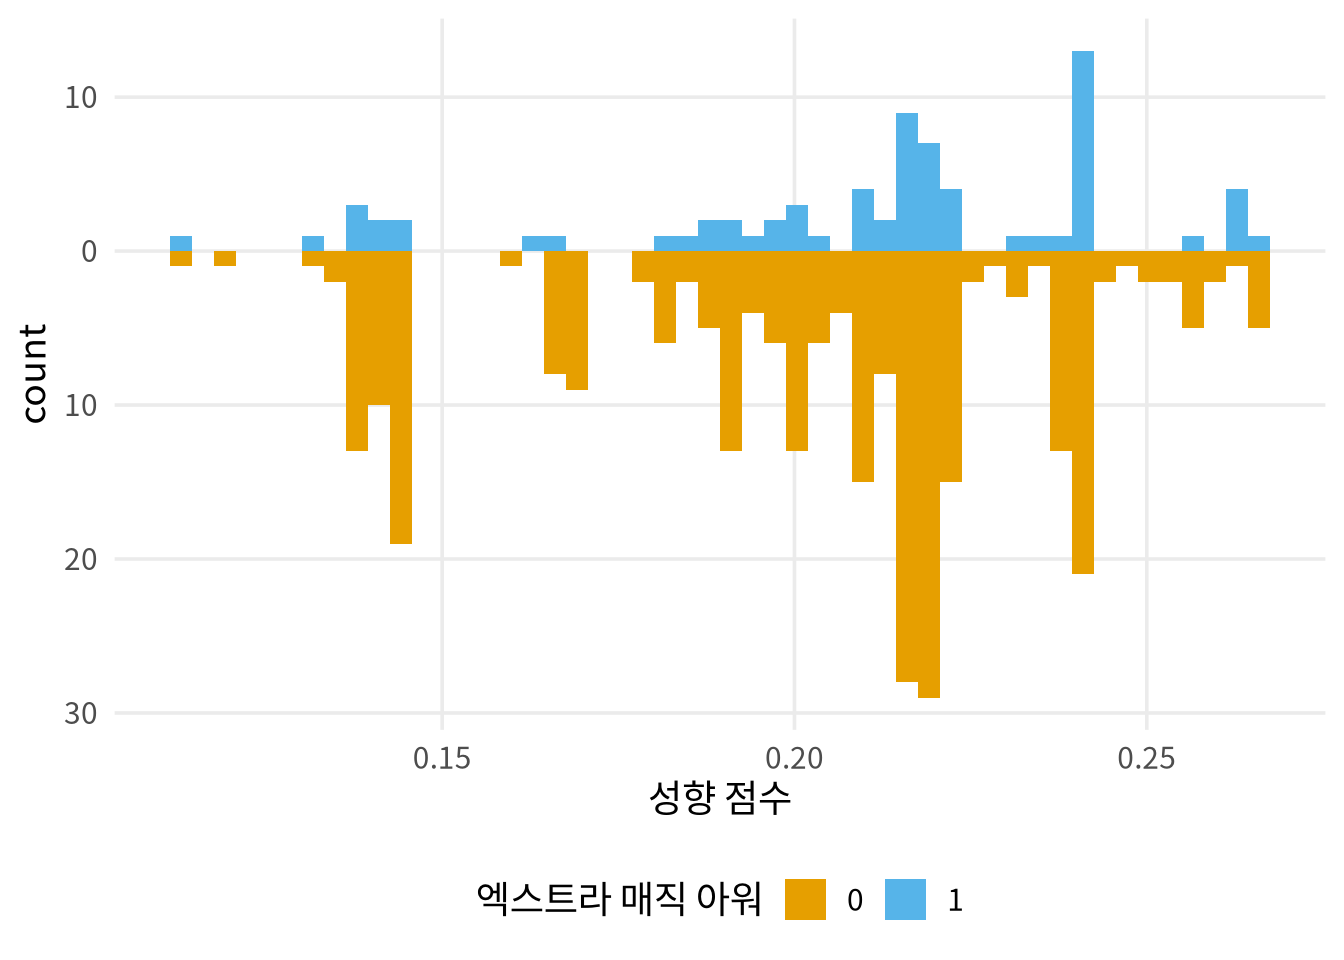
이러한 문제들에 대해 무엇을 할 수 있을까요? 우리의 가정을 뒷받침할 훌륭한 도메인 지식이 필요하지만(또한 구조적으로 엑스트라 매직 아워를 받을 수 없는 날들에 대해 더 나은 제외 기준이 필요할 수도 있습니다), 성향 점수에 담긴 정보를 사용하는 것은 교환 가능성과 (일부 방법의 경우) 긍정성 모두에 도움이 될 수 있습니다.
성향 점수는 그 핵심에 있어 균형(balancing)을 위한 도구입니다. 우리는 이를 사용하여 노출 그룹들을 교환 가능하게 만들려고 노력합니다 (그리고 장 10 에서 보겠지만, 때때로 긍정성을 개선하는 데 사용할 수도 있습니다). 분석에 성향 점수를 통합하는 방법은 많습니다. 흔히 사용되는 기술로는 층화(stratification, 성향 점수 층 내에서 인과 효과 추정), 매칭(matching), 가중치 부여(weighting), 그리고 직접 공변량 조정(direct covariate adjustment, 결과 모델에 성향 점수를 공변량으로 포함) 등이 있습니다. 이 섹션에서는 매칭과 가중치 부여에 집중할 것입니다.
매칭과 가중치 부여는 공변량 균형이 더 잘 잡힌 인구 집단을 만드는 두 가지 다른 방법입니다. 매칭에서는 교환 가능성이 유지되기를 기대하며 관측치의 하위 그룹을 선택하여 하위 인구(sub-population)를 만듭니다. 가중치 부여에서는 교환 가능성이 유지되기를 기대하며 관측치에 다시 가중치를 부여하여 가상 인구(pseudo-population)를 만듭니다.
매칭은 “사과 대 사과” 비교를 할 수 있는 인구 집단을 만드는 직관적인 방법입니다. 노출된 관측치 하나에서 시작한다고 상상해 봅시다. 무한한 인구 집단에서라면, 노출 상태를 제외하고는 모든 것이 동일한 노출되지 않은 관측치 하나를 직접 선택할 수 있을 것입니다. 다시 말해, 공변량 값은 동일하지만 노출 값은 반대인 두 관측치를 매칭하는 것입니다. 이를 정확 매칭(exact matching)이라고 합니다. 정확 매칭은 매우 큰 데이터나 공변량의 수(및 값)가 매우 제한적일 때 잘 작동하지만, 공변량의 수와 연속성이 증가함에 따라 그러한 짝을 찾는 것이 점점 더 복잡해집니다. 여기서 모든 공변량의 요약 측정치인 성향 점수가 등장합니다.
MatchIt 패키지는 R에서 매칭을 위한 가장 유연한 도구 중 하나입니다. matchit()을 사용하여 유사한 날짜들을 매칭해 봅시다. (만약 distance 인자에 미리 계산된 성향 점수를 포함하지 않았다면, matchit()이 우리를 위해 로지스틱 회귀를 다시 적합시켰을 것입니다.) 2018년에 매직 킹덤에 아침 엑스트라 매직 아워가 있었던 날은 60일이었습니다. 이 60일의 노출된 각 날짜에 대해, matchit()은 구성된 성향 점수를 사용한 최근접 이웃(nearest-neighbor) 매칭을 구현하여 비교 가능한 노출되지 않은 날짜를 찾았습니다. 출력 결과를 살펴보면, 기본 대상 추정 대상(target estimand)이 “ATT”, 즉 처치받은 집단에서의 평균 처치 효과임을 알 수 있습니다. 우리는 장 10 에서 이에 대해 더 자세히 논의할 것이지만, 현재로서는 matchit()이 아침 엑스트라 매직 아워가 있었던 모든 날짜를 유지하고 노출되지 않았던 날짜 중 일부를 버릴 것임을 아는 것이 중요합니다.
A `matchit` object
 - method: 1:1 nearest neighbor matching without replacement
 - distance: User-defined - number of obs.: 354 (original), 120 (matched)
 - target estimand: ATT
 - covariates: park_ticket_season, park_close, park_temperature_high
get_matches() 함수를 사용하여 매칭된 사람들로만 구성된 원래 변수들이 포함된 데이터 프레임을 만들 수 있습니다. 표본 크기가 354일에서 120일로 줄어든 점에 주목하십시오.
matched_data <- get_matches(matchit_obj) |>
  as_tibble()

matched_data
# A tibble: 120 × 24
id subclass weights park_date wait_hour
<chr> <fct> <dbl> <date> <int>
1 5 1 1 2018-01-05 9
2 340 1 1 2018-12-17 9
3 12 2 1 2018-01-12 9
4 180 2 1 2018-07-07 9
5 19 3 1 2018-01-19 9
6 236 3 1 2018-09-01 9
7 25 4 1 2018-01-26 9
8 66 4 1 2018-03-08 9
9 33 5 1 2018-02-03 9
10 20 5 1 2018-01-20 9
# ℹ 110 more rows
# ℹ 19 more variables: attraction_name <chr>,
# wait_minutes_actual_avg <dbl>,
# wait_minutes_posted_avg <dbl>,
# attraction_park <chr>, attraction_land <chr>,
# park_open <time>, park_close <time>,
# park_extra_magic_morning <dbl>, …subclass 열은 어떤 날짜들이 서로 매칭되었는지 알려줍니다. 예를 들어 subclass == 1의 경우, 아침 엑스트라 매직 아워가 있었던 날과 없었던 날의 한 쌍이 있습니다. 그들의 성향 점수는 동일합니다.
# A tibble: 2 × 3
  park_date  park_extra_magic_morning .fitted
  <date>                        <dbl>   <dbl>
1 2018-01-05                        1   0.184
2 2018-12-17                        0   0.184
그들의 공변량들을 자세히 살펴보면 이유를 알 수 있습니다. 이들은 정확히 일치하지는 않지만 — 기온과 공원 폐쇄 변수가 약간 다릅니다 — 둘 다 과거 기온이 낮고 폐쇄 시간이 늦은 평수기 티켓 시즌 날짜들임을 볼 수 있습니다. 이들이 서로에게 좋은 반사실이 될 수 있을까요?
# A tibble: 2 × 4
  park_date  park_temperature_high park_ticket_season
  <date>                     <dbl> <chr>
1 2018-01-05                  54.3 regular
2 2018-12-17                  65.4 regular
# ℹ 1 more variable: park_close <time>
쌍 45번도 비슷한 성향 점수를 가지고 있지만, 쌍 1번만큼 가깝지는 않습니다.
# A tibble: 2 × 3
  park_date  park_extra_magic_morning .fitted
  <date>                        <dbl>   <dbl>
1 2018-11-16                        1   0.360
2 2018-11-05                        0   0.349
하지만 그들의 실제 변수들은 그렇게 가깝지 않습니다. 과거 기온에 약 20도 정도 차이가 나고, 공원 폐쇄 시간은 둘 다 이른 편이지만 쌍 1번보다는 조금 더 떨어져 있습니다.
# A tibble: 2 × 4
  park_date  park_temperature_high park_ticket_season
  <date>                     <dbl> <chr>
1 2018-11-16                  64.5 regular
2 2018-11-05                  83.9 regular
# ℹ 1 more variable: park_close <time>
우리는 또한 어떤 날짜들이 매칭되지 않았는지 알고 싶을 수 있습니다. 엑스트라 매직 아워가 있었던 모든 날짜를 유지했으므로, 제외된 모든 날짜들은 엑스트라 매직 아워가 없었던 날들임을 알 수 있습니다. 안티 조인(anti-join)을 사용하여 매칭된 데이터에 없는 날짜들을 확인할 수 있습니다.
# A tibble: 234 × 3
   park_date  park_extra_magic_morning .fitted
   <date>                        <dbl>   <dbl>
 1 2018-01-01                        0  0.302
 2 2018-01-03                        0  0.290
 3 2018-01-04                        0  0.188
 4 2018-01-06                        0  0.207
 5 2018-01-08                        0  0.102
 6 2018-01-09                        0  0.0960
 7 2018-01-10                        0  0.0972
 8 2018-01-11                        0  0.0895
 9 2018-01-13                        0  0.165
10 2018-01-14                        0  0.171
# ℹ 224 more rows
우리는 이렇게 제외된 데이터에도 여전히 가치 있는 통계적 정보가 많이 있다고 느낄 수 있습니다. 엑스트라 매직 아워가 있었던 각 날짜에 대해 하나 이상의 매칭 대상을 사용함으로써 추가적인 통계적 정밀도를 얻을 수 있습니다. 이전에는 \(1:1\) 매칭을 사용했지만, matchit()은 ratio 인자를 통해 \(1:k\) 매칭도 지원합니다. 예를 들어 ratio = 2로 설정하면 엑스트라 매직 아워가 있었던 매일 매일애 대해 두 개의 매칭 대상을 얻게 되어 표본 크기가 180이 됩니다.
하지만 데이터가 제한적일 때는 매칭 대상을 늘리는 것에 주의해야 합니다. 더 많은 날짜를 매칭하려고 할수록 매칭의 품질은 떨어질 것입니다. 예를 들어, 엑스트라 매직 아워가 있었던 각 날짜에 대해 4개의 매칭 대상을 찾으려고 하면, subclass == 1에 대해 나중에 매칭된 대상들의 성향 점수가 꽤 달라지기 시작합니다. 이것이 편향-분산 트레이드오프(bias-variance trade-off)입니다: 더 많은 매칭 대상을 사용하면 정밀도는 좋아지지만, 좋은 짝을 찾기 어려워져 편향이 증가할 수 있습니다.
matchit(
  park_extra_magic_morning ~ park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9_with_ps,
  distance = ps_logit_scale,
  ratio = 4
) |>
  get_matches() |>
  as_tibble() |>
  filter(subclass == 1) |>
  select(park_date, park_extra_magic_morning, .fitted)
# A tibble: 5 × 3
park_date park_extra_magic_morning .fitted
<date> <dbl> <dbl>
1 2018-01-05 1 0.184
2 2018-12-17 0 0.184
3 2018-04-11 0 0.187
4 2018-04-22 0 0.175
5 2018-06-21 0 0.138우리는 matchit()에게 일정 거리 이내의 관측치들만 매칭하도록 요청함으로써 매칭의 품질을 제어할 수 있습니다. 다시 말해, 성향 점수가 우리가 원하는 것보다 멀리 떨어진 관측치들은 매칭하지 않도록 요청할 수 있습니다. 우리는 이를 캘리퍼(caliper) 설정을 통해 제어합니다. 캘리퍼는 로짓 척도에서 매칭 가능한 두 관측치 사이의 최대 허용 거리입니다. 이는 동적인 값으로, caliper 인자에 제공하는 값에 성향 점수의 표준 편차를 곱하여 계산됩니다. 하지만 캘리퍼를 0.2로 설정하여 1:2 매칭을 시도해 봅시다. 캘리퍼를 사용한 매칭 결과 178일이 얻어졌는데, 이는 \(60 + 60*2\)보다 2일 적은 수치입니다. 엑스트라 매직 아워가 있었던 날들 중 두 날은 매칭 대상을 2개가 아닌 1개만 찾았기 때문입니다.
# A tibble: 2 × 2
  subclass     n
  <fct>    <int>
1 17           2
2 50           2
중요한 점은 캘리퍼를 설정함으로써, 어떤 관측치들이 얼마나 제외되느냐에 따라 우리가 추론을 이끌어내는 인구 집단이 달라질 수 있다는 점입니다. 우리는 장 10 에서 이를 다시 살펴볼 것입니다.
매칭을 생각하는 한 가지 방법은 거친 가중치(crude weight)로 보는 것입니다: 최종 표본에서 매칭된 모든 사람은 1의 가중치를 받고, 매칭되지 않은 모든 사람은 0의 가중치를 받습니다. 또 다른 접근 방식은 이 가중치를 매끄럽게 허용하여, 가중치가 부여된 가상 인구에서 관심 있는 공변량들이 평균적으로 균형을 이루도록 가중치를 적용하는 것입니다. 우리는 이미 균형을 맞춰야 할 공변량들의 유용한 요약치를 가지고 있습니다: 바로 성향 점수입니다. 성향 점수로 매칭을 하는 대신, 이를 가중치의 기초로 사용할 것입니다. 우리는 관심 있는 대상 추정 대상에 따라 다양한 가중치를 계산할 수 있습니다 (자세한 내용은 장 10 참조). 이 섹션에서는 일반적으로 역확률 가중치(inverse probability weights)라고 불리는 평균 처치 효과(ATE) 가중치에 집중할 것입니다. 가중치는 다음과 같이 구성됩니다: 각 관측치는 자신이 실제로 받은 노출을 받을 확률의 역수로 가중치가 부여됩니다.
\[w_{ATE} = \frac{X}{p} + \frac{(1 - X)}{1 - p}\]
예를 들어, 관측치 1이 노출 전 공변량들이 주어졌을 때 노출될 확률이 매우 높았지만(\(p = 0.9\)), 실제로는 노출되지 않았다면, 그 가중치는 10이 됩니다(\(w_1 = 1 / (1 - 0.9)\)). 마찬가지로, 관측치 2가 노출될 확률이 매우 높았고(\(p = 0.9\)), 실제로 노출되었다면, 그 가중치는 1.1이 됩니다(\(w_2 = 1 / 0.9\)). 직관적으로, 우리는 측정된 교란 요인들을 바탕으로 반사실을 구성하는 데 도움이 되는 정보를 가진 관측치에 더 많은 가중치를 부여하는 것입니다 — 노출될 것으로 예측되었지만 우연히 노출되지 않았거나, 그 반대의 경우들입니다.
propensity 패키지는 wt_estimand() 패턴을 따르는 이름의 함수들로 다양한 성향 점수 가중치를 계산합니다. ATE를 계산하기 위해 wt_ate()를 사용하며, 여기에 적합된 성향 점수와 관찰된 노출 값을 제공합니다.
library(propensity)

seven_dwarfs_9_with_wt <- seven_dwarfs_9_with_ps |>
  mutate(w_ate = wt_ate(.fitted, park_extra_magic_morning))
표 8.2 는 처음 6개 행의 가중치를 보여줍니다. 예를 들어, 1월 1일은 엑스트라 매직 아워가 없었으며, 이를 갖지 않을 확률은 \(1 - 0.3 = 0.7\)이었습니다. 따라서 이 날은 특별히 놀라운 날이 아닙니다. 가중치는 1.4를 받습니다. 반면 1월 5일은 더 놀라운 날입니다: 엑스트라 매직 아워를 가질 확률이 0.18이었지만 실제로 이를 가졌기 때문입니다. 이 날은 이를 갖지 않은 다른 날들에 대해 좋은 반사실이 될 수 있으므로 5.4의 가중치를 받습니다.
seven_dwarfs_9_with_wt |>
  select(
    park_date,
    park_extra_magic_morning,
    park_ticket_season,
    park_close,
    park_temperature_high,
    .fitted,
    w_ate
  ) |>
  head() |>
  gt::gt() |>
  gt::cols_label(
    .fitted = "P(EMM)",
    park_date = "날짜",
    park_extra_magic_morning = "엑스트라 매직 아워",
    park_ticket_season = "티켓 시즌",
    park_close = "폐쇄 시간",
    park_temperature_high = "과거 기온",
    w_ate = "ATE 가중치"
)| 날짜 | 엑스트라 매직 아워 | 티켓 시즌 | 폐쇄 시간 | 과거 기온 | P(EMM) | ATE 가중치 |
|---|---|---|---|---|---|---|
| 2018-01-01 | 0 | peak | 23:00:00 | 58.63 | 0.3019 | 1.433 |
| 2018-01-02 | 0 | peak | 24:00:00 | 53.65 | 0.2815 | 1.392 |
| 2018-01-03 | 0 | peak | 24:00:00 | 51.11 | 0.2900 | 1.408 |
| 2018-01-04 | 0 | regular | 24:00:00 | 52.66 | 0.1881 | 1.232 |
| 2018-01-05 | 1 | regular | 24:00:00 | 54.29 | 0.1841 | 5.432 |
| 2018-01-06 | 0 | regular | 23:00:00 | 56.25 | 0.2074 | 1.262 |
.fitted 열에 성향 점수가, w_ate 열에 가중치가 포함된 seven_dwarfs_9_with_wt 데이터셋의 처음 6개 관측치.
만약 MatchIt의 방식이 마음에 든다면, 동일한 설계 원칙과 많은 유용한 기능을 가진 형제 패키지인 WeightIt이 있습니다. 우리는 propensity에 집중하겠지만, MatchIt에 익숙하다면 WeightIt도 사용하기 쉽습니다.
wt_it <- WeightIt::weightit(
  park_extra_magic_morning ~ park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9_with_ps,
  ps = ".fitted"
)

wt_it
A weightit object
- method: "glm" (propensity score weighting with GLM)
- number of obs.: 354
- sampling weights: none
- treatment: 2-category
- estimand: ATE
- covariates: park_ticket_season, park_close, park_temperature_highhead(wt_it$weights)[1] 1.433 1.392 1.408 1.232 5.432 1.262아침에 엑스트라 매직 아워를 가질 예측 확률이 매우 낮았던 날이 실제로 이를 가졌다면 높은 가중치를 받게 됩니다. ATE 가중치의 최솟값은 1이지만 최댓값은 제한이 없습니다. 관찰된 노출을 받을 확률이 0에 가까울수록 가중치는 더 높아집니다. 이는 우리가 극단적인 가중치(extreme weights)에 주의해야 함을 의미합니다. 극단적인 가중치는 결과로 나타나는 결과 모델에 과도한 정보를 추가하는 가중치입니다. 극단적인 가중치는 우리의 추정치를 불안정하게(destabilize) 만들어, 정밀도를 떨어뜨리고 잠재적으로 편향을 악화시키는 경향이 있습니다. 그림 8.8 은 ATE 가중치의 분포를 보여줍니다.
seven_dwarfs_9_with_wt |>
  ggplot(aes(w_ate)) +
  geom_histogram() +
  scale_x_log10() +
  xlab("ATE 가중치")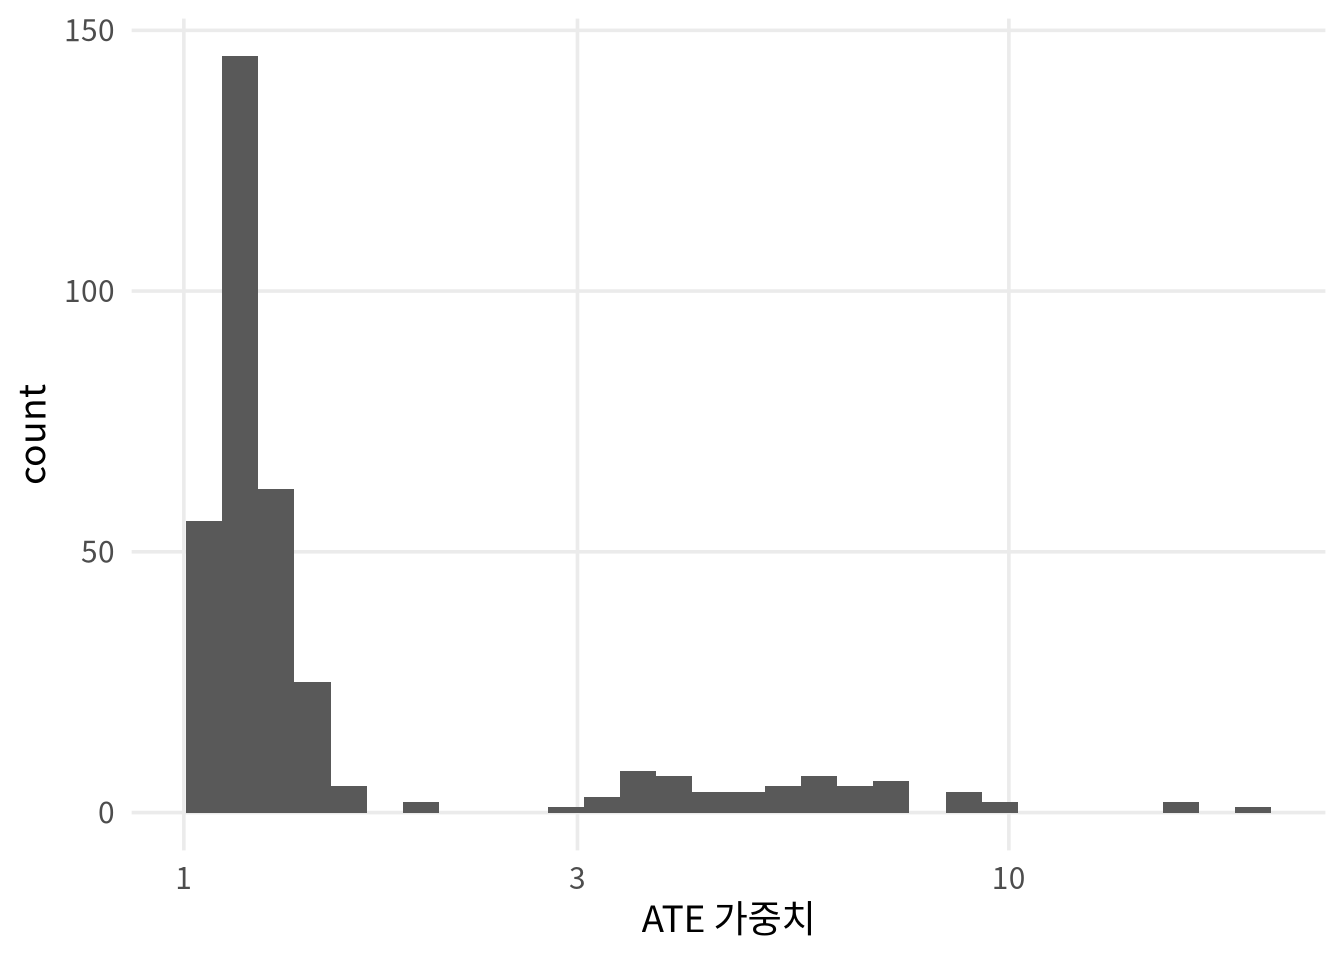
실제로 가중치가 10을 넘는 날들이 여러 개 있습니다 (표 8.3). 예를 들어 4월 27일은 거의 20일치에 해당하는 가중치를 받고 있습니다! 이 날이 엑스트라 매직 아워가 없었던 날들에 대해 좋은 반사실이 될 수는 있겠지만, 가중치가 이렇게 높으면 편향을 줄이는 것보다 분산을 더 많이 키우게 될 것입니다.
seven_dwarfs_9_with_wt |>
  filter(w_ate > 10) |>
  select(
    park_date,
    park_extra_magic_morning,
    park_ticket_season,
    park_close,
    park_temperature_high,
    .fitted,
    w_ate
  ) |>
  gt::gt() |>
  gt::cols_label(
    .fitted = "P(EMM)",
    park_date = "날짜",
    park_extra_magic_morning = "엑스트라 매직 아워",
    park_ticket_season = "티켓 시즌",
    park_close = "폐쇄 시간",
    park_temperature_high = "과거 기온",
    w_ate = "ATE 가중치"
  )
Warning: There was 1 warning in `filter()`.
ℹ In argument: `w_ate > 10`.
Caused by warning in `vec_ptype2.psw.double()`:
! Converting psw to numeric
ℹ Class-specific attributes and metadata have been
dropped
ℹ Use explicit casting to numeric to avoid this
warning| 날짜 | 엑스트라 매직 아워 | 티켓 시즌 | 폐쇄 시간 | 과거 기온 | P(EMM) | ATE 가중치 |
|---|---|---|---|---|---|---|
| 2018-01-26 | 1 | value | 20:00:00 | 73.25 | 0.09867 | 10.13 |
| 2018-02-09 | 1 | value | 22:00:00 | 81.50 | 0.06261 | 15.97 |
| 2018-03-02 | 1 | value | 22:00:00 | 81.29 | 0.06281 | 15.92 |
| 2018-04-27 | 1 | value | 23:00:00 | 84.33 | 0.05059 | 19.77 |
우리는 안정화 계수(stabilization factor)인 노출군과 비노출군의 비율을 사용하여 극단적인 가중치의 불안정성을 일부 완화할 수 있습니다. 받은 노출의 확률을 역전시키는 대신, 분자에 해당 비율을 사용합니다. 안정화는 가중치에 흥미로운 효과를 줍니다. 첫째, 가중치의 퍼짐 정도를 작게 만들어 분산을 개선합니다. 둘째, 평균이 1인 가중치를 생성합니다. 다시 말해, 가상 인구의 크기가 원래 인구와 거의 같아집니다.
# A tibble: 1 × 5
   mean   min   max     n   sum
  <dbl> <dbl> <dbl> <int> <dbl>
1  1.00 0.342  3.35   354  355.
seven_dwarfs_9_with_wt |>
ggplot(aes(stbl_wts)) +
geom_histogram() +
scale_x_log10() +
xlab("안정화된 ATE 가중치")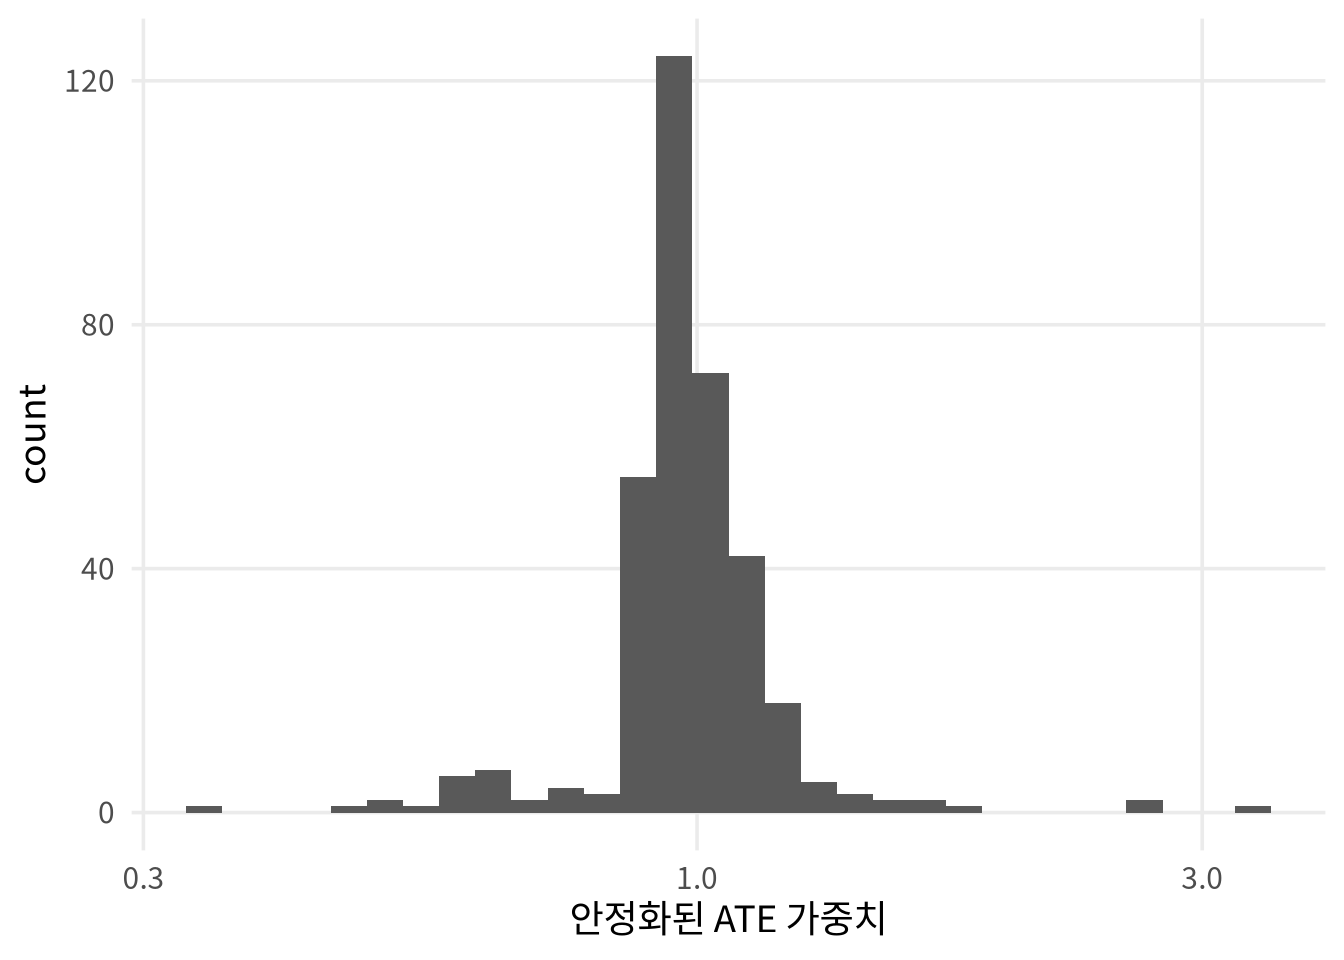
극단적인 가중치(및 부족한 중첩)를 해결하기 위해 사용되는 또 다른 기술 세트는 트리밍(trimming)과 절단(truncation)입니다. 트리밍은 성향 점수의 허용 범위를 설정하고 그 범위를 벗어나는 관측치들을 분석에서 제외하는 것입니다. 트리밍을 할 때는 적합도와 캘리브레이션을 개선하기 위해 성향 점수 모델을 다시 적합시켜야 합니다. 절단은 관측치를 제외하는 대신, 허용 범위를 벗어나는 모든 값을 해당 범위의 최솟값 또는 최댓값으로 절단하는 것입니다. 절단은 때때로 윈저화(Winsorizing)라고도 불립니다. 저자들에 따라 “트리밍”과 “절단”을 혼용하거나 심지어 반대 의미로 사용하기도 하므로, 자신이 의미하는 바를 명확히 하고 다른 분석가들이 의미하는 바도 잘 이해해야 합니다.
propensity 패키지는 이러한 과정들을 관리하기 위한 헬퍼 함수들을 제공합니다. ps_trim()은 관측치들을 트리밍하고, ps_trunc()는 이들을 절단합니다. ps_refit()은 트리밍되지 않은 관측치들로만 성향 점수 모델을 다시 적합시킵니다. 여기서 몇 가지 주의할 점이 있습니다. 첫째, 우리는 점수를 트리밍할 최적의 범위를 결정하기 위해 적응형(adaptive) 방법을 사용하고 있습니다; 이 접근 방식은 결과 관측치들의 분산을 최적화합니다. 둘째, 트리밍된 성향 점수에 대해 ps_refit()을 사용하여 트리밍된 관측치 없이 성향 점수를 다시 계산합니다. 셋째, ps_trunc()에서 우리는 성향 점수를 하위 1% 미만인 경우 1% 값으로 절단하고 있습니다. 연구자들은 흔히 1%와 99% 백분위수에서 절단하지만, 우리의 가장 높은 성향 점수는 약 0.50이므로 극단적인 가중치를 생성하지 않을 것이기 때문에 상한선은 그대로 둡니다.
트리밍과 절단은 우리 표본에 서로 다른 방식으로 영향을 미칩니다. 트리밍을 하면 나중에 관측치 수가 줄어듭니다. 어떤 관측치가 트리밍되었는지는 is_unit_trimmed()로 확인할 수 있습니다. 원래 성향 점수의 낮은 범위에 있는 관측치들만 트리밍되었습니다. ps_refit()을 사용할 때 모델에 포함되지 않았기 때문에 이들의 trimmed_ps 값은 NA입니다.
seven_dwarfs_9_with_wt |>
  filter(is_unit_trimmed(trimmed_ps)) |>
  select(park_date, park_extra_magic_morning, .fitted, trimmed_ps)
# A tibble: 36 × 4
park_date park_extra_magic_mor…¹ .fitted trimmed_ps
<date> <dbl> <dbl> <ps_trim>
1 2018-02-02 0 0.0695 NA
2 2018-02-09 1 0.0626 NA
3 2018-02-26 0 0.0581 NA
4 2018-02-27 0 0.0630 NA
5 2018-03-01 0 0.0702 NA
6 2018-03-02 1 0.0628 NA
7 2018-03-03 0 0.0601 NA
8 2018-04-24 0 0.0611 NA
9 2018-04-25 0 0.0631 NA
10 2018-04-26 0 0.0623 NA
# ℹ 26 more rows
# ℹ abbreviated name: ¹park_extra_magic_morning이 하위 집합에서 중첩이 약간 개선된 것을 볼 수 있습니다 (그림 8.10).
ggplot(
  seven_dwarfs_9_with_wt,
  aes(trimmed_ps, fill = factor(park_extra_magic_morning))
) +
  geom_mirror_histogram(bins = 50) +
  scale_y_continuous(labels = abs) +
  labs(x = "성향 점수", fill = "엑스트라 매직 아워")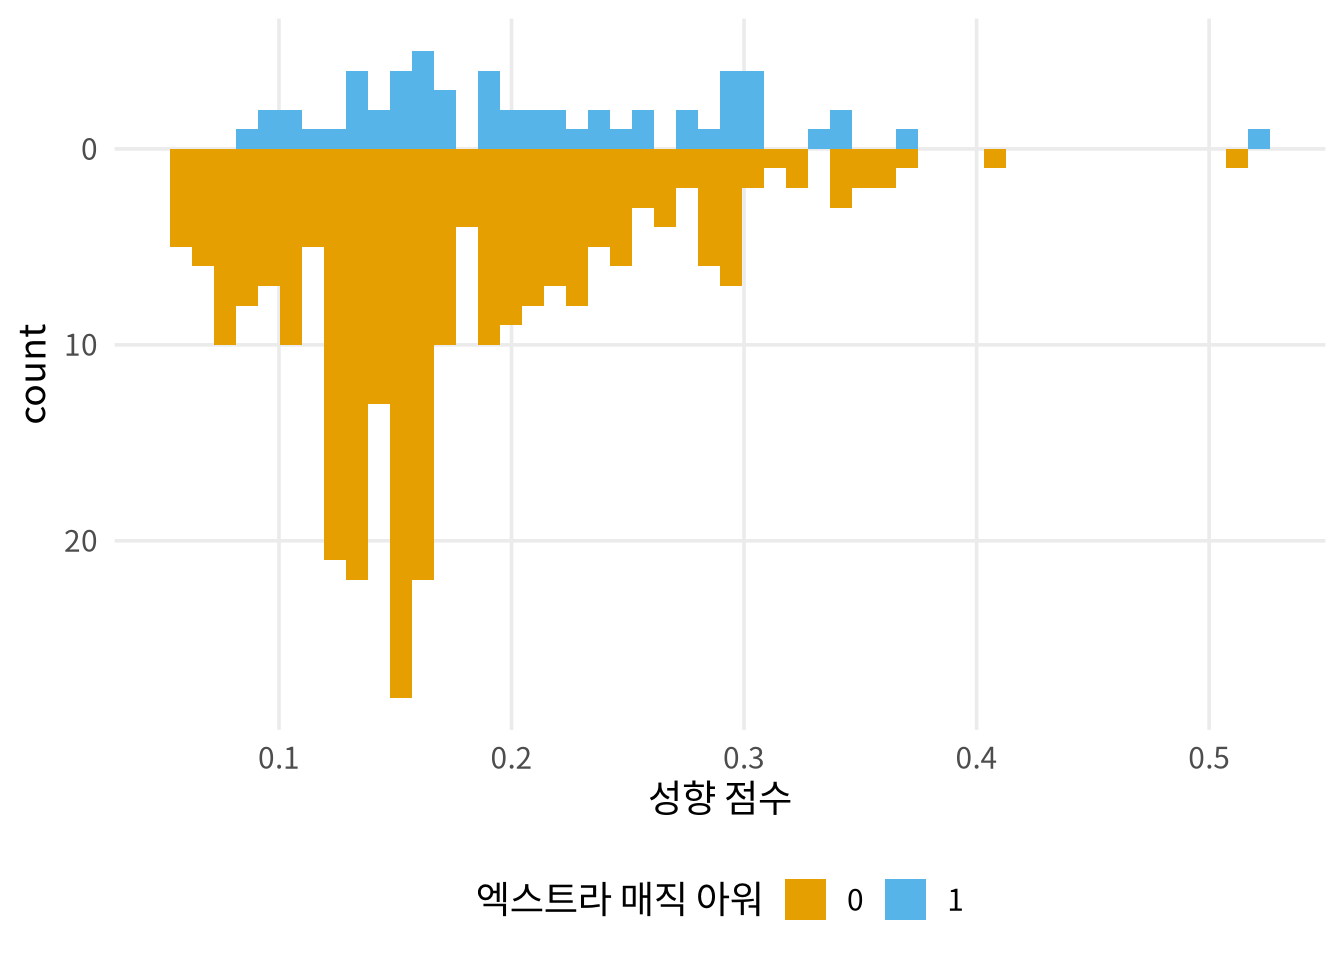
절단의 경우, 관측치를 제거하지 않고 일부 관측치들이 허용 범위 내에 있도록 강제합니다. 절단된 모든 관측치들(is_unit_truncated()로 찾음)은 이제 trunc_ps에서 .fitted의 1% 백분위수와 동일한 값을 갖게 됩니다.
seven_dwarfs_9_with_wt |>
  filter(is_unit_truncated(trunc_ps)) |>
  select(park_date, park_extra_magic_morning, .fitted, trunc_ps)
# A tibble: 4 × 4
park_date park_extra_magic_morning .fitted trunc_ps
<date> <dbl> <dbl> <ps_trun>
1 2018-04-27 1 0.0506 0.05744
2 2018-08-27 0 0.0547 0.05744
3 2018-10-01 0 0.0567 0.05744
4 2018-10-03 0 0.0566 0.05744그래프의 왼쪽에서 절단이 어떻게 중첩을 강제하는지 볼 수 있습니다 (그림 8.11). 절단은 단위를 버리지 않기 때문에 트리밍보다 표본 크기를 개선하지만, 이렇게 성향 점수를 강제로 변경하는 것은 직관적이지 않을 수 있습니다.
ggplot(
  seven_dwarfs_9_with_wt,
  aes(trunc_ps, fill = factor(park_extra_magic_morning))
) +
  geom_mirror_histogram(bins = 50) +
  scale_y_continuous(labels = abs) +
  labs(x = "성향 점수", fill = "엑스트라 매직 아워")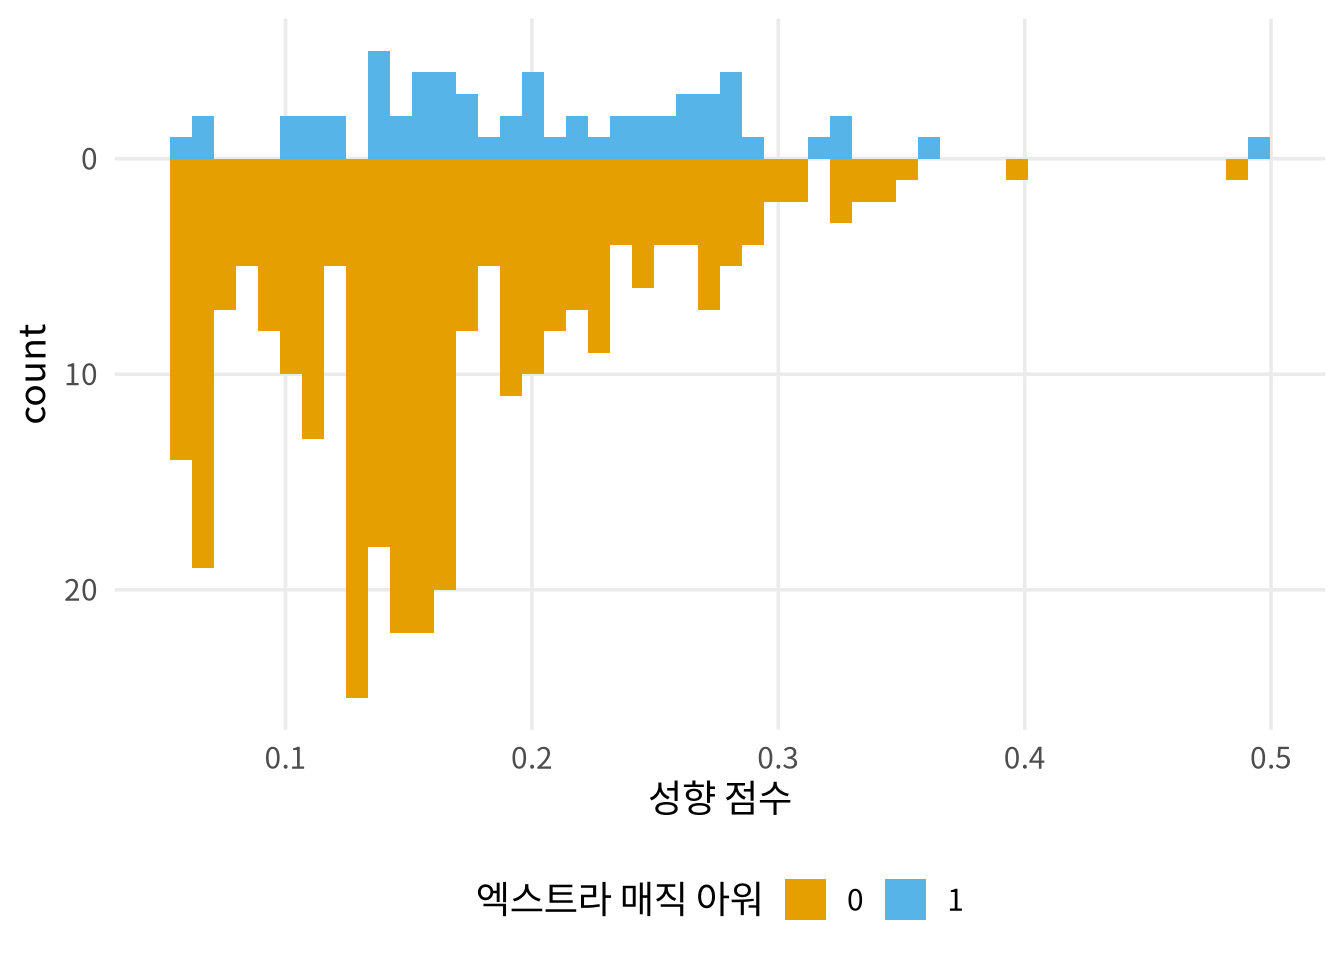
그런 다음 트리밍되거나 절단된 점수를 사용하여 가중치를 계산할 수 있습니다. 사실, 이러한 접근 방식들을 안정화된 가중치와 결합할 수 있습니다. 절단된 성향 점수에 대해 안정화된 가중치를 계산해 봅시다. (우리는 또한 매칭 및 캘리퍼(caliper)와 함께 절단되거나 트리밍된 가중치를 사용할 수 있지만, 여기서는 보여주지 않겠습니다.) 그림 8.12 는 절단 및 안정화 후의 가중치 분포를 보여줍니다.
seven_dwarfs_9_with_wt <- seven_dwarfs_9_with_wt |>
  mutate(trunc_stbl_wt = wt_ate(
    trunc_ps,
    park_extra_magic_morning,
    stabilize = TRUE
  ))

seven_dwarfs_9_with_wt |>
  ggplot(aes(trunc_stbl_wt)) +
  geom_histogram() +
  scale_x_log10() +
  xlab("절단 및 안정화된 ATE 가중치")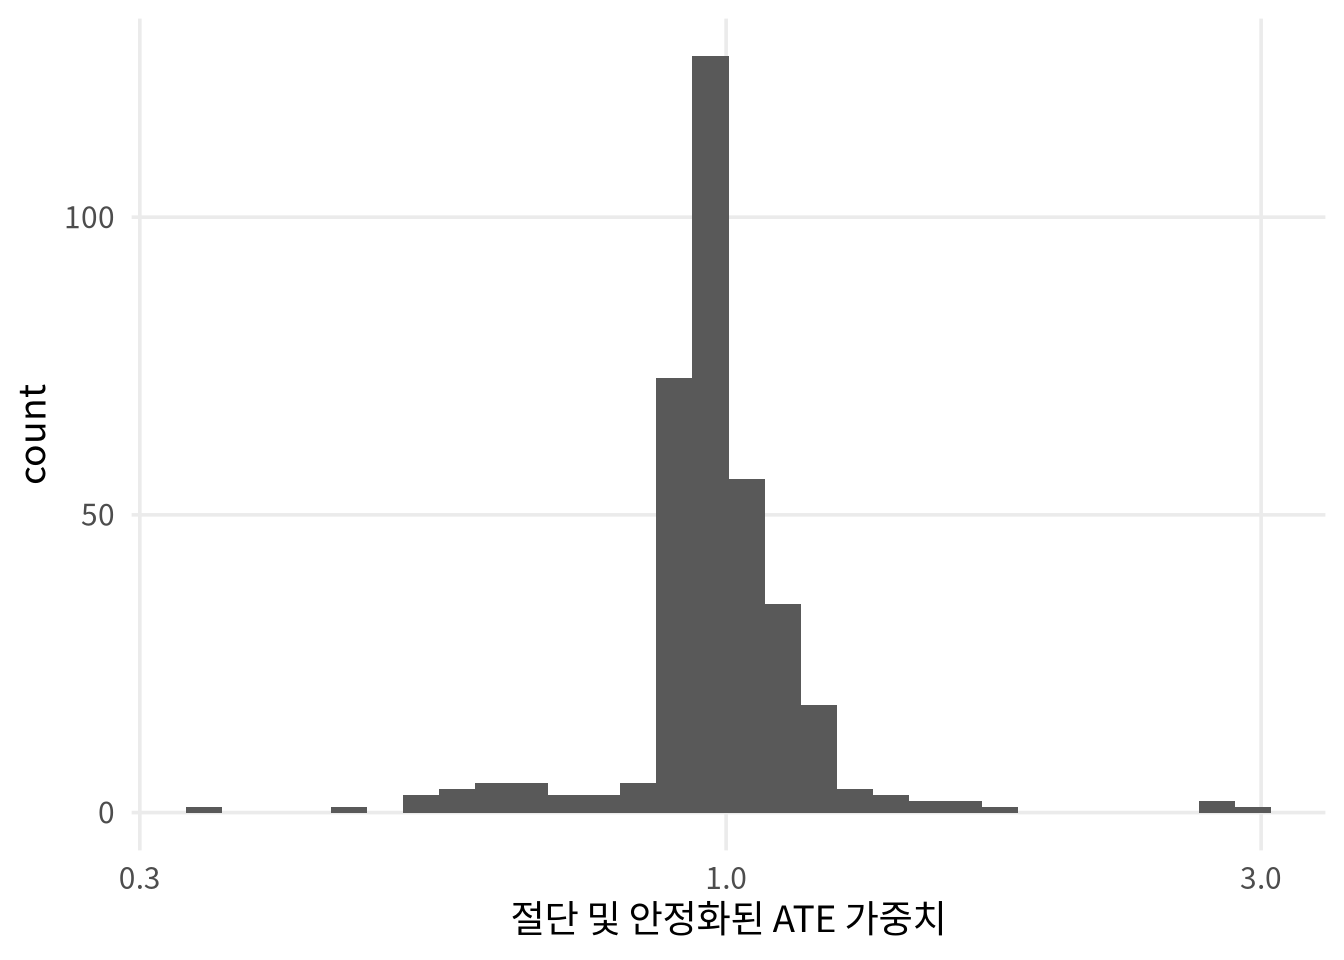
절단과 트리밍은 캘리퍼 사용과 마찬가지로 우리가 추론을 이끌어내는 인구 집단을 변화시킬 수 있습니다. 우리는 sec-estimands장에서 이를 더 조사할 것입니다.
극단적인 가중치가 종종 긍정성의 문제라는 점을 눈치채셨을 것입니다. 예를 들어 트리밍된 관측치들은 주로 엑스트라 매직 아워가 없었던 날들 중 이를 가질 예측 확률이 낮았던 날들이었습니다. 일단 성향 점수를 적합시켰다면, 트리밍되거나 절단된 결과들을 조사하여 왜 처음에 이를 수정해야 했는지 더 잘 이해할 수 있습니다. 여기서는 트리밍된 관측치들이 모두 티켓 시즌이 비수기이면서 폐쇄 시간이 늦고 따뜻했던 날들인 것으로 보입니다. 아마도 이러한 날들은 디즈니의 요구 사항에 따라 구조적으로 아침 엑스트라 매직 아워를 가질 수 없는 날들일 수 있습니다. 성향 점수에 따라 관측치를 동적으로 제거하기보다는 제외 기준을 수정하는 것이 좋을 수 있으므로, 그것이 사실인지 확인하고 싶을 것입니다.
seven_dwarfs_9_with_wt |>
  filter(is_unit_trimmed(trimmed_ps)) |>
  select(
    park_ticket_season,
    park_close,
    park_temperature_high
  )
# A tibble: 36 × 3
park_ticket_season park_close park_temperature_high
<chr> <time> <dbl>
1 value 22:00 74.6
2 value 22:00 81.5
3 value 22:00 86.4
4 value 22:00 81.1
5 value 21:00 85.0
6 value 22:00 81.3
7 value 23:00 73.1
8 value 22:00 83.1
9 value 22:00 81.0
10 value 22:00 81.8
# ℹ 26 more rows가중치 부여가 매칭보다 통계적으로 더 효율적이므로, 가능하면 매칭보다는 가중치 부여를 사용할 것을 권장합니다. 하지만 매칭에는 뚜렷한 장점이 있습니다: 바로 이해하기 쉽다는 것입니다. 통계적 배경 지식이 있는 사람은 가중치 분석 결과를 해석하는 데 익숙할 수 있지만, 그렇지 않은 이해관계자는 가상 인구나 왜 표본 크기가 정수가 아닌 값이 될 수 있는지 이해하지 못할 수 있습니다. 따라서 데이터가 많고 분석 결과의 해석을 돕는다고 판단된다면 매칭이 좋은 옵션이 될 수 있습니다.
우리는 또한 장 10 에서 가중치 부여된 인구 집단을 제시하는 몇 가지 방법들을 소개할 것이며, 이는 이해관계자들이 분석을 더 잘 이해하도록 도와 두 마리 토끼를 모두 잡을 수 있게 해줄 것입니다.
이제 매칭과 가중치 부여를 통해 성향 점수를 적용했으니, 이러한 접근 방식들이 그림 8.5 에서 보았던 균형을 개선했는지 물을 때입니다. 성향 점수 기술의 결과를 조사하기 위한 기법들로 넘어가 봅시다.