경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
지금까지 이 책에서 우리는 두 가지 주요 접근 방식을 배웠습니다:
두 방법 모두 모델을 올바르게 명시해야만 편향되지 않은 추정치를 얻습니다. 이중 로버스트(doubly robust, DR) 추정량은 두 모델 중 하나만 올바르게 명시되어도 편향되지 않은 추정치를 얻는 특별한 성질이 있습니다.
이중 로버스트 추정량의 대표적인 형태는 증강된 역확률 가중치(Augmented Inverse Probability Weighting, AIPW) 추정량입니다. AIPW는 IPTW와 G-공식(결과 회귀)을 결합합니다.
ATE AIPW 추정량은 다음과 같이 정의됩니다:
\[\hat{\tau}_{AIPW} = \frac{1}{n}\sum_{i=1}^{n}\left[\hat{\mu}_1(C_i) - \hat{\mu}_0(C_i) + \frac{X_i(Y_i - \hat{\mu}_1(C_i))}{\hat{e}(C_i)} - \frac{(1-X_i)(Y_i - \hat{\mu}_0(C_i))}{1-\hat{e}(C_i)}\right]\]
여기서: - \(\hat{\mu}_x(C_i) = E[Y \mid X = x, C = C_i]\): 결과 모델 예측값 - \(\hat{e}(C_i) = P(X = 1 \mid C = C_i)\): 성향 점수
이 추정량에는 두 가지 “방어선”이 있습니다: - 결과 모델이 올바르면: 성향 점수 부분 기대값이 0이 되어 결과 모델만으로 추정합니다. - 성향 점수 모델이 올바르면: 결과 모델 편향을 성향 점수 부분이 보정합니다.
library(broom)
library(touringplans)
library(dplyr)
library(propensity)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  drop_na()

# 1단계: 성향 점수 모델 적합
ps_model <- glm(
  park_extra_magic_morning ~
    park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9,
  family = binomial()
)

# 2단계: 결과 모델 적합 (G-공식 스타일)
outcome_model <- lm(
  wait_minutes_posted_avg ~
    park_extra_magic_morning *
    (park_ticket_season + park_close + park_temperature_high),
  data = seven_dwarfs_9
)

# 3단계: AIPW 추정량 계산
seven_dwarfs_aipw <- seven_dwarfs_9 |>
  mutate(
    # 성향 점수
    ps = predict(ps_model, type = "response"),

    # 결과 모델: 처치군으로 설정했을 때의 예측값
    mu1 = predict(outcome_model,
                  newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 1)),

    # 결과 모델: 비처치군으로 설정했을 때의 예측값
    mu0 = predict(outcome_model,
                  newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 0)),

    # AIPW 개별 공헌
    aipw_component = (mu1 - mu0) +
      park_extra_magic_morning * (wait_minutes_posted_avg - mu1) / ps -
      (1 - park_extra_magic_morning) * (wait_minutes_posted_avg - mu0) / (1 - ps)
  )

# AIPW ATE 추정치
aipw_ate <- mean(seven_dwarfs_aipw$aipw_component)
cat("AIPW ATE 추정치:", round(aipw_ate, 3), "분\n")
AIPW ATE 추정치: -4.123 분# 비교: 순수 IPTW
iptw_estimate <- seven_dwarfs_9 |>
mutate(
ps = predict(ps_model, type = "response"),
w_ate = wt_ate(ps, park_extra_magic_morning)
) |>
lm(wait_minutes_posted_avg ~ park_extra_magic_morning, data = _, weights = w_ate) |>
tidy() |>
filter(term == "park_extra_magic_morning") |>
pull(estimate)
# 비교: 순수 G-공식
gcomp_estimate <- mean(
predict(outcome_model,
newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 1)) -
predict(outcome_model,
newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 0))
)
cat("\n세 가지 추정량 비교:\n")
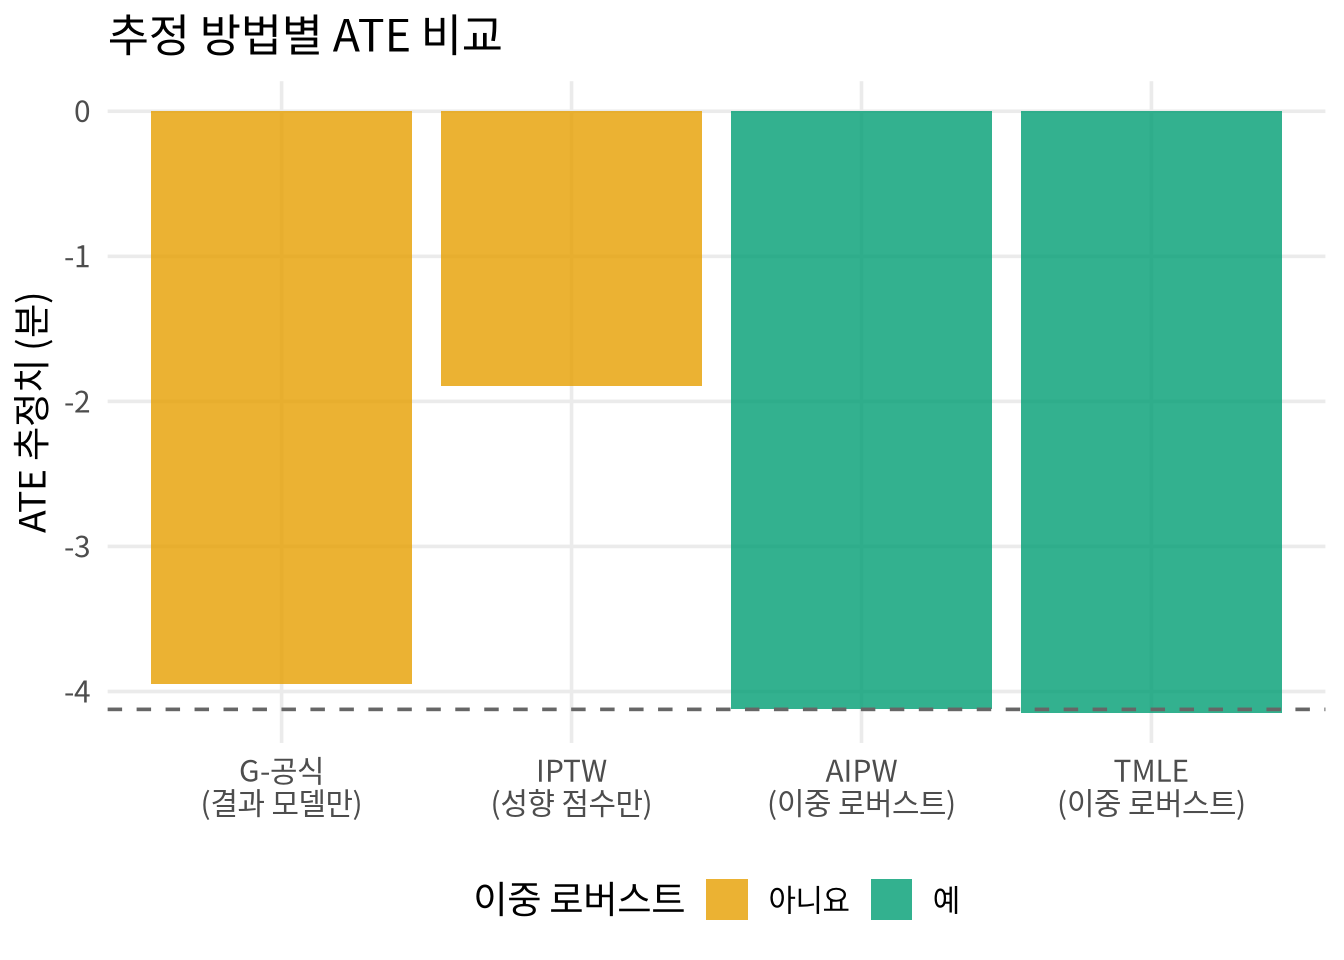
세 가지 추정량 비교: AIPW (이중 로버스트): -4.12 분 IPTW (성향 점수만): -1.9 분 G-공식 (결과 모델만): -3.95 분이중 로버스트 추정량은 두 모델 중 하나만 잘못 명시되어도 편향되지 않습니다:
물론 두 모델이 모두 잘못 명시되면 이중 로버스트 추정량도 편향됩니다.
{DoubleML} 또는 {AIPW} 패키지 사용실무에서는 전용 패키지를 사용하면 편리합니다:
# install.packages("AIPW")
library(AIPW)

aipw_result <- AIPW$new(
  Y = seven_dwarfs_9$wait_minutes_posted_avg,
  A = seven_dwarfs_9$park_extra_magic_morning,
  W = select(seven_dwarfs_9, park_ticket_season, park_close, park_temperature_high),
  Q.SL.library = "SL.glm",  # 결과 모델에 Super Learner 사용 가능
  g.SL.library = "SL.glm",  # 성향 점수에 Super Learner 사용 가능
  k_split = 5,               # 교차 적합(cross-fitting)
  verbose = FALSE
)

aipw_result$fit()
aipw_result$summary()대상 학습(Targeted Learning, TL)은 Laan과 동료들이 개발한 세미파라메트릭 추정 프레임워크로, 사전에 지정된 추정 대상의 통계적 성능을 최적화하는 것이 목표입니다 (laan2006targeted?; laan2011targeted?).
대상 학습의 핵심 알고리즘은 TMLE(Targeted Maximum Likelihood Estimation) 또는 TMLE(Targeted Minimum Loss-based Estimation)입니다.
TMLE는 세 단계로 이루어집니다:
1단계: 초기 추정(Initial estimation) - 결과 모델 \(Q = E[Y \mid X, C]\) 추정 (G-공식 부분) - 성향 점수 \(g = P(X = 1 \mid C)\) 추정
2단계: 목표 업데이트(Targeting/Fluctuation) - 초기 결과 모델을 성향 점수 정보로 “목표” 추정 대상에 맞춰 업데이트합니다. - 이 과정에서 이중 로버스트 성질을 보장합니다.
3단계: 추정치 계산(Substitution) - 업데이트한 모델로 최종 추정치를 계산합니다.
# TMLE 수동 구현 (개념 설명용)
# 실제로는 tmle, tmle3, ltmle 패키지 사용 권장

# 1단계: 초기 추정
# 결과 모델 초기 예측
Q0_1 <- predict(outcome_model,
                newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 1))
Q0_0 <- predict(outcome_model,
                newdata = mutate(seven_dwarfs_9, park_extra_magic_morning = 0))
Q0   <- predict(outcome_model)

# 성향 점수
g1 <- predict(ps_model, type = "response")
g0 <- 1 - g1

# 2단계: 영리한 공변량(clever covariate)으로 업데이트
# 영리한 공변량: 처치군은 1/g(X=1), 비처치군은 -1/g(X=0)
clever_cov <- seven_dwarfs_9$park_extra_magic_morning / g1 -
  (1 - seven_dwarfs_9$park_extra_magic_morning) / g0

# 잔차를 대상으로 영리한 공변량을 활용해 로지스틱 회귀를 수행합니다 (fluctuation)
# 선형 결과이므로 선형 회귀 사용
fluctuation <- lm(
  (seven_dwarfs_9$wait_minutes_posted_avg - Q0) ~ clever_cov - 1
)
epsilon <- coef(fluctuation)["clever_cov"]

# 3단계: 업데이트한 예측값으로 ATE 계산
Q_star_1 <- Q0_1 + epsilon / g1
Q_star_0 <- Q0_0 - epsilon / g0

tmle_ate <- mean(Q_star_1 - Q_star_0)
cat("TMLE ATE 추정치:", round(tmle_ate, 3), "분\n")
TMLE ATE 추정치: -4.147 분{tmle} 패키지를 사용한 TMLE실무에서는 tmle 또는 {tmle3} 패키지를 사용하는 것이 더 편리하고 정확합니다:
# install.packages("tmle")
library(tmle)

# TMLE에서는 머신러닝 알고리즘을 사용하는 Super Learner와 결합하여
# 모델 오명시의 위험을 더욱 줄일 수 있습니다
tmle_fit <- tmle(
  Y = seven_dwarfs_9$wait_minutes_posted_avg,
  A = seven_dwarfs_9$park_extra_magic_morning,
  W = select(seven_dwarfs_9, park_ticket_season, park_close, park_temperature_high),
  family = "gaussian",
  Q.SL.library = c("SL.glm", "SL.ranger"),   # 결과 Super Learner
  g.SL.library = c("SL.glm", "SL.ranger")    # 성향 점수 Super Learner
)

summary(tmle_fit)library(ggplot2)
# 각 추정량의 특성 비교를 위한 시각화
methods_comparison <- tibble(
방법 = c("G-공식\n(결과 모델만)", "IPTW\n(성향 점수만)", "AIPW\n(이중 로버스트)", "TMLE\n(이중 로버스트)"),
이중_로버스트 = c("아니요", "아니요", "예", "예"),
효율성 = c("중간", "낮음", "높음", "가장 높음"),
ATE = c(gcomp_estimate, iptw_estimate, aipw_ate, tmle_ate),
방법_순서 = 1:4
)
ggplot(methods_comparison, aes(x = reorder(방법, 방법_순서), y = ATE,
fill = 이중_로버스트)) +
geom_col(alpha = 0.8) +
geom_hline(yintercept = aipw_ate, linetype = "dashed", color = "grey40") +
scale_fill_manual(values = c("아니요" = "#E69F00", "예" = "#009E73")) +
labs(
x = NULL,
y = "ATE 추정치 (분)",
fill = "이중 로버스트",
title = "추정 방법별 ATE 비교"
)
실무에서는 다음을 고려하세요:
현대 인과 추론 실무에서는 이중 로버스트 방법을 기본으로 사용하고, 단순한 방법들과 결과를 비교하는 것이 좋습니다.