노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
인과 관계를 분석할 때는 우리가 풀고자 하는 인과적 질문을 항상 염두에 두어야 합니다. 인과적 질문은 분석에 필요한 가정뿐 아니라 질문에 답하는 방식까지 안내합니다. 이번 장에서는 인과적 질문의 해답과 밀접하게 연관된 세 개념인 추정 대상(estimand), 추정량(estimator), 추정치(estimate)를 다룹니다. 추정 대상(estimand)은 우리가 알고자 하는 목표이고, 추정량(estimator)은 데이터로 이 대상을 근사하는 방법입니다. 추정치(estimate)는 추정량에 데이터를 대입해 얻은 값입니다. 추정 대상은 굽고 싶은 케이크의 화보 사진, 추정량은 조리법(레시피), 추정치는 오븐에서 갓 꺼낸 실제 케이크에 비유할 수 있습니다.
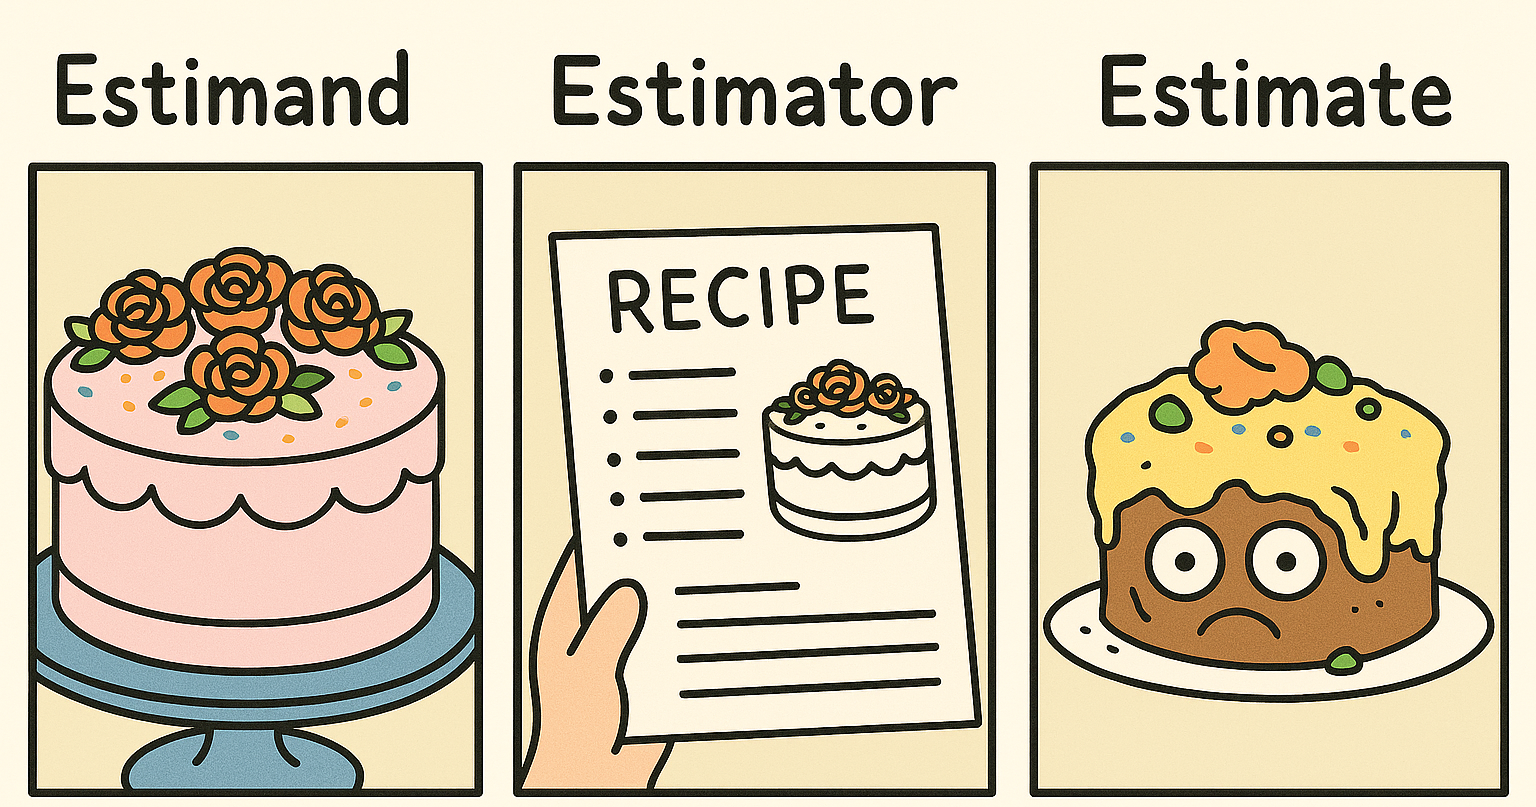
지금까지 우리는 주로 평균 처치 효과(average treatment effect, ATE), 즉 전체 인구에 대한 관심 노출의 평균적인 효과에 집중해 왔습니다. 여기서 추정 대상은 모든 개인에 대한 잠재적 결과 차이의 기댓값입니다:
\[E[Y(1) - Y(0)]\]
우리가 사용하는 추정량은 선택한 방법에 따라 달라집니다. 예를 들어, A/B 테스트나 무작위 대조 시험(RCT)에서 우리의 추정량은 노출 A를 받은 사람들의 평균 결과에서 노출 B를 받은 사람들의 평균 결과를 뺀 값이 될 수 있습니다.
\[\sum_{i=1}^{N}\frac{Y_i\times X_i}{N_{\textrm{A}}} - \frac{Y_i\times (1-X_i)}{N_{\textrm{B}}}\]
여기서 \(X\) 는 노출 A에 대한 지시 변수(\(X=1\) 이면 노출 A, \(X=0\) 이면 노출 B)이고, \(N_A\) 는 그룹 A의 총 인원, \(N_B\) 는 그룹 B의 총 인원이며 \(N_A + N_B = N\) 입니다. 이 예시를 좀 더 구체화해 봅시다. 행동 유도(Call-To-Action, 흔히 CTA로 약칭하며 마케팅 캠페인을 위한 서면 지침)를 위한 두 가지 디자인이 있고, 이들이 사용자의 평균 구매 품목 수에 차이를 만드는지 평가하고 싶다고 가정해 봅시다. 사용자의 일부를 무작위로 배정하여 디자인 A 또는 디자인 B를 보게 하는 A/B 테스트를 만들 수 있습니다. 100명의 참가자에 대한 A/B 테스트 데이터가 ab라는 데이터셋에 있다고 가정해 봅시다. 다음은 그러한 데이터셋을 시뮬레이션하는 코드입니다.
여기서 노출은 x이고 결과는 y입니다. 실제 평균 처치 효과는 1이며, 이는 평균적으로 행동 유도 디자인 A를 보는 것이 구매 품목 수를 1만큼 증가시킨다는 것을 의미합니다.
ab# A tibble: 100 × 2
x y
<int> <dbl>
1 0 -0.280
2 1 1.87
3 1 1.36
4 0 -0.208
5 0 1.13
6 1 0.352
7 1 -0.148
8 1 2.08
9 0 2.09
10 0 -1.41
# ℹ 90 more rows아래는 R에서 이를 추정하는 두 가지 방법입니다. 공식(formula) 접근법을 사용하여, 첫 번째 예시에서는 노출 값에 따른 y의 차이를 계산합니다.
# A tibble: 1 × 3
    n_a   n_b estimate
  <int> <dbl>    <dbl>
1    54    46     1.15
또는, x로 group_by()하고 각 그룹에 대해 y의 평균을 summarize()한 다음, 결과를 피벗(pivot)하여 그 차이를 구할 수도 있습니다.
ab |>
  group_by(x) |>
  summarize(avg_y = mean(y)) |>
  pivot_wider(
    names_from = x,
    values_from = avg_y,
    names_prefix = "x_"
  ) |>
  summarize(estimate = x_1 - x_0)
# A tibble: 1 × 1
estimate
<dbl>
1 1.15노출인 \(X\) 가 무작위로 배정되었기 때문에, 이 추정량은 우리가 관심 있는 추정 대상에 대한 편향되지 않은 추정치를 제공합니다.
그렇다면 편향되지 않았다(unbiased)는 것은 무엇을 의미할까요? “진정한” 인과 효과는 1이지만, 이 추정치는 정확히 1이 아니라 1.149임을 알 수 있습니다. 왜 차이가 날까요? 이 A/B 테스트는 전체 인구가 아닌 100명의 참가자 샘플을 포함했기 때문입니다. 샘플 크기가 커질수록 우리의 추정치는 진실에 더 가까워질 것입니다. 한번 시도해 봅시다. 데이터를 다시 시뮬레이션하되 샘플 크기를 100에서 100,000으로 늘려보겠습니다:
# A tibble: 1 × 3
    n_a   n_b estimate
  <int> <dbl>    <dbl>
1 49918 50082     1.01
추정치가 1.01로, 실제 평균 처치 효과인 1에 훨씬 더 가까워진 것을 확인하십시오.
만약 \(X\) 가 무작위로 배정되지 않았다고 가정해 봅시다. 그럴 경우, 우리는 노출 전 공변량(pre-exposure covariates)을 사용하여 \(X\) 의 조건부 확률(성향 점수)을 추정하고, 이 확률을 가중치 \((w_i)\) 에 통합하여 인과 효과를 추정할 수 있습니다. 우리는 가중치가 없는 추정량을 확장하여 가중 평균을 사용함으로써 우리의 평균 처치 효과 추정 대상을 추정할 수 있습니다. 이러한 버전의 역확률 가중치 부여는 때때로 Hajek 추정량(Hajek estimator)이라고 불립니다. 우리는 결과 모델을 위해 회귀를 사용하는 데 집중하겠지만, 가중치가 없는 추정량의 이 간단한 확장은 우리가 서로 다른 추정 대상에 적응하기 위해 추정량을 어떻게 수정할 수 있는지 보여줍니다.
\[\frac{\sum_{i=1}^NY_i\times X_i\times w_i}{\sum_{i=1}^NX_i\times w_i}-\frac{\sum_{i=1}^NY_i\times(1-X_i)\times w_i}{\sum_{i=1}^N(1-X_i)\times w_i}\]
연구의 목표나 인과적 질문에 따라 우리는 서로 다른 추정 대상을 추정하고 싶을 수 있습니다. 여기서는 가장 일반적인 인과 추정 대상들과 그들의 대상 인구, 그들이 답하는 데 도움이 될 수 있는 인과적 질문들, 그리고 이를 추정하기 위해 사용되는 방법들을 개괄할 것입니다 (Greifer 와/과 Stuart 2021).
흔히 쓰이는 추정 대상은 평균 처치 효과(average treatment effect, ATE)입니다. 대상 인구(target population)는 관심 있는 전체 표본 또는 인구 집단입니다. 여기서 추정 대상은 모든 개인에 대한 잠재적 결과 차이의 기댓값입니다:
\[E[Y(1) - Y(0)]\]
예를 들어 “특정 정책을 모든 대상 환자에게 적용해야 하는가?”와 같은 연구 질문이 이에 해당합니다 (Greifer 와/과 Stuart 2021).
대부분의 무작위 대조 시험은 ATE를 목표 추정 대상으로 설계됩니다. 앞서 ab 데이터에 적용했던 추정량은 이 경우 잘 작동할 것입니다. 우리는 또한 매칭(matching)과 가중치 부여(weighting)라는 다른 두 가지 유형의 추정량도 보았습니다. 비무작위 설정에서 여러분은 전체 매칭(full matching)을 사용하여 ATE를 추정할 수 있습니다. 노출군의 각 관측치는 대조군의 적어도 하나의 관측치와 (그 반대의 경우도 마찬가지로) 복원 없이 매칭됩니다. 매칭을 이용한 추정 대상에 대해서는 sec-matching-estimands에서 더 자세히 논의하겠습니다. 또는 다음과 같은 역확률 가중치를 사용하여 성향 점수 가중치 부여 방식으로 ATE를 추정할 수 있습니다.
\[w_{ATE} = \frac{X}{p} + \frac{(1 - X)}{1 - p}\]
다시 말해, 가중치는 노출군에 속한 사람들에게는 성향 점수의 역수(1/p)이고, 대조군에게는 (1 - 성향 점수)의 역수(1/(1-p))입니다. 직관적으로 이 가중치는 여러분이 실제로 속했던 그룹에 속할 확률의 역수와 같습니다. 매칭과 가중치 부여 모두에서, 추정량에는 sec-outcome-model에서 할 것처럼 결과 모델을 적합시키는 과정이 포함된다는 점에 유의하십시오. 즉, 성향 점수에 기반한 매칭이나 가중치 부여는 ATE 추정의 첫 번째 단계일 뿐입니다. 매칭되거나 가중치가 부여된 데이터를 결과 모델에서 사용해야만 비로소 ATE의 추정치가 생성됩니다.
Touring Plans 데이터를 사용하여 이 인과 추정 대상을 더 깊이 파헤쳐 봅시다. sec-using-ps에서 우리는 아침에 “엑스트라 매직 아워”가 있었는지 여부와 같은 날 오전 9시에서 10시 사이의 “세븐 드워프 마인 트레인” 평균 대기 시간 사이의 관계를 조사했었습니다. 우리의 데이터셋인 seven_dwarfs를 다시 구성하고 이전에 명시했던 것과 동일한 성향 점수 모델을 적합시켜 봅시다.
library(broom)
library(touringplans)

seven_dwarfs <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  mutate(park_extra_magic_morning = factor(
    park_extra_magic_morning,
    labels = c("Magic Hours 없음", "엑스트라 매직 아워")
  ))

seven_dwarfs_with_ps <- glm(
  park_extra_magic_morning ~ park_ticket_season + park_close +
    park_temperature_high,
  data = seven_dwarfs,
  family = binomial()
) |>
  augment(type.predict = "response", data = seven_dwarfs)
이 데이터 프레임에서 관심 있는 변수들의 표를 살펴봅시다. 이를 위해 gtsummary 패키지의 tbl_summary() 함수를 사용할 것입니다. (또한 표의 변수 이름을 정리하기 위해 labelled 패키지도 사용할 것입니다.)
library(gtsummary)
library(labelled)
seven_dwarfs_with_ps <- seven_dwarfs_with_ps |>
  set_variable_labels(
    park_ticket_season = "티켓 시즌",
    park_close = "폐쇄 시간",
    park_temperature_high = "과거 최고 기온"
  )

tbl_summary(
  seven_dwarfs_with_ps,
  by = park_extra_magic_morning,
  include = c(park_ticket_season, park_close, park_temperature_high)
) |>
  # 표에 전체(overall) 열을 추가합니다
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 2941 |
엑스트라 매직 아워 N = 601 |
Overall N = 3541 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 60 (20%) | 18 (30%) | 78 (22%) |
| regular | 158 (54%) | 35 (58%) | 193 (55%) |
| value | 76 (26%) | 7 (12%) | 83 (23%) |
| 폐쇄 시간 | |||
| 16:30:00 | 1 (0.3%) | 0 (0%) | 1 (0.3%) |
| 18:00:00 | 37 (13%) | 18 (30%) | 55 (16%) |
| 20:00:00 | 18 (6.1%) | 2 (3.3%) | 20 (5.6%) |
| 21:00:00 | 28 (9.5%) | 0 (0%) | 28 (7.9%) |
| 22:00:00 | 91 (31%) | 11 (18%) | 102 (29%) |
| 23:00:00 | 78 (27%) | 11 (18%) | 89 (25%) |
| 24:00:00 | 40 (14%) | 17 (28%) | 57 (16%) |
| 25:00:00 | 1 (0.3%) | 1 (1.7%) | 2 (0.6%) |
| 과거 최고 기온 | 84 (78, 89) | 83 (76, 87) | 84 (78, 89) |
| 1 n (%); Median (Q1, Q3) | |||
표 10.1 를 보면, 294일은 아침에 엑스트라 매직 아워가 없었고, 60일은 있었습니다. 또한 엑스트라 매직 아워가 있었던 날의 30%가 성수기였던 반면, 그렇지 않았던 날은 20%가 성수기였습니다. 게다가 엑스트라 매직 아워가 있는 날은 그렇지 않은 날에 비해 오후 6시(18:00:00)에 폐쇄될 확률이 더 높았습니다. 엑스트라 매직 아워가 있는 날의 최고 기온 중앙값은 83도로, 그렇지 않은 날보다 약간 낮았습니다.
이제 ATE를 추정하기 위해 성향 점수 가중치를 구성해 봅시다. sec-ps에서 보았듯이, propensity 패키지는 가중치를 추정하기 위한 헬퍼 함수들을 가지고 있습니다. wt_ate() 함수가 우리를 위해 ATE 가중치를 계산해 줄 것입니다.
library(propensity)
seven_dwarfs_wts <- seven_dwarfs_with_ps |>
  mutate(w_ate = wt_ate(.fitted, park_extra_magic_morning))
이 가중치들의 분포를 살펴봅시다.
ggplot(seven_dwarfs_wts, aes(x = w_ate)) +
  geom_histogram(bins = 50)
Warning in vec_ptype2.psw.double(x = x, y = y, x_arg = x_arg, y_arg = y_arg, : Converting psw to numeric
ℹ Class-specific attributes and metadata have been
dropped
ℹ Use explicit casting to numeric to avoid this
warning
Converting psw to numeric
ℹ Class-specific attributes and metadata have been
dropped
ℹ Use explicit casting to numeric to avoid this
warning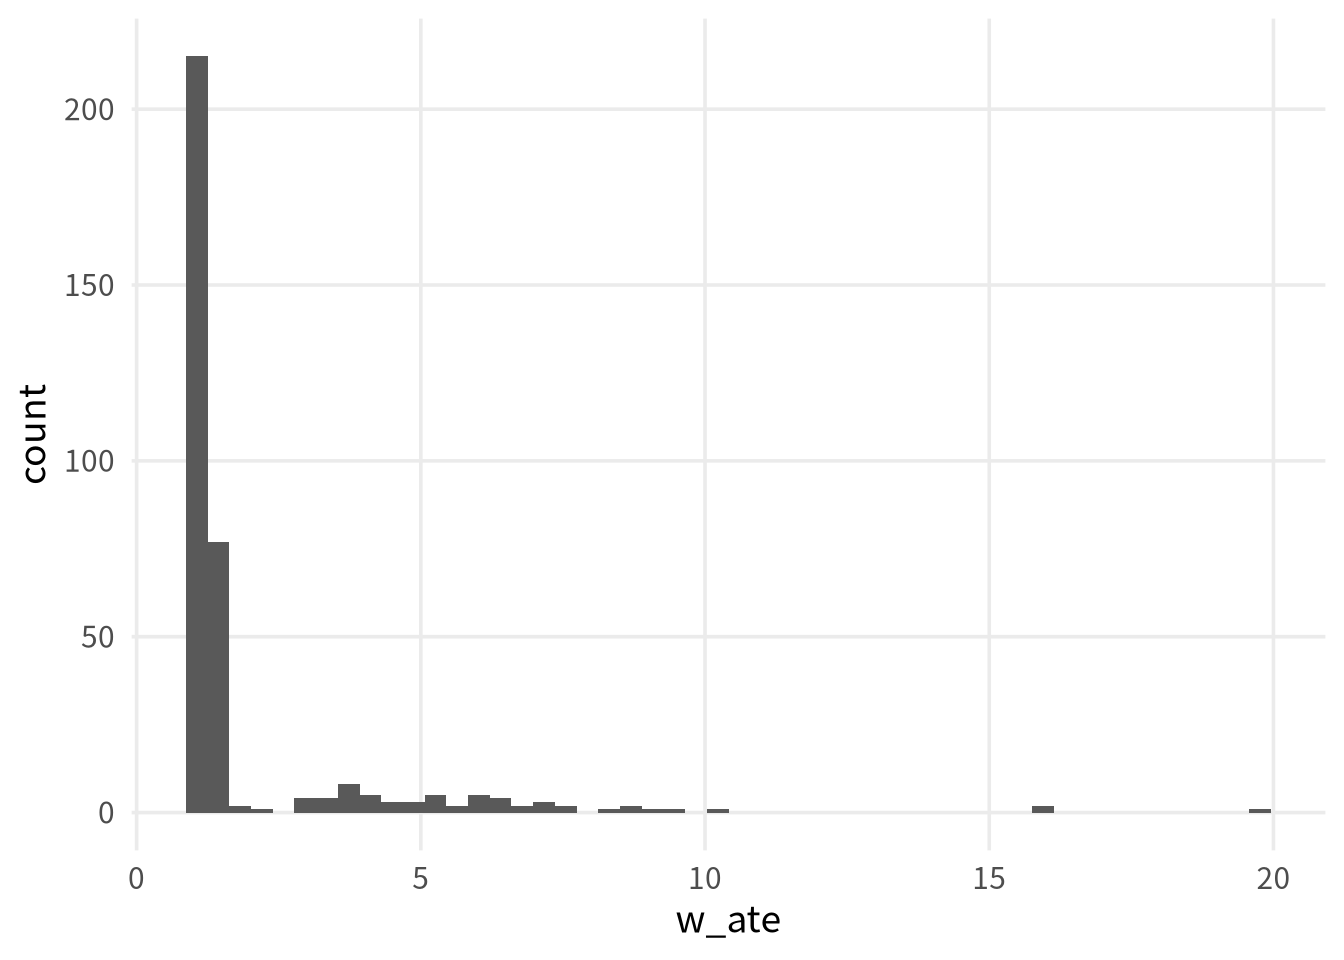
그림 fig-sd-ate-hist에서 많은 가중치가 1(ATE 가중치가 가질 수 있는 가장 작은 값)에 가깝고, 가장 큰 가중치(약 24)까지 긴 꼬리가 이어져 있습니다. 이 분포는 ATE 가중치의 잠재적인 문제를 부각시킵니다. 가중치의 범위가 1부터 무한대까지이기 때문에, 작은 표본에서 가중치가 너무 크면 추정치에 편향이 생길 수 있습니다(유한 표본 편향, finite sample bias). 우리는 sec-ps에서 이러한 가중치들이 추정치의 분산을 불안정하게 만들 수 있으며, 이는 안정화를 통해 개선될 수 있음을 보았습니다. 그러나 ATE 가중치는 유한 표본 편향의 문제도 겪고 있으며, 이는 안정화로 해결할 수 없습니다.
우리는 교란 요인을 고려하지 않는 것이 인과 추정치를 편향시킬 수 있다는 것을 알고 있지만, 모든 교란 요인을 고려한 후에도 유한 표본에서는 여전히 편향된 추정치를 얻을 수 있습니다. 통계학에서 우리가 내세우는 많은 속성들은 대표본(large samples)에 의존하지만, 얼마나 “큰지”에 대한 정의는 모호할 수 있습니다. 간단한 시뮬레이션을 살펴봅시다. 여기 노출 \(X\) , 결과 \(Y\) , 그리고 하나의 교란 요인 \(Z\) 가 있습니다. 우리는 \(Z\) 에만 의존하는 \(Y\) (따라서 실제 처치 효과는 0임)와 역시 \(Z\) 에 의존하는 \(X\) 를 시뮬레이션할 것입니다.
만약 우리가 하나의 교란 요인 \(Z\) 를 사용하여 성향 점수 모델을 적합시키고 가중 추정량을 계산한다면, 편향되지 않은 결과(이 경우 0)를 얻어야 합니다.
## 성향 점수 모델 적합
finite_sample_wts <- glm(
x ~ z,
data = finite_sample,
family = binomial("probit")
) |>
augment(data = finite_sample, type.predict = "response") |>
mutate(wts = wt_ate(.fitted, x))
finite_sample_wts |>
summarize(
effect = sum(y * x * wts) / sum(x * wts) -
sum(y * (1 - x) * wts) / sum((1 - x) * wts)
)# A tibble: 1 × 1
effect
<dbl>
1 0.197결과가 0에서 꽤 떨어져 있지만, 이것이 편향인지 아니면 단지 이 시뮬레이션된 표본에서 우연히 관찰되는 것인지 알기는 어렵습니다. 유한 표본 편향의 가능성을 탐구하기 위해 서로 다른 샘플 크기에서 이 시뮬레이션을 여러 번 재실행하고 그 결과를 그래프로 그려봅시다.
sim <- function(n) {
## 시뮬레이션 데이터셋 생성
finite_sample <- tibble(
z = rnorm(n),
x = case_when(
0.5 + z + rnorm(n) > 0 ~ 1,
TRUE ~ 0
),
y = z + rnorm(n)
)
finite_sample_wts <- glm(
x ~ z,
data = finite_sample,
family = binomial("probit")
) |>
augment(data = finite_sample, type.predict = "response") |>
mutate(wts = wt_ate(.fitted, x))
bias <- finite_sample_wts |>
summarize(
effect = sum(y * x * wts) / sum(x * wts) -
sum(y * (1 - x) * wts) / sum((1 - x) * wts)
) |>
pull()
tibble(
n = n,
bias = bias
)
}
## 5가지 다른 샘플 크기를 검토하고, 각각 1000번씩 시뮬레이션
set.seed(1)
finite_sample_sims <- map_df(
rep(
c(50, 100, 500, 1000, 5000, 10000),
each = 1000
),
sim
)
bias <- finite_sample_sims |>
group_by(n) |>
summarize(bias = mean(bias))
ggplot(bias, aes(x = n, y = bias)) +
geom_point() +
geom_line() +
geom_hline(yintercept = 0, lty = 2)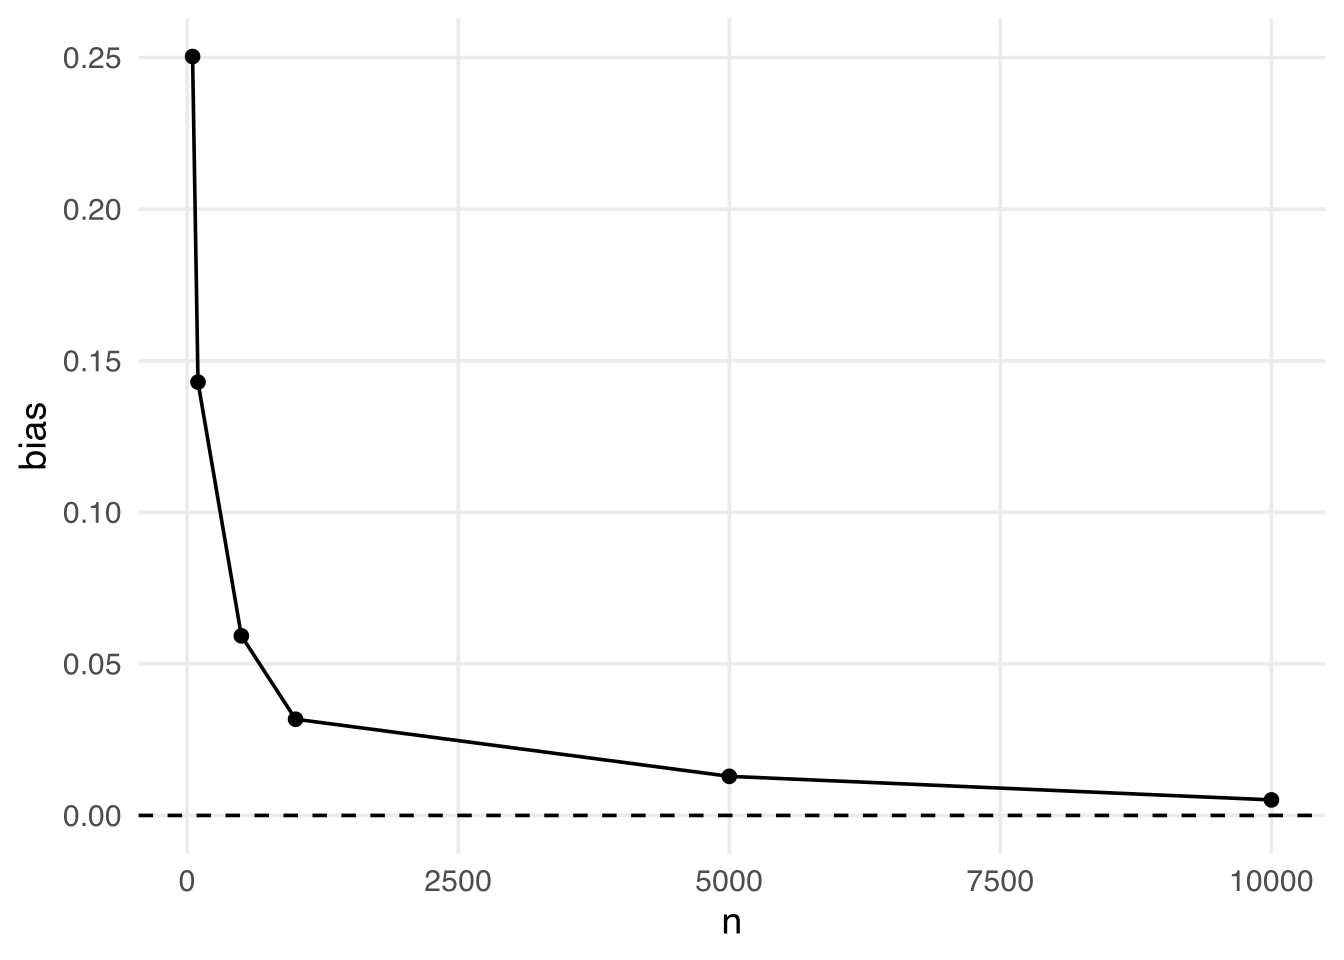
표본 크기가 클 때조차(5,000명), 우리는 여전히 “진정한” 효과인 0에서 벗어난 약간의 편향을 보게 됩니다. 표본 크기가 10,000보다 커져야 비로소 이 편향이 사라지는 것을 볼 수 있습니다.
경계가 없는(unbounded) 가중치(즉, 이론적으로 무한히 커질 수 있는 가중치)를 사용하는 추정 대상은 유한 표본 편향을 겪을 가능성이 더 높습니다. 유한 표본 편향에 빠질 가능성은 다음에 달려 있습니다: (1) 여러분이 선택한 추정 대상 (즉, 가중치에 경계가 있는가?) (2) 노출군과 비노출군에서의 공변량 분포 (즉, 중첩이 잘 되어 있는가? 중첩이 좋지 않은 경우 발생하는 잠재적인 긍정성 위배 영역은 가중치가 너무 커질 수 있는 영역입니다) (3) 표본 크기.
역확률 가중치 부여는 (바라건대) 관측치들이 교란 요인들에 대해 균형을 이루는 가상 인구(pseudo-population)를 생성합니다. 이 가상 인구는 원래의 표본 인구와 다르며, (진단 및 의사소통 목적으로) 그 차이를 이해하는 것이 도움이 됩니다. gtsummary 패키지는 가중치가 적용된 표를 생성할 수 있게 해주며, 이는 가중치에 의해 생성된 가상 인구에 대한 직관을 얻는 데 도움을 줍니다. 먼저, survey 패키지를 불러오고 설문 조사 설계 객체(survey design object)를 생성해야 합니다. survey 패키지는 가중치를 사용하여 통계량과 모델을 계산하는 기능을 지원합니다. 역사적으로 많은 연구자들이 설문 조사 분석에 가중치를 통합하는 기술들을 적용해 왔습니다. 비록 우리가 설문 조사 분석을 하고 있는 것은 아니지만, 동일한 기술들이 우리의 성향 점수 가중치에도 유용하게 쓰입니다.
library(survey)
library(halfmoon)
hdr <- paste0(
"**{level}** \n",
"N = {n_unweighted}; ESS = {format(n, digits = 1, nsmall = 1)}"
)
seven_dwarfs_svy <- svydesign(
# ~1은 설문 조사가 클러스터링된 데이터가 아님을 survey에 알려줍니다
ids = ~1,
data = seven_dwarfs_wts,
weights = ~w_ate
)
tbl_svysummary(
seven_dwarfs_svy,
by = park_extra_magic_morning,
include = c(park_ticket_season, park_close, park_temperature_high)
) |>
# 그룹별 *유효 표본 크기(effective sample size)*를 제공합니다
add_ess_header(header = hdr) |>
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 294; ESS = 291.31 |
엑스트라 매직 아워 N = 60; ESS = 46.71 |
Overall N = 7111 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 78 (22%) | 81 (23%) | 160 (22%) |
| regular | 193 (54%) | 187 (52%) | 380 (53%) |
| value | 83 (23%) | 89 (25%) | 172 (24%) |
| 폐쇄 시간 | |||
| 16:30:00 | 2 (0.4%) | 0 (0%) | 2 (0.2%) |
| 18:00:00 | 50 (14%) | 72 (20%) | 122 (17%) |
| 20:00:00 | 20 (5.6%) | 19 (5.3%) | 39 (5.5%) |
| 21:00:00 | 31 (8.7%) | 0 (0%) | 31 (4.3%) |
| 22:00:00 | 108 (30%) | 86 (24%) | 193 (27%) |
| 23:00:00 | 95 (27%) | 81 (23%) | 176 (25%) |
| 24:00:00 | 48 (14%) | 94 (26%) | 142 (20%) |
| 25:00:00 | 1 (0.3%) | 6 (1.6%) | 7 (1.0%) |
| 과거 최고 기온 | 84 (78, 89) | 83 (78, 87) | 84 (78, 88) |
| 1 n (%); Median (Q1, Q3) | |||
| Abbreviation: ESS = Effective Sample Size | |||
표 10.2 에서 변수들이 그룹 간에 더 균형을 이루고 있음을 확인하십시오. 예를 들어, 표 10.1 에서 park_ticket_season 변수를 보면, 아침에 엑스트라 매직 아워가 있었던 날 중 성수기(peak season)였던 날의 비율(30%)이 엑스트라 매직 아워가 없었던 날의 비율(23%)보다 높았습니다. 표 10.2 에서는 이것이 균형을 이루어, 엑스트라 매직 아워 그룹과 그렇지 않은 그룹 모두에서 성수기의 가중 비율이 22%가 되었습니다. 가중치는 각 관측치에 가중치를 부여함으로써 두 그룹이 균형 잡힌 것처럼 보이도록 변수의 분포를 변화시킵니다. 또한, 표 10.2 의 변수 분포가 이제 표 10.1 의 전체(Overall) 열과 일치한다는 점에 주목하십시오. ATE 가중치는 정확히 이 역할을 수행합니다: 각 노출군에 대해 성향 점수에 포함된 변수들의 분포가 전체 샘플의 분포와 일치하도록 만듭니다.
ATE 가중치에 의해 생성된 가상 인구를 이해하는 데 도움이 되는 또 다른 시각화 방법인 대칭 히스토그램(mirrored histogram)을 살펴봅시다. 그래프의 윗부분에는 노출군(아침에 엑스트라 매직 아워가 있었던 날)의 성향 점수 분포를 그리고, 그 아래에는 비노출군의 성향 점수 분포를 대칭으로 그릴 것입니다. 이 시각화를 통해 두 분포를 빠르게 비교할 수 있습니다. 그런 다음 가중치가 포함되었을 때 이러한 분포가 어떻게 달라지는지 보여주기 위해 가중치가 적용된 히스토그램을 겹쳐서 그릴 것입니다. sec-eval-ps-model에서 보았듯이, halfmoon 패키지는 이 시각화를 돕는 geom_mirror_histogram() 함수를 포함하고 있습니다.
library(halfmoon)
ggplot(seven_dwarfs_wts, aes(.fitted, group = park_extra_magic_morning)) +
geom_mirror_histogram(bins = 50) +
geom_mirror_histogram(
aes(fill = park_extra_magic_morning, weight = w_ate),
bins = 50,
alpha = 0.5
) +
scale_y_continuous(labels = abs) +
labs(
x = "성향 점수",
fill = "엑스트라 매직 아워"
)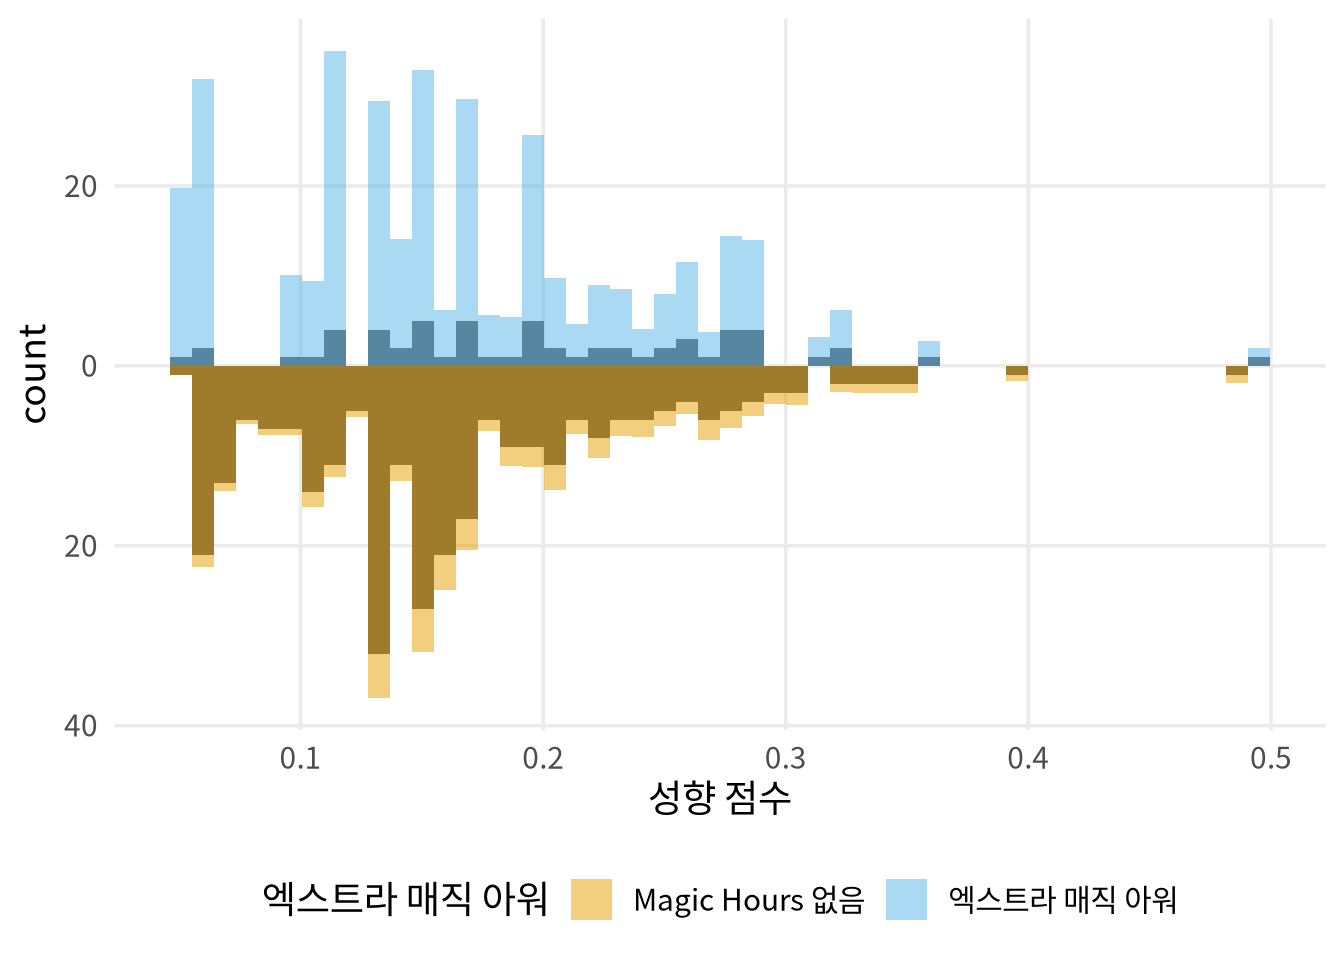
그림 fig-sd-mirror-hist-ate로부터 몇 가지 사실을 알 수 있습니다. 첫째, 실제 관찰된 인구 집단에는 노출된 날보다 노출되지 않은 날(아침에 엑스트라 매직 아워가 없었던 날)이 더 많습니다. 이런 이유로 관찰된 샘플에서의 분포를 보여주는 더 어두운 히스토그램을 통해 확인할 수 있습니다. 마찬가지로, 노출된 날들이 상당히 더 많이 가중되었음을 위쪽의 밝은 파란색 영역을 통해 알 수 있습니다. 또한 가중치를 적용한 후 두 분포가 비슷해 보임을 알 수 있습니다. 위쪽의 파란색 가중 분포의 모양이 아래쪽의 주황색 가중 분포의 모양과 유사합니다.
우리의 추정 대상은 다음과 같음을 기억하십시오:
\[E[Y(1) - Y(0)]\]
데이터를 사용하여 잠재적 결과의 평균을 추정하려면, 섹션 3.3 에서 논의한 세 가지 인과적 가정인 교환 가능성, 긍정성, 그리고 일관성을 충족해야 합니다. 이 추정 대상은 또한 우리가 데이터의 어느 부분에 대해 이러한 가정들을 세워야 하는지도 알려줍니다. ATE는 전체 인구를 목표로 하는 추정 대상입니다. 따라서 우리는 처치 값의 전체 범위에 걸쳐 이러한 가정들을 충족해야 합니다. 즉, 처치받지 않은 그룹의 반사실적 상황을 추정하기 위해 처치받은 그룹을 사용해야 하고, 처치받은 그룹의 반사실적 상황을 추정하기 위해 처치받지 않은 그룹을 사용해야 합니다. 두 집단 모두로부터 정보를 빌려와야 하기 때문에, 긍정성 가정의 한 측면은 노출될 확률이 0보다 크고 1보다 작아야 한다는 것입니다: \(0<p<1\).
우리가 본 또 다른 추정 대상 — MatchIt의 기본 추정 대상이기도 한 — 은 처치받은 집단에서의 평균 처치 효과(average treatment effect among the treated, ATT)입니다. ATT의 대상 인구는 노출된(처치받은) 인구 집단입니다. 이 인과 추정 대상은 노출군에 속한 사람들에 대해 조건부화합니다:
\[E[Y(1) - Y(0) | X = 1]\]
ATT가 관심 대상이 되는 연구 질문의 예는 “현재 마케팅 캠페인을 받고 있는 사람들에게 캠페인을 중단해야 하는가?” 또는 “현재 처치를 받고 있는 환자들에게 의료진이 처치 권장을 중단해야 하는가?” 등이 있습니다 (Greifer 와/과 Stuart 2021).
ATT는 매칭을 할 때 흔히 사용되는 목표 추정 대상입니다. 여기서는 모든 노출된 관측치들이 포함되고 대조군 관측치와 매칭되며, 대조군의 일부 관측치는 버려질 수 있습니다. 대안적으로, 우리는 가중치 부여를 통해 ATT를 추정할 수 있습니다. ATT 가중치는 다음과 같이 추정됩니다:
\[w_{ATT} = X + \frac{(1-X)p}{1-p}\]
다시 말해, 처치받은 집단은 1의 가중치를 받고, 처치받지 않은 집단은 처치받을 오즈(odds)와 동일한 가중치를 받습니다. 왜 이 가중치들이 해당 인구 집단을 대상으로 작동할까요? 이 가중치들을 쓰는 다른 방법은 ATE 가중치의 변환으로 보는 것입니다. ATE와 ATT 가중치는 오직 분자만 다릅니다. 가중치의 분자는 때때로 틸팅 함수(tilting functions)라고 불립니다. ATE 가중치의 틸팅 함수는 1이고, ATT의 틸팅 함수는 처치받을 확률(성향 점수)입니다. 만약 ATE 가중치에 1을 곱하면 아무것도 변하지 않으며, 우리는 여전히 전체 인구를 다루게 됩니다. 만약 ATE 가중치에 처치 확률을 곱하면, 가중치의 척도가 조정되어 이제 처치받은 집단을 목표로 하게 됩니다.
\[ \begin{aligned} w_i^{\mathrm{ATE}} &= \begin{cases} \dfrac{1}{p}, & X_i = 1,\\[8pt] \dfrac{1}{1 - p}, & X_i = 0, \end{cases} \quad \Bigl(tilt_{\rm ATE}(p)=1\Bigr) \\[1em] w_i^{\mathrm{ATT}} &= \begin{cases} \dfrac{p}{p} = 1, & X_i = 1,\\[6pt] \dfrac{p}{1 - p}, & X_i = 0, \end{cases} \quad \Bigl(tilt_{\rm ATT}(p)=p\Bigr) \end{aligned} \]
틸팅 함수는 우리가 가중치를 어떻게 수정하여 특정 인구 집단을 목표로 삼는지, 그리고 가중치가 어떻게 거동하는지 이해하는 데 도움을 줍니다. 예를 들어 ATE의 경우, 틸팅 함수는 대상 인구를 있는 그대로(전체 인구) 유지하며, 그림 10.5 에서 보듯이 가중치는 무한대로 발산할 수 있습니다(처치받은 집단은 왼쪽으로, 처치받지 않은 집단은 오른쪽으로 갈수록).
ps <- seq(0.01, 0.99, by = 0.01)
df <- tibble(ps = ps) |>
mutate(
h_ate = 1,
h_att = ps,
h_atc = 1 - ps,
h_ato = ps * (1 - ps),
h_atm = pmin(ps, 1 - ps),
w0_att = h_att / (1 - ps),
w1_atc = h_atc / ps,
w0_atc = h_atc / (1 - ps),
w1_ato = h_ato / ps,
w0_ato = h_ato / (1 - ps),
w1_atm = h_atm / ps,
w0_atm = h_atm / (1 - ps)
)
plot_df <- bind_rows(
df |> select(ps, starts_with("h_")) |>
pivot_longer(
-ps,
names_to = "estimand",
names_prefix = "h_",
values_to = "value"
) |>
mutate(panel = "틸팅 함수"),
df |>
select(ps, starts_with("w0_")) |>
pivot_longer(
-ps,
names_to = "estimand",
names_prefix = "w0_",
values_to = "value"
) |>
mutate(panel = "가중치 (처치받지 않은 집단)"),
df |>
select(ps, starts_with("w1_")) |>
pivot_longer(
-ps,
names_to = "estimand",
names_prefix = "w1_",
values_to = "value"
) |>
mutate(panel = "가중치 (처치받은 집단)")
) |>
mutate(
panel = factor(
panel,
levels = c("틸팅 함수", "가중치 (처치받지 않은 집단)", "가중치 (처치받은 집단)"),
)
)
plot_weight_properties <- function(plot_df, estimand_type) {
plot_df |>
filter(estimand == estimand_type) |>
ggplot(aes(ps, value)) +
geom_line() +
facet_wrap(~panel, ncol = 1, scales = "free_y") +
labs(
x = "성향 점수",
y = NULL
) +
expand_limits(y = c(0, 1))
}
plot_weight_properties(plot_df, "ate")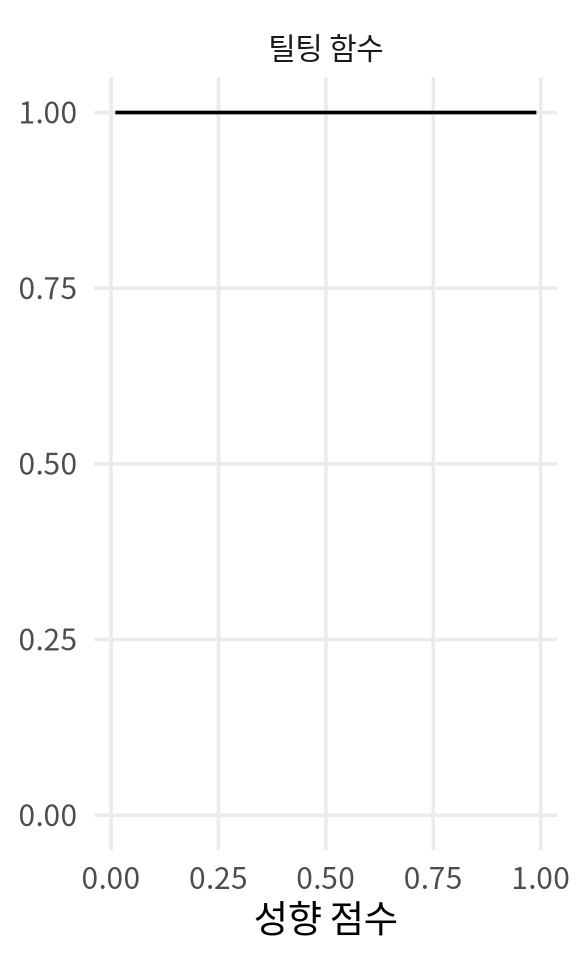
ATT의 경우, 틸팅 함수는 인구 집단을 처치받은 집단과 더 비슷하게 만들려고 노력합니다. 처치받지 않은 집단은 처치받을 오즈(odds)인 가중치를 갖게 되는데, 이는 ATE와 마찬가지로 0에서 무한대까지의 범위를 갖습니다. 하지만 처치받은 집단은 이미 처치받은 집단과 같으므로 1의 가중치를 갖습니다 (그림 10.6).
plot_weight_properties(plot_df, "att")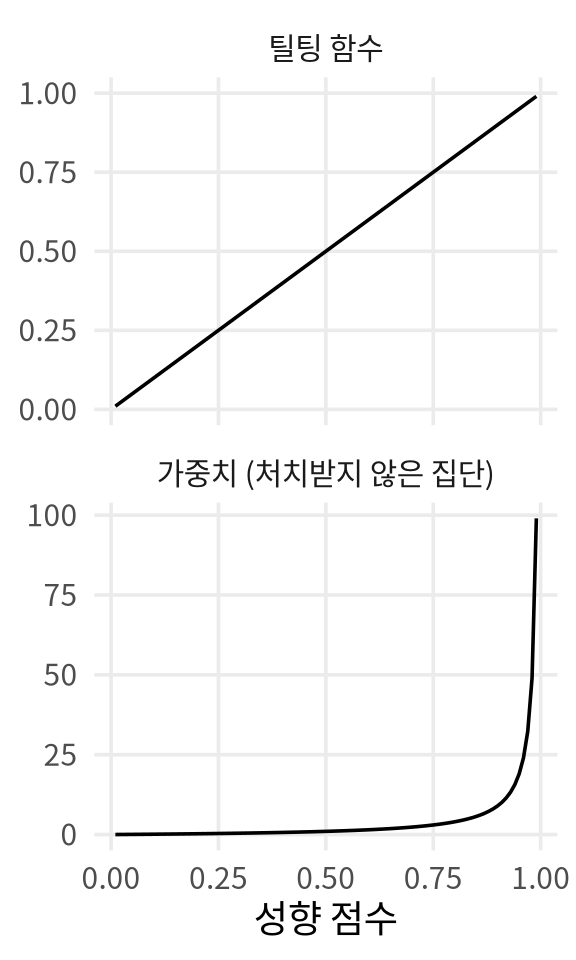
seven_dwarfs_wts 데이터 프레임에 ATT 가중치를 추가하고 그 분포를 살펴봅시다.
Warning in vec_ptype2.psw.double(x = x, y = y, x_arg = x_arg, y_arg = y_arg, : Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning
Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning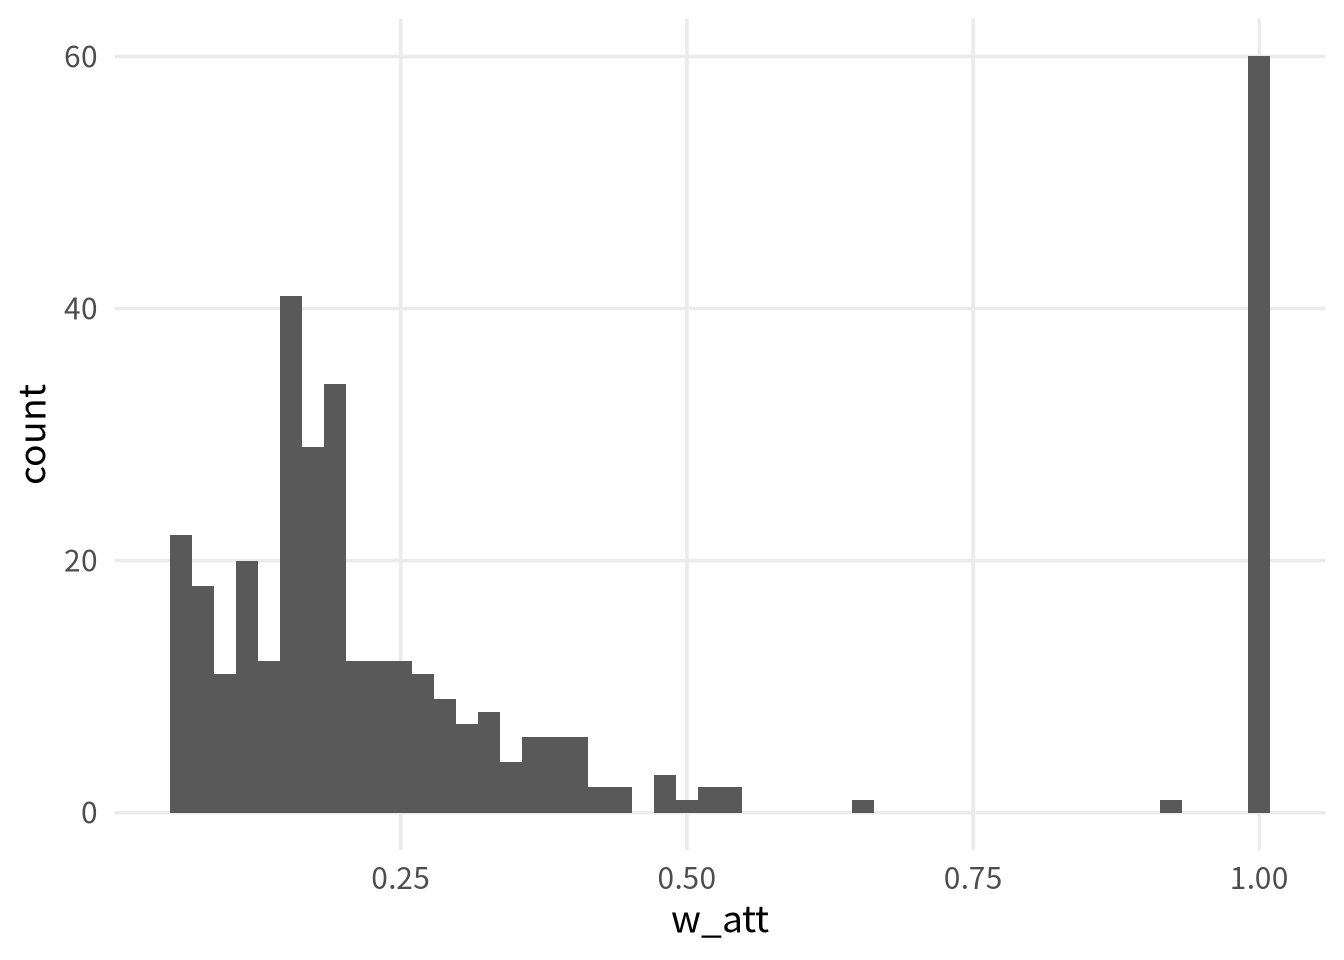
ATE 가중치와 비교했을 때, 그림 10.7 의 가중치는 더 안정적으로 보입니다. 분포가 심하게 치우쳐 있지 않고 범위가 0에서 1을 약간 넘는 수준으로 작으며, 많은 가중치가 정확히 1에 몰려 있습니다. 이 가중치들은 노출군에 속한 모든 날에 대해 정확히 1입니다. 이론적으로 이 가중치들은 비노출군에 대해 0에서 무한대까지의 범위를 가질 수 있습니다. 그러나 우리는 ATT 및 그와 유사한 가중치들에서 더 안정적인 가중치를 보게 되는 경향이 있습니다. 이 특정 샘플은 노출된 날보다 노출되지 않은 날이 훨씬 더 많기 때문에 가중치 범위가 훨씬 작으며, 이는 대다수의 노출되지 않은 날들이 노출된 날들의 변수 분포와 일치하도록 하향 가중(downweighted)되었음을 의미합니다. 이러한 안정성은 직관적으로 예상할 수 있는 것이기도 합니다: 처치받지 않은 그룹의 가중치는 처치받을 오즈입니다. 이 가중치가 매우 높아지려면 처치받을 오즈 또한 매우 높아야 하는데, 물론 처치받지 않은 집단에서 그런 일은 훨씬 드물게 발생합니다. 우리가 만든 가상 인구를 더 명확히 이해하기 위해 가중치가 적용된 표를 살펴봅시다.
seven_dwarfs_svy <- svydesign(
ids = ~1,
data = seven_dwarfs_wts,
weights = ~w_att
)
tbl_svysummary(
seven_dwarfs_svy,
by = park_extra_magic_morning,
include = c(park_ticket_season, park_close, park_temperature_high)
) |>
add_ess_header(header = hdr) |>
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 294; ESS = 223.11 |
엑스트라 매직 아워 N = 60; ESS = 60.01 |
Overall N = 1201 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 18 (30%) | 18 (30%) | 36 (30%) |
| regular | 35 (58%) | 35 (58%) | 70 (58%) |
| value | 7 (12%) | 7 (12%) | 14 (12%) |
| 폐쇄 시간 | |||
| 16:30:00 | 1 (0.9%) | 0 (0%) | 1 (0.4%) |
| 18:00:00 | 13 (21%) | 18 (30%) | 31 (26%) |
| 20:00:00 | 2 (3.3%) | 2 (3.3%) | 4 (3.3%) |
| 21:00:00 | 3 (4.6%) | 0 (0%) | 3 (2.3%) |
| 22:00:00 | 17 (28%) | 11 (18%) | 28 (23%) |
| 23:00:00 | 17 (28%) | 11 (18%) | 28 (23%) |
| 24:00:00 | 8 (14%) | 17 (28%) | 25 (21%) |
| 25:00:00 | 0 (0.3%) | 1 (1.7%) | 1 (1.0%) |
| 과거 최고 기온 | 83 (74, 88) | 83 (75, 87) | 83 (75, 88) |
| 1 n (%); Median (Q1, Q3) | |||
| Abbreviation: ESS = Effective Sample Size | |||
우리는 다시 한번 그룹 간의 균형을 달성했지만, 표 10.3 의 목표값들은 이전 표들과 다릅니다. ATE 가중 표(표 10.2)에서 wdw_ticket_season 변수를 보았을 때, 성수기의 가중 비율이 관찰된 샘플의 전체 성수기 비율인 22% 근처에서 균형을 이루었던 것을 기억하십시오. ATT 가중 표에서는 성수기 날짜의 가중 비율이 노출군과 비노출군 모두에서 30%이며, 이는 가중치가 적용되지 않은 노출군의 비율을 반영합니다. 표 10.3 를 가중치가 적용되지 않은 표(표 10.1)와 비교해 보면, 각 열이 가중치가 적용되지 않은 표의 노출군 열과 가장 유사하다는 점을 알 수 있을 것입니다. 이러한 유사성은 대상 인구가 노출군(아침에 엑스트라 매직 아워가 있었던 날들)이기 때문이며, 따라서 우리는 비교군(매직 아워 없음)을 해당 그룹과 최대한 비슷하게 만들려고 노력하는 것입니다.
가중 가상 인구를 관찰하기 위해 다시 한번 대칭 히스토그램을 생성할 수 있습니다.
ggplot(seven_dwarfs_wts, aes(.fitted, group = park_extra_magic_morning)) +
geom_mirror_histogram(bins = 50) +
geom_mirror_histogram(
aes(fill = park_extra_magic_morning, weight = w_att),
bins = 50,
alpha = 0.5
) +
scale_y_continuous(labels = abs) +
labs(
x = "성향 점수",
fill = "엑스트라 매직 아워"
)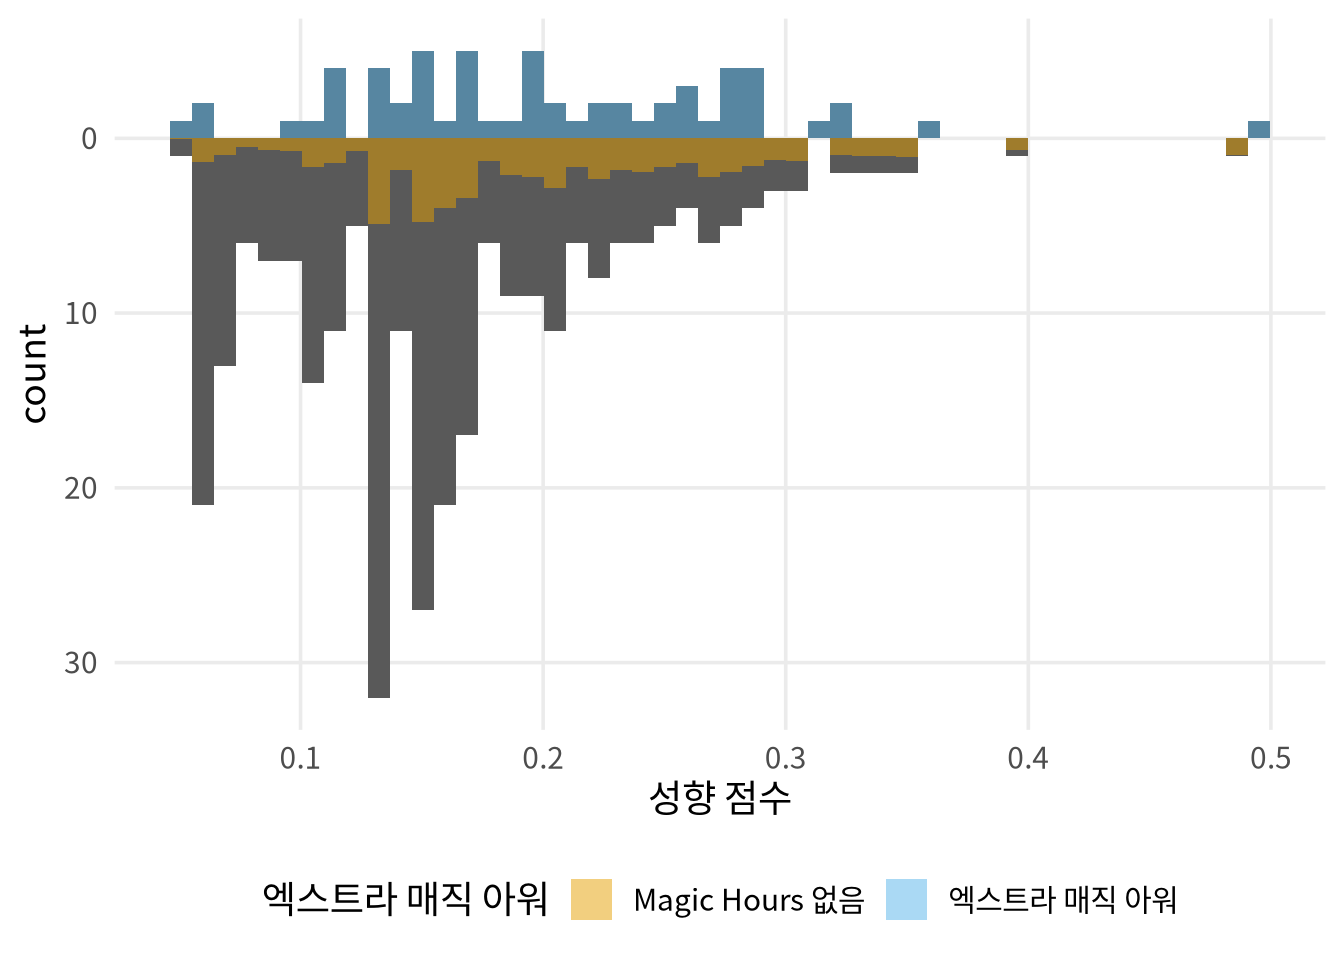
노출군의 모든 날이 1의 가중치를 가지기 때문에, 그림 10.8 에서의 성향 점수 분포(그래프에서 0 위의 어두운 막대들)는 파란색으로 겹쳐진 가중 분포와 정확히 일치합니다. 비노출군 인구 집단에서는 거의 모든 관측치가 하향 가중(downweighted) 됩니다; 어두운 주황색 분포는 성향 점수의 분포보다 작으며 그 위의 노출군 분포와 더 밀접하게 일치합니다. ATT는 노출군에 비해 비노출군에 훨씬 더 많은 관측치가 있을 때 추정하기가 더 쉽습니다.
ATT와 다른 추정 대상들은 ATE에 비해 한 가지 장점이 있습니다: 전체 인구의 하위 집합에 대해서만 추론을 하기 때문에, 우리가 세워야 하는 인과적 가정들이 해당 인구 집단의 하위 집합에 대해서만 충족되면 된다는 것입니다. ATT의 추정 대상은 다음과 같으므로:
\[E[Y(1) - Y(0) | X = 1]\]
가정이 전체 인구가 아닌 처치받은 집단에만 적용되기 때문에 더 약한 가정을 갖게 됩니다. 교환 가능성의 경우, 우리는 더 이상 처치받지 않은 사람들에 대해 잠재적 결과 y(1)을 추정하려고 시도하지 않습니다; 우리는 오직 처치받은 사람들에 대해서만 추론을 하며 해당 그룹에 대해서는 이미 y(1)을 관찰했습니다. 우리는 오직 y(0)만 추정하면 되며, 이를 위해 처치받지 않은 사람들로부터 정보를 빌려올 것입니다. 이는 우리 가정에 두 가지 결과를 가져옵니다: 1) 교환 가능성 가정은 오직 잠재적 결과 y(0)에 대해서만 충족되면 되도록 완화되고, 2) 긍정성 가정은 \(p < 1\) 만 요구하도록 완화됩니다; 즉, 노출되지 않을 확률이 어느 정도는 있어야 합니다.
비노출군(대조군)에서의 평균 처치 효과(ATU 또는 ATC)를 추정하기 위한 대상 인구는 비노출된(처치받지 않은) 인구 집단입니다. 우리는 이 추정 대상을 지칭하기 위해 ATU와 ATC를 모두 사용할 것입니다. 이 인과 추정 대상은 비노출군에 속한 사람들에 대해 조건부화합니다.
\[E[Y(1) - Y(0) | X = 0]\]
ATU가 관심 대상이 되는 연구 질문의 예는 “현재 마케팅 캠페인을 받지 않는 사람들에게 캠페인을 시작해야 하는가?” 또는 “현재 처치를 받지 않는 환자들에게 의료진이 처치를 확장 권장해야 하는가?” 등이 있습니다 (Greifer 와/과 Stuart 2021).
ATU 또한 매칭을 통해 추정될 수 있습니다. 여기서는 모든 비노출된 관측치들이 포함되고 노출된 관측치와 매칭되며, 노출된 관측치의 일부는 버려질 수 있습니다. 대안적으로, 우리는 가중치 부여를 통해 ATU를 추정할 수 있습니다. ATU 가중치는 다음과 같이 추정됩니다:
\[w_{ATU} = \frac{X(1-p)}{p}+ (1-X)\]
이는 ATT의 반대입니다: 비노출군이 1의 가중치를 받고, 노출군이 처치받지 않을 오즈와 동일한 가중치를 받습니다. 우리는 비처치 확률을 틸팅 함수로 사용함으로써 비처치 그룹을 목표로 삼고 있습니다.
\[ \begin{aligned} w_i^{\mathrm{ATC}} &= \begin{cases} \dfrac{1 - p}{p}, & X_i = 1,\\[6pt] \dfrac{1 - p}{1 - p} = 1, & X_i = 0, \end{cases} \quad \Bigl(tilt_{\rm ATC}(p)=1 - p\Bigr) \end{aligned} \]
ATC의 틸팅 함수는 인구 집단을 처치받지 않은 집단과 더 비슷하게 만들려고 작동합니다. 따라서 처치받지 않은 집단은 1의 가중치를 갖는 반면, 처치받은 집단은 처치받지 않을 오즈인 가중치를 갖는데, 이는 0에서 무한대까지의 범위를 가집니다.
plot_weight_properties(plot_df, "atc")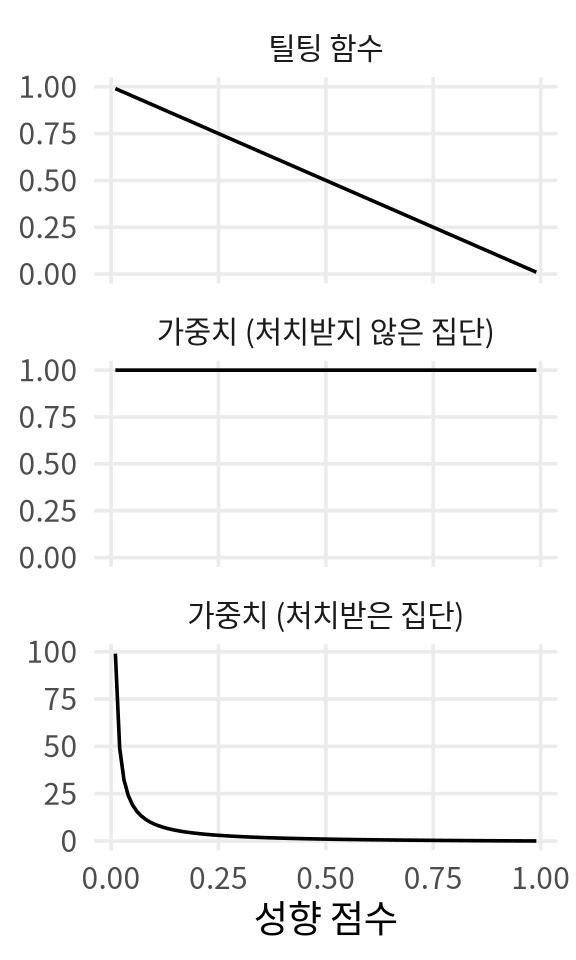
seven_dwarfs_wts 데이터 프레임에 ATU 가중치를 추가하고 그 분포를 살펴봅시다.
Warning in vec_ptype2.psw.double(x = x, y = y, x_arg = x_arg, y_arg = y_arg, : Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning
Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning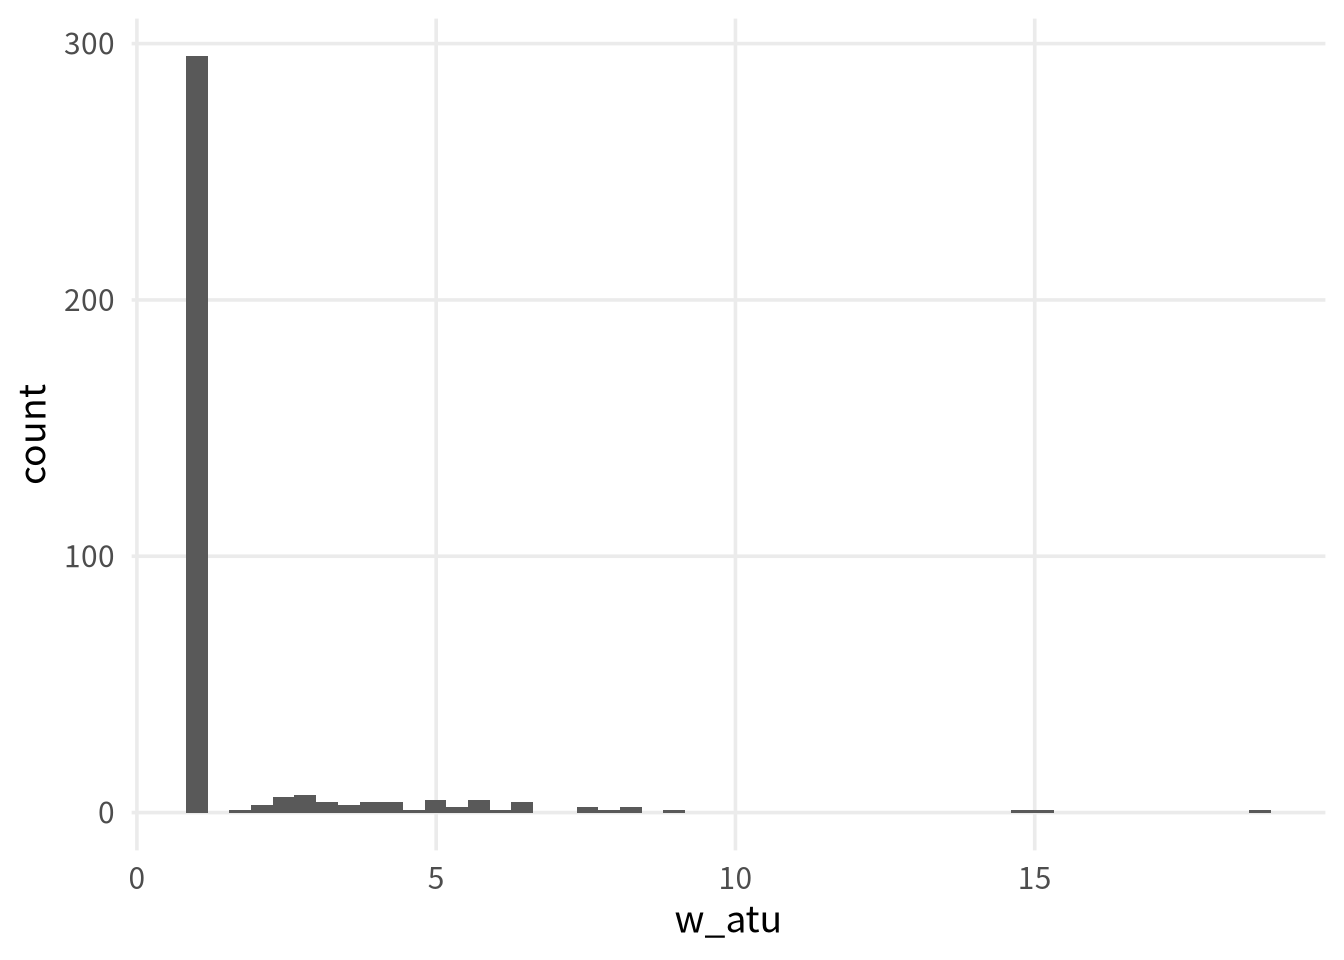
그림 10.10 의 가중치 분포는 ATE 가중치에서 보았던 것과 매우 비슷해 보입니다 — 1 근처에 여러 개가 있고 긴 꼬리가 있습니다. 이 가중치들은 비노출군에 속한 모든 관측치에 대해 1이 될 것이며, 노출군에 대해서는 0에서 무한대까지의 범위를 가질 수 있습니다. 우리 비노출군에 더 많은 관측치가 있기 때문에, 노출군 관측치들은 그들의 분포와 일치하도록 상향 가중(upweighted)됩니다.
이제 가중치가 적용된 표를 살펴봅시다.
seven_dwarfs_svy <- svydesign(
ids = ~1,
data = seven_dwarfs_wts,
weights = ~w_atu
)
tbl_svysummary(
seven_dwarfs_svy,
by = park_extra_magic_morning,
include = c(park_ticket_season, park_close, park_temperature_high)
) |>
add_ess_header(header = hdr) |>
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 294; ESS = 294.01 |
엑스트라 매직 아워 N = 60; ESS = 42.51 |
Overall N = 5911 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 60 (20%) | 63 (21%) | 123 (21%) |
| regular | 158 (54%) | 152 (51%) | 310 (52%) |
| value | 76 (26%) | 82 (27%) | 158 (27%) |
| 폐쇄 시간 | |||
| 16:30:00 | 1 (0.3%) | 0 (0%) | 1 (0.2%) |
| 18:00:00 | 37 (13%) | 54 (18%) | 91 (15%) |
| 20:00:00 | 18 (6.1%) | 17 (5.7%) | 35 (5.9%) |
| 21:00:00 | 28 (9.5%) | 0 (0%) | 28 (4.7%) |
| 22:00:00 | 91 (31%) | 75 (25%) | 166 (28%) |
| 23:00:00 | 78 (27%) | 70 (23%) | 148 (25%) |
| 24:00:00 | 40 (14%) | 77 (26%) | 117 (20%) |
| 25:00:00 | 1 (0.3%) | 5 (1.6%) | 6 (1.0%) |
| 과거 최고 기온 | 84 (78, 89) | 83 (78, 87) | 84 (78, 88) |
| 1 n (%); Median (Q1, Q3) | |||
| Abbreviation: ESS = Effective Sample Size | |||
이제 표 10.4 의 노출군 열은 가중치가 적용되지 않은 표의 비노출군 열과 일치하도록 가중되었습니다.
가중 가상 인구를 관찰하기 위해 다시 한번 대칭 히스토그램을 생성할 수 있습니다.
ggplot(seven_dwarfs_wts, aes(.fitted, group = park_extra_magic_morning)) +
geom_mirror_histogram(bins = 50) +
geom_mirror_histogram(
aes(fill = park_extra_magic_morning, weight = w_atu),
bins = 50,
alpha = 0.5
) +
scale_y_continuous(labels = abs) +
labs(
x = "성향 점수",
fill = "엑스트라 매직 아워"
)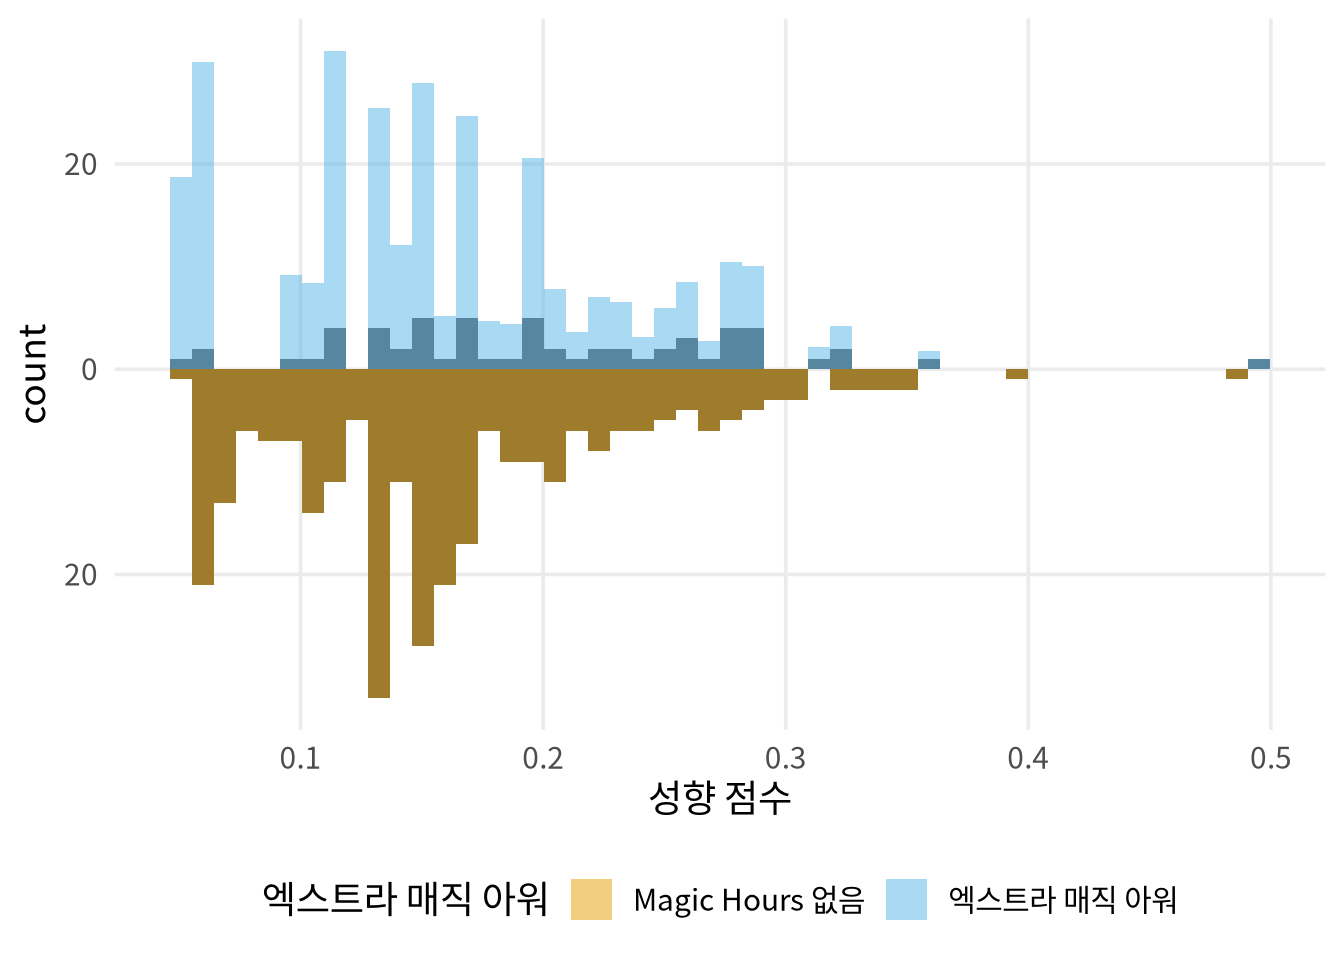
비노출군인 날들에 대한 가중치는 모두 1이므로, 이 그룹의 성향 점수 분포는 주황색으로 표시된 가중 가상 인구와 정확히 겹칩니다. 파란색 막대는 노출된 인구 집단이 비노출군 분포와 일치하도록 상당히 상향 가중(upweighted)되었음을 나타냅니다.
ATT와 마찬가지로, 우리의 추정 대상은 처치 상태에 대해 조건부화합니다. ATC의 경우, 우리는 인과적 가정을 처치받지 않은 그룹에 대해서만 필수적인 것으로 완화합니다. 처치받지 않은 사람들에 대해서는 이미 y(0)를 관찰했기 때문에 y(1)만 추정하면 됩니다. 이는 비노출군이 있는 곳 어디에나 노출군 관측치가 일부 있어야 함을 의미합니다. 즉, 이제 우리는 \(p > 0\) 이라는 긍정성 가정을 갖게 됩니다: 처치받을 확률이 어느 정도는 존재해야 합니다.
균등하게 매칭 가능한 집단에서의 평균 처치 효과(average treatment effect among the evenly matchable, ATM)를 추정하기 위한 대상 인구는 균등하게 매칭 가능한 사람들입니다. 이 인과 추정 대상은 어떤 거리 척도에 의해 “균등하게 매칭 가능”하다고 간주되는 사람들에 대해 조건부화합니다.
\[E[Y(1) - Y(0) | M_d = 1]\]
여기서 \(d\) 는 거리 척도를 나타내고, \(M_d=1\) 은 해당 거리 척도 하에서 단위가 균등하게 매칭 가능함을 나타냅니다 (Samuels 2017; D’Agostino McGowan 2018). ATM에 관한 연구 질문의 예로는 “임상적 평형 상태(clinical equipoise)에 있는 사람들이 노출을 받아야 하는가?” 등이 있을 수 있습니다 (Greifer 와/과 Stuart 2021). 의학에서 임상적 평형 상태에 있는 사람들이란 어떻게 처치해야 할지 진정으로 불확실한 사람들을 의미합니다. 이러한 불확실성에 직면하여 최선의 결정을 내리고 싶어 하기 때문에, 이들은 우리가 추론을 이끌어낼 인구 집단의 매우 중요한 부분인 경우가 많습니다.
ATM은 매칭을 할 때 흔히 사용되는 목표 추정 대상입니다. 여기서 일부 노출군 관측치는 대조군 관측치와 매칭됩니다. 하지만 두 그룹의 일부 관측치들은 버려질 수도 있습니다. 이러한 유형의 매칭은 종종 캘리퍼(caliper)를 통해 수행되는데, 섹션 8.3 에서 보여준 것처럼 관측치들이 사전에 지정된 캘리퍼 거리 내에 있을 때만 매칭됩니다. 대안적으로, ATM은 가중치 부여를 통해 추정될 수 있습니다. ATM 가중치는 다음과 같이 추정됩니다:
\[w_{ATM} = \frac{\min \{p, 1-p\}}{Xp + (1-X)(1-p)}\]
ATM의 틸팅 함수는 \(min\{p, 1-p\}\) 입니다.
\[ \begin{aligned} w_i^{\mathrm{ATM}} &= \begin{cases} \dfrac{min \{p, 1-p\}}{p}, & X_i = 1,\\[6pt] \dfrac{min \{p, 1-p\}}{1 - p}, & X_i = 0, \end{cases} \quad \Bigl(tilt_{\rm ATM}(p)=min \{p, 1-p\}\Bigr) \end{aligned} \]
이는 가중치에 흥미로운 영향을 미칩니다. 틸팅 함수는 0.5에서 가장 높은 값을 갖는 삼각형 모양의 함수로 가중치를 조절하는데, 이 지점은 처치 그룹 사이에서 가장 불확실성이 큰 지점(임상적 평형 상태)입니다. 0.5 이상에서는 비노출군이 1의 가중치를 갖지만, 확률이 0에 가까워질수록 하향 가중됩니다. 처치받을 확률이 낮은 사람들은 많은 정보를 제공하지 않기 때문입니다. 노출군의 경우는 그 반대입니다. 0.5 이하에서 그들은 1의 가중치를 가지며 확률이 1에 가까워질수록 하향 가중됩니다.
plot_weight_properties(plot_df, "atm")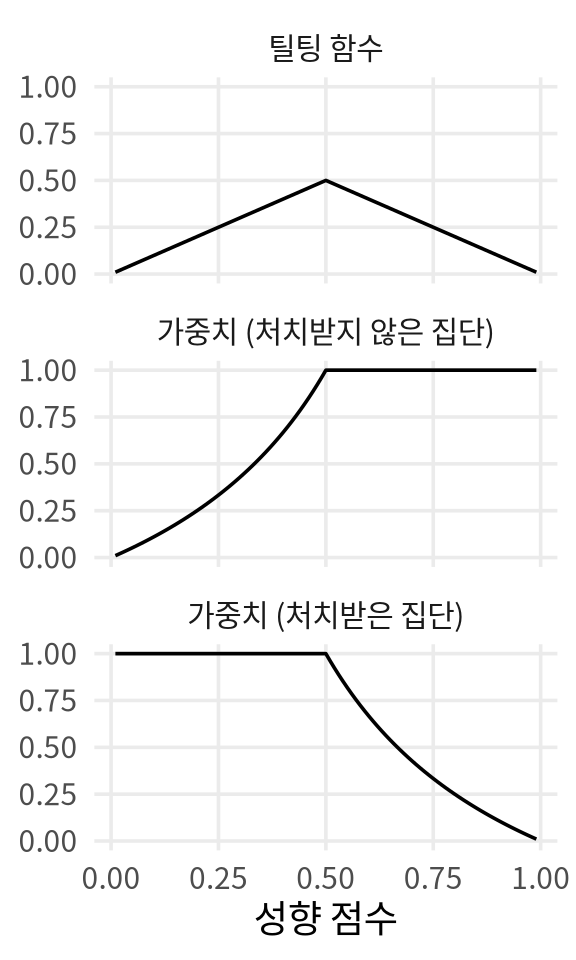
seven_dwarfs_wts 데이터 프레임에 ATM 가중치를 추가하고 그 분포를 살펴봅시다.
Warning in vec_ptype2.psw.double(x = x, y = y, x_arg = x_arg, y_arg = y_arg, : Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning
Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning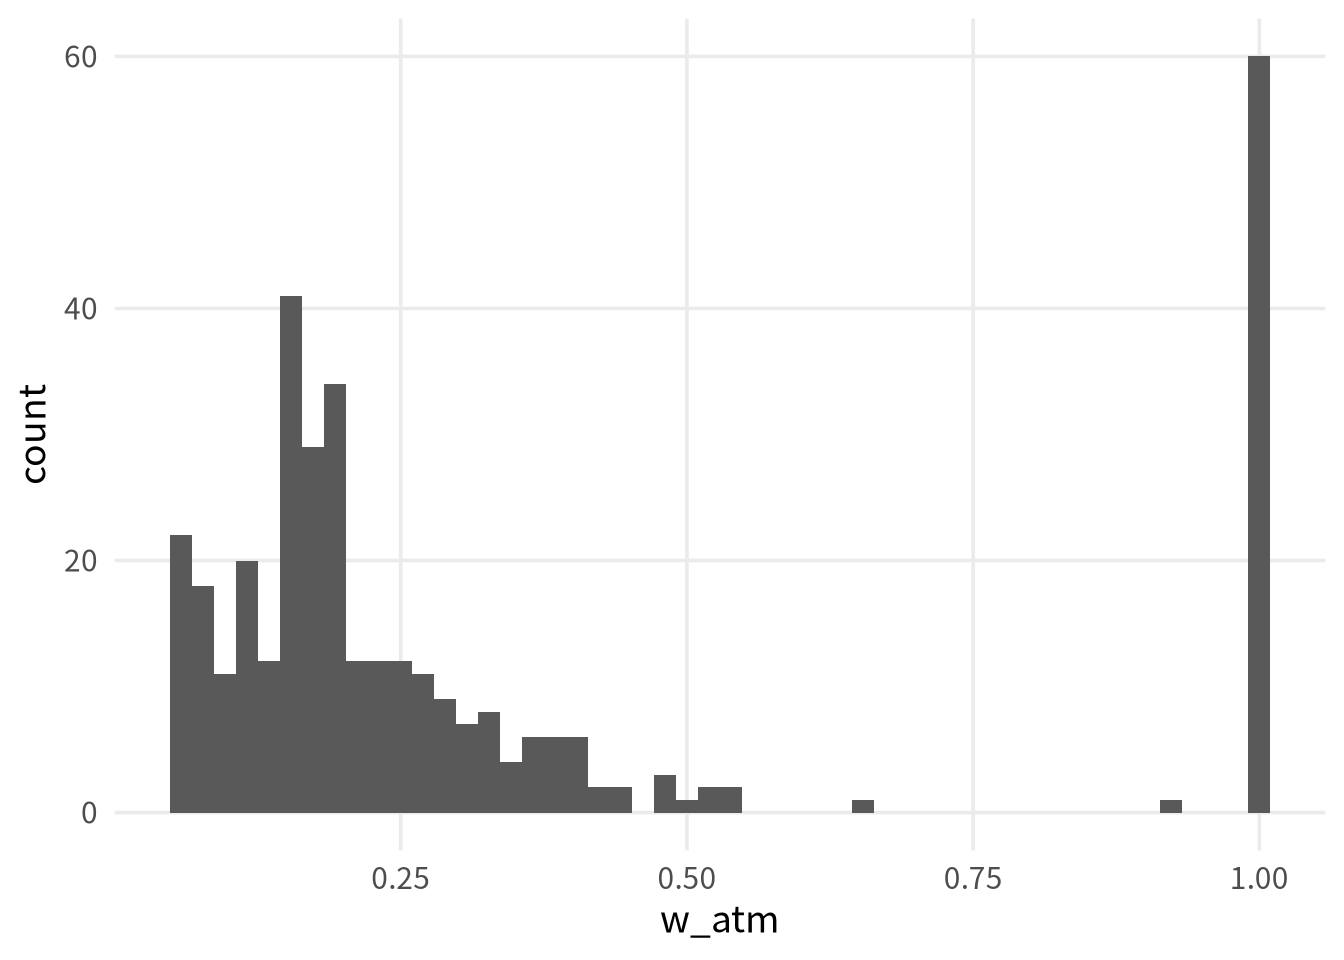
그림 10.13 에서 가중치의 분포는 ATT 가중치에서 보았던 것과 매우 비슷해 보입니다. 이는 이 특정 샘플에서 노출군에 비해 비노출군 관측치가 훨씬 더 많기 때문입니다. 이 가중치들은 0에서 1 사이의 범위를 갖는다는 좋은 속성을 가지고 있어, 노출 그룹 간의 불균형에 관계없이 항상 안정적입니다.
이제 가중치가 적용된 표를 살펴봅시다.
seven_dwarfs_svy <- svydesign(
ids = ~1,
data = seven_dwarfs_wts,
weights = ~w_atm
)
tbl_svysummary(
seven_dwarfs_svy,
by = park_extra_magic_morning,
include = c(park_ticket_season, park_close, park_temperature_high)
) |>
add_ess_header(header = hdr) |>
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 294; ESS = 223.11 |
엑스트라 매직 아워 N = 60; ESS = 60.01 |
Overall N = 1201 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 18 (30%) | 18 (30%) | 36 (30%) |
| regular | 35 (58%) | 35 (58%) | 70 (58%) |
| value | 7 (12%) | 7 (12%) | 14 (12%) |
| 폐쇄 시간 | |||
| 16:30:00 | 1 (0.9%) | 0 (0%) | 1 (0.4%) |
| 18:00:00 | 13 (21%) | 18 (30%) | 31 (26%) |
| 20:00:00 | 2 (3.3%) | 2 (3.3%) | 4 (3.3%) |
| 21:00:00 | 3 (4.6%) | 0 (0%) | 3 (2.3%) |
| 22:00:00 | 17 (28%) | 11 (18%) | 28 (23%) |
| 23:00:00 | 17 (28%) | 11 (18%) | 28 (23%) |
| 24:00:00 | 8 (14%) | 17 (28%) | 25 (21%) |
| 25:00:00 | 0 (0.3%) | 1 (1.7%) | 1 (1.0%) |
| 과거 최고 기온 | 83 (74, 88) | 83 (75, 87) | 83 (75, 88) |
| 1 n (%); Median (Q1, Q3) | |||
| Abbreviation: ESS = Effective Sample Size | |||
이 특정 샘플에서, ATM 가중치는 ATT 가중치와 유사하므로, 이 표는 ATT 가중 표와 비슷해 보입니다. 이러한 유사성이 항상 보장되는 것은 아니며, ATM 가상 인구는 전체, 노출군, 그리고 비노출군 가중치 미적용 인구와 다르게 보일 수 있습니다. 따라서 ATM 가중치를 사용할 때는 최종적으로 어떤 인구 집단에 대해 추론을 이끌어내게 될지 이해하기 위해 가중 표를 검토하는 것이 필수적입니다.
가중 가상 인구를 관찰하기 위해 다시 한번 대칭 히스토그램을 생성할 수 있습니다.
ggplot(seven_dwarfs_wts, aes(.fitted, group = park_extra_magic_morning)) +
geom_mirror_histogram(bins = 50) +
geom_mirror_histogram(
aes(fill = park_extra_magic_morning, weight = w_atm),
bins = 50,
alpha = 0.5
) +
scale_y_continuous(labels = abs) +
labs(
x = "성향 점수",
fill = "엑스트라 매직 아워"
)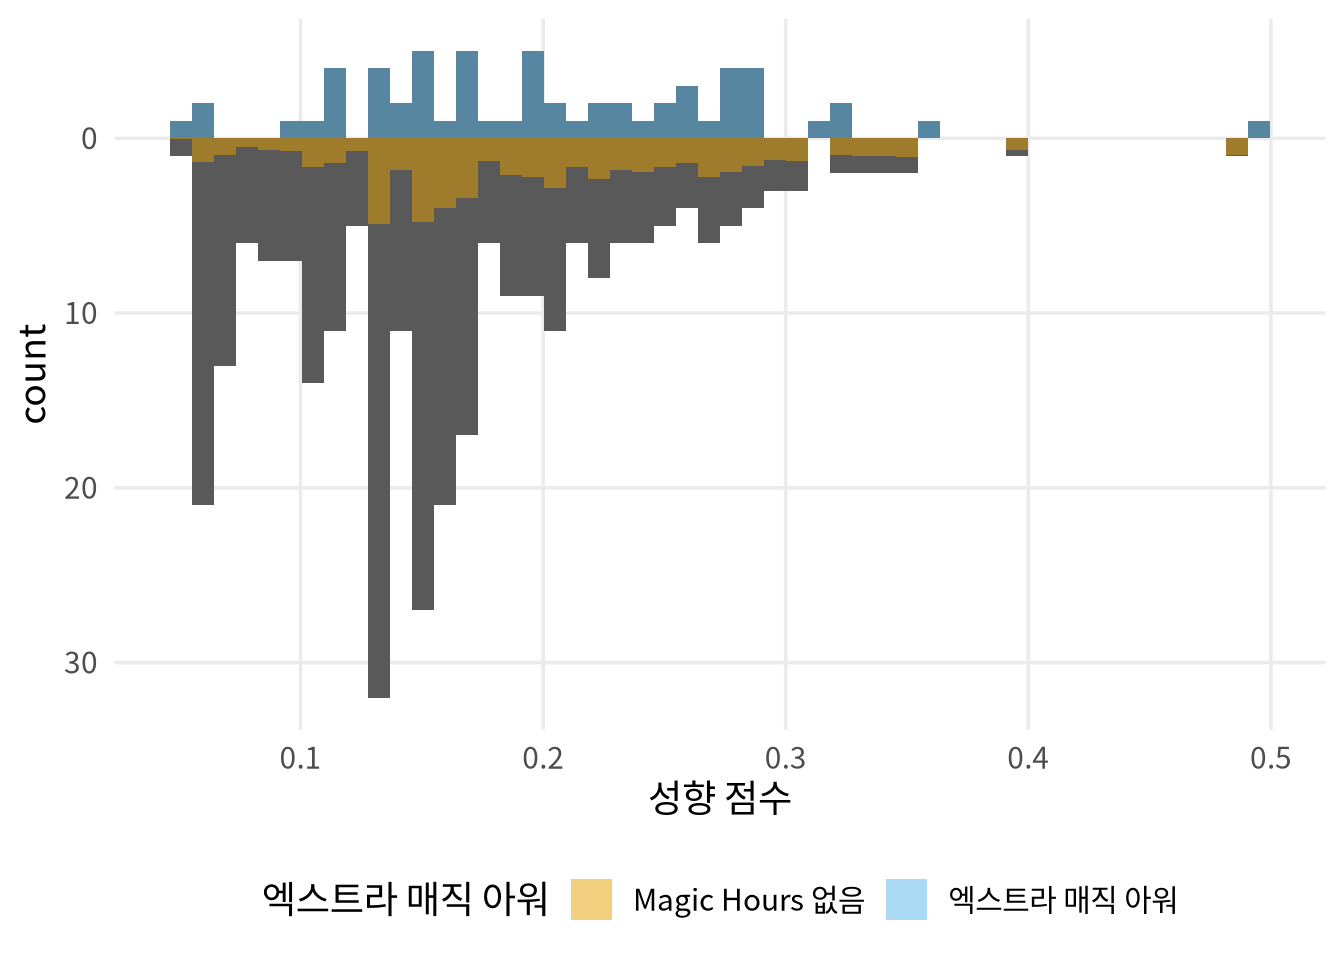
ATM 가중치는 0과 1 사이로 제한되므로, 모든 관측치들은 하향 가중(downweighted)될 것입니다. 이는 작은 샘플에서 큰 가중치로 인해 발생할 수 있는 유한 표본 편향의 가능성을 제거하며, 개선된 분산 속성을 갖습니다.
인과적 가정 또한 ATM에 대해서는 완화됩니다: 우리는 ATE와 동일한 교환 가능성 및 긍정성 가정을 가지지만, 이러한 가정들은 전체 인구가 아닌 오직 균등하게 매칭 가능한 사람들에 대해서만 요구됩니다. 중첩 영역의 중간 부분에서의 교란이 덜 극단적이고, 정의상 더 나은 긍정성을 갖기 때문에 이는 종종 더 실현 가능한 가정이 됩니다.
ATM은 임상적 평형 상태에 있는 특정 인구 집단(균등하게 매칭 가능한 사람들)을 추정하지만, 평형 상태를 고려하는 방법에는 여러 가지가 있습니다. 관련된 또 다른 대상 인구는 중첩된 집단에서의 평균 처치 효과(average treatment effect among the overlap population, ATO)입니다. ATO가 관심 대상이 되는 연구 질문의 예는 ATM과 동일하게 “임상적 평형 상태에 있는 사람들이 노출을 받아야 하는가?” 등이 있습니다 (Greifer 와/과 Stuart 2021).
다시 말하지만, 이 가중치들은 ATM 가중치와 유사하지만 약간 감쇄되어 있어 분산 속성이 더 개선되었습니다.
ATO 가중치는 다음과 같이 추정됩니다:
\[w_{ATO} = X(1-p) + (1-X)p\]
ATO의 틸팅 함수는 \(p(1-p)\) 입니다1.
\[ \begin{aligned} w_i^{\mathrm{ATO}} &= \begin{cases} \dfrac{p(1-p)}{p} = 1-p, & X_i = 1,\\[6pt] \dfrac{p(1-p)}{1 - p} = p, & X_i = 0, \end{cases} \quad \Bigl(tilt_{\rm ATO}(p)=p(1-p)\Bigr) \end{aligned} \]
ATM과 마찬가지로, ATO의 틸팅 함수는 성향 점수가 0.5인 사람들을 가장 강조하고 확률이 0 또는 1에 가까운 사람들의 가중치를 낮춥니다. 하지만 ATO의 틸팅 함수는 ATM의 것보다 더 매끄럽기 때문에 분산 속성이 더 좋습니다. 가중치에 미치는 영향은 성향 점수 전 범위에 걸쳐 선형적이라는 것인데, 처치받지 않은 집단의 가중치는 성향 점수가 1에 가까워질수록 1에 수렴하고, 반대로 처치받은 집단의 가중치는 성향 점수가 0에 가까워질수록 1에 수렴합니다. 우리는 각 그룹에 다른 그룹에 속할 확률과 동일한 가중치를 부여합니다!
plot_weight_properties(plot_df, "ato")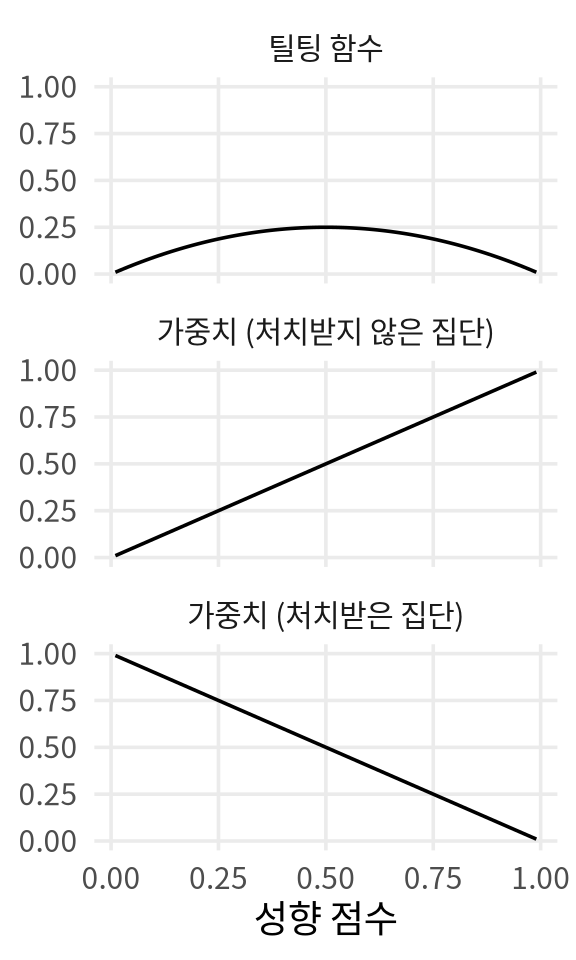
seven_dwarfs_wts 데이터 프레임에 ATO 가중치를 추가하고 그 분포를 살펴봅시다.
Warning in vec_ptype2.psw.double(x = x, y = y, x_arg = x_arg, y_arg = y_arg, : Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning
Converting psw to numeric
ℹ Class-specific attributes and metadata have been
  dropped
ℹ Use explicit casting to numeric to avoid this
  warning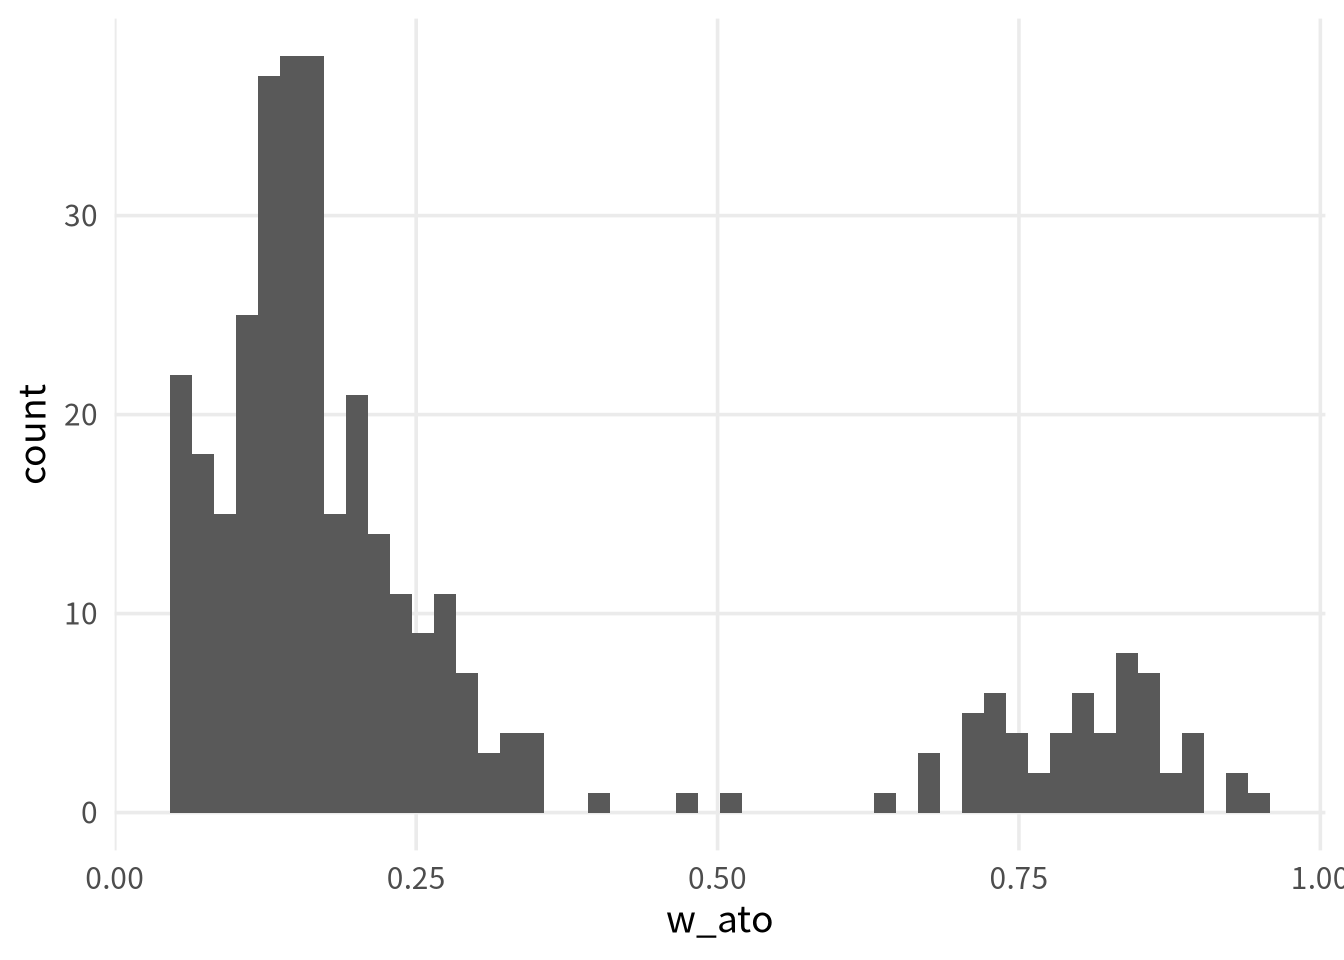
ATM 가중치와 마찬가지로, ATO 가중치는 0과 1 사이로 제한되어 있어 노출군과 비노출군 사이의 불균형에 관계없이 ATE, ATT, ATU보다 더 안정적입니다.
유한 표본 편향 시뮬레이션을 다시 살펴보면서, ATO 가중치를 추가하여 이러한 편향 가능성이 가중치에 어떤 영향을 미치는지 알아봅시다.
sim <- function(n) {
  ## 시뮬레이션 데이터셋 생성
  finite_sample <- tibble(
    z = rnorm(n),
    x = case_when(
      0.5 + z + rnorm(n) > 0 ~ 1,
      TRUE ~ 0
    ),
    y = z + rnorm(n)
  )
  finite_sample_wts <- glm(
    x ~ z,
    data = finite_sample,
    family = binomial("probit")
  ) |>
    augment(data = finite_sample, type.predict = "response") |>
    mutate(
      wts_ate = wt_ate(.fitted, x),
      wts_ato = wt_ato(.fitted, x)
    )
  bias <- finite_sample_wts |>
    summarize(
      effect_ate = sum(y * x * wts_ate) / sum(x * wts_ate) -
        sum(y * (1 - x) * wts_ate) / sum((1 - x) * wts_ate),
      effect_ato = sum(y * x * wts_ato) / sum(x * wts_ato) -
        sum(y * (1 - x) * wts_ato) / sum((1 - x) * wts_ato)
    )
  tibble(
    n = n,
    bias = c(bias$effect_ate, bias$effect_ato),
    weight = c("ATE", "ATO")
  )
}

## 5가지 다른 샘플 크기를 검토하고, 각각 1000번씩 시뮬레이션
set.seed(1)
finite_sample_sims <- map_df(
  rep(
    c(50, 100, 500, 1000, 5000, 10000),
    each = 1000
  ),
  sim
)

bias <- finite_sample_sims |>
  group_by(n, weight) |>
  summarize(bias = mean(bias))

ggplot(bias, aes(x = n, y = bias, color = weight)) +
  geom_point() +
  geom_line() +
  geom_hline(yintercept = 0, lty = 2)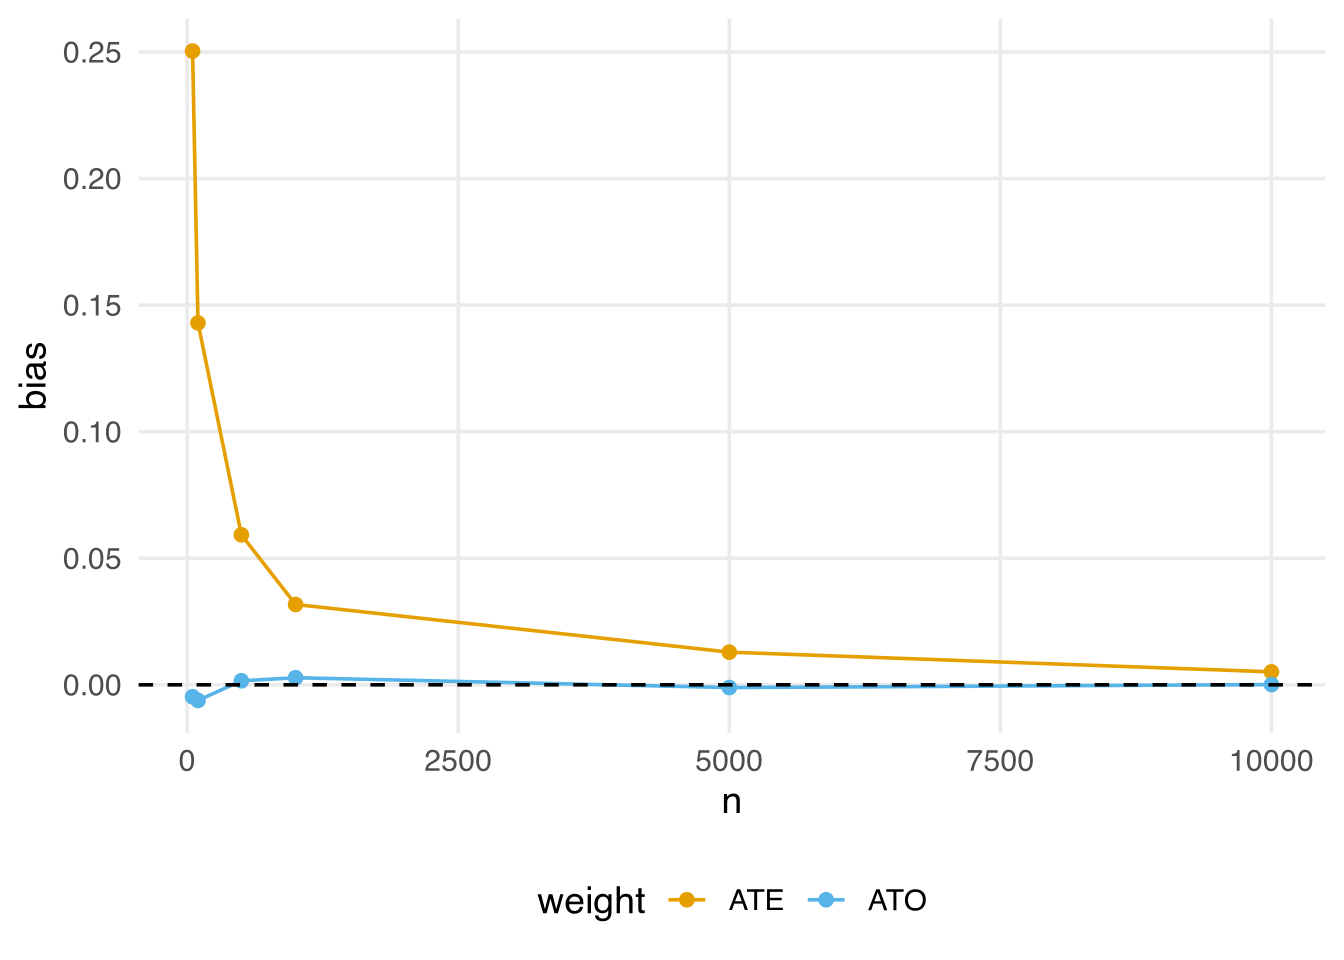
ATO 가중치 추정치는 상대적으로 작은 샘플에서도 거의 즉시 편향이 사라지는 것에 주목하십시오.
이제 가중치가 적용된 표를 살펴봅시다.
seven_dwarfs_svy <- svydesign(
  ids = ~1,
  data = seven_dwarfs_wts,
  weights = ~w_ato
)
tbl_svysummary(
  seven_dwarfs_svy,
  by = park_extra_magic_morning,
  include = c(park_ticket_season, park_close, park_temperature_high)
) |>
  add_ess_header(header = hdr) |>
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 294; ESS = 246.21 |
엑스트라 매직 아워 N = 60; ESS = 59.41 |
Overall N = 961 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 14 (29%) | 14 (29%) | 28 (29%) |
| regular | 28 (58%) | 28 (58%) | 55 (58%) |
| value | 6 (13%) | 6 (13%) | 13 (13%) |
| 폐쇄 시간 | |||
| 16:30:00 | 0 (0.7%) | 0 (0%) | 0 (0.4%) |
| 18:00:00 | 9 (19%) | 13 (27%) | 22 (23%) |
| 20:00:00 | 2 (3.7%) | 2 (3.7%) | 4 (3.7%) |
| 21:00:00 | 2 (5.1%) | 0 (0%) | 2 (2.5%) |
| 22:00:00 | 14 (29%) | 9 (20%) | 23 (24%) |
| 23:00:00 | 14 (28%) | 9 (19%) | 23 (24%) |
| 24:00:00 | 7 (14%) | 14 (29%) | 21 (22%) |
| 25:00:00 | 0 (0.3%) | 1 (1.7%) | 1 (1.0%) |
| 과거 최고 기온 | 83 (75, 88) | 83 (76, 87) | 83 (75, 88) |
| 1 n (%); Median (Q1, Q3) | |||
| Abbreviation: ESS = Effective Sample Size | |||
ATM 가중치와 마찬가지로, ATO 가상 인구는 가중치가 적용되지 않은 전체, 노출군, 또는 비노출군 인구와 닮지 않았을 수 있으므로, 우리가 추론을 이끌어낼 인구 집단을 이해하기 위해 이러한 가중 표를 검토하는 것이 필수적입니다.
ATO 가중 가상 인구를 관찰하기 위해 다시 한번 대칭 히스토그램을 생성할 수 있습니다.
ggplot(seven_dwarfs_wts, aes(.fitted, group = park_extra_magic_morning)) +
  geom_mirror_histogram(bins = 50) +
  geom_mirror_histogram(
    aes(fill = park_extra_magic_morning, weight = w_ato),
    bins = 50,
    alpha = 0.5
  ) +
  scale_y_continuous(labels = abs) +
  labs(
    x = "성향 점수",
    fill = "엑스트라 매직 아워"
  )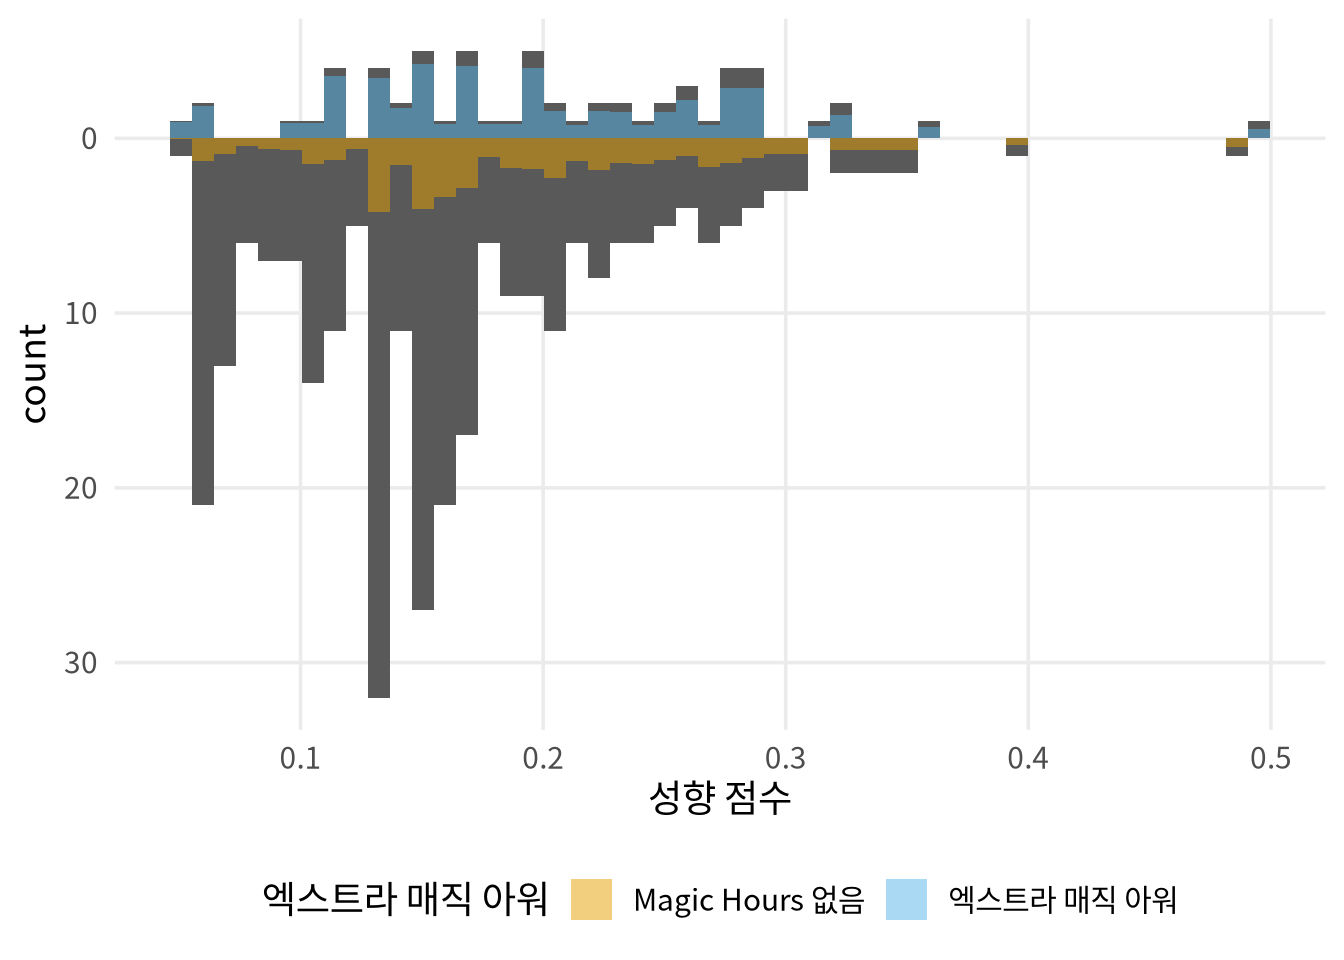
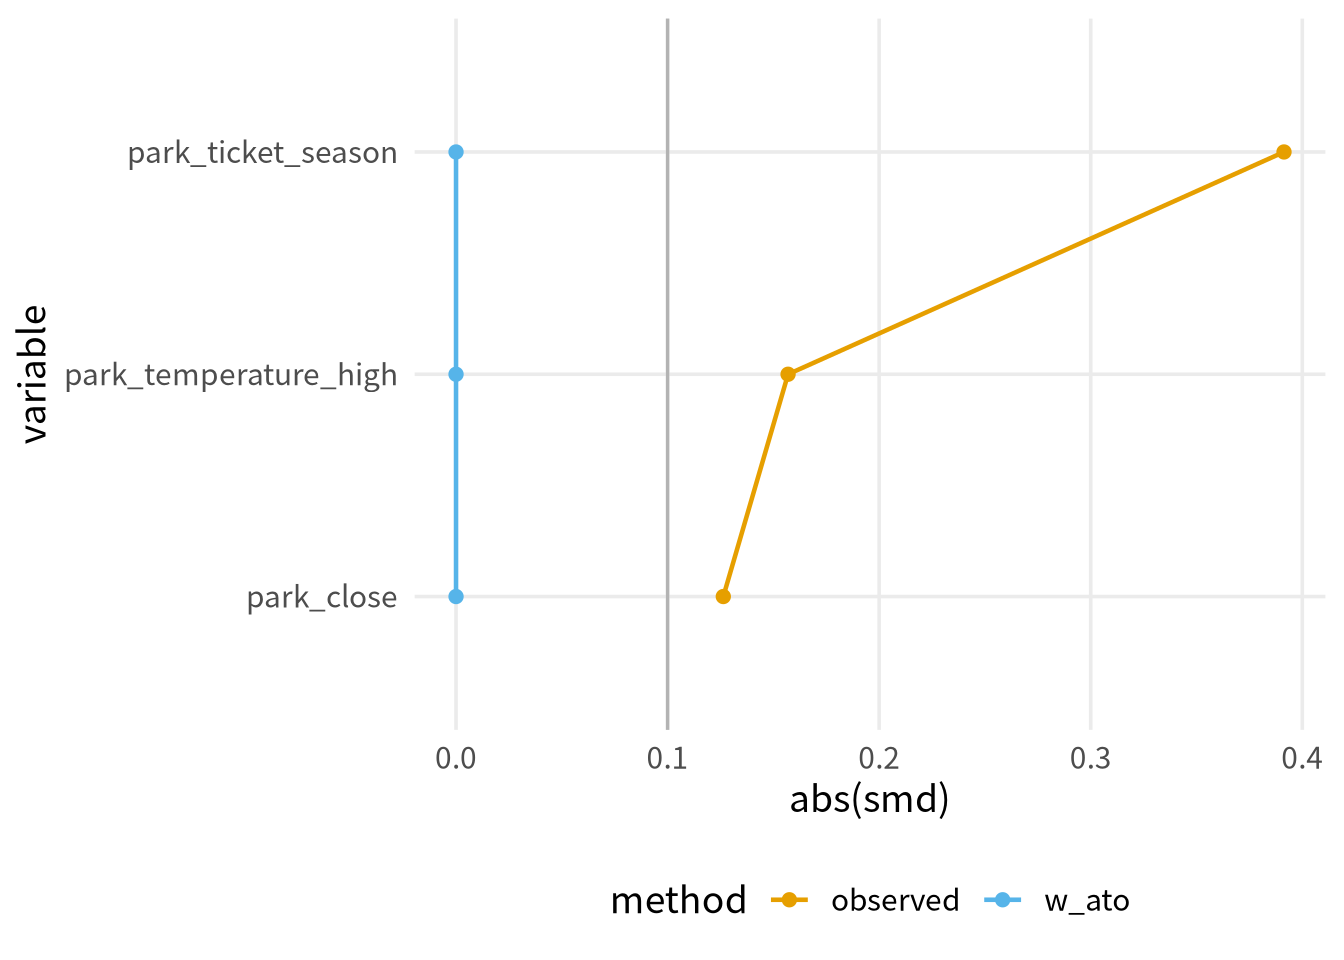
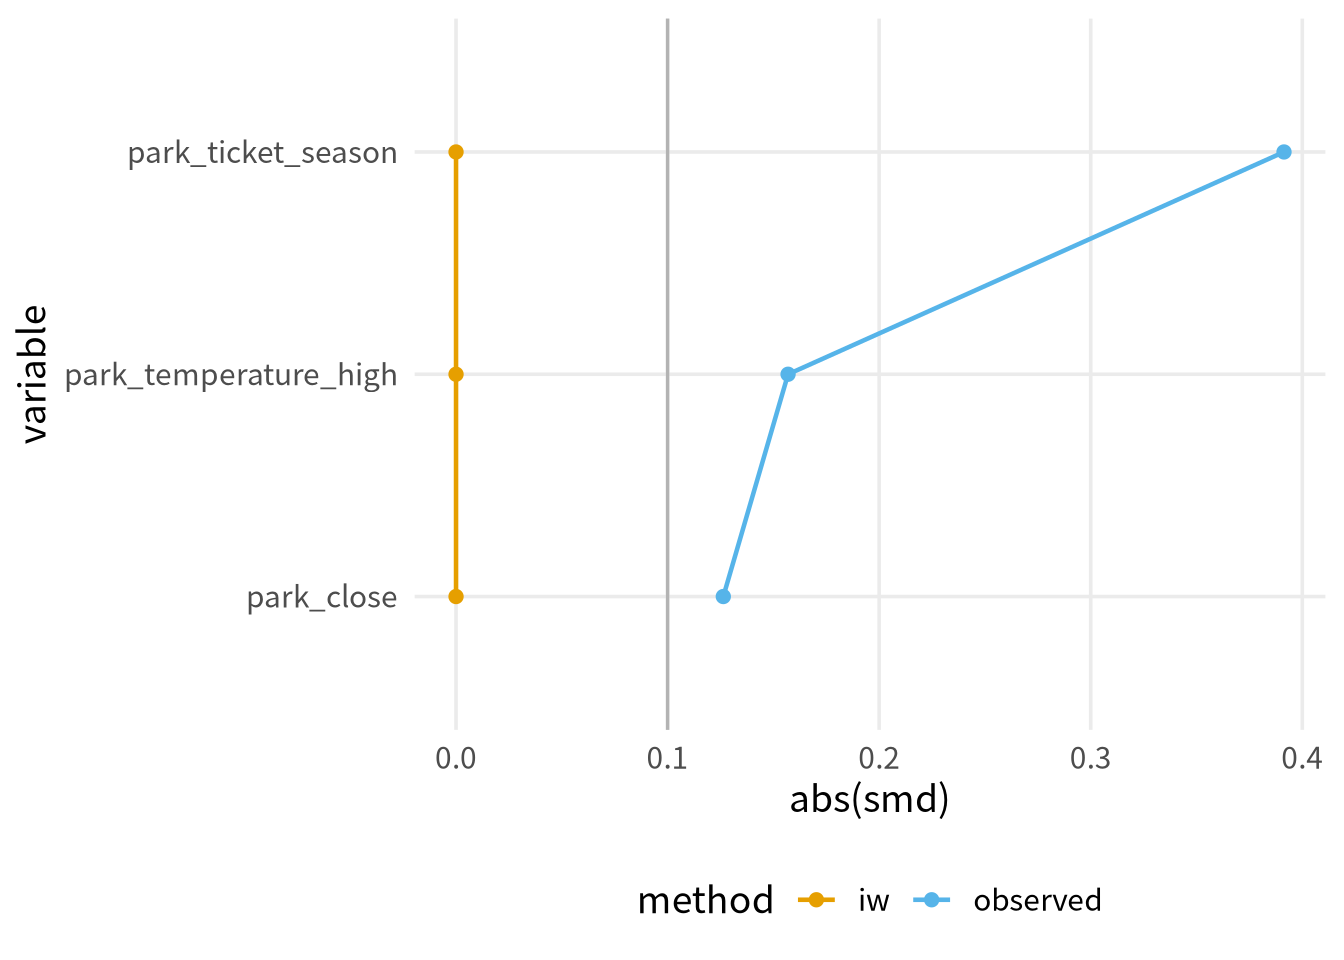
그림 10.18 는 ATM 가상 인구와 유사해 보이지만, 노출된 인구 집단에서 하향 가중(downweighting)이 증가한 것에서 알 수 있듯이 약간의 감쇄가 있습니다. 중첩된(또는 균등하게 매칭 가능한) 집단이 목표일 때는 ATO 가중치를 사용하는 것이 더 나은데, 이는 더 나은 분산 속성을 갖기 때문입니다. 또 다른 장점은 성향 점수 모델에 포함된 모든 변수들이 (로지스틱 회귀를 통해 적합된 경우2) 평균에서 완벽하게 균형을 이룬다는 점입니다. 러브 플롯(Love plot)을 살펴봅시다. 그림 10.19 에서는 ATO 가중치로 가중되었을 때 세 가지 공변량 모두 SMD가 0임을 알 수 있습니다.
섹션 8.4 에서 보았듯이, 절단(trimming)이나 절삭(truncation)은 긍정성 및 중첩 문제를 다루기 위한 흔한 기술입니다. 여러분은 그 결과로 나타나는 추정 대상을 또 다른 유형의 중첩 집단으로 생각할 수 있습니다. 예를 들어, 절단된 관측치의 경우 틸팅 함수는 절단된 관측치에 대해 0이고 남겨진 관측치에 대해 1입니다. 많은 분석가들은 이렇게 함으로써 여전히 ATE를 근사화하고 있기를 바랍니다. 즉, 이 대상 인구가 전체 인구와 충분히 가까워 거의 동일한 답을 주면서도 더 나은 분산을 갖기를 기대하는 것입니다. 하지만 우리는 중첩된 집단이 그 자체로 가치 있는 대상 인구라는 사실도 알고 있습니다. 절단이나 절삭을 할 때 인구 집단 간의 변화를 살펴보는 것은 여러분의 인구가 전체 인구를 얼마나 잘 근사하는지, 아니면 중첩된 집단으로 간주하는 것이 더 나은지 이해하는 데 도움이 될 수 있습니다.
MatchIt은 estimand 인자를 사용하여 서로 다른 추정 대상을 쉽게 목표로 삼을 수 있습니다. ATE의 경우 전체 매칭(full matching)을 사용해야 하고, ATM의 경우 캘리퍼(caliper)를 사용해야 함에 유의하십시오.
| 추정 대상 | MatchIt 명령 |
|---|---|
| ATE | matchit(…, method = "full", estimand = "ATE") |
| ATT | matchit(…, estimand = "ATT") |
| ATC | matchit(…, estimand = "ATC") |
| ATM | matchit(…, caliper = <caliper>) |
가중치가 서로 다른 인구 집단을 어떻게 목표로 삼는지에 대한 직관은 틸팅 함수로 귀결됩니다: 우리는 관심 있는 인구 집단을 대표하도록 가중치의 척도를 조정하는 것입니다. 매칭에 대한 직관은 더 간단합니다: 그것은 누구를 제외하고 누구를 남길 것인가의 문제입니다. 수학적으로 이는 동일합니다: 매칭에서 모든 사람은 0 또는 1의 가중치를 받으며, 이러한 가중치를 결정하는 방식은 알고리즘적 틸팅 함수와 관련이 있습니다. 하지만 매칭을 사용하면, 누가 왜 제외되었는지 생각하기가 더 쉽습니다.
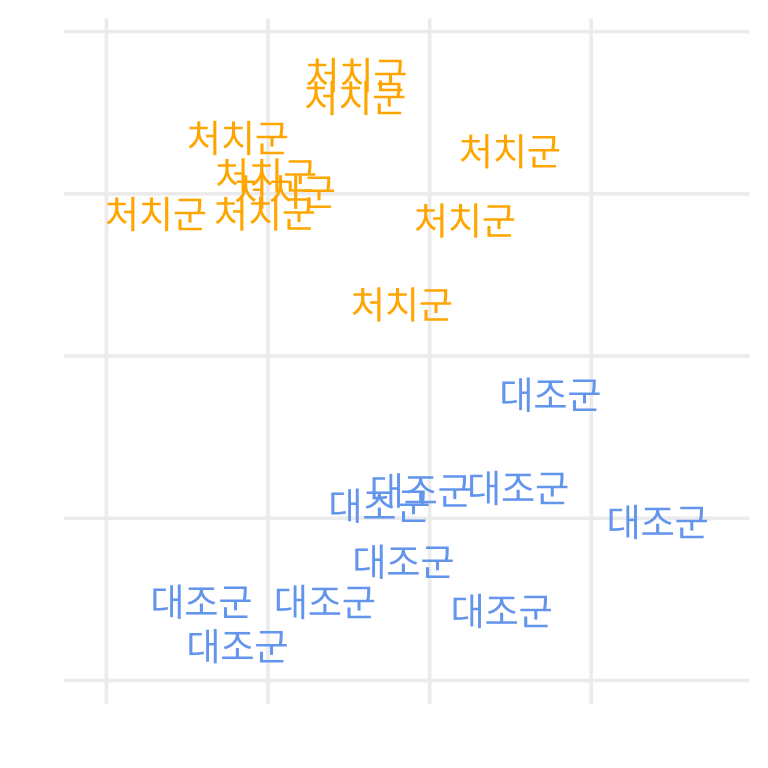
ATE, ATT, ATC, ATM을 목표로 하는 시뮬레이션 예제인 그림 10.20 를 고려해 봅시다. ATE의 경우, 우리는 전체 인구 중에서 매칭되는 짝을 찾습니다. ATT의 경우, 우리는 처치군(treated group)에 대한 짝을 찾으므로, 처치군의 범위를 벗어나는 대조군(untreated) 관측치는 제외될 수 있습니다. ATC의 경우는 그 반대입니다: 우리는 대조군에 대한 짝을 찾으므로, 대조군과 겹치지 않는 처치군 관측치가 제외될 수 있습니다. ATM의 경우, 우리는 대신 두 그룹 사이에 중첩(overlap)이 존재하는 인구 집단에 집중하며, 따라서 어느 그룹이든 좋은 짝이 없는 관측치는 제외될 수 있습니다. 매칭에서, 우리는 캘리퍼를 통해 우리가 수용 가능한 중첩의 수준을 조절합니다.
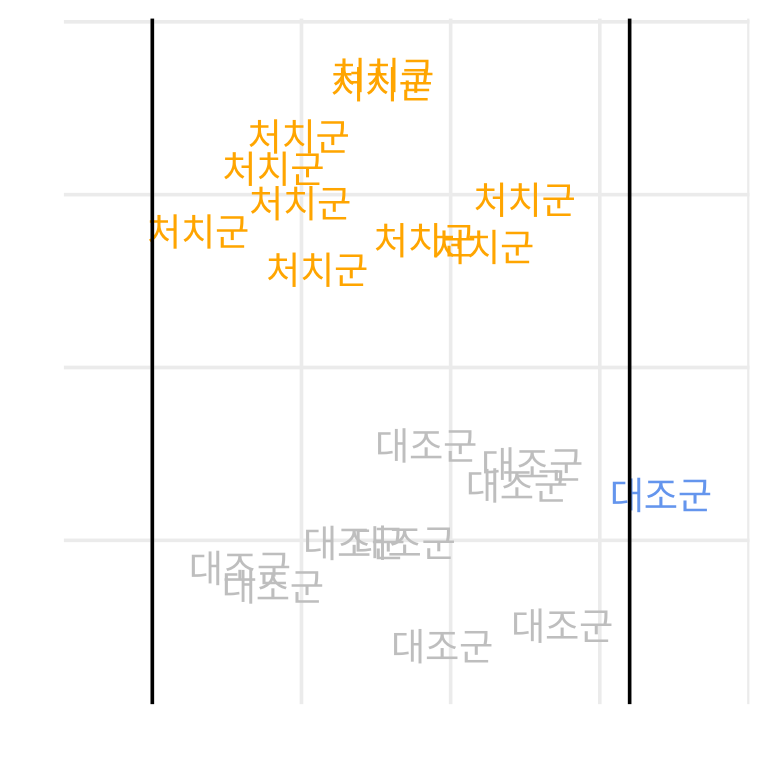
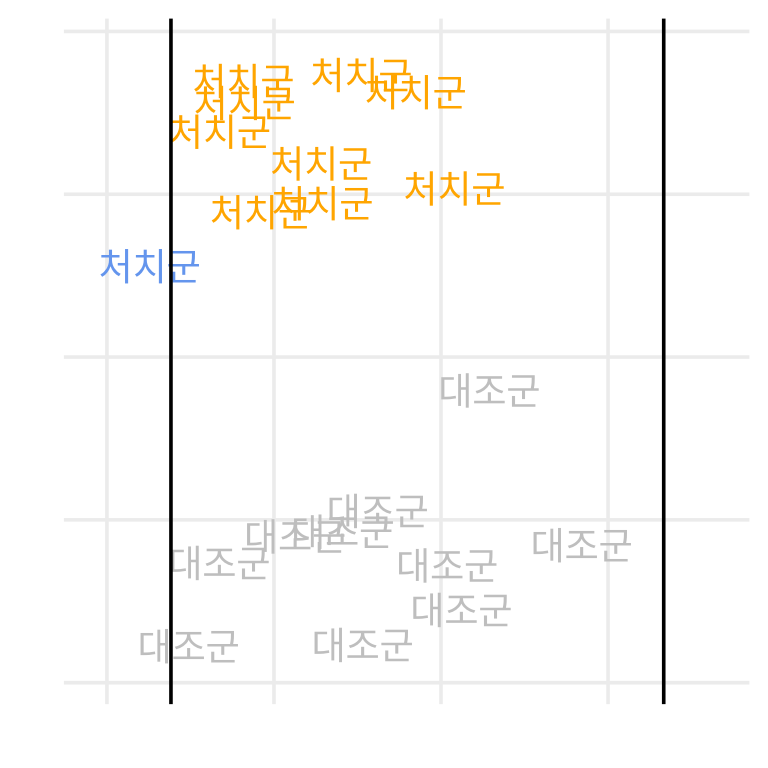
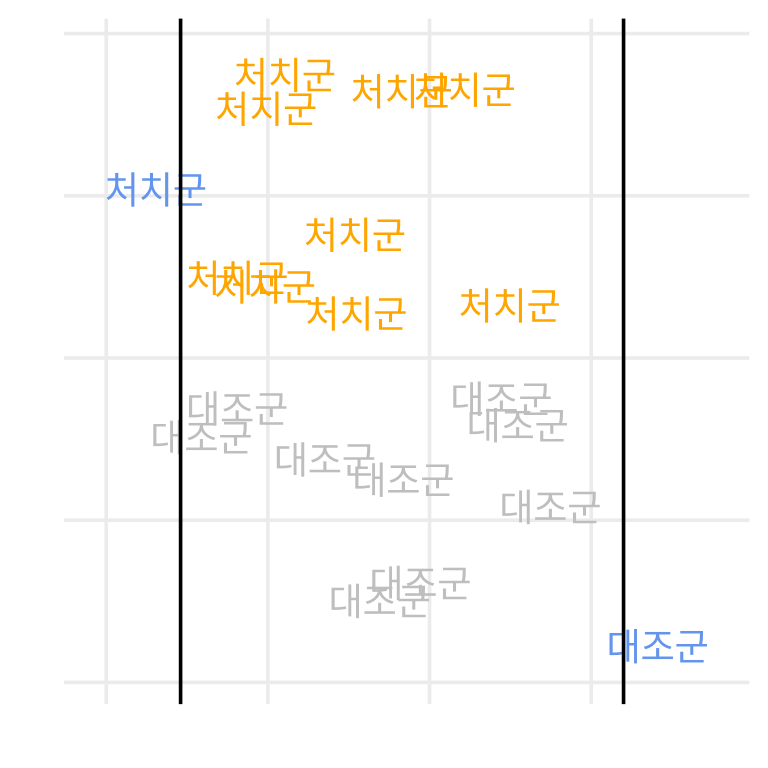
매칭을 사용하면, 우리는 매칭되는 짝이 있는 인구 집단으로 부분 집합을 만듭니다. 이는 우리가 추론을 이끌어낼 인구 집단을 설명하기 위해 가중 표를 사용할 필요가 없음을 의미합니다. 하지만 만약 여러분이 여러 매칭 체계를 탐색하고 있다면 어떨까요? 그런 경우, 데이터의 여러 복사본을 만드는 대신 bind_matches()를 사용하여 원래 데이터셋에서 각 매칭 체계에 대한 (0 또는 1) 가중치를 추적하는 것이 도움이 될 수 있습니다. 그러한 이진 가중치를 사용하여 가중 표를 이용할 수 있습니다.
주어진 분석을 위한 추정 대상을 선택할 때 몇 가지 요소를 고려해야 합니다. 서로 다른 추정 대상은 서로 다른 질문에 답합니다; 이상적으로 우리는 질문과 일치하는 추정 대상을 선택할 것입니다. 예를 들어, 만약 디즈니가 아침 엑스트라 매직 아워가 없는 날에 이를 추가할지 여부를 평가하는 데 관심이 있다면, 여기서 ATU가 관심 있는 추정 대상이 될 것입니다. 우리는 또한 가용한 샘플 크기와 노출군 및 비노출군 관측치의 분포(즉, 유한 표본 편향이 문제가 될 수 있는 지) 등에 근거하여 특정 질문에 답하는 것이 얼마나 실용적인지도 고려해야 합니다. ATE 이외의 다른 추정 대상들은 인과적 가정을 완화해주기 때문에, 데이터가 주어졌을 때 더 실용적인 목표가 될 수 있습니다.
아래는 추정 대상과 이를 추정하기 위한 방법들(R 함수 포함), 그리고 Greifer 와/과 Stuart (2021) 의 표 2에서 확장된 예시 질문들을 요약한 표입니다.
| 추정 대상 | 대상 인구 | 예시 연구 질문 | 매칭 방법 | 가중치 부여 방법 |
|---|---|---|---|---|
| ATE | 전체 인구 | 오후 5-6시 사이의 세븐 드워프 마인 트레인 대기 시간을 변화시키기 위해 모든 아침에 엑스트라 매직 아워를 운영해야 하는가? 특정 정책이 모든 적격 관측치에 적용되어야 하는가? | 전체 매칭 (Full matching), 미세 층화 (Fine stratification) | ATE 가중치, wt_ate()
|
| ATT | 노출된(처치받은) 관측치 | 오후 5-6시 사이의 세븐 드워프 마인 트레인 대기 시간을 변화시키기 위해 엑스트라 매직 아워를 중단해야 하는가? 현재 마케팅 캠페인을 받고 있는 사람들에게 캠페인을 중단해야 하는가? 현재 처치를 받고 있는 환자들에게 의료진이 처치 권장을 중단해야 하는가? | 캘리퍼 없는 쌍 매칭 (Pair matching), 전체 매칭 (Full matching), 미세 층화 (Fine stratification) | ATT 가중치, wt_att()
|
| ATU | 비노출된(대조군) 관측치 | 오후 5-6시 사이의 세븐 드워프 마인 트레인 대기 시간을 변화시키기 위해 모든 날에 엑스트라 매직 아워를 추가해야 하는가? 현재 마케팅 캠페인을 받지 않는 사람들에게 캠페인을 확장해야 하는가? 현재 처치를 받지 않는 환자들에게 의료진이 처치를 확장 권장해야 하는가? | 캘리퍼 없는 쌍 매칭 (Pair matching), 전체 매칭 (Full matching), 미세 층화 (Fine stratification) | ATU 가중치, wt_atu()
|
| ATM | 균등하게 매칭 가능한 집단 | 오후 5-6시 사이의 세븐 드워프 마인 트레인 대기 시간을 변화시키기 위해 엑스트라 매직 아워 제공 여부를 변경해야 할 날들이 있는가? 일부 관측치들에 대해 노출의 효과가 존재하는가? 임상적 평형 상태에 있는 환자들이 처치를 받아야 하는가? | 캘리퍼 매칭 (Caliper matching), 거친 정확 매칭 (Coarsened exact matching), 카디널리티 매칭 (Cardinality matching) | ATM 가중치, wt_atm()
|
| ATO | 중첩된 집단 | ATM과 동일 | ATO 가중치, wt_ato()
|
장 9 에서 논의했듯이, 유효 표본 크기(ESS)는 다양한 추정치들이 얼마나 효율적인지 이해하는 방법입니다. 이는 가중치가 적용된 표본과 동일한 분산을 제공하는 독립적인 관측치의 수를 측정합니다. ESS는 선택한 방법과 추정 과정의 효율성에 대한 일반적인 점검뿐만 아니라, 여러 접근 방식이 연구 질문을 다룰 때 방법들을 선택하는 도구로도 유용합니다.
연구 질문을 다루는 가중치 세트나 매칭 체계가 하나 이상인 경우, 각각의 ESS를 비교하는 것이 선택에 도움이 될 수 있습니다. 다른 모든 조건이 같다면 ESS가장 높은 것을 선택하십시오. halfmoon 패키지의 ess()와 plot_ess()가 이에 도움이 될 수 있습니다. 그림 10.21 에서 우리는 ATE와 ATU 가중치의 ESS가 다른 가중치들보다 훨씬 낮음을 볼 수 있습니다. 다른 가중치들은 모두 비교적 비슷하며, ATO 가중치가 가장 높은 ESS를 가집니다.
library(halfmoon)
seven_dwarfs_wts |>
  plot_ess(.weights = starts_with("w_"))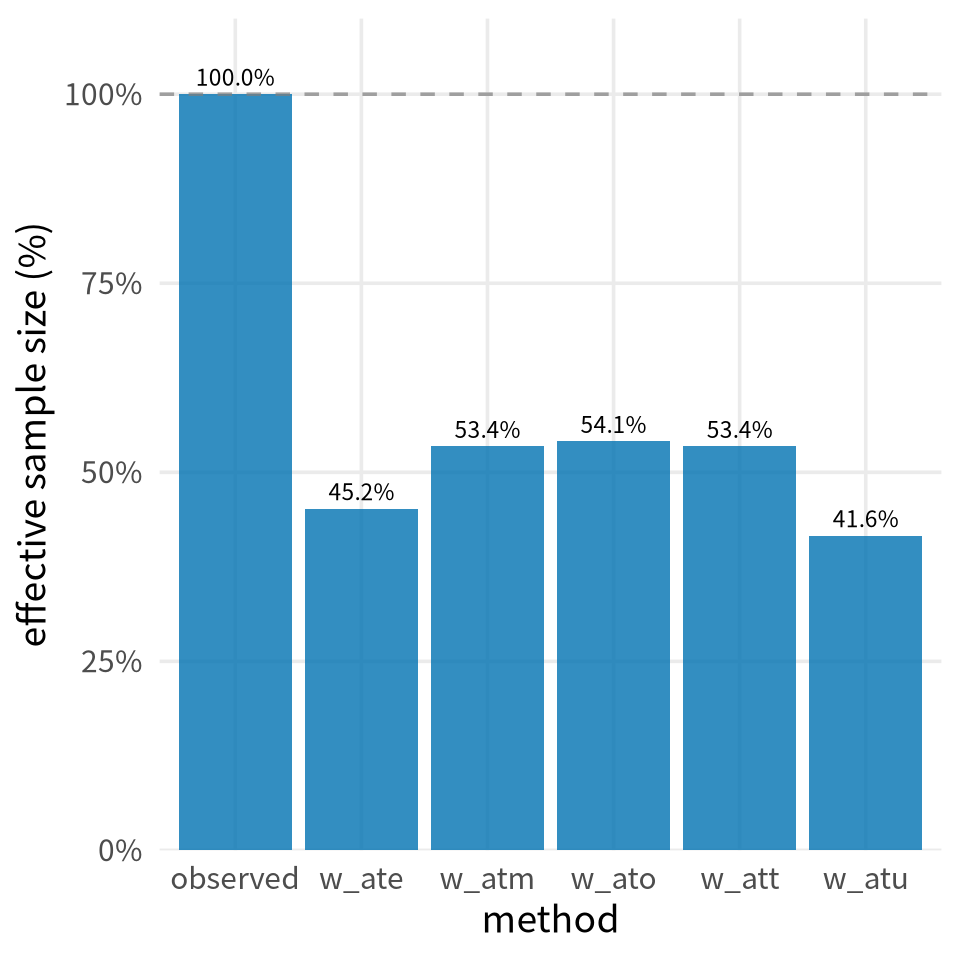
균형(balance)과 정밀도(precision)를 바라보는 근본적인 긴장은 편향-분산 트레이드오프(bias-variance trade-off)입니다. 관찰된 표본 크기가 가장 크지만, 균형은 가장 나쁘고 우리의 연구 질문을 해결하지 못할 수 있습니다. ATO는 가장 좋은 균형과 가장 높은 ESS를 가지지만, 우리의 요구에 맞지 않을 수 있는 특정한 종류의 연구 질문을 다룹니다. 만약 우리가 노출을 무작위 배정했다면, 적어도 평균적으로 그리고 충분히 큰 (실제) 표본 크기에서 가장 좋은 균형과 가장 높은 ESS를 가졌을 것입니다. 그러나 관찰 데이터에서는 종종 편향과 분산 사이에서 타협을 해야 합니다. 가중치 부여가 유효 표본 크기를 줄이기는 하지만, 이는 종종 필요한 타협입니다: 가중치 없이는 정밀하게 추정된 틀린 답을 얻게 될 것이기 때문입니다!
장 6 에서 우리는 다변량 선형 회귀와 같은 표준적인 방법들이 언제 성공하고 실패하는지 논의했습니다. 그렇다면 lm(outcome ~ exposure + confounder)와 같은 회귀 추정량은 어떤 추정 대상을 추정할까요?
간단한 문제들을 탐구하다 보면, 다변량 회귀에서 얻는 답이 종종 ATE 가중치로 얻는 답과 가깝다는 것을 알게 될 것입니다. 만약 노출군들 사이의 분포에서 처치군이나 비처치군의 비율이 불균형하게 높다면, 그 답은 ATT나 ATU에 더 가까울 수 있습니다.
실제로는 우리가 어떤 추정 대상을 다루고 있는지 항상 명확한 것은 아닙니다. 이를 조사하는 한 가지 방법은 선형 회귀로부터 함축된(implied) 가중치를 도출하는 기술을 사용하는 것입니다 (Chattopadhyay 와/과 Zubizarreta 2022; Aronow 와/과 Samii 2015). lmw 패키지를 사용하면 이러한 가중치를 계산할 수 있습니다. 기본값은 ATE에 대한 것이지만, 다른 추정 대상을 목표로 할 수도 있습니다.
이러한 함축된 가중치들은 몇 가지 좋은 속성을 가지고 있습니다. 이들은 평균에 대해 완벽하게 균형을 이루며, 그러한 가중치들 중에서 가장 낮은 분산을 가집니다.
또한 평균이 1이므로, 그 합이 원래 데이터셋의 크기와 같습니다. 유효 표본 크기 또한 관찰된 표본 크기에 비해 높습니다.
# A tibble: 1 × 4
   mean   sum     n   ess
  <dbl> <dbl> <int> <dbl>
1     1   354   354  305.
문제는 이 가중치들이 일관되지 않은(incoherent) 속성들도 가지고 있다는 점입니다. 평균에 대해서는 균형을 맞추지만, 목표 인구 집단에 대해서는 균형을 맞추지 못할 수도 있습니다. 이와 관련하여, 때때로 음수 가중치(negative weights)를 생성하기도 합니다. 예를 들어, 이 모델에 상호작용 항을 추가하면 일부 가중치가 0보다 작아집니다. 음수 가중치는 데이터에 있는 공변량들의 결합 분포를 벗어난 외삽(extrapolation)을 의미합니다. 여기서는 0에 가깝지만, 더 극단적일 수도 있습니다. 따라서 우리가 ATE를 목표로 삼았다 하더라도, 이를 매우 정밀하게 수행하지 못했을 수 있습니다. 즉, 대상 인구 집단이 누구인지 더 이상 명확하지 않게 됩니다.
[1] -0.1113이러한 속성이 연구 주제에 적절하다고 판단된다면, 이 접근 방식은 추가적인 이점을 제공합니다. 이제 결과와 노출 사이의 관계를 미리 들여다보지 않고도 장 8 및 sec-eval-ps-model의 기술을 사용하여 다변량 선형 모델의 균형과 함수 형태를 진단할 수 있습니다. 이들은 단지 가중치일 뿐이므로 halfmoon, gtsummary 등 가중치를 다루는 모든 도구를 여전히 사용할 수 있습니다. lmw 패키지는 로버스트 표준 오차를 포함한 결과 효과를 계산하기 위한 편리한 추정 함수인 lmw_est()도 제공합니다. 따라서 동료들이 OLS를 사용하고 싶어 하지만 여러분은 균형과 외삽에 대해 비판적으로 생각하고 싶을 때, 두 마리 토끼를 다 잡을 수 있습니다. 하지만 음수 가중치나 다른 이상한 속성이 나타난다면, 추정 대상에 따라 다른 접근 방식을 사용하는 것이 더 나을 수 있습니다.
우리는 sec-g-comp장에서 이와 같은 다변량 결과 모델을 사용하여 다른 추정 대상을 목표로 하는 또 다른 방법에 대해 논의할 것입니다.