경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
성향 점수는 연속형 노출을 포함한 다른 여러 노출 유형으로 일반화할 수 있습니다. 주요 작업 흐름은 같습니다. 노출을 결과로 하는 모델을 만든 뒤, 이 모델로 두 번째 결과 모델에 가중치를 줍니다. 연속형 노출일 때 성향을 생성하는 가장 간단한 방법은 선형 회귀입니다. 확률 대신 누적 밀도 함수(cumulative density function)를 사용하며, 이 밀도로 결과 모델에 가중치를 부여합니다.
예시를 살펴보겠습니다. touringplans 데이터셋에는 놀이기구의 게시 대기 시간 정보가 있습니다. 또한 관찰된 실제 대기 시간 데이터도 일부 있습니다. 여기서 다룰 질문은 ’오전 8시 세븐 드워프 마인 트레인의 게시 대기 시간이 오전 9시 실제 대기 시간에 영향을 미치는가?’입니다. 우리의 DAG는 다음과 같습니다.
library(tidyverse)
library(ggdag)
library(ggokabeito)

coord_dag <- list(
  x = c(Season = -1, close = -1, weather = -2, extra = 0, x = 1, y = 2),
  y = c(Season = -1, close = 1, weather = 0, extra = 0, x = 0, y = 0)
)

labels <- c(
  extra = "Extra Magic Morning",
  x = "평균 게시 대기 시간",
  y = "평균 실제 대기 시간",
  Season = "티켓 시즌",
  weather = "과거 최고 기온",
  close = "공원 폐쇄 시간"
)

dagify(
  y ~ x + close + Season + weather + extra,
  x ~ weather + close + Season + extra,
  extra ~ weather + close + Season,
  coords = coord_dag,
  labels = labels,
  exposure = "x",
  outcome = "y"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = c(rep(0, 7), .2, 0, .2, .2, 0), edge_colour = "grey70") +
  geom_dag_point() +
  geom_dag_label_repel(seed = 1602) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(
    legend.position = "none",
    axis.text.x = element_text()
  ) +
  coord_cartesian(clip = "off") +
  scale_x_continuous(
    limits = c(-2.25, 2.25),
    breaks = c(-2, -1, 0, 1, 2),
    labels = c(
      "\n(1년 전)",
      "\n(6개월 전)",
      "\n(3개월 전)",
      "오전 8-9시\n(오늘)",
      "오전 9-10시\n(오늘)"
    )
  )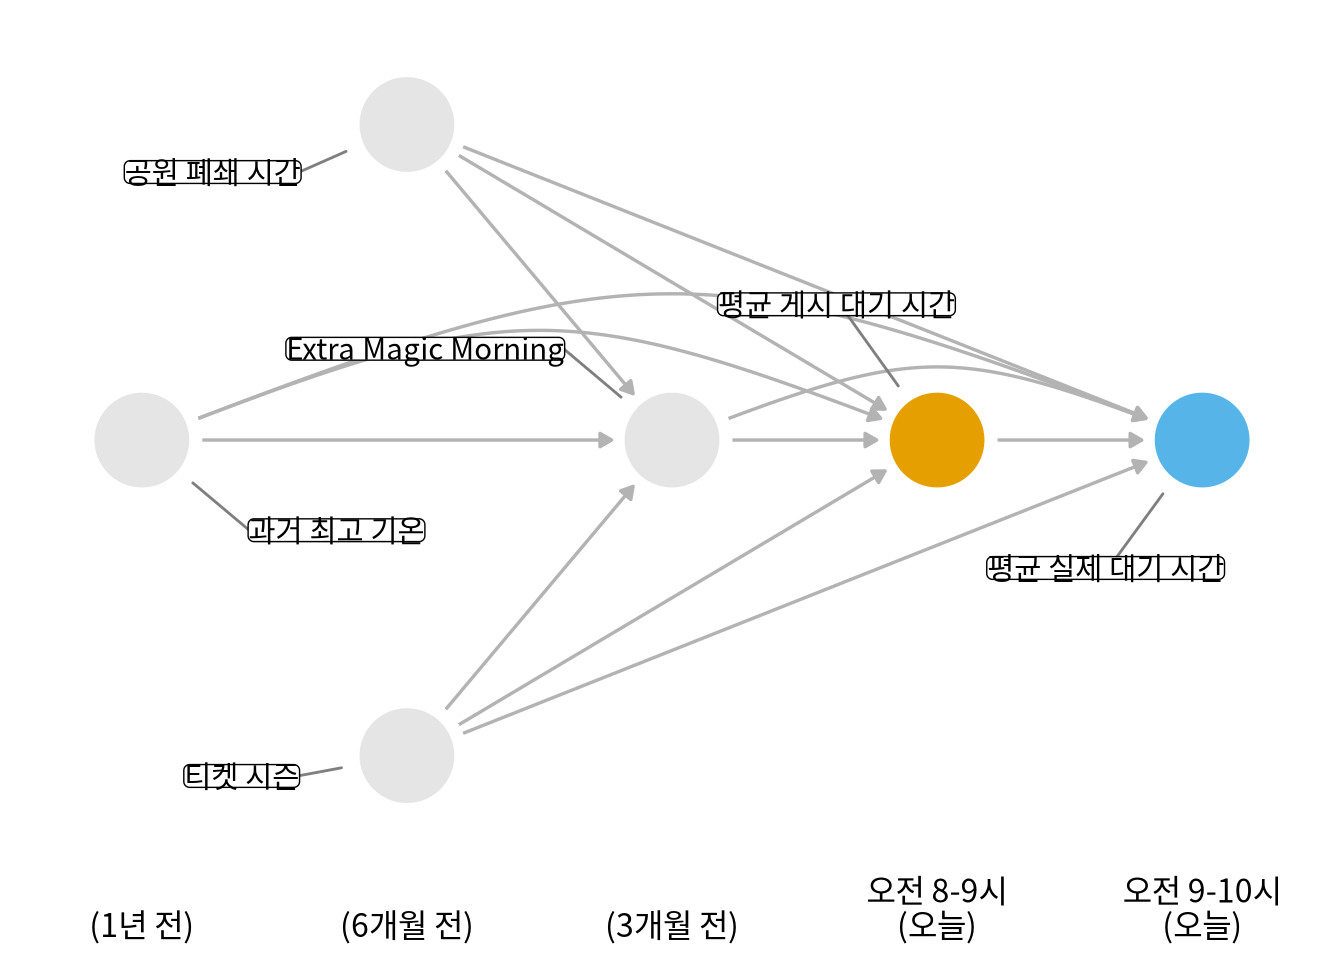
그림 fig-dag-avg-wait에서 주요 교란 요인이 공원 폐쇄 시간, 과거 최고 기온, 그 놀이기구의 아침 엑스트라 매직 아워 여부, 티켓 시즌이라고 가정합니다. 이는 이 DAG에서 유일한 최소 조정 집합(minimal adjustment set)이기도 합니다. 교란 요인은 노출과 결과보다 앞서며, 정의상 노출은 결과보다 앞섭니다. 평균 게시 대기 시간은 이론적으로 조작할 수 있는 노출입니다. 공원에서 예상과는 다른 시간을 게시할 수도 있기 때문입니다.
모델은 이진 노출과 비슷하지만 게시된 시간이 연속형 변수이므로 선형 회귀를 사용합니다. 확률을 쓰지 않으므로 정규 밀도(normal density)에서 가중치 분모를 계산합니다. 그 뒤 dnorm() 함수로 exposure의 정규 밀도를 구하며, 이때 .fitted를 평균으로, mean(.sigma)을 표준 편차로 씁니다.
연속형 노출 가중치는 모델링 선택에 매우 민감합니다. 특히 극단적인 가중치의 존재가 문제인데, 이는 다른 유형의 노출에서도 발생할 수 있습니다. 일부 관측치가 극단적인 가중치를 가질 때 성향이 불안정해져 신뢰 구간이 넓어집니다. 노출의 한계 분포(marginal distribution)를 써서 이를 안정화할 수 있습니다. 성향 점수의 한계 분포를 계산하는 일반적인 방법은 예측 변수가 없는 회귀 모델을 사용하는 것입니다.
극단적인 가중치는 추정치를 불안정하게 만들어 신뢰 구간을 넓게 만듭니다. 극단적인 가중치는 경계가 없는 모든 유형의 가중치(이진 노출 및 기타 유형 포함)에서 문제가 될 수 있습니다. 하지만 ATO(0과 1 사이로 제한됨)와 같은 경계가 있는 가중치는 이러한 문제를 겪지 않으며, 이는 많은 장점 중 하나입니다.
그런 다음, 이를 단순히 역전시키는 대신 numerator / denominator로 가중치를 계산합니다. 우리의 게시 대기 시간 예시에 이를 적용해 봅시다. 먼저, 질문에 답하기 위해 데이터를 정리하겠습니다: 8시의 게시 대기 시간이 9시의 실제 대기 시간에 영향을 미치는가? 우리는 기준점 데이터(모든 공변량과 8시의 게시 대기 시간)를 결과(평균 실제 대기 시간)와 결합할 것입니다. wait_minutes_actual_avg 변수에도 결측치가 많으므로, 일단 관찰되지 않은 값들은 제외하겠습니다.
library(tidyverse)
library(touringplans)
eight <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 8) |>
  select(-wait_minutes_actual_avg)

nine <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  select(park_date, wait_minutes_actual_avg)

wait_times <- eight |>
  left_join(nine, by = "park_date") |>
  drop_na(wait_minutes_actual_avg)
먼저, 분모 모델을 계산해 봅시다. 공변량들을 사용하여 wait_minutes_posted_avg에 대한 모델을 lm()으로 적합시킨 다음, 적합된 예측값(.fitted)을 사용하여 dnorm()으로 밀도를 계산할 것입니다.
library(broom)
denominator_model <- lm(
  wait_minutes_posted_avg ~
    park_close + park_extra_magic_morning + park_temperature_high + park_ticket_season,
  data = wait_times
)

denominators <- denominator_model |>
  augment(data = wait_times) |>
  mutate(
    denominator = dnorm(
      wait_minutes_posted_avg,
      .fitted,
      mean(.sigma, na.rm = TRUE)
    )
  ) |>
select(park_date, denominator, .fitted)denominator의 역수만 사용하면, 다음과 같이 몇 개의 극단적인 가중치가 발생합니다:
denominators |>
  mutate(wts = 1 / denominator) |>
  ggplot(aes(wts)) +
  geom_histogram(fill = "#E69F00", color = "white", bins = 50) +
  scale_x_log10(name = "가중치")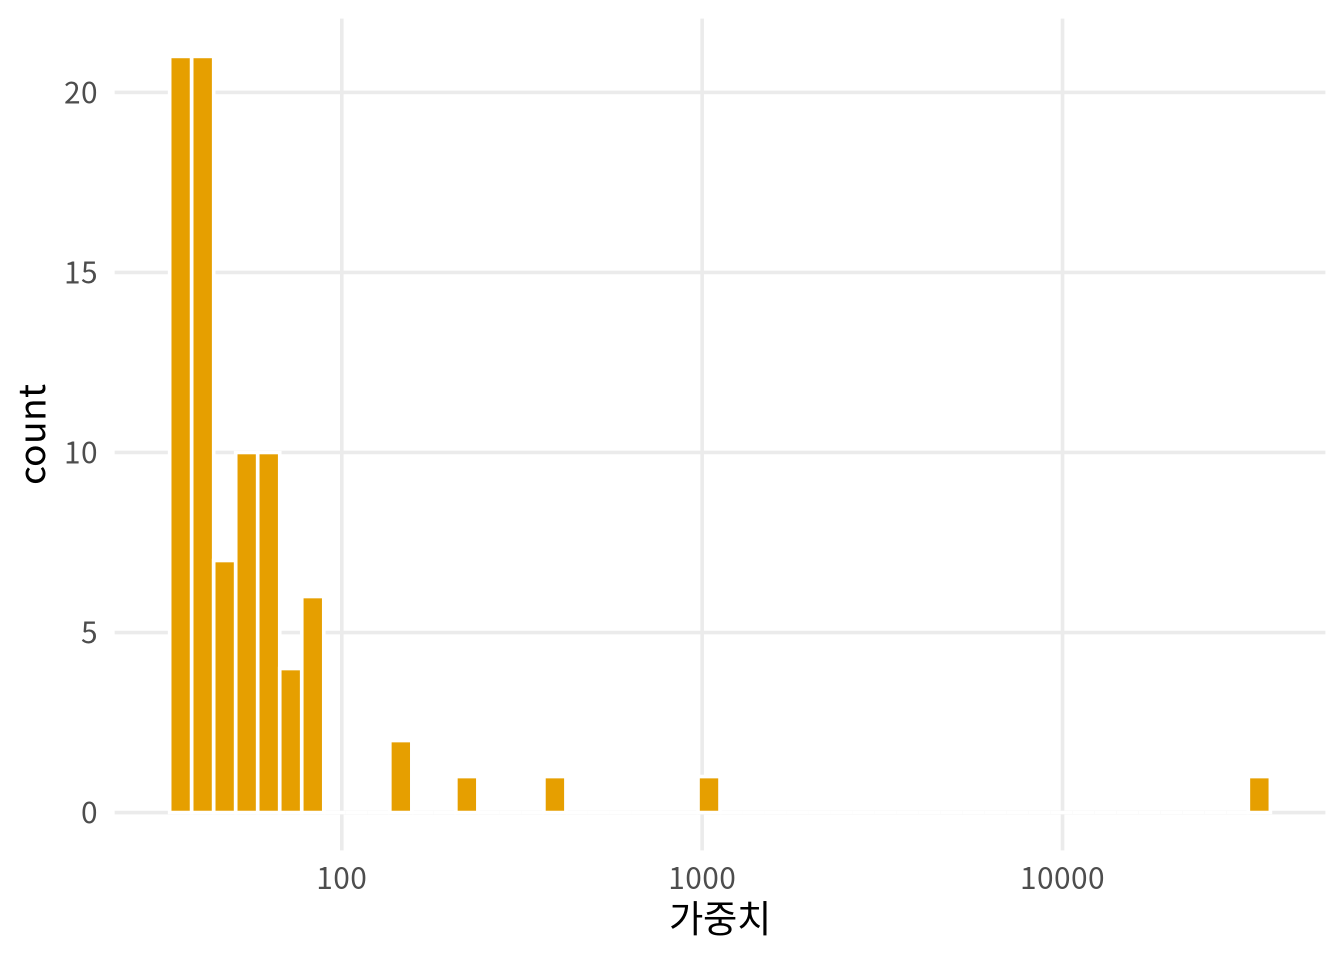
그림 fig-hist-sd-unstable에서 가중치가 100을 넘는 사례 여럿과 10,000을 넘는 사례 하나를 볼 수 있습니다. 이러한 극단적인 가중치는 특정 지점에 과도한 영향을 주어 추정 결과를 복잡하게 만듭니다.
이제 안정화된 가중치에 사용할 분자 밀도를 적합시켜 봅시다:
또한 적합된 값들을 날짜별로 원래 데이터셋에 다시 결합한 다음, numerator / denominator를 사용하여 안정화된 가중치(swts)를 계산해야 합니다.
안정화된 가중치는 훨씬 덜 극단적입니다. 안정화된 가중치는 평균이 1에 가까워야 합니다(이 예시에서는 round(mean(wait_times_wts$swts), digits = 2)입니다); 평균이 1에 가까울 때 가상 인구(즉, 가중치 부여 후의 등가 관측치 수)는 원래 모집단 크기와 같아집니다. 만약 평균이 1에서 멀다면, 모델 오명시나 긍정성 위배의 문제가 있을 수 있습니다 (Hernán 와/과 Robins 2021).
ggplot(wait_times_wts, aes(swts)) +
  geom_histogram(fill = "#E69F00", color = "white", bins = 50) +
  scale_x_log10(name = "가중치")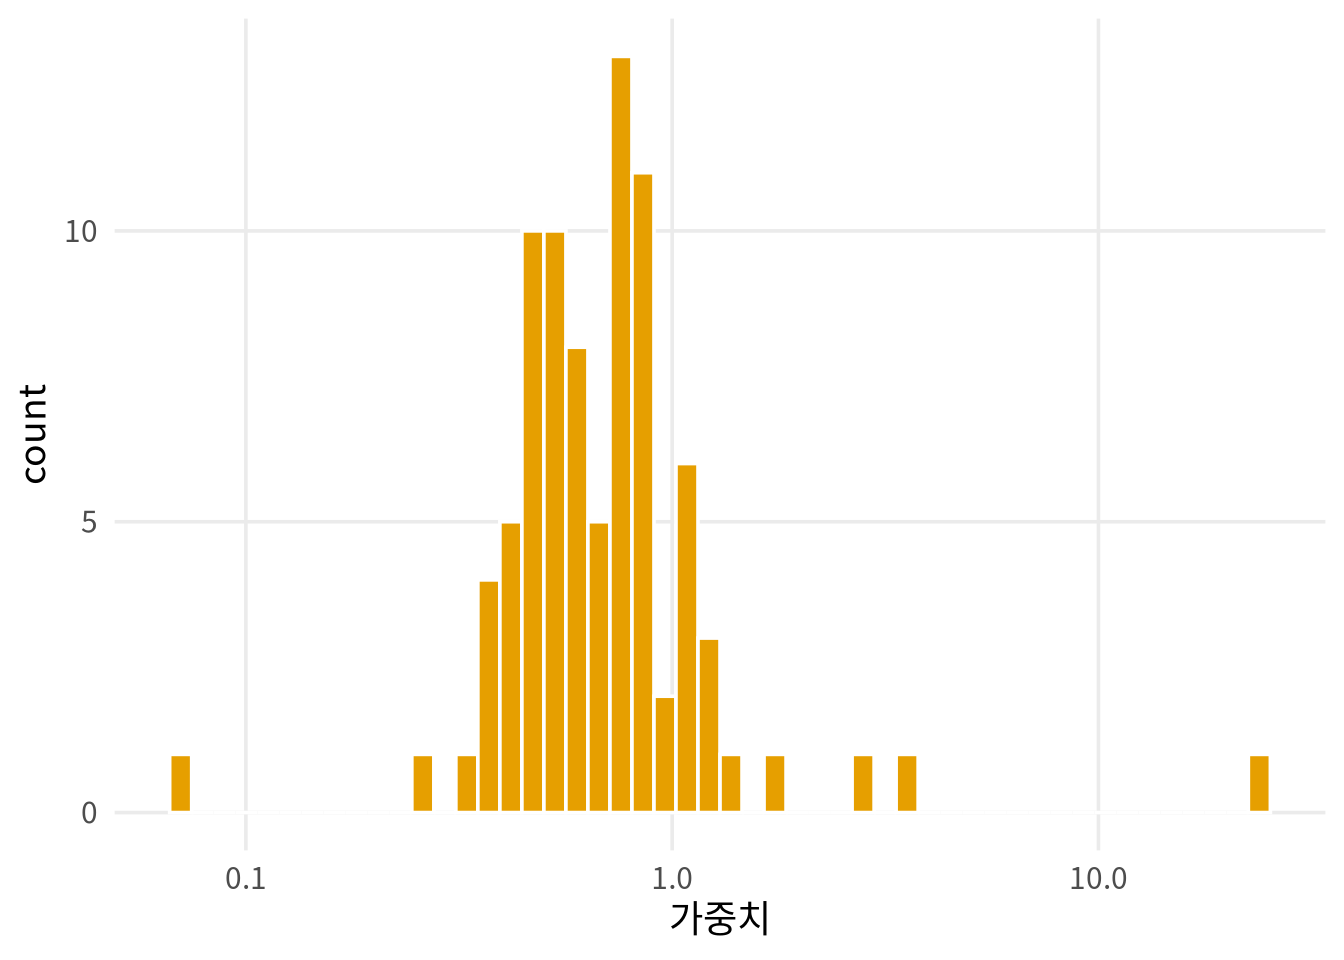
노출 — 평균 게시 대기 시간 — 을 표준화된 가중치와 비교해 보면, 여전히 예외적으로 높은 가중치가 하나 있습니다. 이것이 문제일까요, 아니면 유효한 데이터 포인트일까요?
ggplot(wait_times_wts, aes(wait_minutes_posted_avg, swts)) +
  geom_point(size = 3, color = "grey80", alpha = 0.7) +
  geom_point(
    data = function(x) filter(x, swts > 10),
    color = "firebrick",
    size = 3
  ) +
  geom_text(
    data = function(x) filter(x, swts > 10),
    aes(label = park_date),
    size = 5,
    hjust = 0,
    nudge_x = -15.5,
    color = "firebrick"
  ) +
  scale_y_log10() +
  labs(x = "평균 게시 대기 시간", y = "안정화된 가중치")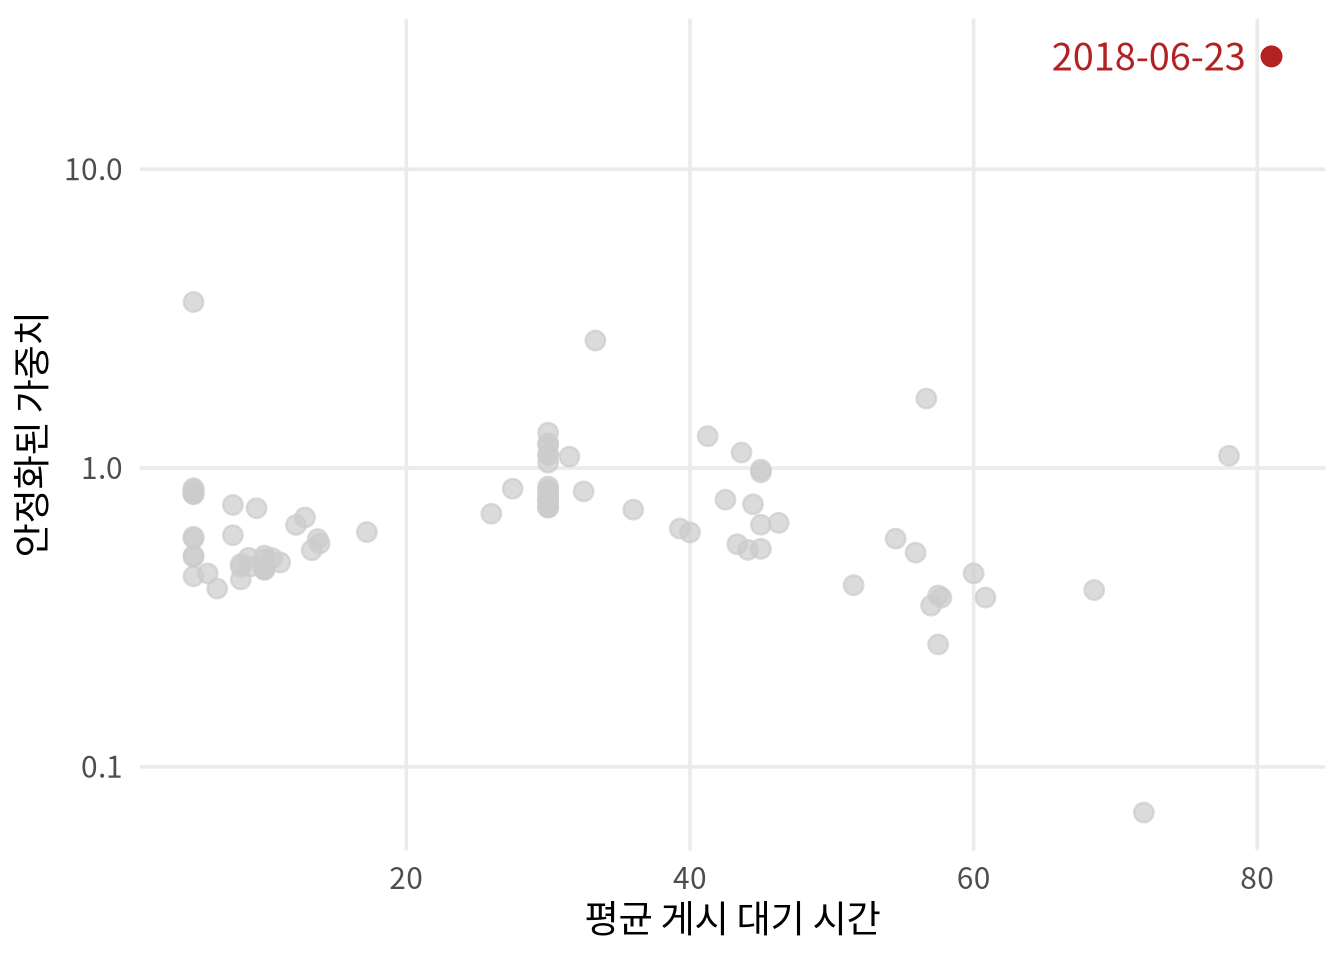
wait_minutes_posted_avg 값을 가진 날들은 몇 가지 예외를 제외하고는 가중치가 낮아지는 경향이 있습니다. 가장 특이한 가중치는 2018년 6월 23일의 데이터입니다.
| park_date | wait_minutes_posted_avg | .fitted | park_close | park_extra_magic_morning | park_temperature_high | park_ticket_season |
|---|---|---|---|---|---|---|
| 2018-06-23 | 81 | 28.1 | 24:00:00 | 0 | 91.36 | regular |
우리의 모델은 관찰된 것보다 훨씬 낮은 게시 대기 시간을 예측했기 때문에, 이 날짜의 가중치가 높아졌습니다. 왜 게시된 시간이 그렇게 높았는지(실제 시간은 훨씬 낮았습니다)는 알 수 없지만, 해당 날짜에 세븐 드워프 마인 트레인의 보물을 파고 있는 플루토(Pluto)의 아티스트 렌더링을 발견했습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
이진 노출과 연속형 노출 외에도, 많은 연구에서 범주형 노출(categorical exposures)을 다루게 됩니다. 예를 들어, 세 가지 치료 옵션(A, B, C) 중 하나, 또는 세 가지 티켓 시즌(peak, regular, value) 중 하나와 같이 세 개 이상의 범주를 가진 노출입니다.
범주형 노출에서도 성향 점수 접근법을 적용할 수 있지만, 이진 노출에 비해 몇 가지 추가적인 고려가 필요합니다.
범주형 노출에서 성향 점수는 각 처치 범주를 받을 확률의 벡터입니다. \(K\)개의 범주가 있는 노출에서 개인 \(i\)에 대한 성향 점수 벡터는 다음과 같습니다.
\[\hat{e}_k(C_i) = P(X_i = k \mid C_i), \quad k = 1, 2, \ldots, K\]
이 확률들의 합은 1입니다: \(\sum_{k=1}^{K} \hat{e}_k(C_i) = 1\).
다항 로지스틱 회귀(multinomial logistic regression)가 범주형 노출의 성향 점수를 추정하는 가장 일반적인 방법입니다.
library(broom)
library(touringplans)
library(dplyr)

# 범주형 노출 예시: 티켓 시즌(peak, regular, value)이 대기 시간에 미치는 영향
seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  drop_na() |>
  mutate(
    # 티켓 시즌을 명시적으로 factor로 지정
    park_ticket_season = factor(
      park_ticket_season,
      levels = c("value", "regular", "peak")  # value를 기준 범주로
    )
  )

cat("티켓 시즌 분포:\n")
티켓 시즌 분포:table(seven_dwarfs_9$park_ticket_season)
  value regular    peak
     41      85      21
# 다항 로지스틱 회귀로 성향 점수 계산
# nnet::multinom()을 사용
# install.packages("nnet")
library(nnet)
# 범주형 노출(티켓 시즌)에 대한 다항 로지스틱 회귀
# 티켓 시즌을 예측하는 교란 요인: 공원 폐쇄 시간, 기온, 엑스트라 매직 아워
ps_model_multinom <- multinom(
park_ticket_season ~
park_close + park_temperature_high + park_extra_magic_morning,
data = seven_dwarfs_9,
trace = FALSE
)
# 각 범주에 대한 예측 확률 (성향 점수)
ps_probs <- predict(ps_model_multinom, type = "probs") |>
as.data.frame() |>
setNames(paste0("ps_", c("value", "regular", "peak")))
head(ps_probs) ps_value ps_regular ps_peak
1 0.09971 0.1886 0.71170
2 0.02337 0.2981 0.67850
3 0.20565 0.3405 0.45383
4 0.40893 0.5029 0.08817
5 0.46433 0.5049 0.03074
6 0.44085 0.5320 0.02714범주형 노출에서 각 개인의 가중치는 실제로 받은 처치를 받을 확률의 역수입니다:
\[w_i = \frac{1}{P(X_i = k_i \mid C_i)} = \frac{1}{\hat{e}_{k_i}(C_i)}\]
# 각 개인의 실제 처치에 해당하는 확률 추출
seven_dwarfs_with_ps <- seven_dwarfs_9 |>
  bind_cols(ps_probs) |>
  mutate(
    # 실제 받은 처치의 성향 점수
    ps_actual = case_when(
      park_ticket_season == "value"   ~ ps_value,
      park_ticket_season == "regular" ~ ps_regular,
      park_ticket_season == "peak"    ~ ps_peak
    ),
    # ATE 가중치 (역확률)
    w_ate = 1 / ps_actual,
    # 안정화된 ATE 가중치
    marginal_prob = case_when(
      park_ticket_season == "value"   ~ mean(park_ticket_season == "value"),
      park_ticket_season == "regular" ~ mean(park_ticket_season == "regular"),
      park_ticket_season == "peak"    ~ mean(park_ticket_season == "peak")
    ),
    w_ate_stable = marginal_prob / ps_actual
  )

cat("ATE 가중치 요약:\n")
ATE 가중치 요약:summary(seven_dwarfs_with_ps$w_ate_stable) Min. 1st Qu. Median Mean 3rd Qu. Max.
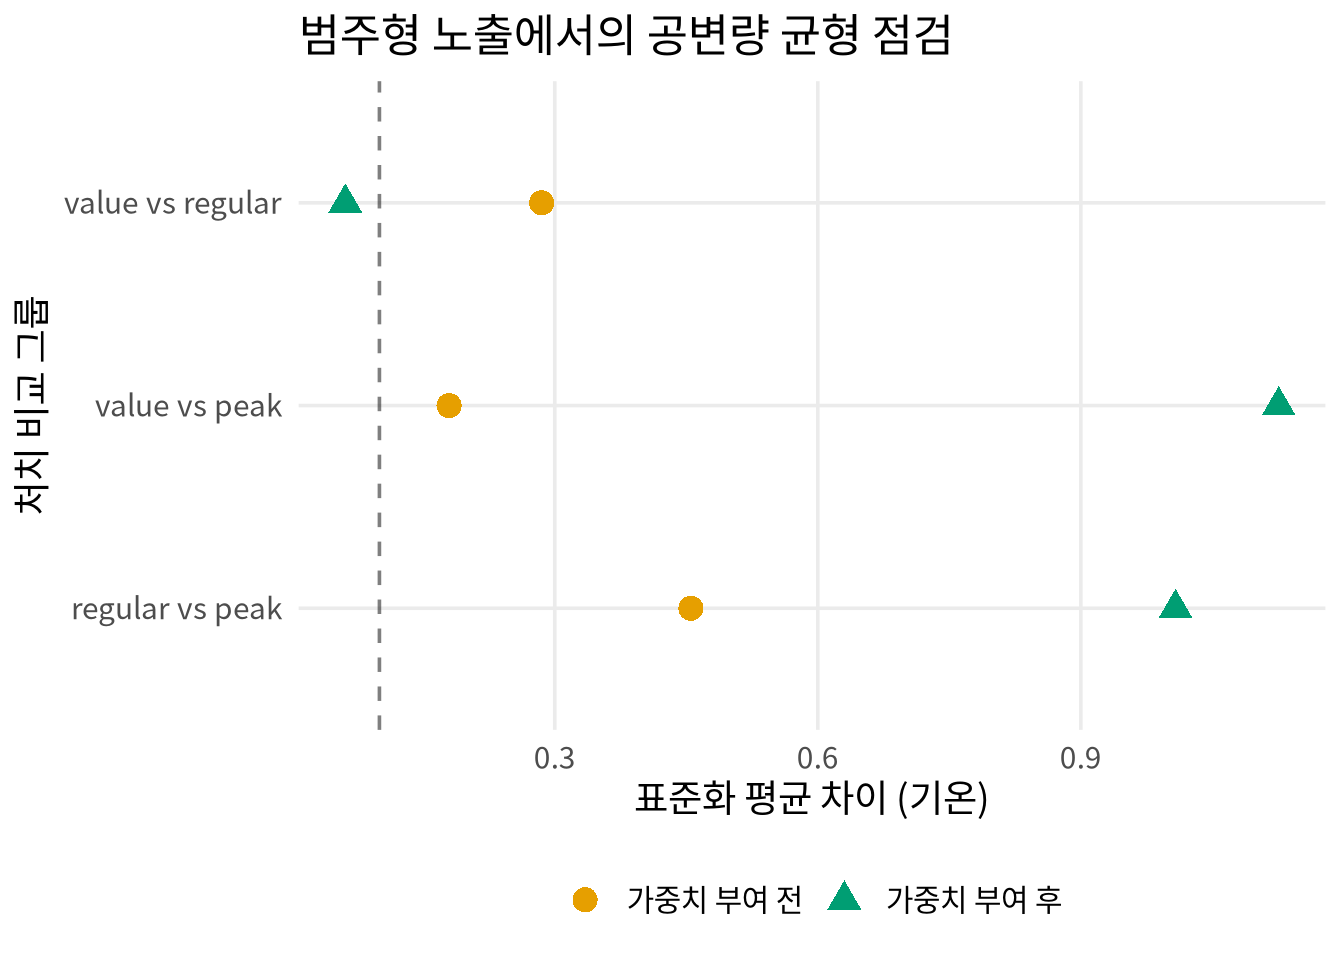
0.201 0.673 0.899 1.045 1.105 17.631 범주형 노출에서 가중치 부여의 효과를 진단하는 방법은 이진 노출과 유사합니다. 각 처치 범주 쌍 사이의 공변량 균형을 확인해야 합니다.
library(ggplot2)

# 각 처치 쌍의 균형 점검 (단순화된 버전)
seasons <- c("value", "regular", "peak")
balance_results <- list()

for (s1 in 1:(length(seasons) - 1)) {
  for (s2 in (s1 + 1):length(seasons)) {
    season_a <- seasons[s1]
    season_b <- seasons[s2]

    subset_data <- seven_dwarfs_with_ps |>
      filter(park_ticket_season %in% c(season_a, season_b))

    # 가중치 부여 전후 온도의 SMD
    preweight_smd <- with(
      subset_data,
      (mean(park_temperature_high[park_ticket_season == season_a]) -
       mean(park_temperature_high[park_ticket_season == season_b])) /
      sd(park_temperature_high)
    )

    postweight_smd <- with(
      subset_data,
      (weighted.mean(park_temperature_high[park_ticket_season == season_a],
                     w_ate_stable[park_ticket_season == season_a]) -
       weighted.mean(park_temperature_high[park_ticket_season == season_b],
                     w_ate_stable[park_ticket_season == season_b])) /
      sd(park_temperature_high)
    )

    balance_results[[paste(season_a, "vs", season_b)]] <- tibble(
      comparison = paste(season_a, "vs", season_b),
      variable = "park_temperature_high",
      before = abs(preweight_smd),
      after = abs(postweight_smd)
    )
  }
}

balance_df <- bind_rows(balance_results) |>
  tidyr::pivot_longer(
    cols = c(before, after),
    names_to = "timing",
    values_to = "smd"
  ) |>
  mutate(timing = factor(timing, levels = c("before", "after"),
                         labels = c("가중치 부여 전", "가중치 부여 후")))

ggplot(balance_df, aes(x = smd, y = comparison, color = timing, shape = timing)) +
  geom_point(size = 4) +
  geom_vline(xintercept = 0.1, linetype = "dashed", alpha = 0.5) +
  scale_color_manual(values = c("가중치 부여 전" = "#E69F00", "가중치 부여 후" = "#009E73")) +
  labs(
    x = "표준화 평균 차이 (기온)",
    y = "처치 비교 그룹",
    color = NULL,
    shape = NULL,
    title = "범주형 노출에서의 공변량 균형 점검"
  )
범주형 노출에서 결과 모델은 기준 범주와 비교한 각 범주의 효과를 추정합니다.
# A tibble: 3 × 7
  term   estimate std.error statistic  p.value conf.low
  <chr>     <dbl>     <dbl>     <dbl>    <dbl>    <dbl>
1 (Inte…    62.2       2.47     25.2  9.65e-55    57.4
2 park_…     4.29      2.92      1.47 1.44e- 1    -1.48
3 park_…    10.2       3.68      2.78 6.13e- 3     2.96
# ℹ 1 more variable: conf.high <dbl>park_ticket_seasonregular와 park_ticket_seasonpeak 계수는 기준 범주(value)에 비해 각 시즌이 평균 게시 대기 시간에 미치는 추정 효과입니다.
범주형 노출에서는 여러 개의 비교(pairwise comparisons)가 가능합니다. \(K\)개의 범주가 있을 때, 가능한 쌍별 비교의 수는 \(\binom{K}{2} = K(K-1)/2\)입니다. 각 쌍별 비교에 대해 별도의 인과 추정치를 보고하거나, 공통 기준 범주와 비교한 효과를 보고할 수 있습니다.
어떤 비교가 인과적으로 의미 있는지는 연구 질문에 따라 다릅니다.