경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
지금까지 살펴본 방법들은 모두 측정되지 않은 교란이 없다(no unmeasured confounding)는 가정에 의존했습니다. 그러나 실제 연구에서는 중요한 교란 요인을 측정할 수 없는 경우가 많습니다.
이 장에서는 측정되지 않은 교란이 있는 상황에서도 인과 효과를 식별할 수 있는 설계 기반(design-based) 방법들을 소개합니다:
도구 변수(instrumental variable, IV)는 노출에는 영향을 미치지만, 노출을 제외하고는 결과에 직접 영향을 미치지 않는 변수입니다.
유효한 도구 변수는 세 가지 조건을 충족해야 합니다:
library(ggdag)
library(ggokabeito)

dagify(
  X ~ Z + U,
  Y ~ X + U,
  coords = list(
    x = c(Z = 0, X = 1, Y = 2, U = 1.5),
    y = c(Z = 0, X = 0, Y = 0, U = 1)
  ),
  labels = c(
    Z = "도구 변수\n(Z)",
    X = "노출 (X)",
    Y = "결과 (Y)",
    U = "측정되지 않은\n교란 요인 (U)"
  ),
  latent = "U"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(aes(x, y, xend = xend, yend = yend, color = status)) +
  geom_dag_edges() +
  geom_dag_point() +
  geom_dag_label_repel(seed = 42) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none")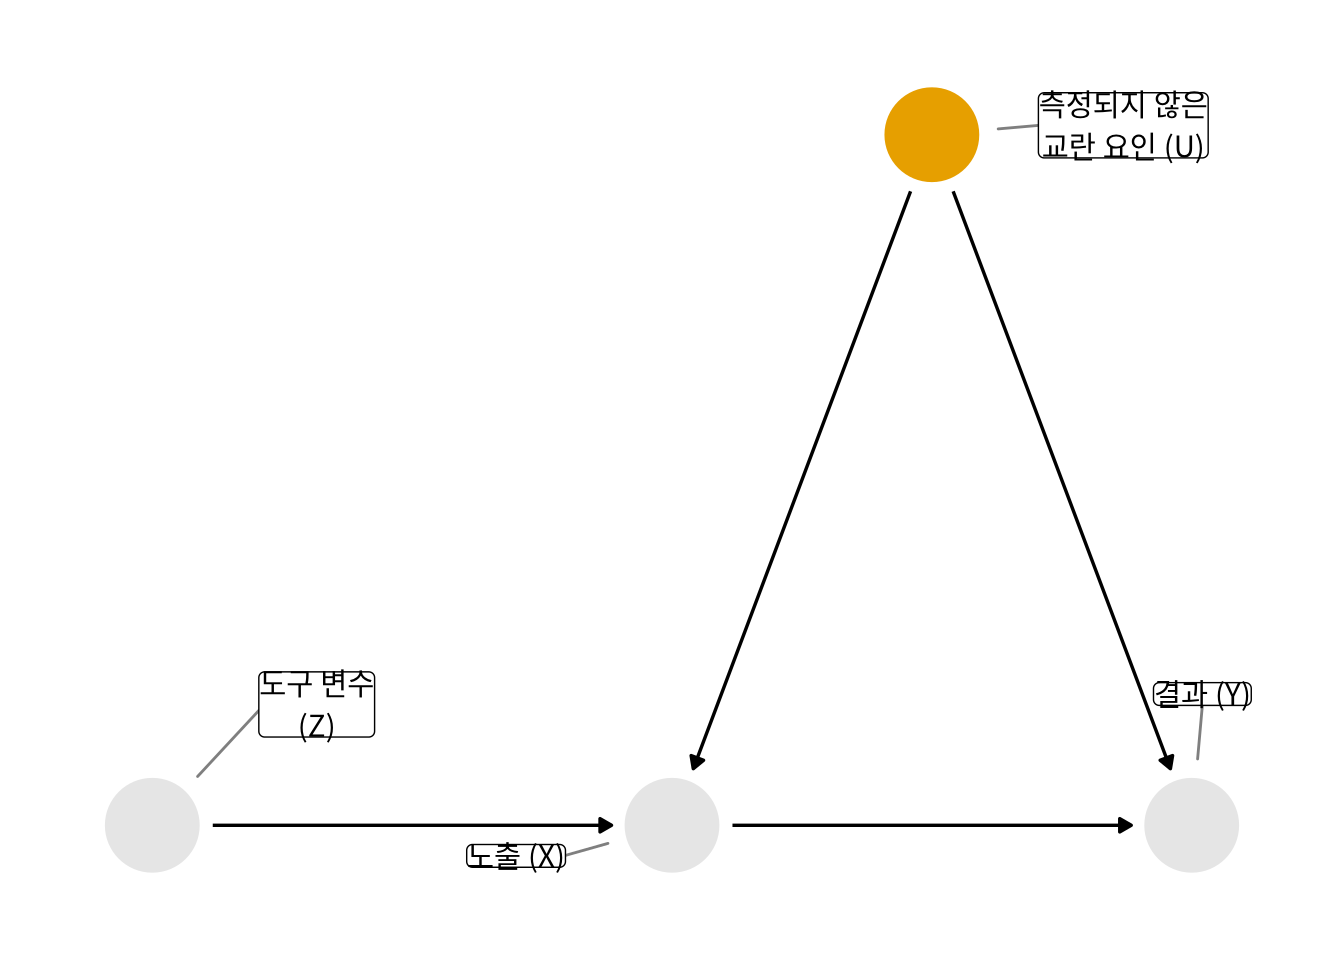
도구 변수 추정의 가장 일반적인 방법은 2단계 최소제곱법(Two-Stage Least Squares, 2SLS)입니다:
1단계: 도구 변수를 사용하여 노출을 예측하는 회귀 모델 적합
\[X = \alpha_0 + \alpha_1 Z + \varepsilon_1\]
2단계: 1단계에서의 예측값(\(\hat{X}\))으로 결과를 예측
\[Y = \beta_0 + \beta_1 \hat{X} + \varepsilon_2\]
\(\beta_1\)이 도구 변수 추정치가 됩니다.
library(dplyr)
library(broom)

# 도구 변수 분석 시뮬레이션 예시
# 의료 복지 프로그램 참여가 건강 결과에 미치는 효과
# 도구 변수: 무작위 배정된 인센티브(추첨)

set.seed(2024)
n <- 1000

# 데이터 생성
iv_data <- tibble(
  u = rnorm(n),                           # 측정되지 않은 교란 (예: 건강 의식)
  z = rbinom(n, 1, 0.5),                  # 도구 변수: 인센티브 배정 (무작위)
  # 노출: 프로그램 참여 (z와 u에 영향 받음)
  x = as.integer(plogis(-1 + 1.5 * z + 0.8 * u) > runif(n)),
  # 결과: 건강 점수 (x와 u에 영향 받음, z와는 x를 통해서만)
  y = 2 * x + 1.5 * u + rnorm(n, sd = 0.5)
)

cat("프로그램 참여율 (z=0):", round(mean(iv_data$x[iv_data$z == 0]), 3), "\n")
프로그램 참여율 (z=0): 0.247 프로그램 참여율 (z=1): 0.615
단순 OLS 추정치 (편향됨): 2.894 1단계 F-통계량 (도구 변수 강도 확인): 160.4
2SLS IV 추정치 (올바른 추정): 2.334 cat("(참 효과: 2.0)\n")(참 효과: 2.0)중요한 점은, 표준 IV는 전체 인구에서의 ATE가 아닌 지역 평균 처치 효과(Local Average Treatment Effect, LATE)를 추정한다는 것입니다. LATE는 도구 변수로 인해 처치 상태가 변한 사람들(“순응자, compliers”)에서의 평균 처치 효과입니다.
회귀 불연속 설계(Regression Discontinuity Design, RDD)는 처치 배정이 연속형 변수(점수, 등급 등)의 임계값을 기준으로 결정될 때 사용합니다. 임계값 주변에서 배정은 사실상 무작위적이라고 볼 수 있어, 인과 효과를 식별할 수 있습니다.
library(ggplot2)

# RDD 시뮬레이션: 입학 시험 점수를 기준으로 한 장학금 배정
set.seed(2024)
n <- 500
threshold <- 60  # 장학금 기준 점수

rdd_data <- tibble(
  score = runif(n, 40, 80),               # 입학 시험 점수
  treatment = as.integer(score >= threshold),  # 장학금 배정
  u = rnorm(n),                           # 측정되지 않은 개인 특성
  # 결과: GPA (장학금이 5점 향상 효과, 점수/u도 영향)
  outcome = 2 + 0.05 * score + 5 * treatment + 0.3 * u + rnorm(n)
)

ggplot(rdd_data, aes(x = score, y = outcome, color = factor(treatment))) +
  geom_point(alpha = 0.4, size = 1.5) +
  geom_smooth(method = "lm", se = TRUE, formula = y ~ x) +
  geom_vline(xintercept = threshold, linetype = "dashed", linewidth = 1.2) +
  scale_color_manual(
    values = c("0" = "#E69F00", "1" = "#009E73"),
    labels = c("0" = "장학금 없음", "1" = "장학금 있음")
  ) +
  labs(
    x = "입학 시험 점수",
    y = "GPA",
    color = NULL,
    title = "회귀 불연속 설계: 장학금이 GPA에 미치는 효과"
  ) +
  annotate("text", x = threshold + 0.5, y = max(rdd_data$outcome) - 0.5,
           label = "임계값", hjust = 0, color = "black")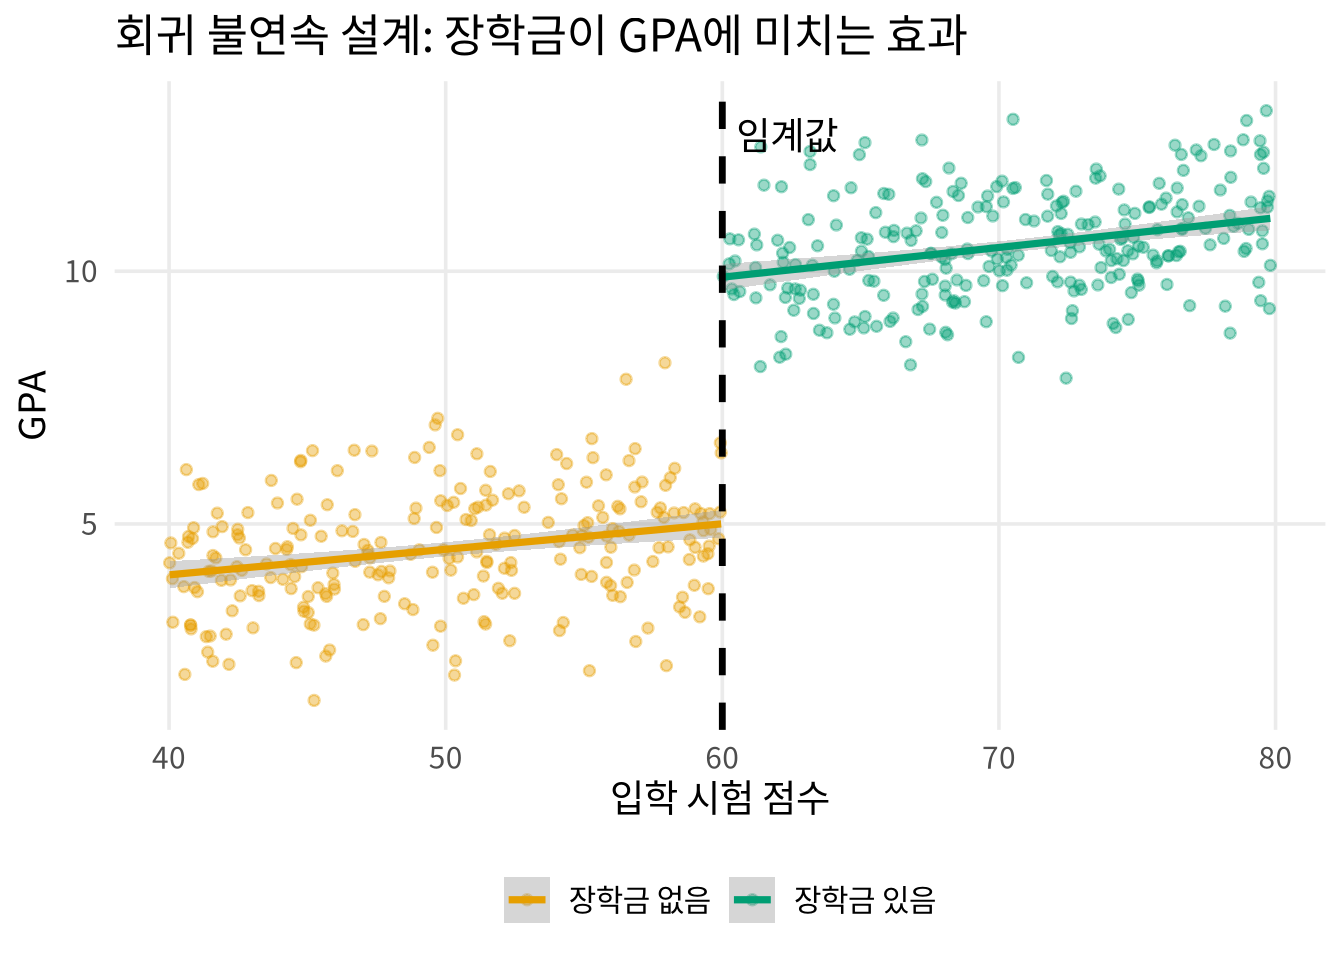
# RDD 추정: 임계값 주변 좁은 대역(bandwidth) 사용
bandwidth <- 10

rdd_subset <- rdd_data |>
  filter(abs(score - threshold) <= bandwidth)

# 임계값 기준으로 중심화된 점수 변수 생성
rdd_subset <- rdd_subset |>
  mutate(score_centered = score - threshold)

# RDD 추정치: 임계값에서의 불연속성
rdd_fit <- lm(
  outcome ~ score_centered * treatment,
  data = rdd_subset
)

tidy(rdd_fit, conf.int = TRUE)
# A tibble: 4 × 7
term estimate std.error statistic p.value conf.low
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Inte… 4.92 0.185 26.6 4.10e-73 4.56
2 score… 0.0383 0.0322 1.19 2.35e- 1 -0.0251
3 treat… 5.04 0.281 17.9 5.28e-46 4.48
4 score… 0.00928 0.0474 0.196 8.45e- 1 -0.0840
# ℹ 1 more variable: conf.high <dbl>treatment 계수가 임계값에서의 처치 효과 추정치입니다 — 이것이 RDD가 추정하는 것입니다.
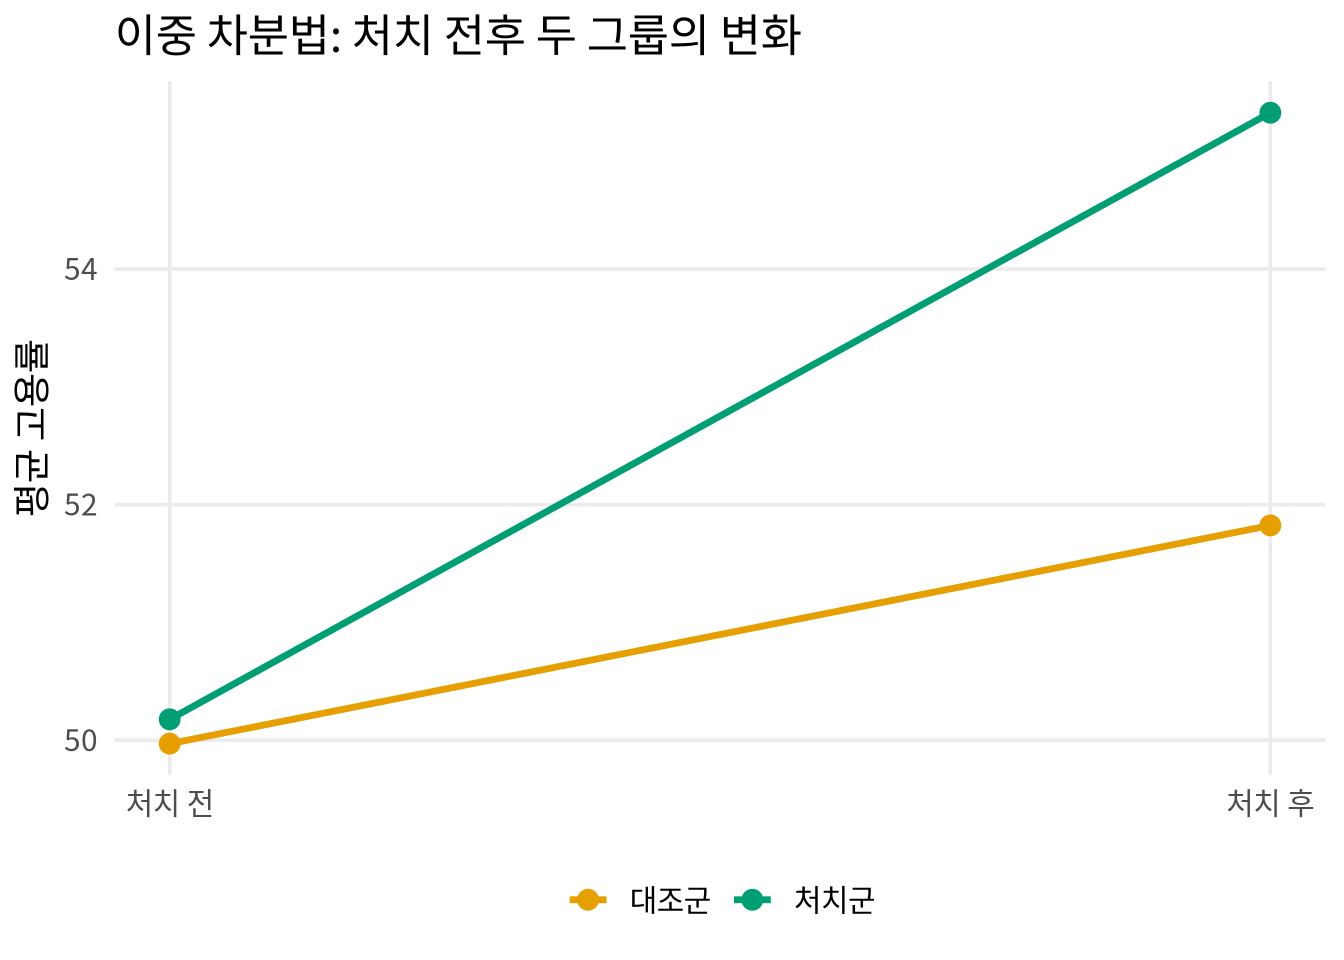
이중 차분법(Difference-in-Differences, DiD)은 처치 전후의 두 시점에서의 데이터를 사용하여 처치 효과를 추정합니다. 이 방법은 관찰되지 않는 고정된 개인 특성(time-invariant unobserved confounders)을 통제할 수 있습니다.
DiD의 핵심 가정은 평행 추세(parallel trends) 가정입니다: 처치를 받지 않았다면, 처치군과 대조군은 시간에 따라 동일한 방향으로 변화했을 것이라는 가정입니다.
# DiD 시뮬레이션: 최저임금 인상이 고용에 미치는 효과 (Card & Krueger 1994 스타일)
set.seed(2024)
n_units <- 100  # 각 그룹의 지역 수

did_data <- tibble(
  unit = rep(1:(2 * n_units), each = 2),
  time = rep(c("before", "after"), 2 * n_units),
  treatment_group = rep(c(rep(0, n_units), rep(1, n_units)), each = 2),
  # 측정되지 않은 지역 고정 효과
  unit_effect = rep(rnorm(2 * n_units, 0, 2), each = 2),
  # 공통 시간 추세
  time_trend = ifelse(time == "before", 0, 1),
  # 처치 더미 (after × treatment)
  treated = as.integer(treatment_group == 1 & time == "after"),
  # 결과: 고용률 (처치 효과 = 3%)
  employment = 50 + unit_effect + 2 * time_trend +
    3 * treated + rnorm(2 * n_units * 2)
) |>
  arrange(unit, time)

cat("DiD 데이터 구조 (첫 8행):\n")
DiD 데이터 구조 (첫 8행):# A tibble: 8 × 7
unit time treatment_group unit_effect time_trend
<int> <chr> <dbl> <dbl> <dbl>
1 1 after 0 1.96 1
2 1 before 0 1.96 0
3 2 after 0 0.937 1
4 2 before 0 0.937 0
5 3 after 0 -0.216 1
6 3 before 0 -0.216 0
7 4 after 0 -0.426 1
8 4 before 0 -0.426 0
# ℹ 2 more variables: treated <int>, employment <dbl>did_summary <- did_data |>
group_by(treatment_group, time) |>
summarize(mean_employment = mean(employment), .groups = "drop") |>
mutate(
group_label = ifelse(treatment_group == 1, "처치군", "대조군"),
time_num = ifelse(time == "before", 0, 1)
)
ggplot(did_summary, aes(x = time_num, y = mean_employment,
color = group_label, group = group_label)) +
geom_point(size = 3) +
geom_line(linewidth = 1.2) +
scale_x_continuous(breaks = c(0, 1), labels = c("처치 전", "처치 후")) +
scale_color_manual(values = c("처치군" = "#009E73", "대조군" = "#E69F00")) +
labs(
x = NULL,
y = "평균 고용률",
color = NULL,
title = "이중 차분법: 처치 전후 두 그룹의 변화"
)
# A tibble: 4 × 7
  term   estimate std.error statistic  p.value conf.low
  <chr>     <dbl>     <dbl>     <dbl>    <dbl>    <dbl>
1 (Inte…   50.0       0.219   228.    0          49.5
2 treat…    0.206     0.309     0.667 5.05e- 1   -0.402
3 time_…    1.85      0.309     5.99  4.79e- 9    1.24
4 treat…    3.30      0.438     7.53  3.41e-13    2.44
# ℹ 1 more variable: conf.high <dbl>
treated 계수가 DiD 추정치입니다. 이는 처치그룹이 처치 후 시점에서 보인 변화에서 대조군의 시간적 추세를 뺀 차이입니다.
\[\hat{\tau}_{DiD} = (\bar{Y}_{T,post} - \bar{Y}_{T,pre}) - (\bar{Y}_{C,post} - \bar{Y}_{C,pre})\]
여기서 T는 처치군, C는 대조군, post와 pre는 처치 후와 처치 전을 의미합니다. 이 추정량이 인과적 의미를 갖기 위해서는 평행 추세 가정이 충족되어야 합니다.