노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
이 장에서는 이 책에서 배우는 기술을 활용해 데이터를 직접 분석해 보겠습니다. 다음과 같은 핵심 단계들을 거치며 인과 분석의 전체 게임(whole game)을 실행해 볼 것입니다.
여기서는 각 단계에 담긴 핵심 개념과 전체적인 흐름을 파악하는 데 집중하겠습니다. 모든 내용을 한꺼번에 완벽히 이해하지 못해도 괜찮습니다. 구체적인 내용은 이어지는 장들에서 자세히 다룹니다.
이번 연습에서 답을 찾아볼 인과적 질문은 다음과 같습니다. “모기장(bed net) 사용이 말라리아 위험을 낮추는가?”
말라리아는 여전히 심각한 공중보건 문제입니다. 2000년 이후 말라리아 발생률은 전반적으로 감소했지만, 2020년 코로나19 팬데믹 기간에는 의료 서비스 중단 등의 여파로 사례와 사망자가 다시 늘어났습니다 (“World Malaria Report” 2021). 말라리아 사망자의 약 86%가 29개국에 집중되어 있습니다. 전체 사망자의 거의 절반이 나이지리아(27%), 콩고민주공화국(12%), 우간다(5%), 모잠비크(4%), 앙골라(3%), 부르키나파소(3%) 등 6개국에서 발생했습니다. 특히 사망자 대부분은 5세 미만 어린이입니다 (Fink 기타 2022). 말라리아는 임산부에게도 치명적이며 조산이나 저체중아 출산 등 임신 결과에 악영향을 미칩니다.
모기장은 말라리아 기생충의 주요 숙주인 모기에게 물리지 않도록 물리적 장벽을 제공하여 질병과 사망을 예방합니다. 인류는 아주 오래전부터 모기장을 사용해 왔습니다. 기원전 5세기 그리스의 역사학자 헤로도토스(Herodotus)는 역사(The Histories)에서 이집트인들이 낚시 그물을 모기장 대용으로 쓰는 모습을 기록했습니다.
늪지대 위에 사는 사람들은 수많은 각다귀(gnats)를 피해 높은 타워 위에서 휴식을 취합니다. 각다귀는 바람 때문에 높이 날지 못하기 때문입니다. 타워를 세우기 어려운 지역의 사람들은 투망(casting net)을 활용합니다. 낮에는 물고기를 잡는 데 쓰고, 밤에는 침대 주위에 그물을 둘러 그 안에서 잠을 잡니다. 옷이나 리넨 시트는 각다귀가 뚫고 물 수 있지만, 그물은 통과하지 못합니다 (Macaulay 2008).
현대의 모기장은 제2차 세계 대전 당시 러시아 군인들의 사례에서 착안해 살충제 처리가 된 경우가 많지만 (Nevill 기타 1996), 여전히 낚시 그물로 전용되는 사례도 종종 발견됩니다 (Gettleman 2015).
이 질문을 확인하기 위한 무작위 시험을 상상하는 건 어렵지 않습니다. 참가자를 무작위로 배정해 모기장 사용 여부를 결정하고, 일정 기간 뒤 두 그룹 간의 말라리아 위험 차이를 비교하는 것입니다. 인과 효과를 추정할 때 무작위 배정(Randomization)은 가장 강력한 수단입니다. 분석 결과가 유효하기 위해 필요한 가정의 수를 크게 줄여주기 때문입니다(자세한 내용은 sec-assump장에서 다룹니다). 특히 무작위 배정은 교란(confounding) 문제를 효과적으로 해결하며, 우리가 미처 파악하지 못한 교란 요인들까지도 골고루 배분해 줍니다.
1990년대의 몇몇 획기적인 시험들은 모기장 사용이 말라리아 위험에 미치는 효과를 연구했습니다. 2004년의 메타 분석에 따르면 살충제 처리 모기장은 (모기장을 사용하지 않는 경우에 비해) 아동 사망률을 17%, 말라리아 기생충 유병률을 13%, 그리고 단순 및 중증 말라리아 사례를 약 50% 감소시켰습니다 (Lengeler 2004). 세계보건기구(WHO)가 살충제 처리 모기장을 권장하기 시작한 이후, 살충제 저항성은 큰 우려 사항이 되었습니다. 그러나 시험들에 대한 후속 분석 결과, 그것이 아직 모기장의 공중보건상 이점에 영향을 미치지는 않은 것으로 나타났습니다 (Pryce, Richardson, 와/과 Lengeler 2018).
시험들은 또한 모기장 프로그램의 경제성을 결정하는 데 영향력이 있었습니다. 예를 들어, 한 시험에서는 무료 모기장 배포와 비용 분담 프로그램(참가자가 보조금을 받는 수수료를 지불하는 방식)을 비교했습니다. 연구 저자들은 모기장 수용도가 두 그룹 간에 비슷했으며, 접근이 더 쉬웠던 무료 모기장 배포가 더 많은 생명을 구했고, 구한 생명당 비용도 비용 분담 프로그램보다 저렴하다는 것을 발견했습니다 (Cohen 와/과 Dupas 2010).
윤리, 비용, 시간 등 말라리아 위험에 대한 모기장 사용 효과를 추정하기 위한 새로운 무작위 시험을 수행할 수 없는 몇 가지 이유가 있습니다. 우리는 모기장 사용을 지지하는 실질적이고 견고한 증거를 가지고 있지만, 관측 데이터에 기반한 인과 추론이 도움이 될 수 있는 몇 가지 상황을 고려해 봅시다.
이 주제에 대한 시험이 이루어지기 전의 시점을 상상해 보십시오. 사람들이 이미 스스로 이러한 목적으로 모기장을 사용하기 시작했다고 가정해 봅시다. 우리의 목표는 여전히 무작위 시험을 수행하는 것일 수 있지만, 관찰된 데이터를 통해 더 빨리 질문에 답할 수 있습니다. 또한 이 연구 결과는 시험 설계나 중간 정책 제안의 가이드가 될 수 있습니다.
때로는 시험을 수행하는 것이 윤리적이지 않을 수도 있습니다. 말라리아 연구에서 이러한 사례의 예는 모기장 효과 연구에서 제기된 질문입니다: 유아기의 말라리아 통제가 질병에 대한 면역 형성을 지연시켜, 결과적으로 인생 후반기에 중증 말라리아나 사망을 초래하는가? 우리는 이제 모기장 사용이 매우 효과적이라는 것을 알고 있기 때문에, 모기장을 지급하지 않는 것은 비윤리적일 것입니다. 최근의 한 관찰 연구는 유아기 모기장 사용이 모든 원인으로 인한 사망률에 미치는 이점이 성인기까지 지속됨을 발견했습니다 (Fink 기타 2022).
우리는 또한 이전 시험과 다른 효과를 추정하거나 다른 인구 집단에 대한 효과를 추정하고 싶을 수도 있습니다. 예를 들어, 무작위 시험과 관찰 연구 모두 살충제 처리 모기장이 (사용률이 충분히 높기만 하다면) 모기장을 사용하는 사람들뿐만 아니라 전체 지역 사회의 말라리아 저항력을 향상시킨다는 점을 더 잘 이해하도록 도왔습니다 (Howard 기타 2000; Hawley 기타 2003).
장 6 및 장 13 에서 보겠지만, 이 책에서 논의할 인과 추론 기술들은 무작위 배정이 가능한 상황에서도 종종 유익합니다.
관찰 연구를 수행할 때도 가능하다면 실행했을 무작위 시험을 끝까지 생각해보는 것이 여전히 도움이 됩니다. 이 인과 분석에서 우리가 모방하려는 시험은 목표 시험(target trial)입니다. 목표 시험을 고려하는 것은 우리의 인과적 질문을 더 정밀하게 만드는 데 도움이 됩니다. 우리는 섹션 3.4 에서 이 프레임워크를 더 명시적으로 사용할 것이지만, 지금은 앞서 제기된 인과적 질문을 고려해 봅시다: 모기장(모기 그물)을 사용하는 것이 말라리아 위험을 줄이는가? 이 질문은 비교적 간단해 보이지만 여전히 모호합니다. 장 1 에서 보았듯이, 우리는 몇 가지 핵심 영역을 명확히 해야 합니다:
“모기장”이란 무엇을 의미하는가? 모기장에는 여러 종류가 있습니다: 처리되지 않은 모기장, 살충제 처리 모기장, 그리고 최근의 지속성 살충제 처리 모기장.
무엇과 비교한 위험인가? 예를 들어, 살충제 처리 모기장을 모기장을 사용하지 않는 경우와 비교하는 것입니까? 처리되지 않은 모기장과 비교하는 것입니까? 아니면 지속성 살충제 처리 모기장과 같은 새로운 유형의 모기장을 이미 사용 중인 모기장과 비교하는 것입니까?
무엇에 의해 정의된 위험인가? 사람이 말라리아에 걸렸는지 여부입니까? 사람이 말라리아로 사망했는지 여부입니까?
누구 사이에서의 위험인가? 우리는 이 지식을 어떤 인구 집단에 적용하려고 합니까? 우리는 어떤 인구 집단을 연구에 포함하는 것이 실용적입니까? 누구를 제외해야 할까요?
우리는 시뮬레이션된 데이터를 사용하여 더 구체적인 질문에 답할 것입니다: 살충제 처리 모기장을 사용하는 것이 사용하지 않는 것에 비해 1년 후 말라리아에 걸릴 위험을 감소시키는가? Andrew Heiss 박사에 의해 시뮬레이션된 이 특정 데이터에서:
…연구자들은 모기장 사용이 개인의 말라리아 감염 위험을 낮추는지에 관심이 있습니다. 그들은 익명의 국가에서 1,752가구로부터 데이터를 수집했으며 환경적 요인, 개인의 건강 및 가구 특성과 관련된 변수들을 가지고 있습니다. 이 데이터는 실험 데이터가 아닙니다 — 연구자들은 누가 모기장을 사용할지 통제할 수 없으며, 개별 가구는 무료 모기장을 신청할지 또는 직접 모기장을 구매할지, 그리고 모기장이 있을 때 이를 사용할지 여부를 스스로 선택합니다.
우리는 시뮬레이션된 데이터를 사용하기 때문에, 실제 생활에서는 갖기 힘든 말라리아 감염 가능성을 측정하는 결과 변수에 직접 접근할 수 있습니다. 우리는 이 척도를 그대로 사용할 것인데, 이는 우리가 실제 효과 크기를 더 면밀히 조사할 수 있게 해주기 때문입니다. 반면 실제로는 인구 집단에 대한 정기적인 말라리아 검사와 같은 다른 대리 지표를 통해 효과 크기를 추정해야 할 것입니다. 또한 데이터가 그렇게 시뮬레이션되었기 때문에, 우리 데이터셋의 인구가 우리가 추론하고자 하는 인구(이름 없는 국가)를 대표한다고 안전하게 가정할 수 있습니다. 우리는 {causalworkshop} 패키지의 net_data에서 시뮬레이션된 데이터를 찾을 수 있으며, 여기에는 10개의 변수가 포함되어 있습니다:
idnet and net_num
malaria_riskincomehealthhouseholdeligibletemperatureresistance말라리아 위험의 분포는 모기장 사용 여부에 따라 상당히 다르게 나타나는 것으로 보입니다 (그림 2.1).
library(tidyverse)
if (requireNamespace("causalworkshop", quietly = TRUE)) {
  library(causalworkshop)
} else {
  # Create dummy data if causalworkshop is not available
  set.seed(123)
  n <- 1000
  net_data <- tibble(
    id = 1:n,
    income = rnorm(n, 500, 100),
    health = rnorm(n, 50, 15),
    temperature = rnorm(n, 25, 5),
    household = sample(1:8, n, replace = TRUE),
    eligible = sample(c(0, 1), n, replace = TRUE, prob = c(0.7, 0.3)),
    resistance = rnorm(n, 30, 10)
  ) |>
    mutate(
      # Create net usage based on income, health, temperature
      net_prob = plogis(-2 + 0.002 * income + 0.01 * health + 0.05 * temperature),
      net_num = rbinom(n, 1, net_prob),
      net = ifelse(net_num == 1, "Net", "No Net"),
      # Create malaria risk based on net usage and confounders
      malaria_risk = 60 - 15 * net_num - 0.005 * income - 0.3 * health - 1.0 * temperature + rnorm(n, 0, 10)
    ) |>
    select(-net_prob) # Remove intermediate variable
}

net_data |>
  ggplot(aes(malaria_risk, fill = net)) +
  geom_density(color = NA, alpha = .8)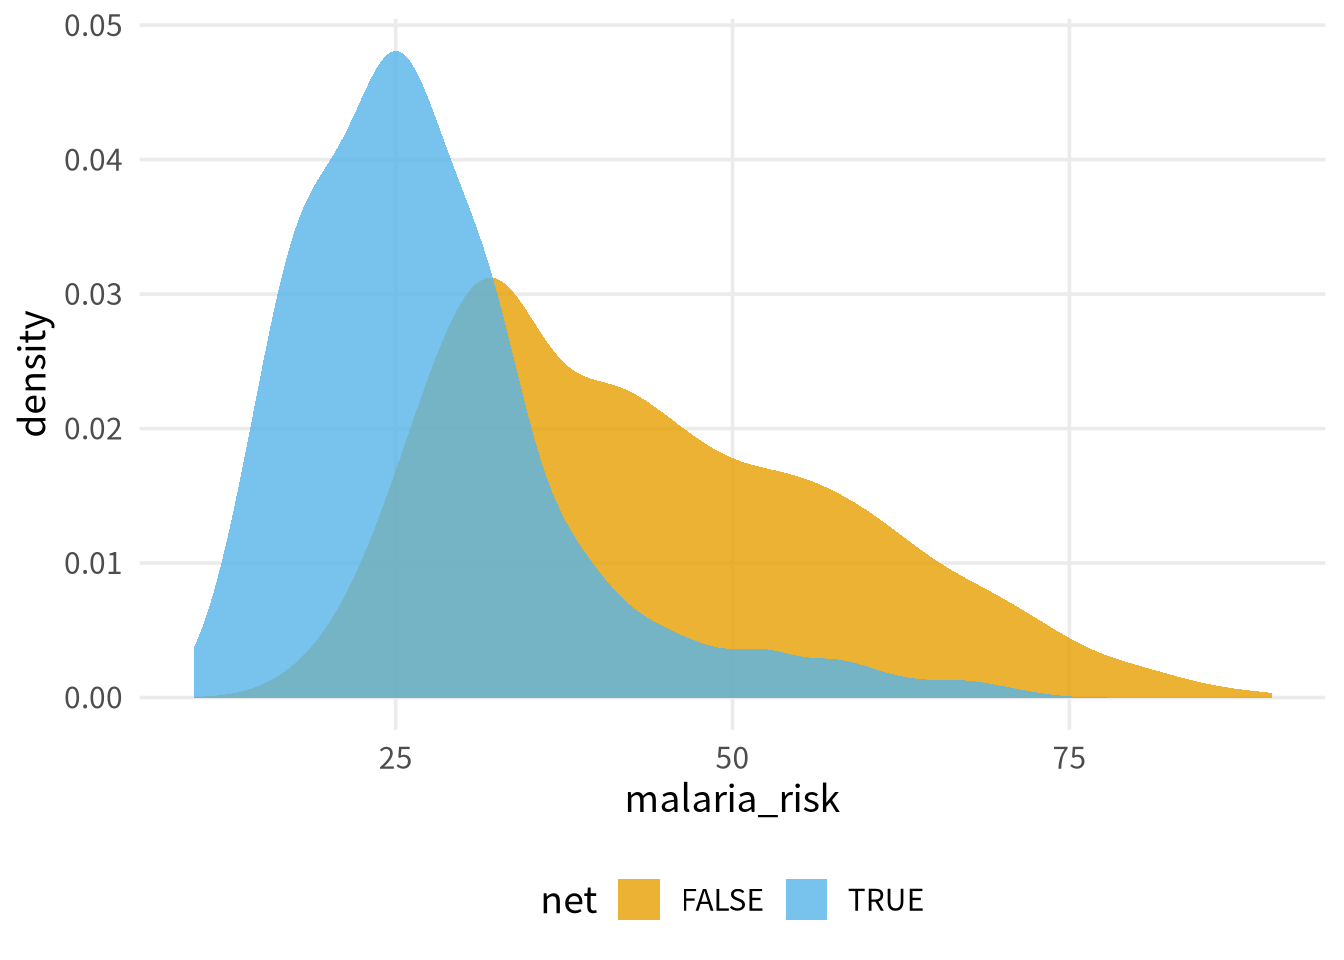
그림 2.1 에서 모기장을 사용한 사람들의 밀도는 사용하지 않은 사람들의 밀도보다 왼쪽에 위치합니다. 말라리아 위험의 평균 차이는 약 16.4이며, 이는 모기장 사용이 말라리아에 대해 보호 효과가 있을 수 있음을 시사합니다.
# A tibble: 2 × 2
  net   malaria_risk
  <lgl>        <dbl>
1 FALSE         43.9
2 TRUE          27.5
단순 선형 회귀에서도 예상대로 동일한 결과를 확인할 수 있습니다.
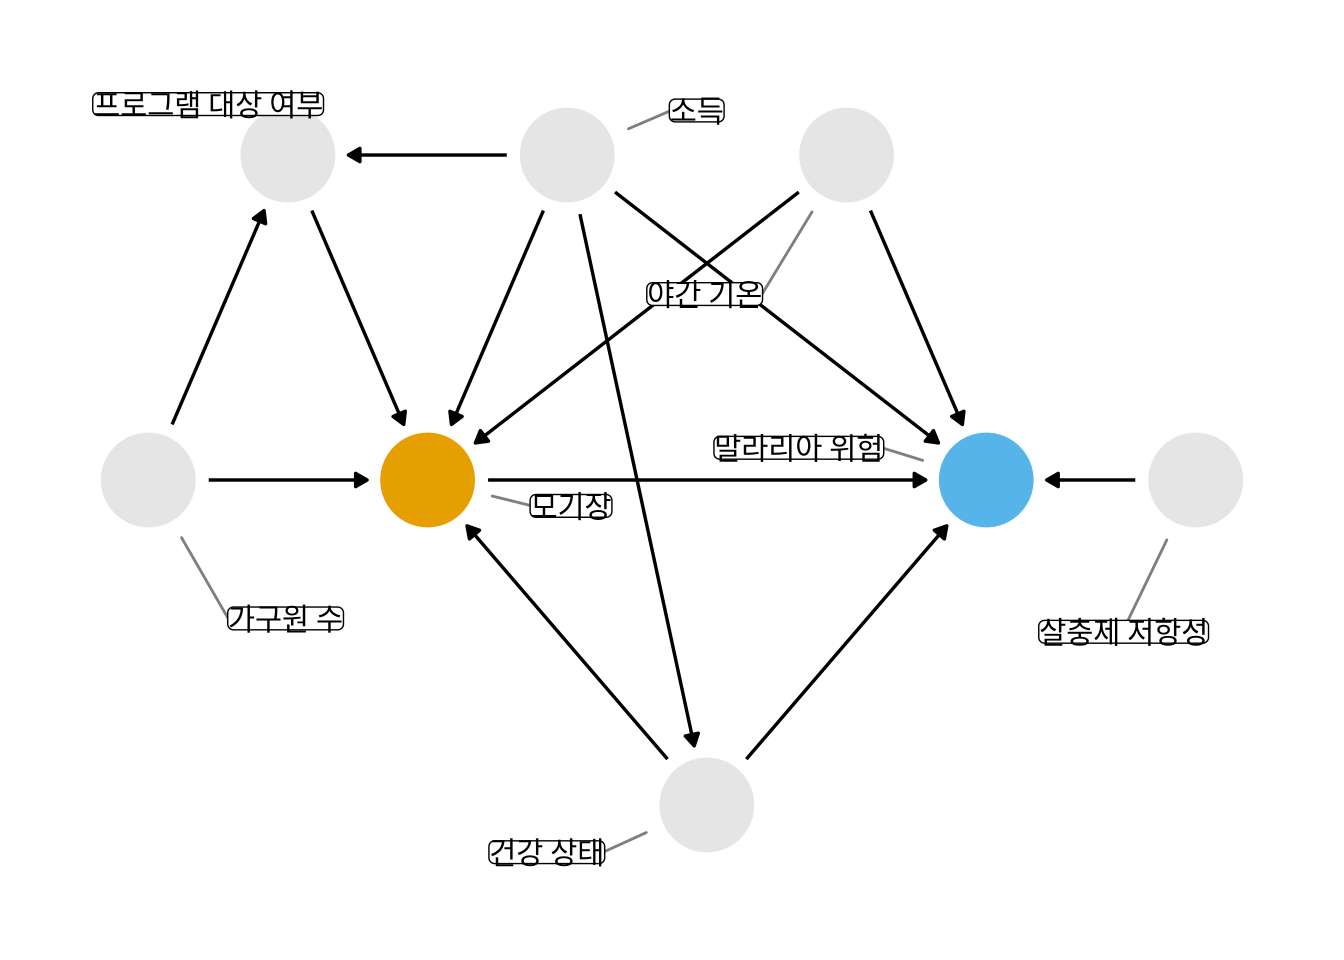
위의 단순 추정치를 인과적 추정치로 해석하려고 할 때 우리가 직면하는 문제는, 우리가 보고 있는 효과에 대해 다른 요인들이 원인일 수 있다는 점입니다. 이 예시에서는 교란(confounding)에 집중할 것입니다: 모기장 사용과 말라리아의 공통 원인은 우리가 어떤 방식으로든 이를 고려하지 않는 한 우리가 보는 효과를 편향시킬 것입니다. 우리가 어떤 변수들을 고려해야 하는지 결정하는 가장 좋은 방법 중 하나는 인과 다이어그램을 사용하는 것입니다. 인과 방향성 비순환 그래프(Causal Directed Acyclic Graphs, DAGs)라고도 불리는 이 다이어그램은 노출, 결과, 그리고 관련이 있다고 생각되는 다른 변수들 사이의 인과 관계에 대해 우리가 내리는 가정을 시각화합니다. 중요한 점은, DAG 구축은 데이터 기반 접근 방식이 아니라는 것입니다; 오히려 우리는 인과적 질문의 구조에 관한 전문가의 배경 지식을 통해 제안된 DAG에 도달하게 됩니다.
이 질문에 대해 우리가 제안하는 DAG는 다음과 같습니다.
우리는 장 4 에서 DAG를 만들고 분석하는 방법을 알아볼 것입니다.
DAG에서 각 점은 변수를 나타내고, 각 화살표는 원인을 나타냅니다. 다시 말해, 이 다이어그램은 우리가 생각하는 이 변수들 사이의 인과 관계가 무엇인지 선언하는 것입니다. 그림 2.2 에서 우리는 다음과 같이 믿는다고 말하고 있습니다:
여러분은 이러한 주장 중 일부에 동의하거나 동의하지 않을 수 있습니다. 그것은 좋은 일입니다! 우리의 가정을 적나라하게 드러냄으로써 분석의 과학적 신뢰성을 투명하게 평가할 수 있기 때문입니다. DAG를 사용하는 또 다른 이점은 그 기저에 깔린 수학 덕분에, 우리가 이 DAG가 옳다고 가정할 때 고려해야 할 변수의 하위 집합을 정확하게 결정할 수 있다는 점입니다.
이 연습에서는 데이터가 어떻게 생성되었는지에 대한 지식을 바탕으로 합리적인 DAG를 제공하고 있습니다. 실제 생활에서 DAG를 설정하는 것은 깊은 사고, 도메인 전문 지식, 그리고 (종종) 여러 전문가 간의 협력이 필요한 도전적인 작업입니다.
우리가 다루고 있는 주요 문제는, 우리가 작업 중인 데이터를 분석할 때 모기장 사용이 말라리아 위험에 미치는 영향뿐만 아니라 이 모든 다른 관계들의 영향도 함께 보게 된다는 점입니다. DAG 용어로 말하자면, 우리에게는 하나 이상의 열린 인과 경로(open causal pathway)가 있습니다. 만약 이 DAG가 옳다면, 우리에게는 8개의 인과 경로가 있는 셈입니다: 모기장 사용과 말라리아 위험 사이의 경로 하나와 나머지 7개의 교란 경로입니다. 모기장 사용과 말라리아 위험 사이의 연관성(association)은 이 모든 경로들이 뒤섞인 결과입니다.
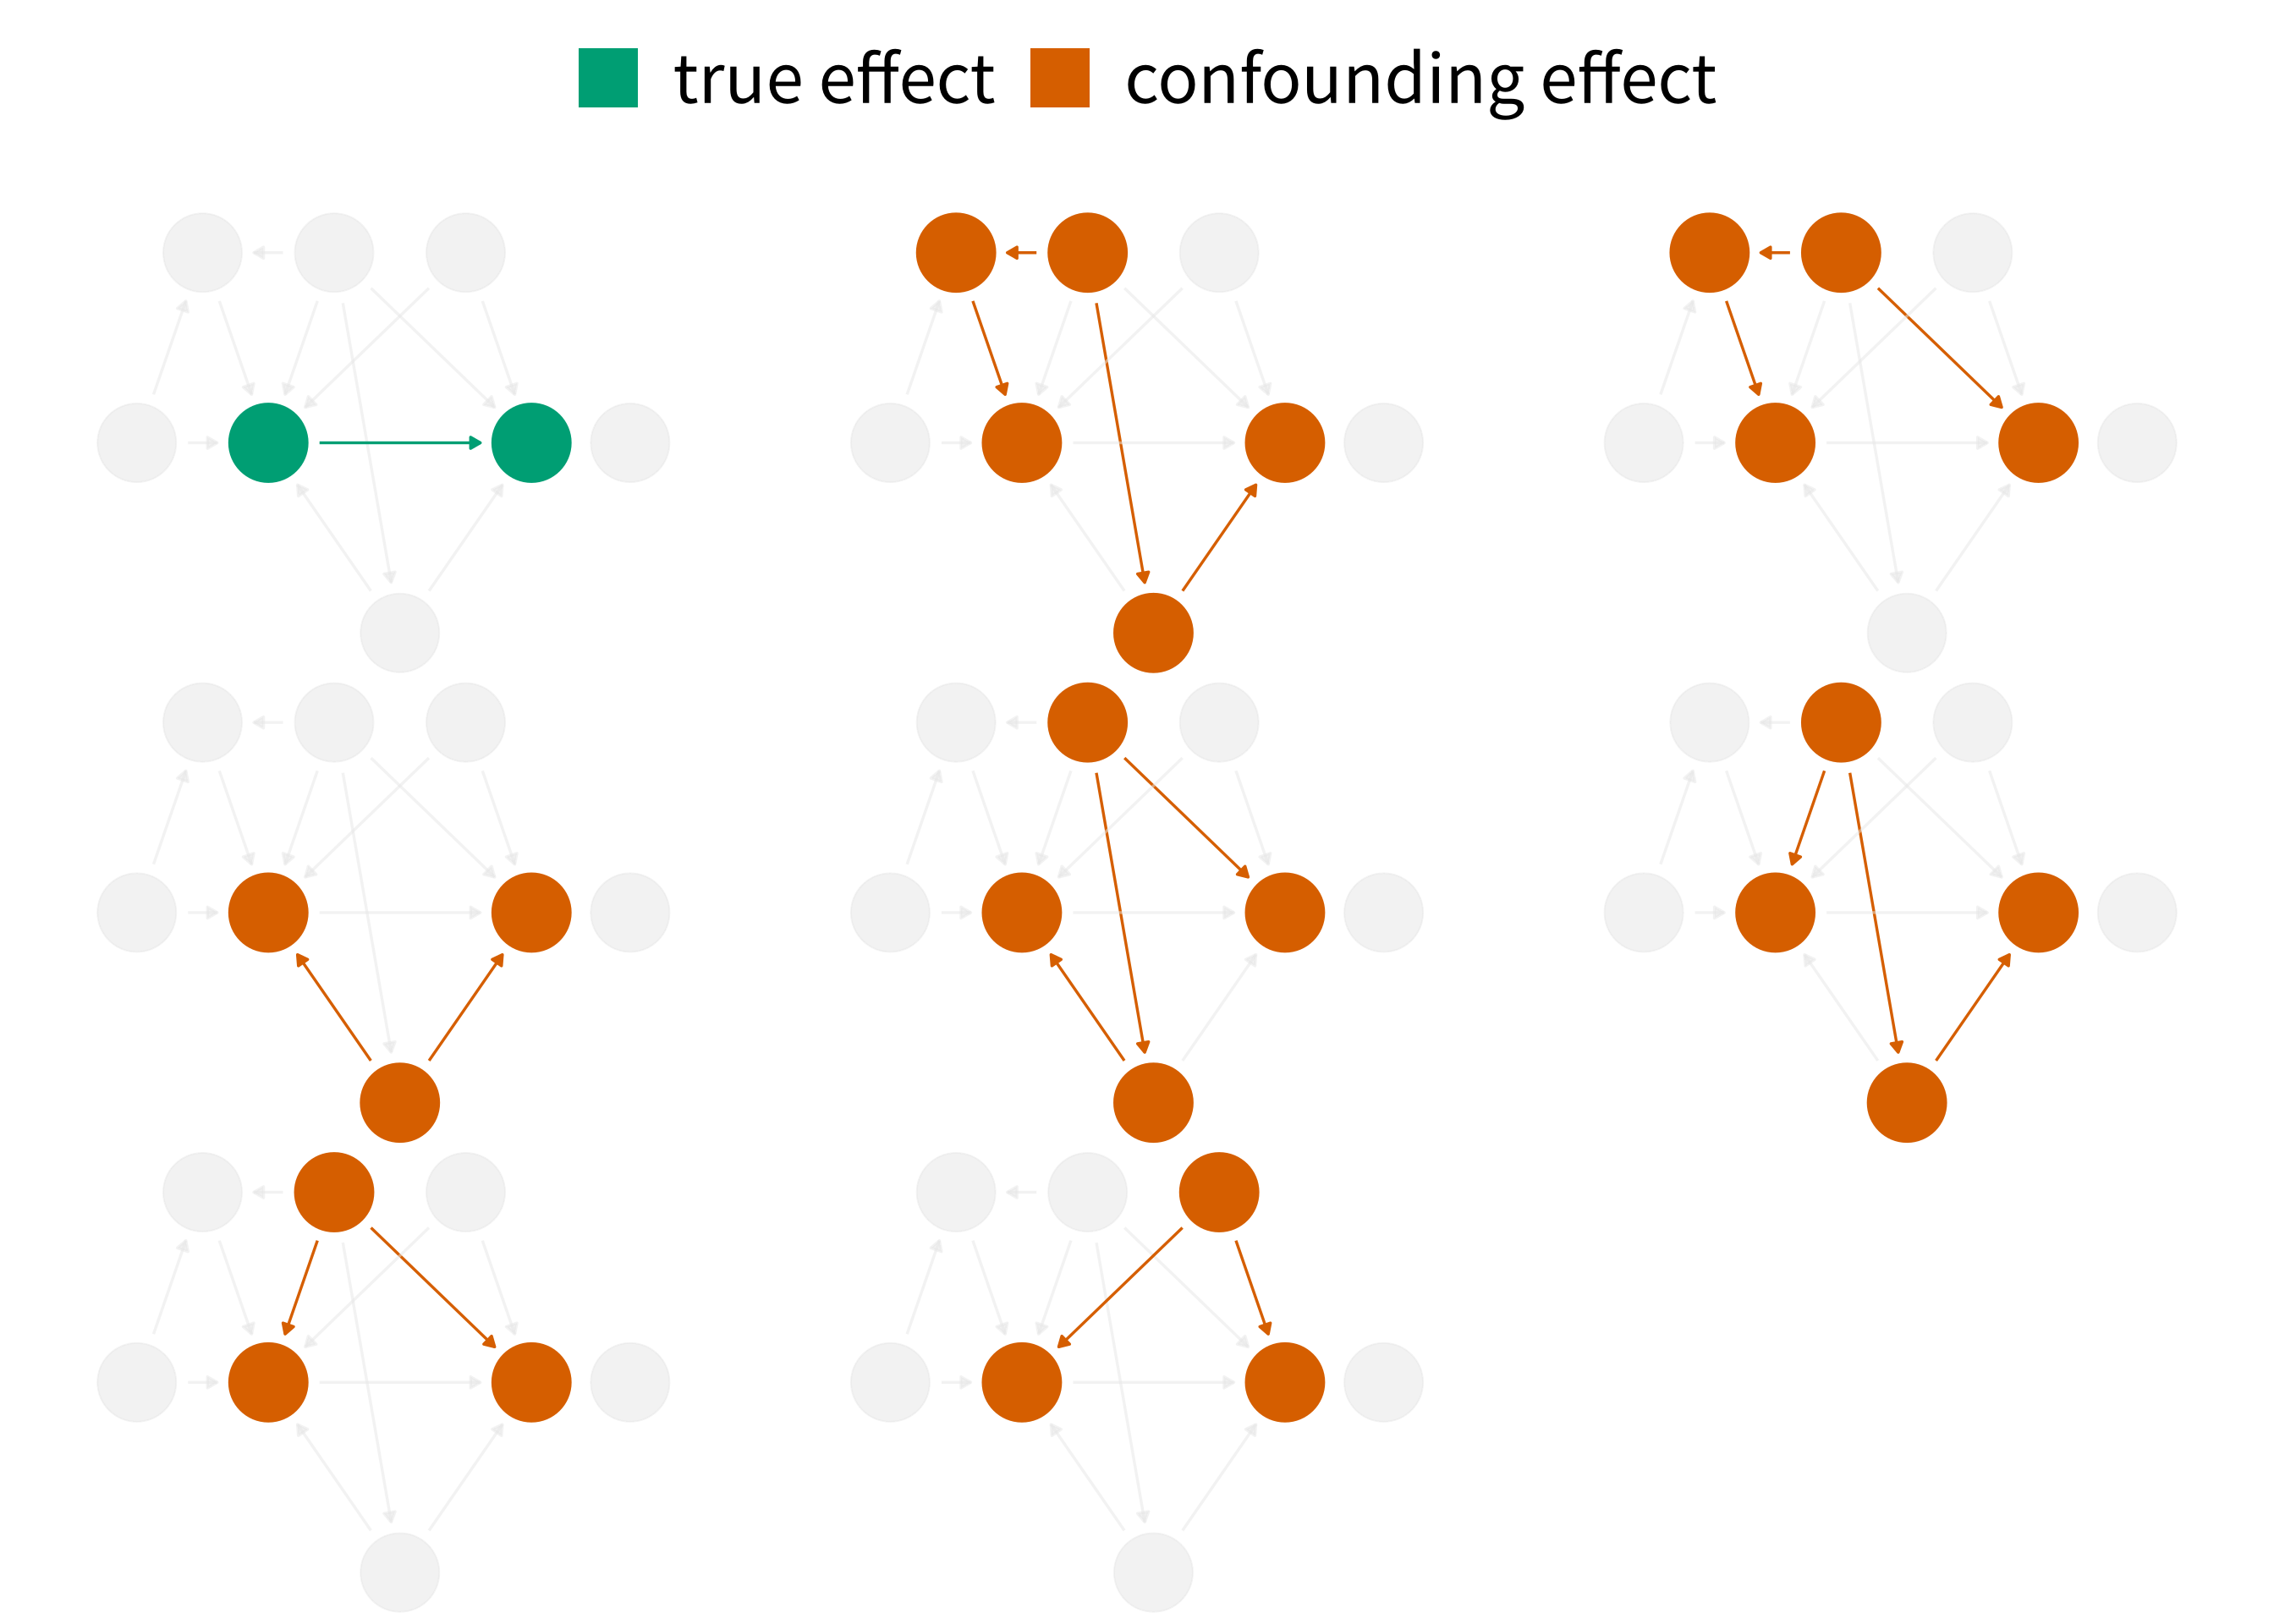
모기장 사용과 말라리아 위험만을 포함하는 단순 선형 회귀를 계산하면, 그림 2.3 에 나타난 7개의 다른 교란 경로가 이를 왜곡하기 때문에 우리가 얻는 효과는 올바르지 않습니다. DAG 용어로 말하자면, 우리가 추구하는 인과 추정치를 왜곡하는 이러한 열린 경로들을 차단(block)해야 합니다. (층화, 매칭, 가중치 부여 등 여러 기술을 통해 경로를 차단할 수 있습니다. 책 전반에 걸쳐 여러 방법을 살펴볼 것입니다.) 다행히도 DAG를 명시함으로써 우리가 통제해야 할 변수들을 정확하게 결정할 수 있습니다. 이 DAG의 경우, 세 가지 변수를 통제해야 합니다: income(소득), health(건강 상태), 그리고 temperature(기온). 이 세 변수는 모든 교란 경로를 차단하는 데 필요한 최소한의 변수 집합인 최소 조정 집합(minimal adjustment set)입니다. 우리는 장 4 에서 조정 집합에 대해 더 자세히 논의할 것입니다.
우리는 이러한 변수들을 통제하기 위해 역확률 가중치(inverse probability weighting, IPW)라고 불리는 기술을 사용할 것이며, 이에 대해 섹션 8.2 에서 자세히 다룰 것입니다. 우리는 로지스틱 회귀를 사용하여 교란 요인들을 바탕으로 처치를 받을 확률인 성향 점수(propensity score)를 예측할 것입니다. 그런 다음, 위에서 적합시킨 선형 회귀 모델에 적용할 역확률 가중치를 계산할 것입니다. 성향 점수 모델은 종속 변수로 노출(모기장 사용)을, 독립 변수로 최소 조정 집합을 포함합니다.
일반적으로 성향 점수 모델을 적합시킬 때는 도메인 전문 지식과 좋은 모델링 관행에 의존하고 싶을 것입니다. 예를 들어, 연속형 교란 요인이 스플라인(splines)을 사용하여 비선형이 되도록 허용하거나, 교란 요인들 사이의 필수적인 상호작용을 추가하고 싶을 수 있습니다. 이 데이터는 시뮬레이션된 것이기 때문에 이러한 추가 파라미터가 필요하지 않음을 알고 있지만(그래서 건너뛸 것입니다), 실제로는 필요한 경우가 많습니다. 이에 대해서는 섹션 8.2 에서 더 자세히 논의하겠습니다.
성향 점수 모델은 net ~ income + health + temperature 공식을 사용하는 로지스틱 회귀 모델로, 교란 요인인 소득, 건강 상태, 기온을 바탕으로 모기장 사용 확률을 예측합니다.
우리는 여러 가지 방법으로 성향 점수를 사용하여 교란을 통제할 수 있습니다. 이 예시에서는 가중치 부여(weighting)에 집중할 것입니다. 특히, 평균 처치 효과(average treatment effect, ATE)를 위한 역확률 가중치를 계산할 것입니다. ATE는 특정 인과적 질문을 나타냅니다: 연구에 참여한 모든 사람이 모기장을 사용했을 때와 아무도 모기장을 사용하지 않았을 때의 결과는 어떻게 다를 것인가?
ATE를 계산하기 위해 broom과 propensity 패키지를 사용할 것입니다. broom의 augment() 함수는 모델로부터 예측 관련 정보를 추출하여 데이터와 결합합니다. propensity의 wt_ate() 함수는 성향 점수와 노출이 주어졌을 때 역확률 가중치를 계산합니다.
역확률 가중치의 경우, ATE 가중치는 여러분이 실제로 받은 처치를 받을 확률의 역수입니다. 다시 말해, 모기장을 사용했다면 ATE 가중치는 모기장을 사용할 확률의 역수이고, 모기장을 사용하지 않았다면 모기장을 사용하지 않을 확률의 역수입니다.
library(broom)
if (requireNamespace("propensity", quietly = TRUE)) {
  library(propensity)
  net_data_wts <- propensity_model |>
    augment(data = net_data, type.predict = "response") |>
    # .fitted는 주어진 관측치에 대해 모델이 예측한 값입니다
    mutate(wts = wt_ate(.fitted, net_num))
} else {
  # propensity 패키지를 사용할 수 없는 경우 ATE 가중치의 수동 구현
  net_data_wts <- propensity_model |>
    augment(data = net_data, type.predict = "response") |>
    mutate(
      # 수동 ATE 가중치 계산
      wts = ifelse(net_num == 1, 1/.fitted, 1/(1-.fitted))
    )
}

net_data_wts |>
  select(net, .fitted, wts) |>
  head()
# A tibble: 6 × 3
net .fitted wts
<lgl> <dbl> <psw{ate}>
1 FALSE 0.246 1.327
2 FALSE 0.218 1.279
3 FALSE 0.323 1.477
4 FALSE 0.231 1.300
5 FALSE 0.279 1.387
6 FALSE 0.306 1.441첫 번째 가구는 모기장을 사용하지 않았습니다. 그들의 모기장 사용 예측 확률은 약 0.25였습니다(달리 말하면, 모기장을 사용하지 않을 예측 확률은 0.75입니다). 이는 그들의 관찰된 net 값과 더 일치하지만, 여전히 모기장을 사용할 어느 정도의 예측 확률이 있으므로 그들의 가중치는 1.33입니다.
wts는 곧 적합시킬 결과 모델에서 각 관측치에 부여될 가중치(가중치를 높이거나 낮춤)의 양을 나타냅니다. 예를 들어, 만약 어떤 가구가 모기장을 사용했는데 그 예측 확률이 매우 낮았다면, 그들이 실제로 모기장을 사용했다는 점을 고려할 때 그들의 가중치는 더 높아질 것입니다. 즉, 이 가구는 위에서 적합시킨 단순 선형 모델에 비해 가중치가 더 높아질 것입니다.
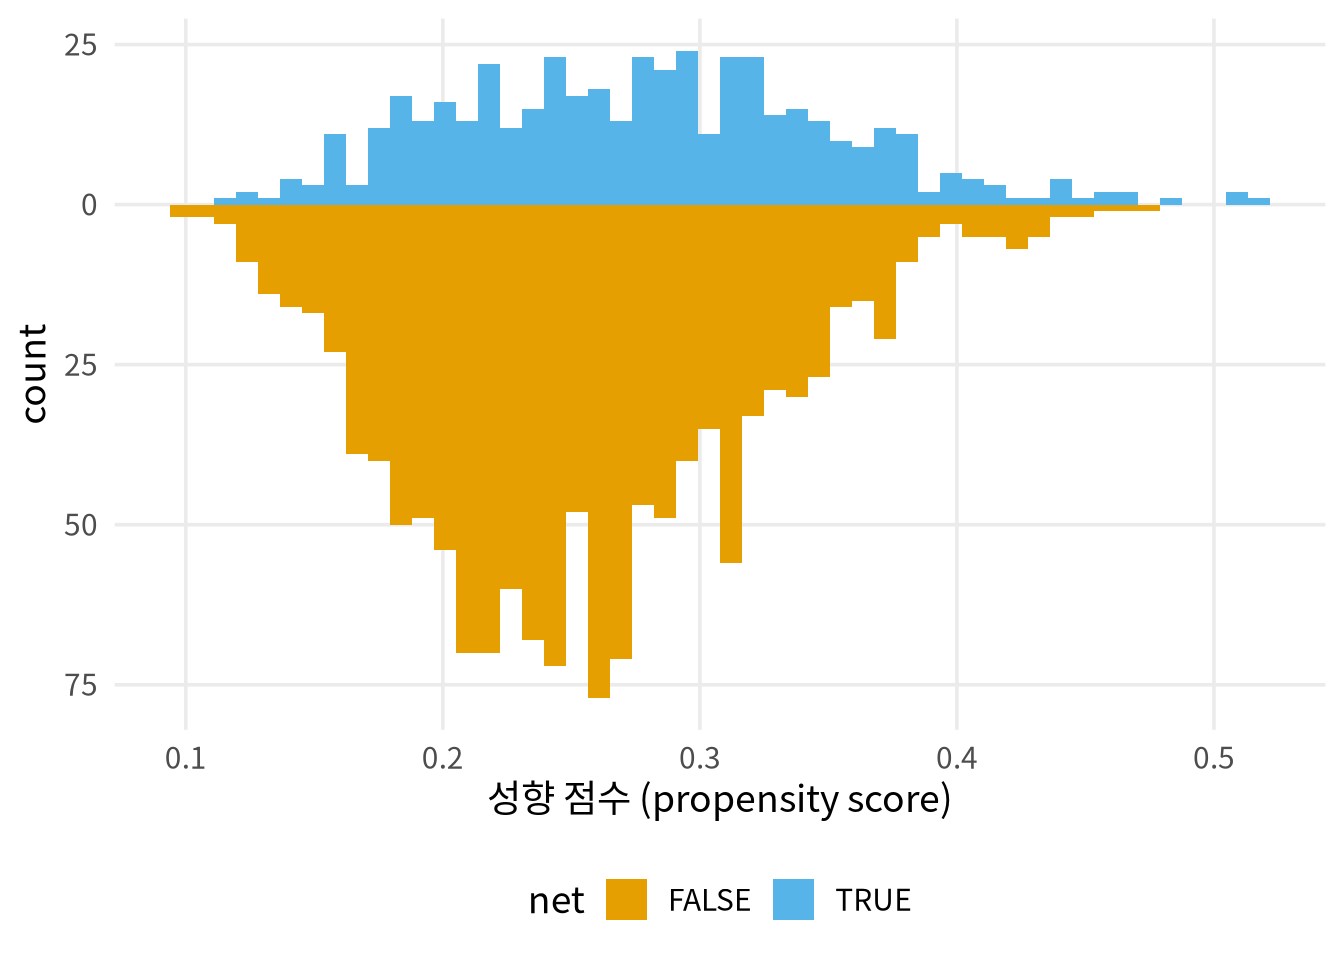
성향 점수 가중치 부여의 목표는 노출군들 사이에서 교란 요인의 분포가 균형을 이루도록 관측치들에 가중치를 부여하는 것입니다. 다른 방식으로 말하자면, 우리는 원칙적으로 DAG에서 교란 요인과 노출 사이의 화살표를 제거하여 교란 경로가 더 이상 우리의 추정치를 왜곡하도록 하지 않는 것입니다. 다음은 성향 점수 모델의 균형을 평가하기 위한 {halfmoon} 패키지의 geom_mirror_histogram()으로 만든 그룹별 성향 점수 분포입니다:
if (requireNamespace("halfmoon", quietly = TRUE)) {
  library(halfmoon)
  ggplot(net_data_wts, aes(.fitted)) +
    geom_mirror_histogram(
      aes(fill = net),
      bins = 50
    ) +
    scale_y_continuous(labels = abs) +
    labs(x = "성향 점수 (propensity score)")
} else {
  # halfmoon 패키지를 사용할 수 없는 경우 일반 히스토그램으로 대체
  ggplot(net_data_wts, aes(.fitted, fill = net)) +
    geom_histogram(bins = 50, alpha = 0.7, position = "identity") +
    labs(x = "성향 점수 (propensity score)", fill = "Used net") +
    facet_wrap(~net, ncol = 1)
}
가중치가 적용된 성향 점수는 분포가 훨씬 더 유사해진 가상 인구를 생성합니다:
if (requireNamespace("halfmoon", quietly = TRUE)) {
  ggplot(net_data_wts, aes(.fitted)) +
    geom_mirror_histogram(
      aes(group = net),
      bins = 50
    ) +
    geom_mirror_histogram(
      aes(fill = net, weight = wts),
      bins = 50,
      alpha = .5
    ) +
    scale_y_continuous(labels = abs) +
    labs(x = "성향 점수 (propensity score)")
} else {
  # halfmoon 패키지를 사용할 수 없는 경우 일반 히스토그램으로 대체
  ggplot(net_data_wts, aes(.fitted, fill = net)) +
    geom_histogram(bins = 50, alpha = 0.7, position = "identity") +
    labs(x = "성향 점수 (propensity score)", fill = "Used net") +
    facet_wrap(~net, ncol = 1)
}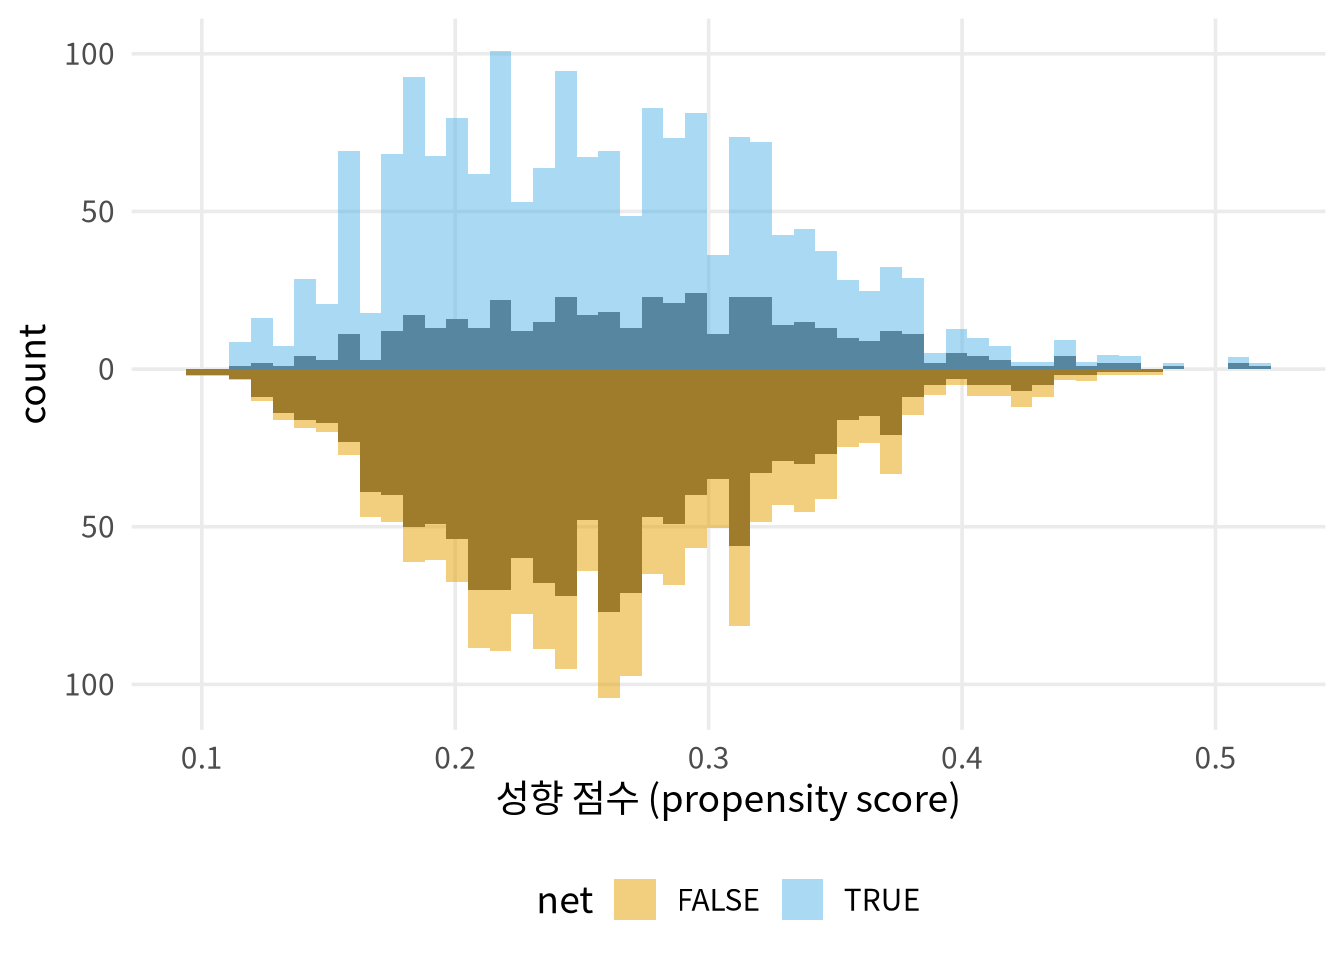
이 예시에서 가중치를 적용하지 않은 분포도 아주 나쁘지는 않습니다. 모양이 어느 정도 비슷하고 상당히 많이 겹치기 때문입니다. 하지만 그림 2.5 의 가중 분포가 훨씬 더 비슷합니다.
성향 점수 가중치 부여 및 대부분의 다른 인과 추론 기술은 오직 관찰된 교란 요인들 — 우리가 모델에 올바르게 반영한 것들 — 에 대해서만 도움을 줍니다. 불행히도 여전히 측정되지 않은 교란이 존재할 수 있으며, 이에 대해서는 아래에서 논의할 것입니다.
무작위 배정(Randomization)은 측정되지 않은 교란까지 해결할 수 있는 유일한 인과 추론 기술 중 하나이며, 이것이 무작위 배정이 그토록 강력한 이유 중 하나입니다.
우리는 또한 각 교란 요인별로 그룹 간의 균형이 얼마나 잘 잡혀 있는지 알고 싶을 수 있습니다. 이를 수행하는 한 가지 방법은 가중치 적용 전후의 각 교란 요인에 대한 표준화된 평균 차이(standardized mean differences, SMDs)를 계산하는 것입니다. 우리는 halfmoon 패키지의 함수인 tidy_smd()로 SMD를 계산하고 geom_love()로 그래프를 그릴 것입니다.
if (requireNamespace("halfmoon", quietly = TRUE)) {
  library(halfmoon)
  plot_df <- tidy_smd(
    net_data_wts,
    c(income, health, temperature),
    .group = net,
    .wts = wts
  )

  ggplot(
    plot_df,
    aes(
      x = abs(smd),
      y = variable,
      group = method,
      color = method
    )
  ) +
    geom_love()
} else {
  # halfmoon 패키지를 사용할 수 없는 경우의 수동 SMD 계산 또는 밀도 그래프
  net_data_wts |>
    select(net, income, health, temperature) |>
    pivot_longer(-net, names_to = "variable", values_to = "value") |>
    ggplot(aes(x = value, fill = net)) +
    geom_density(alpha = 0.7) +
    facet_wrap(~variable, scales = "free") +
    labs(subtitle = "처치 그룹별 분포를 보여주는 밀도 그래프")
}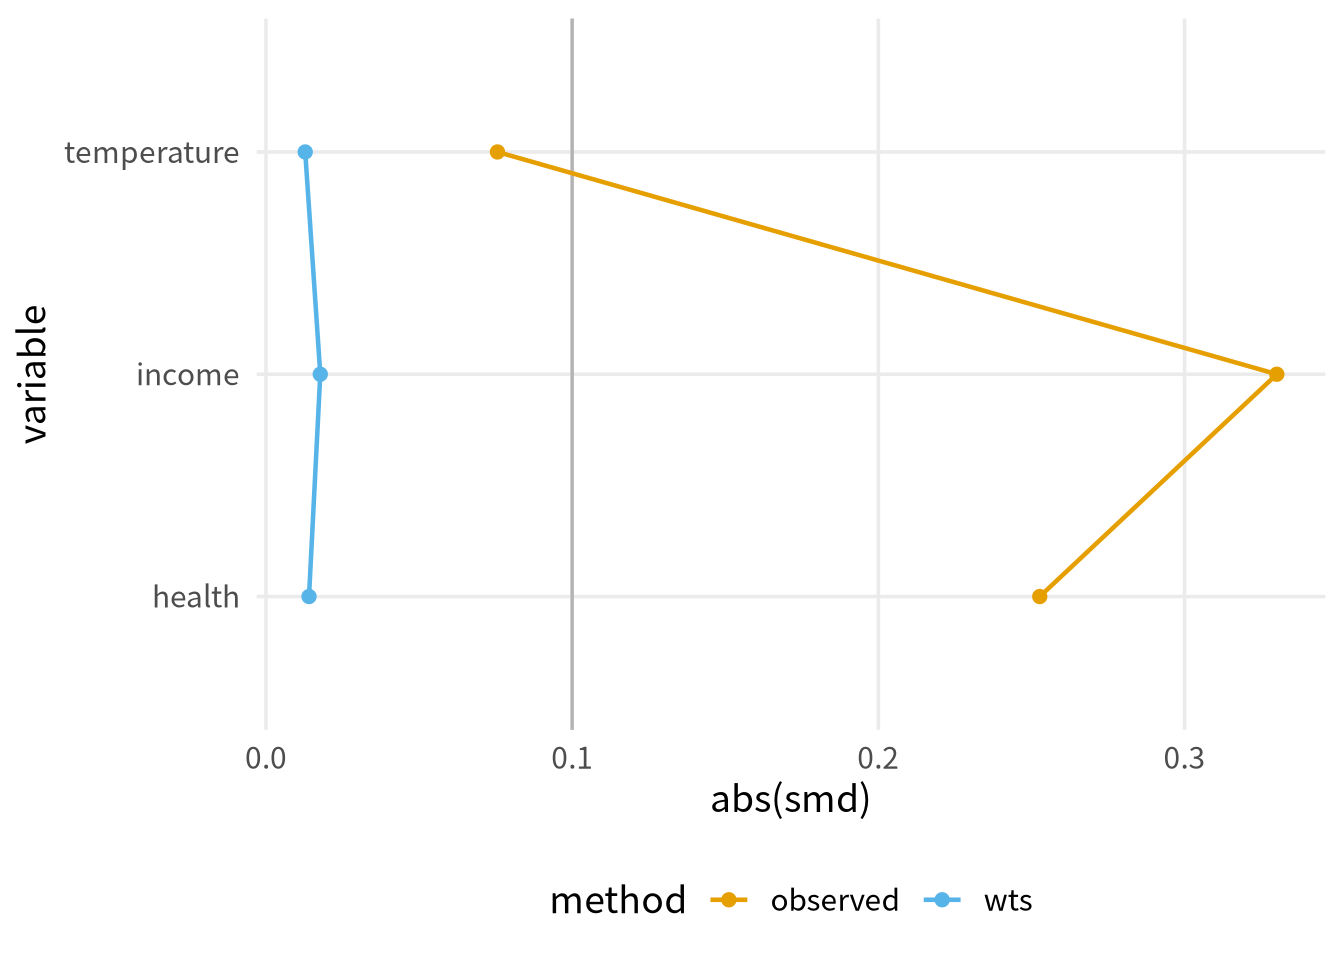
일반적으로 잘 균형 잡힌 교란 요인은 절대 척도에서 SMD가 0.1 미만이어야 한다는 가이드라인이 있습니다. 0.1은 단지 경험 법칙일 뿐이지만, 이를 따른다면 그림 2.6 의 변수들은 가중치 적용 후 잘 균형을 이루고 있습니다(가중치 적용 전에는 불균형함).
결과 모델에 가중치를 적용하기 전에, 극단적인 가중치가 있는지 전체 분포를 확인해 봅시다. 극단적인 가중치는 결과 모델의 추정치와 분산을 불안정하게 만들 수 있으므로 이를 인지하고 있어야 합니다. 우리는 또한 장 10 에서 이러한 문제에 덜 취약한 다른 여러 유형의 가중치에 대해 논의할 것입니다.
net_data_wts |>
  ggplot(aes(wts)) +
  geom_density(fill = "#CC79A7", color = NA, alpha = 0.8)
Warning in vec_ptype2.psw.double(x = x, y = y, x_arg = x_arg, y_arg = y_arg, : Converting psw to numeric
ℹ Class-specific attributes and metadata have been
dropped
ℹ Use explicit casting to numeric to avoid this
warning
Converting psw to numeric
ℹ Class-specific attributes and metadata have been
dropped
ℹ Use explicit casting to numeric to avoid this
warning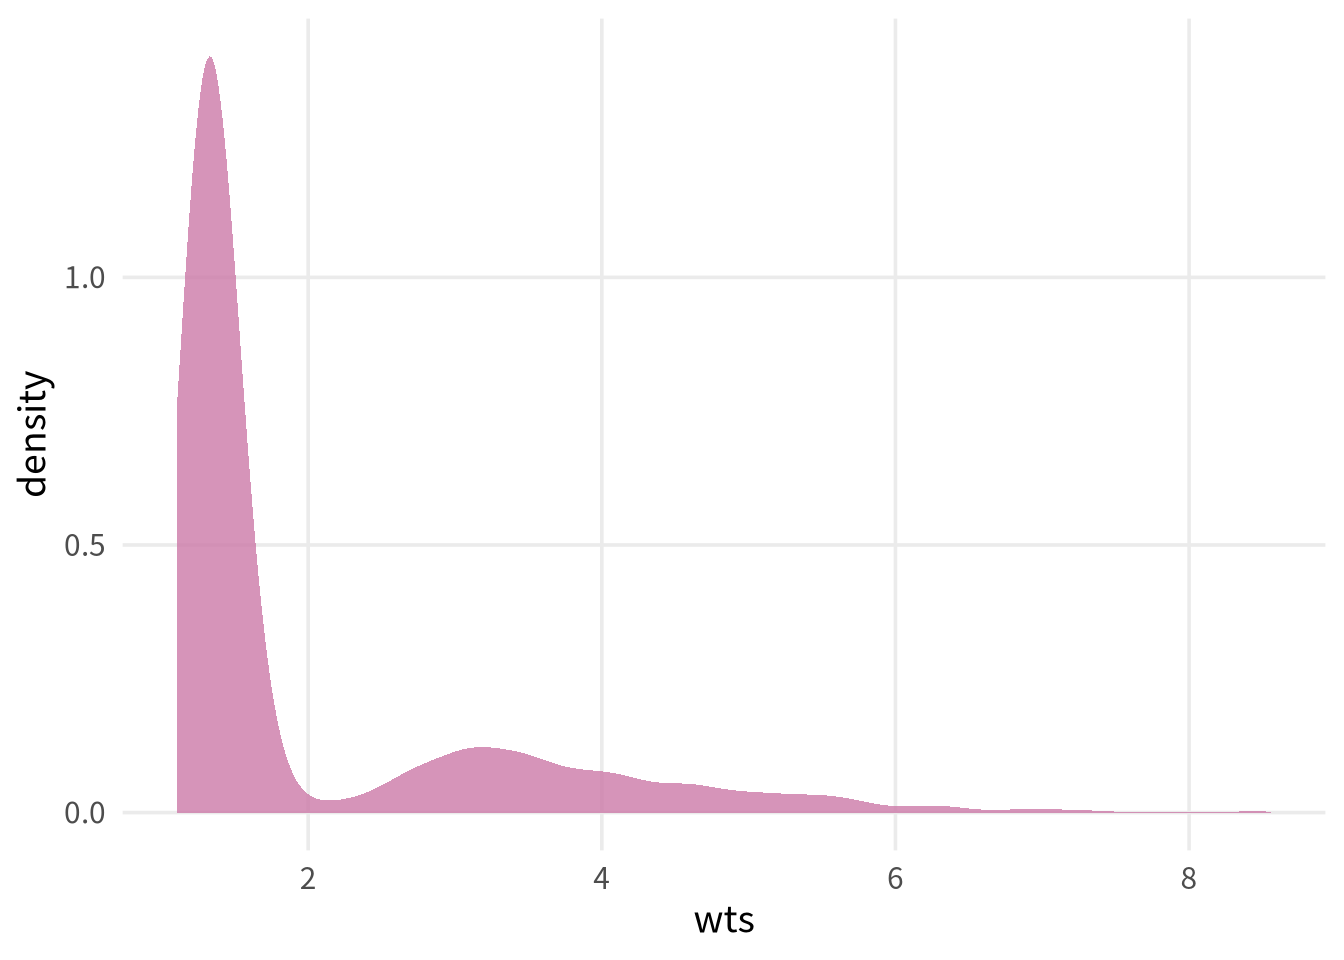
그림 2.7 의 가중치는 비대칭이지만 터무니없는 값은 없습니다. 만약 극단적인 가중치를 발견했다면, 가중치를 절단(trimming)하거나 안정화(stabilizing)해 볼 수 있고, 또는 다른 추정 대상(estimand)에 대한 효과 계산을 고려해 볼 수 있습니다. 이에 대해서는 장 10 에서 다룰 것입니다. 하지만 여기서는 그렇게 할 필요가 없어 보입니다.
이제 단순 선형 회귀 모델에서 교란을 처리하기 위해 ATE 가중치를 사용할 준비가 되었습니다. 이러한 모델을 적합시키는 것은 이 사례에서 매우 간단합니다: 이전과 동일한 모델을 적합시키되, 역확률 가중치를 포함하는 weights = wts를 추가하면 됩니다.
# A tibble: 2 × 7
  term   estimate std.error statistic  p.value conf.low
  <chr>     <dbl>     <dbl>     <dbl>    <dbl>    <dbl>
1 (Inte…     42.7     0.442      96.7 0            41.9
2 netTR…    -12.5     0.624     -20.1 5.50e-81    -13.8
# ℹ 1 more variable: conf.high <dbl>
평균 처치 효과에 대한 추정치는 약 -12.5(95% CI: -13.5, -11.5)입니다. 불행히도 우리가 사용하고 있는 신뢰 구간은 틀렸습니다. 가중치를 추정할 때의 불확실성을 고려하지 않았기 때문입니다. 일반적으로 성향 점수 가중 모델의 신뢰 구간은 이 불확실성을 고려하지 않으면 너무 좁게 나타납니다. 따라서 신뢰 구간의 명목상 커버리지(nominal coverage)가 잘못될 것이며, 이는 잘못된 해석으로 이어질 수 있습니다.
우리는 부트스트랩(bootstrap), 로버스트 표준 오차(robust standard errors), 그리고 경험적 샌드위치 추정량(empirical sandwich estimators)으로 추정 절차를 수동으로 고려하는 것을 포함하여 이 문제를 해결할 여러 가지 방법을 가지고 있으며, 이에 대해 장 11 에서 자세히 논의할 것입니다. 이 예시에서는 재표본 추출을 사용하여 파라미터의 분포를 계산하는 유연한 도구인 부트스트랩을 사용할 것입니다. 부트스트랩은 문제에 대한 닫힌 형태의 해가 존재하지 않거나 그러한 많은 해에 내재된 모수적 가정에 피하고 싶을 때 많은 인과 모델에 유용한 도구입니다. 우리는 부트스트랩 샘플 작업을 위해 tidymodels 생태계의 rsample 패키지를 사용할 것입니다.
부트스트랩은 매우 유연하기 때문에 우리가 계산하고 있는 통계량의 불확실성 원인에 대해 신중하게 생각해야 합니다. 우리는 전체 모델링 과정을 부트스트래핑함으로써 이 불확실성을 고려해야 합니다. 모든 부트스트랩 샘플에 대해 성향 점수 모델을 적합시키고, 역확률 가중치를 계산한 다음, 가중 결과 모델을 적합시켜야 합니다.
library(rsample)

fit_ipw <- function(.split, ...) {
  # 부트스트랩된 데이터 프레임 가져오기
  .df <- as.data.frame(.split)

  # 성향 점수 모델 적합시키기
  propensity_model <- glm(
    net_num ~ income + health + temperature,
    data = .df,
    family = binomial()
  )

  # 역확률 가중치 계산하기
  .df <- propensity_model |>
    augment(type.predict = "response", data = .df) |>
    mutate(
      wts = if (requireNamespace("propensity", quietly = TRUE)) {
        propensity::wt_ate(.fitted, net_num)
      } else {
        # ATE 가중치 수동 계산
        ifelse(net_num == 1, 1/.fitted, 1/(1-.fitted))
      }
    )

  # 올바르게 부트스트랩된 ipw 모델 적합시키기
  lm(malaria_risk ~ net, data = .df, weights = wts) |>
    tidy()
}
이제 각 반복(iteration)에 대해 추정치를 계산하는 방법을 알았으므로, rsample의 bootstraps() 함수를 사용하여 부트스트랩된 데이터셋을 만들어 봅시다. 우리는 1,000개를 만들 것입니다.
set.seed(123)
bootstrapped_net_data <- bootstraps(
  net_data,
  times = 1000,
  apparent = TRUE
)

ipw_results <- bootstrapped_net_data |>
  mutate(boot_fits = map(splits, fit_ipw))
이제 추정치들의 분포를 갖게 되었습니다:
# 모기장 효과 항 찾기
sample_terms <- ipw_results$boot_fits[[1]]$term
net_term <- sample_terms[grepl("net", sample_terms, ignore.case = TRUE) & sample_terms != "(Intercept)"]

ipw_results |>
  filter(id != "Apparent") |>
  mutate(
    estimate = map_dbl(
      boot_fits,
      \(.fit) .fit |>
        filter(term == net_term) |>
        pull(estimate)
    )
  ) |>
  ggplot(aes(estimate)) +
  geom_histogram(fill = "#D55E00FF", color = "white", alpha = 0.8)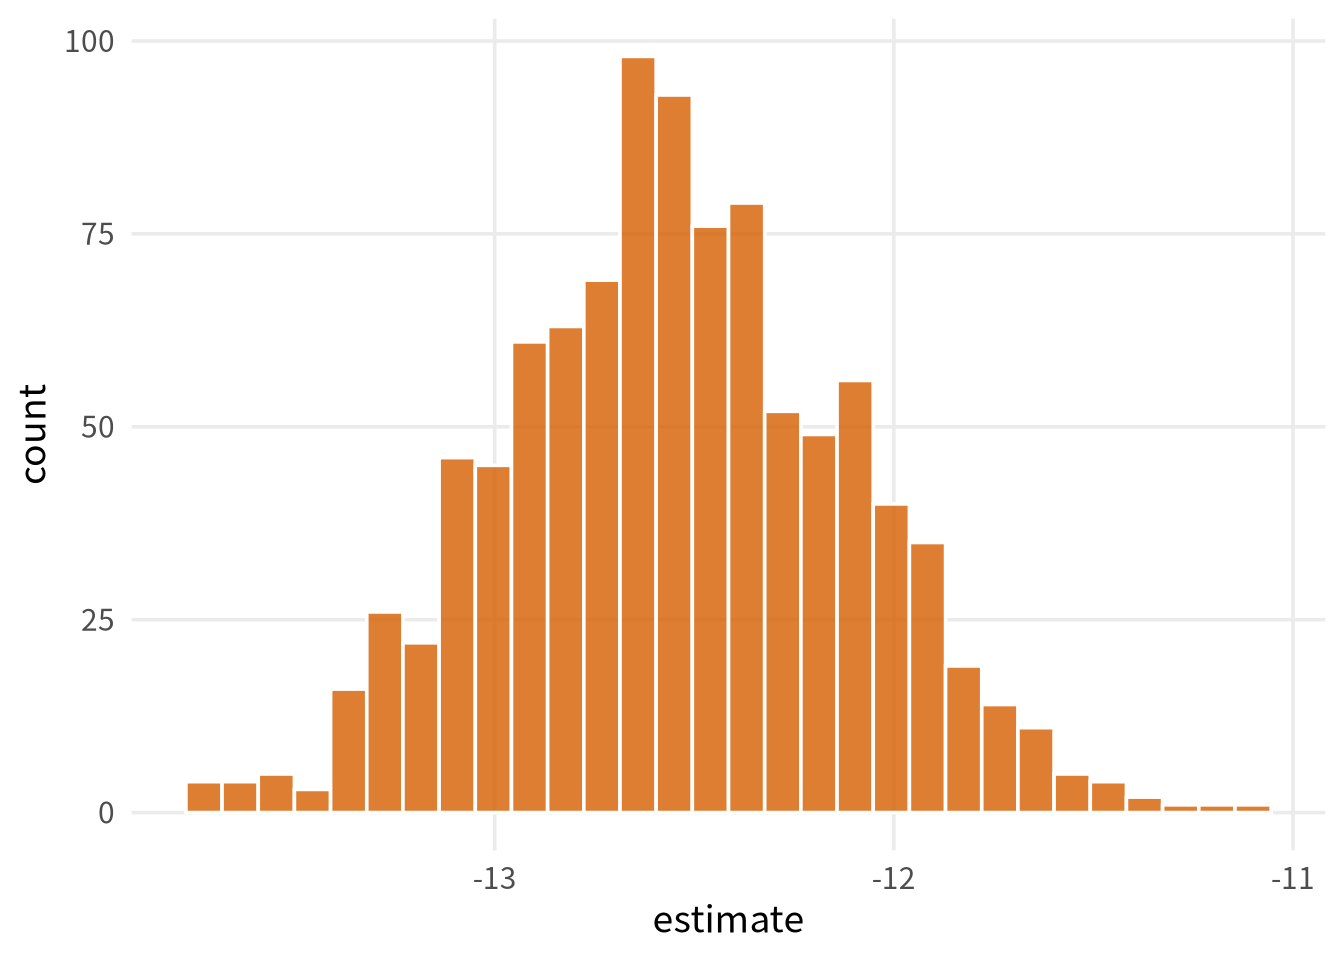
이제 rsample의 int_t()를 사용하여 부트스트랩 분포로부터 95% 신뢰 구간을 계산해 봅시다:
# A tibble: 1 × 6
  term    .lower .estimate .upper .alpha .method
  <chr>    <dbl>     <dbl>  <dbl>  <dbl> <chr>
1 netTRUE  -13.4     -12.5  -11.7   0.05 student-t
이제 우리는 올바른 표준 오차가 포함된, 교란 요인이 조정된 추정치를 갖게 되었습니다. 모든 가구가 모기장을 사용하는 것과 어느 가구도 모기장을 사용하지 않는 것이 말라리아 위험에 미치는 효과 추정치는 약 -12.5 (95% CI: -13.4, -11.7)입니다. 이 연구에서 모기장은 실제로 말라리아 위험을 줄이는 것으로 보입니다.
우리는 관찰된 데이터를 가져와서, 답하고 싶은 인과적 질문에 대해 비판적으로 생각하고, 그곳에 도달하기 위해 필요한 가정을 식별한 다음, 그 가정을 통계 모델에 적용하는 로드맵을 제시했습니다. 인과적 질문에 대한 올바른 답을 얻는 것은 우리의 가정이 어느 정도 맞느냐에 달려 있습니다. 하지만 만약 우리가 덜 정확한 편에 서 있다면 어떨까요? 스포일러 주의: 우리가 방금 계산한 답은 사실 약간 틀렸습니다.
인과 분석을 수행할 때는 민감도 분석을 사용하여 가정을 테스트하는 것이 좋습니다. 우리는 장 16 에서 이러한 기술들을 자세히 다룰 것이지만, 여기서는 측정되지 않은 교란 요인이 결과에 어떤 영향을 미칠지 조사하는 임계점 분석(tipping point analysis)을 간단히 살펴보겠습니다. tipr 패키지는 이러한 민감도 분석을 위한 도구입니다. 우리의 신뢰 구간 상한값이 0(효과가 없음)에 도달하게 하려면 측정되지 않은 교란 요인이 얼마나 강력해야 하는지 물어봅시다.
if (requireNamespace("tipr", quietly = TRUE)) {
  library(tipr)
  tipping_points <- tip_coef(boot_estimate$.upper, exposure_confounder_effect = 1:5)

  tipping_points |>
    ggplot(aes(confounder_outcome_effect, exposure_confounder_effect)) +
    geom_line(color = "#009E73", linewidth = 1.1) +
    geom_point(fill = "#009E73", color = "white", size = 2.5, shape = 21) +
    labs(
      x = "교란 요인-결과 효과 (Confounder-Outcome Effect)",
      y = "노출군 간 교란 요인의\n 표준화된 평균 차이"
    )
}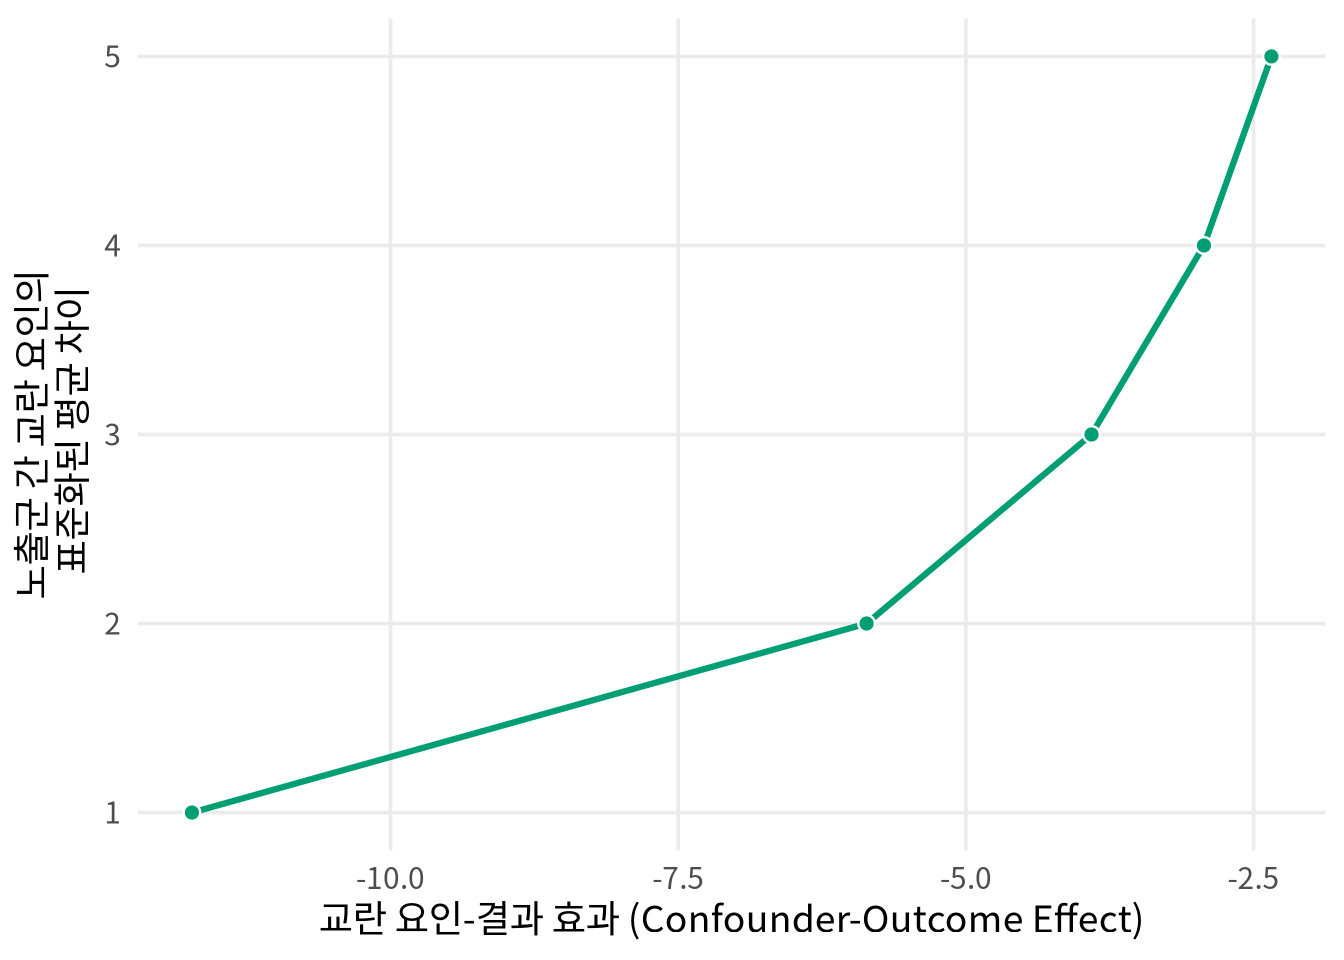
만약 노출군 간의 표준화된 평균 차이가 1인 측정되지 않은 교란 요인이 있다면, 그 교란 요인은 말라리아 위험을 상당히 큰 폭으로 감소시켜야 우리의 결론이 뒤집힐 것입니다. 우리는 이러한 시나리오가 우리의 도메인 지식에 비추어 볼 때 타당한지 고려해야 합니다.
사실 이 데이터는 말라리아에 대한 유전적 저항력이라는 교란 요인을 포함하여 시뮬레이션되었습니다. 이 변수를 포함하지 않음으로써 우리는 약간 편향된 효과를 계산했던 것입니다. 모기장 사용이 말라리아에 미치는 실제 효과는 약 -10입니다.
이 효과를 계산하기 위해 우리는 다음과 같은 과정을 거쳤습니다:
책의 나머지 부분에서 우리는 다양한 도메인의 사례들을 통해 이러한 광범위한 단계들을 따를 것입니다. 우리는 성향 점수 기술을 더 깊이 파고들고, 인과 효과를 추정하기 위한 다른 방법들을 탐구하며, 무엇보다도 우리가 내리는 가정이 합리적인지 반복해서 확인할 것입니다.