경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
인과 추론의 많은 가정이 검증 불가능하므로, 결과의 타당성을 우려하는 것은 자연스러운 일입니다. 16장에서는 가정과 결과의 강점 및 약점을 검토하는 몇 가지 방법을 소개합니다. 우리는 두 가지 주요 방법을 살펴봅니다. 하나는 인과적 질문과 관련 DAG의 논리적 함의를 탐구하는 것이고, 다른 하나는 측정되지 않은 교란(unmeasured confounding) 등이 있을 때 결과가 어떻게 달라질지 수학적 기법으로 정량화하는 것입니다. 이런 접근 방식을 민감도 분석(sensitivity analyses)이라고 합니다. 분석 시 설정한 가정과 조건이 바뀌었을 때 결과가 얼마나 민감하게 반응하는지 확인하는 과정입니다.
모델링을 시작했던 지점인 인과 다이어그램 작성 단계부터 다시 살펴봅시다. DAG는 분석의 기초가 되는 가정을 담고 있으므로, 타인뿐만 아니라 스스로의 분석을 비판적으로 검토하기 좋은 지점입니다.
조정 집합 등을 찾으려고 DAG를 쿼리하는 수학적 원리를 활용하면 DAG의 다른 함의들도 확인할 수 있습니다. 가장 단순한 함의 중 하나는, DAG가 옳고 데이터가 정확하게 측정되었다면 어떤 유효한 조정 집합을 사용하더라도 인과 효과에 대해 편향되지 않은 추정치를 얻어야 한다는 것입니다. 그림 16.1 에서 소개한 DAG를 살펴봅시다.
coord_dag <- list(
  x = c(park_ticket_season = 0, park_close = 0, park_temperature_high = -1, park_extra_magic_morning = 1, wait_minutes_posted_avg = 2),
  y = c(park_ticket_season = -1, park_close = 1, park_temperature_high = 0, park_extra_magic_morning = 0, wait_minutes_posted_avg = 0)
)

labels <- c(
  park_extra_magic_morning = "엑스트라 매직 아워",
  wait_minutes_posted_avg = "평균\n대기 시간",
  park_ticket_season = "티켓\n시즌",
  park_temperature_high = "과거 최고 기온",
  park_close = "공원 폐쇄\n시간"
)

emm_wait_dag <- dagify(
  wait_minutes_posted_avg ~ park_extra_magic_morning + park_close + park_ticket_season + park_temperature_high,
  park_extra_magic_morning ~ park_temperature_high + park_close + park_ticket_season,
  coords = coord_dag,
  labels = labels,
  exposure = "park_extra_magic_morning",
  outcome = "wait_minutes_posted_avg"
)

curvatures <- rep(0, 7)
curvatures[5] <- .3

emm_wait_dag |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = curvatures, edge_color = "grey80") +
  geom_dag_point() +
  geom_dag_text_repel(aes(label = label), size = 3.8, seed = 1630, color = "#494949") +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off") +
  scale_x_continuous(
    limits = c(-1.25, 2.25),
    breaks = c(-1, 0, 1, 2)
  )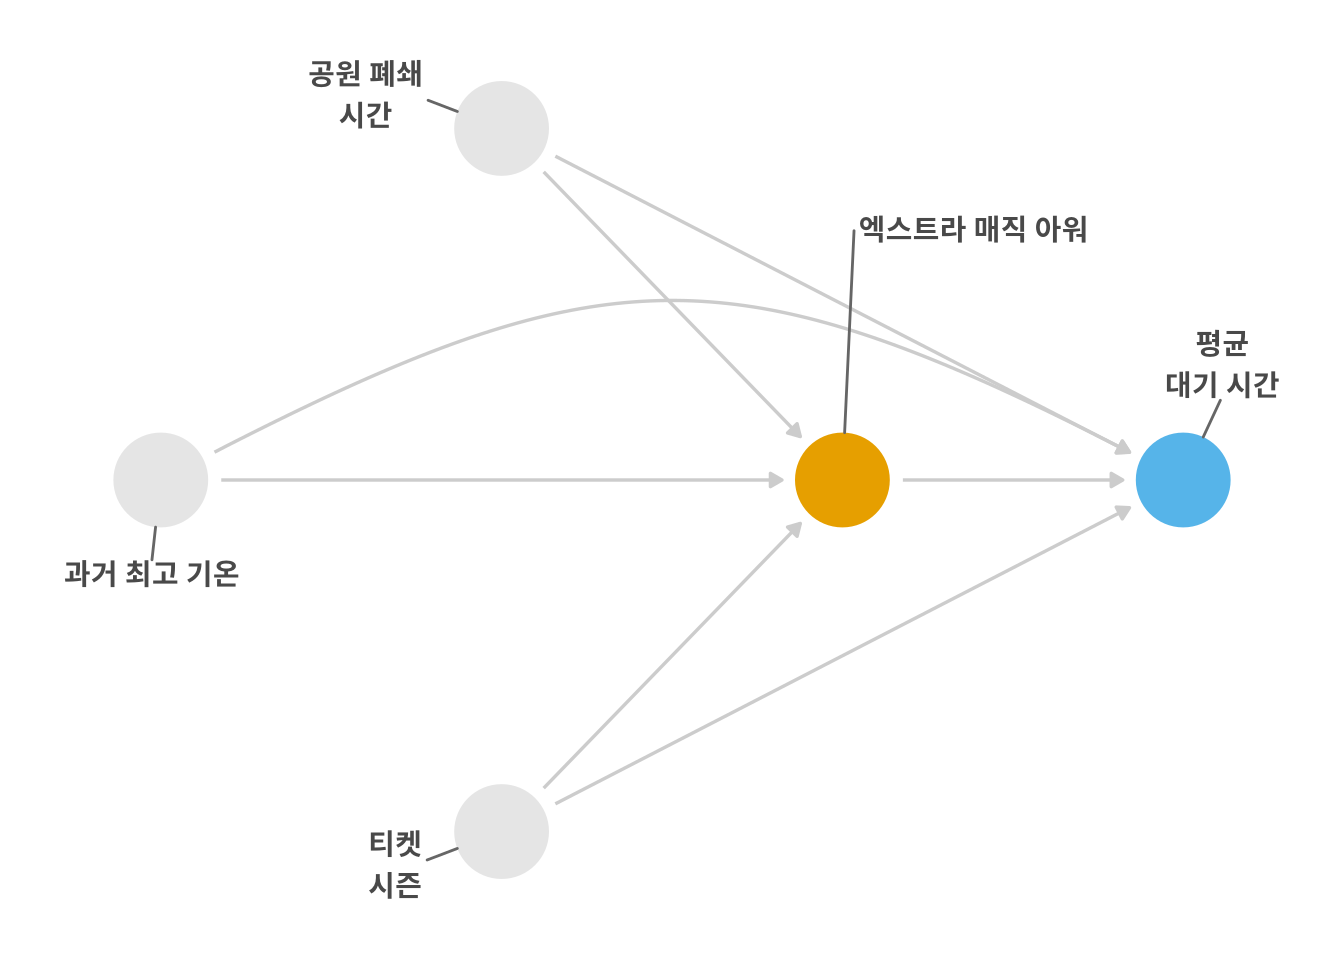
그림 16.1 에는 세 개의 교란 요인이 모두 독립적인 백도어 경로를 나타내기 때문에 단 하나의 조정 집합만 존재합니다. 하지만 만약 우리가 그림 16.2 을 대신 사용했다고 가정해 봅시다. 여기에는 공원 폐쇄 시간과 과거 기온에서 아침 엑스트라 매직 아워 여부로 가는 화살표가 누락되어 있습니다.
emm_wait_dag_missing <- dagify(
  wait_minutes_posted_avg ~ park_extra_magic_morning + park_close + park_ticket_season + park_temperature_high,
  park_extra_magic_morning ~ park_ticket_season,
  coords = coord_dag,
  labels = labels,
  exposure = "park_extra_magic_morning",
  outcome = "wait_minutes_posted_avg"
)

# 생성된 조정 집합:
# park_ticket_season, park_close + park_ticket_season, park_temperature_high + park_ticket_season, or park_close + park_temperature_high + park_ticket_season
adj_sets <- unclass(dagitty::adjustmentSets(emm_wait_dag_missing, type = "all")) |>
  map_chr(\(.x) glue::glue('{unlist(glue::glue_collapse(.x, sep = " + "))}')) |>
  glue::glue_collapse(sep = ", ", last = ", 또는 ")

curvatures <- rep(0, 5)
curvatures[3] <- .3

emm_wait_dag_missing |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = curvatures, edge_color = "grey80") +
  geom_dag_point() +
  geom_dag_text_repel(aes(label = label), size = 3.8, seed = 1630, color = "#494949") +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off") +
  scale_x_continuous(
    limits = c(-1.25, 2.25),
    breaks = c(-1, 0, 1, 2)
  )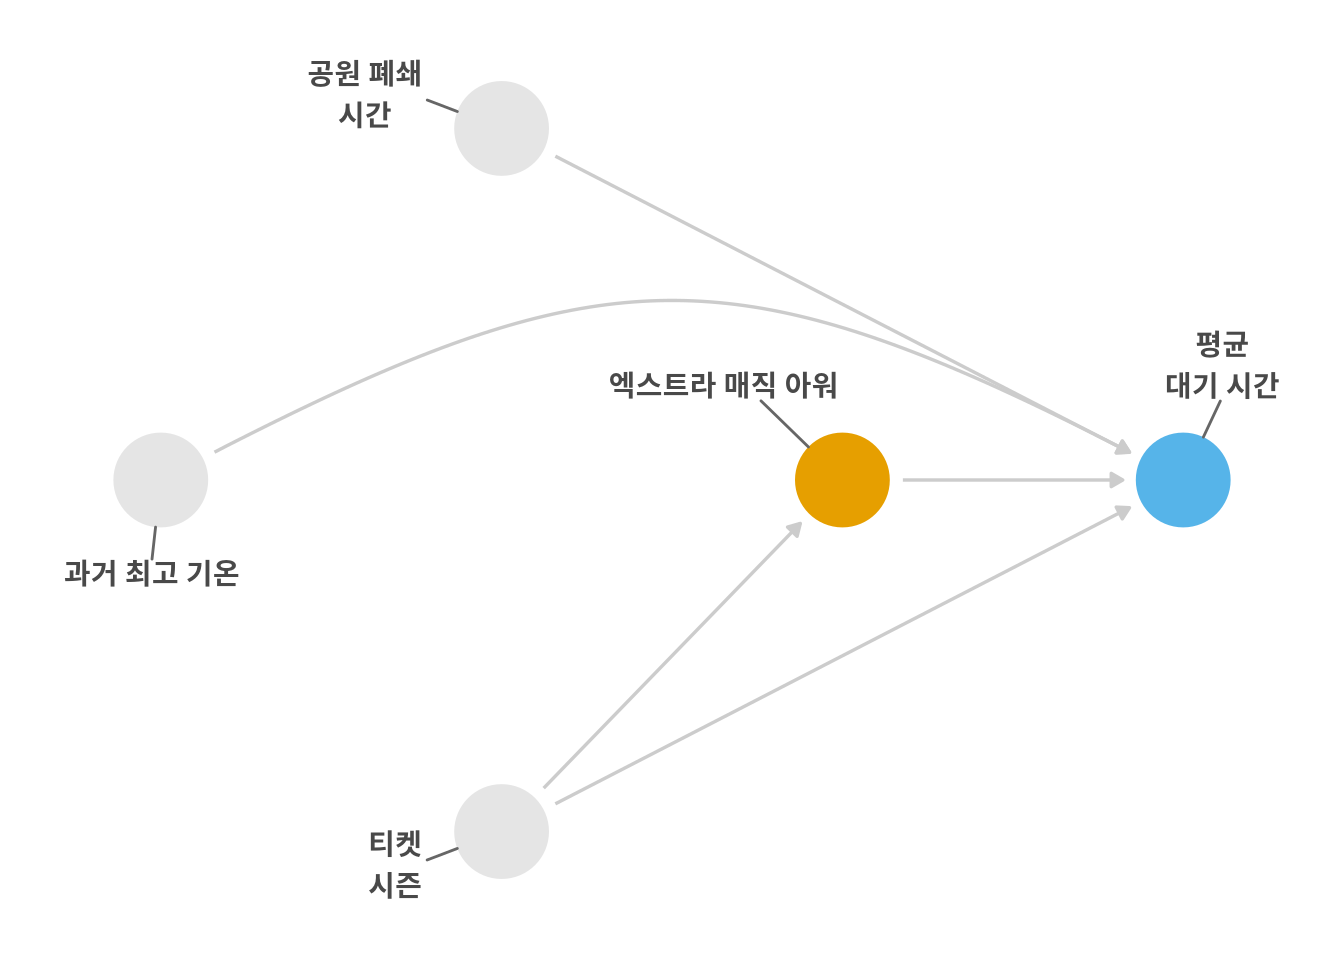
이제 4개의 잠재적인 조정 집합이 있습니다: park_ticket_season, park_close + park_ticket_season, park_temperature_high + park_ticket_season, 또는 park_close + park_temperature_high + park_ticket_season. 표 tbl-alt-sets은 각 조정 집합별 IPW 추정치를 보여줍니다. 결과들이 상당히 다릅니다. 완벽하게 측정되지 않은 서로 다른 변수들을 사용했으므로 추정치에 약간의 변동이 생기는 것은 자연스럽습니다. 하지만 이 DAG가 옳다면 결과들이 지금보다 훨씬 더 일관되어야 합니다. 특히 공원 폐쇄 시간이 포함된 모델과 포함되지 않은 모델 사이에 약 3분의 차이가 납니다. 이런 결과 차이는 설정한 인과 구조에 오류가 있을 수 있음을 시사합니다.
seven_dwarfs <- touringplans::seven_dwarfs_train_2018 |>
  filter(wait_hour == 9)

# 나중에 `.data`와 `.trt`를 사용할 것입니다
fit_ipw_effect <- function(.fmla, .data = seven_dwarfs, .trt = "park_extra_magic_morning", .outcome_fmla = wait_minutes_posted_avg ~ park_extra_magic_morning) {
  .trt_var <- rlang::ensym(.trt)

  # 성향 점수 모델 적합
  propensity_model <- glm(
    .fmla,
    data = .data,
    family = binomial()
  )

  # ATE 가중치 계산
  .df <- propensity_model |>
    augment(type.predict = "response", data = .data) |>
    mutate(w_ate = wt_ate(.fitted, !!.trt_var, exposure_type = "binary"))

  # IPW 모델 적합
  lm(.outcome_fmla, data = .df, weights = w_ate) |>
    tidy() |>
    filter(term == .trt) |>
    pull(estimate)
}

effects <- list(
  park_extra_magic_morning ~ park_ticket_season,
  park_extra_magic_morning ~ park_close + park_ticket_season,
  park_extra_magic_morning ~ park_temperature_high + park_ticket_season,
  park_extra_magic_morning ~ park_temperature_high +
    park_close + park_ticket_season
) |>
  map_dbl(fit_ipw_effect)

tibble(
  `조정 집합` = c(
    "티켓 시즌",
    "폐쇄 시간, 티켓 시즌",
    "과거 최고 기온, 티켓 시즌",
    "과거 최고 기온, 폐쇄 시간, 티켓 시즌"
  ),
  ATE = effects
) |>
  arrange(desc(ATE)) |>
gt::gt()| 조정 집합 | ATE |
|---|---|
| 폐쇄 시간, 티켓 시즌 | 6.579 |
| 과거 최고 기온, 폐쇄 시간, 티켓 시즌 | 6.199 |
| 티켓 시즌 | 4.114 |
| 과거 최고 기온, 티켓 시즌 | 3.627 |
대안적 조정 집합(alternate adjustment sets)은 DAG의 논리적 함의를 조사하는 한 방법입니다. DAG가 옳다면 열린 백도어 경로를 올바르게 통제하는 방법은 여러 가지가 있을 수 있습니다. 반대로 연구 질문의 인과 구조는 관계가 없어야 하는, 즉 무효(null)인 관계들도 함의합니다. 연구자들은 이런 함의를 활용하기 위해 부정 대조군(negative controls)을 이용하기도 합니다. 부정 대조군은 연구 질문과 가능한 한 많은 면에서 유사하지만, 인과적 효과가 없어야 하는 노출(부정 노출 대조군)이나 결과(부정 결과 대조군)를 말합니다. Lipsitch, Tchetgen Tchetgen, 와/과 Cohen (2010) 은 관찰 연구를 위한 부정 대조군을 설명합니다. 그들의 논문에서는 기초 과학(bench science)에서의 표준적인 대조군들을 언급합니다. 실험실 실험에서는 다음과 같은 조치 중 하나라도 취하면 무효 효과(null effect)가 나타나야 합니다:
이는 실험실 연구에만 국한된 것이 아닙니다. 과학자들은 자신의 이해와 가설이 지닌 논리적 함의를 조사할 뿐입니다. 적절한 부정 대조군을 찾으려면 대개 질문을 둘러싼 인과 구조를 더 폭넓게 포함하도록 DAG를 확장해야 합니다. 몇 가지 예시를 살펴봅시다.
먼저 부정 노출 대조군을 살펴보겠습니다. 엑스트라 매직 아워가 실제로 대기 시간을 늘린다면, 그 효과는 특정 시간대에 국한된다고 보는 것이 타당합니다. 다시 말해, 일정 기간이 지나면 엑스트라 매직 아워의 효과가 사라져야 합니다. 오늘을 i, 이전 날을 i - n이라 합시다. 여기서 n은 결과 발생 며칠 전에 부정 노출 대조군이 나타나는지를 뜻합니다. 먼저 n = 63인 경우를 조사해 봅시다. 즉, 9주 전에 엑스트라 매직 아워가 있었는지 확인하는 것입니다. 이는 꽤 합리적인 시작점입니다. 대기 시간에 미치는 효과가 63일 후까지 지속될 가능성은 낮기 때문입니다. 이 분석은 ‘필수 성분을 빠뜨린’ 사례에 해당합니다. 현실적인 원인으로 작용하기에는 너무 긴 시간이 지났기 때문입니다. 여전히 효과가 남아 있다면 이는 잔차 교란(residual confounding) 때문일 가능성이 큽니다.
이 상황을 시각화하기 위해 DAG를 살펴봅시다. 그림 16.3 에서 원래 구조에 동일한 레이어를 하나 더 추가했습니다. 이제 두 개의 엑스트라 매직 아워가 있습니다. 하나는 i일의 것이고 하나는 i - 63일의 것입니다. 마찬가지로 각 날짜별로 두 버전의 교란 요인이 있습니다. 이 DAG에서 한 가지 중요한 세부 사항은 i - 63일의 엑스트라 매직 아워가 i일의 상태에 영향을 미친다고 가정한다는 점입니다. 특정 날의 엑스트라 매직 아워 시행 여부가 다른 날의 시행 여부에도 영향을 줄 가능성이 크기 때문입니다. 연중 배치 시점이 무작위로 결정되지 않기 때문입니다. 이것이 사실이라면 i일의 엑스트라 매직 아워 상태를 통한 간접 효과가 나타날 것입니다. 유효한 부정 대조군을 얻으려면 이 효과를 비활성화해야 하며, 이는 통계적으로 i일의 엑스트라 매직 아워 상태를 통제하여 수행할 수 있습니다. 따라서 이 DAG에서 조정 집합은 교란 요인의 임의 조합(각 날짜별로 최소 하나씩 포함)과 i일의 엑스트라 매직 아워(간접 효과 억제용)가 됩니다.
labels <- c(
  x63 = "엑스트라 매직 아워 (i-63)",
  x = "엑스트라 매직 아워 (i)",
  y = "평균 대기 시간",
  season = "티켓 시즌",
  weather = "과거 최고 기온",
  close = "폐쇄 시간 (i)",
  season63 = "티켓 시즌\n(i-63)",
  weather63 = "과거 최고 기온\n(i-63)",
  close63 = "폐쇄 시간 (i-63)"
)

dagify(
  y ~ x + close + season + weather,
  x ~ weather + close + season + x63,
  x63 ~ weather63 + close63 + season63,
  weather ~ weather63,
  close ~ close63,
  season ~ season63,
  coords = time_ordered_coords(),
  labels = labels,
  exposure = "x63",
  outcome = "y"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_link(edge_color = "grey80") +
  geom_dag_point() +
  geom_dag_text_repel(aes(label = label), size = 3.8, color = "#494949") +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off")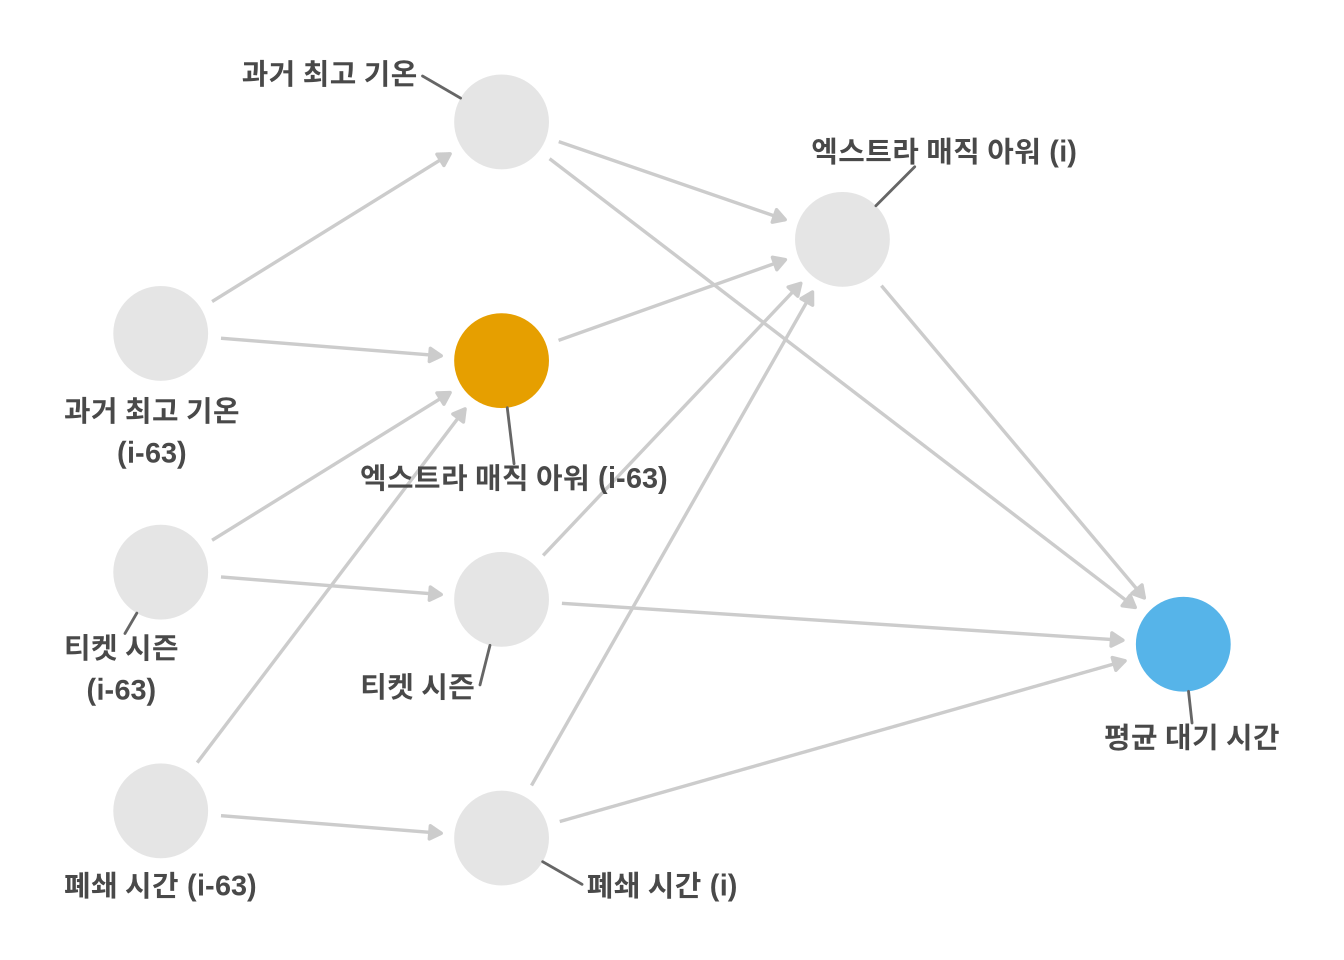
i - 63일과 관련된 이전의 교란 요인들도 포함되어 있습니다.
노출이 i - 63일 데이터이므로 그날과 관련된 교란 요인을 통제하는 것이 좋습니다. 따라서 i - 63 시점의 변수들을 사용하겠습니다. dplyr의 lag() 함수로 이 변수들을 가져옵니다.
n_days_lag <- 63
distinct_emm <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  arrange(park_date) |>
  transmute(
    park_date,
    prev_park_extra_magic_morning = lag(park_extra_magic_morning, n = n_days_lag),
    prev_park_temperature_high = lag(park_temperature_high, n = n_days_lag),
    prev_park_close = lag(park_close, n = n_days_lag),
    prev_park_ticket_season = lag(park_ticket_season, n = n_days_lag)
  )

seven_dwarfs_train_2018_lag <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  left_join(distinct_emm, by = "park_date") |>
  drop_na(prev_park_extra_magic_morning)
이 데이터를 IPW 효과에 사용하면 -0.93분을 얻는데, 이는 i일에 발견한 것보다 훨씬 무효(null)에 가깝습니다. 시간에 따른 효과를 살펴봅시다. 엑스트라 매직 아워의 효과가 잠시(예: 디즈니 월드 평균 여행 기간) 동안은 남아있을 수 있지만, 곧 사라져야 합니다. 하지만 그림 fig-sens-i-63에서 보듯, 효과는 결국 사라지더라도 꽤 오랫동안 남아있습니다. 이 결과가 정확하다면 효과 추정치에 약간의 잔차 교란(residual confounding)이 존재함을 의미합니다.
coefs <- purrr::map_dbl(1:63, calculate_coef)

ggplot(tibble(coefs = coefs, x = 1:63), aes(x = x, y = coefs)) +
  geom_hline(yintercept = 0) +
  geom_point() +
  geom_smooth(se = FALSE) +
  labs(y = "대기 시간 차이 (분)\n (`i`일 대기 시간 vs `i-n`일 EMM)", x = "`i - n`일")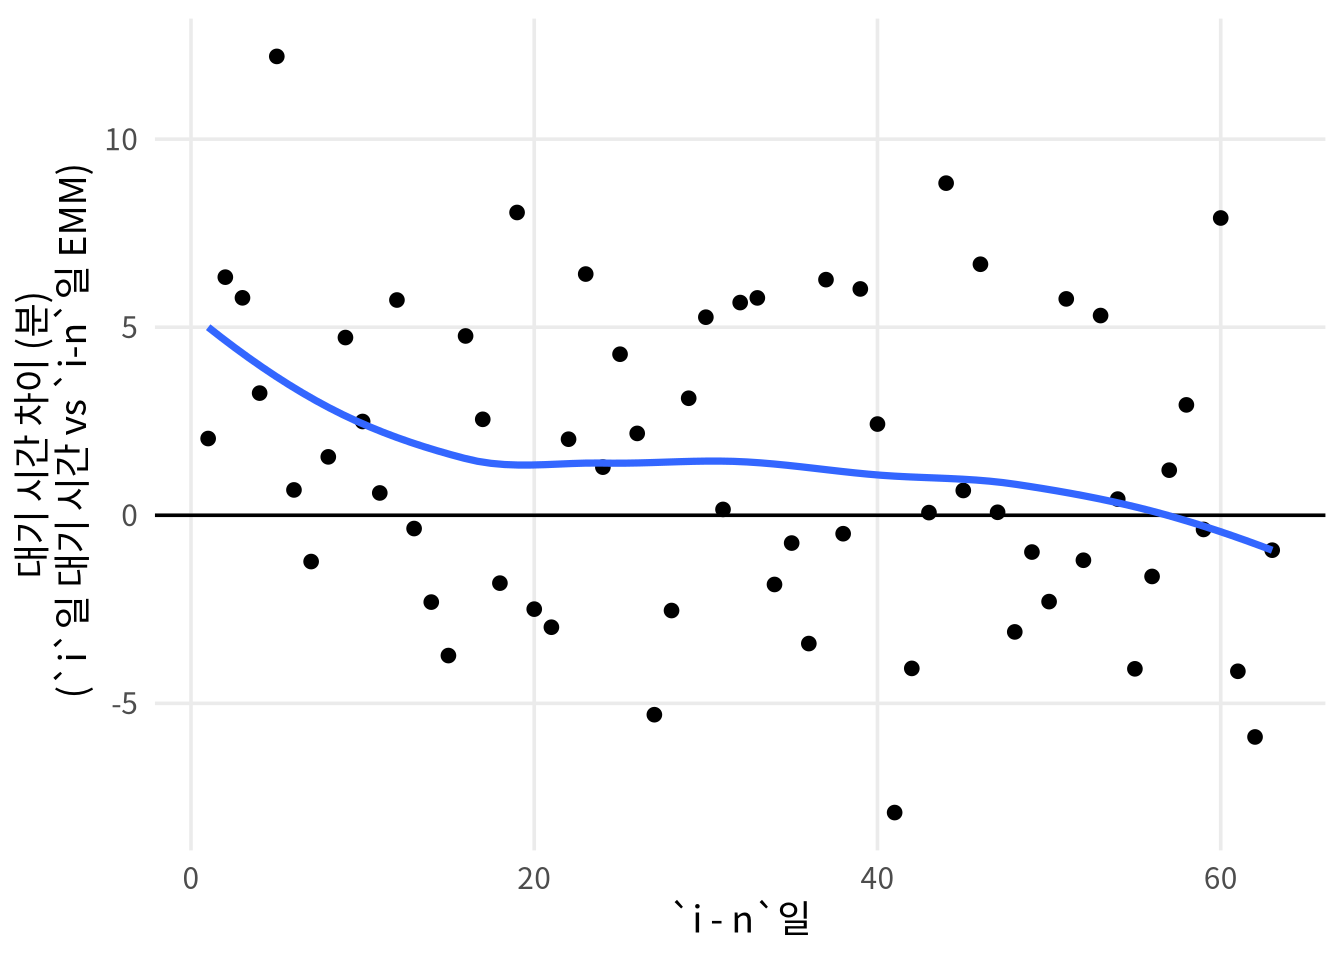
i일의 대기 시간과 i - n일의 엑스트라 매직 아워 여부 사이의 관계를 나타낸 산점도와 평활 회귀선. 여기서 n은 i일 이전의 일수를 나타냅니다. 우리는 이 관계가 빠르게 무효로 수렴할 것으로 기대하지만, 효과는 꽤 오랫동안 무효값 위에 머물러 있습니다. 이렇게 지속되는 효과는 잔차 교란이 존재함을 의미합니다.
이제 부정 대조군 결과의 예시를 살펴보겠습니다. 유니버설 스튜디오(Universal Studios)의 놀이기구 대기 시간입니다. 유니버설 스튜디오 역시 올랜도에 있으므로 대기 시간을 유발하는 요인들은 같은 날의 디즈니 월드와 비슷할 가능성이 큽니다. 물론 디즈니의 엑스트라 매직 아워 시행 여부가 같은 날 유니버설의 대기 시간에 영향을 주지는 않을 것입니다. 두 공원은 서로 다르며, 대부분의 방문객이 한 시간 내에 두 곳을 모두 방문하지는 않기 때문입니다. 이 부정 대조군은 가설상의 메커니즘상 나타날 수 없는 효과를 보여주는 예시입니다.
유니버설 놀이기구 데이터가 없으므로 잔차 교란 유무에 따른 변화를 시뮬레이션해 보겠습니다. 과거 기온, 공원 폐쇄 시간, 티켓 시즌을 바탕으로 대기 시간을 생성합니다. (폐쇄 시간과 티켓 시즌은 디즈니 전용 변수지만, 유니버설의 상황과도 강한 상관관계가 있을 것입니다.) 이것은 부정 결과이므로, 디즈니에 엑스트라 매직 아워가 있었는지 여부와는 관련이 없습니다.
seven_dwarfs_sim <- seven_dwarfs_train_2018 |>
  mutate(
    # 합리적인 유니버설 대기 시간을 시뮬레이션하기 위해
    # 각 변수를 스케일링하고 약간의 무작위 노이즈를 추가합니다
    wait_time_universal =
      park_temperature_high / 150 +
        as.numeric(park_close) / 1500 +
        as.integer(factor(park_ticket_season)) / 1000 +
        rnorm(n(), 5, 5)
)wait_time_universal에 대한 park_extra_magic_morning의 IPW 효과를 계산하면, 예상대로 무효에 가까운 -0.1분이 나옵니다. 하지만 디즈니와 유니버설 모두의 엑스트라 매직 아워와 대기 시간에 영향을 주는 측정되지 않은 교란 요인 u를 놓쳤다면 어떨까요? 데이터를 보강해 해당 시나리오를 시뮬레이션해 보겠습니다.
seven_dwarfs_sim2 <- seven_dwarfs_train_2018 |>
  mutate(
    u = rnorm(n(), mean = 10, sd = 3),
    wait_minutes_posted_avg = wait_minutes_posted_avg + u,
    park_extra_magic_morning = if_else(
      u > 10,
      rbinom(1, 1, .1),
      park_extra_magic_morning
    ),
    wait_time_universal =
      park_temperature_high / 150 +
        as.numeric(park_close) / 1500 +
        as.integer(factor(park_ticket_season)) / 1000 +
        u +
        rnorm(n(), 5, 5)
  )
이제 디즈니와 유니버설 대기 시간 모두에 대한 효과가 바뀝니다. 만약 우리가 디즈니에 대해 -1.28분의 효과를 보았다면, 그것이 교란된 결과라는 것을 반드시 알 수는 없었을 것입니다. 하지만 유니버설 대기 시간은 관련이 없어야 하므로, 결과값 -2.7분이 무효가 아니라는 점은 의심스러운 부분입니다. 이는 측정되지 않은 교란이 존재한다는 증거입니다.
부정 대조군은 가정한 인과 구조의 논리적 함의를 활용합니다. 우리는 그 아이디어를 전체 DAG로 확장할 수 있습니다. DAG가 옳다면 내부 변수들이 통계적으로 어떤 관계를 맺어야 하는지(또는 맺지 않아야 하는지)에 대한 많은 함의가 존재합니다. 부정 대조군과 마찬가지로 데이터에서 독립적이어야 할 변수들이 실제로 그러한지 확인할 수 있습니다. 때로 DAG가 변수 간 독립성을 함의하는 방식은 다른 변수에 대한 조건부입니다. 그래서 이 기법을 함의된 조건부 독립성(implied conditional independencies)이라고 부르기도 합니다 (Textor 기타 2017). 원래 DAG를 쿼리하여 변수 간 관계를 어떻게 설명하는지 알아봅시다.
query_conditional_independence(emm_wait_dag) |>
  unnest(conditioned_on)
# A tibble: 3 × 5
set a b conditioning_set conditioned_on
<chr> <chr> <chr> <chr> <chr>
1 1 park_clo… park… <NA> <NA>
2 2 park_clo… park… <NA> <NA>
3 3 park_tem… park… <NA> <NA> 이 DAG에서는 다음 세 관계가 무효(null)여야 합니다. 1) park_close와 park_temperature_high, 2) park_close와 park_ticket_season, 3) park_temperature_high와 park_ticket_season. 이들은 독립성을 위해 다른 변수를 조건부화할 필요가 없습니다. 즉, 무조건부 독립(unconditionally independent) 상태여야 합니다. 상관관계나 회귀 분석 등 간단한 통계 기법을 사용하여 이러한 무효성이 유지되는지 확인할 수 있습니다. 복잡한 DAG에서는 조건부 독립성(conditional independencies)의 수가 급격히 늘어납니다. 따라서 dagitty는 이런 함의된 무효성을 바탕으로 DAG와 데이터의 일관성을 자동 확인하는 기능을 제공합니다. dagitty는 주어진 조건부 관계의 잔차(residuals)들이 서로 상관되어 있는지 확인하며, 이는 여러 방식으로 자동 모델링됩니다. type = "cis.loess"를 사용하여 비선형 모델로 잔차를 계산하도록 설정하겠습니다. 상관관계를 다루므로 DAG가 옳다면 결과는 0에 가까워야 합니다. 하지만 그림 fig-conditional-ind에서 보듯, 한 관계가 성립하지 않습니다. 공원 폐쇄 시간과 티켓 시즌 사이에 상관관계가 존재합니다.
test_conditional_independence(
  emm_wait_dag,
  data = seven_dwarfs_train_2018 |>
    filter(wait_hour == 9) |>
    mutate(
      across(where(is.character), factor),
      park_close = as.numeric(park_close),
    ) |>
    as.data.frame(),
  type = "cis.loess",
  # 신뢰 구간 계산을 위해 200개의 부트스트랩 샘플 사용
  R = 200
) |>
  ggdag_conditional_independence()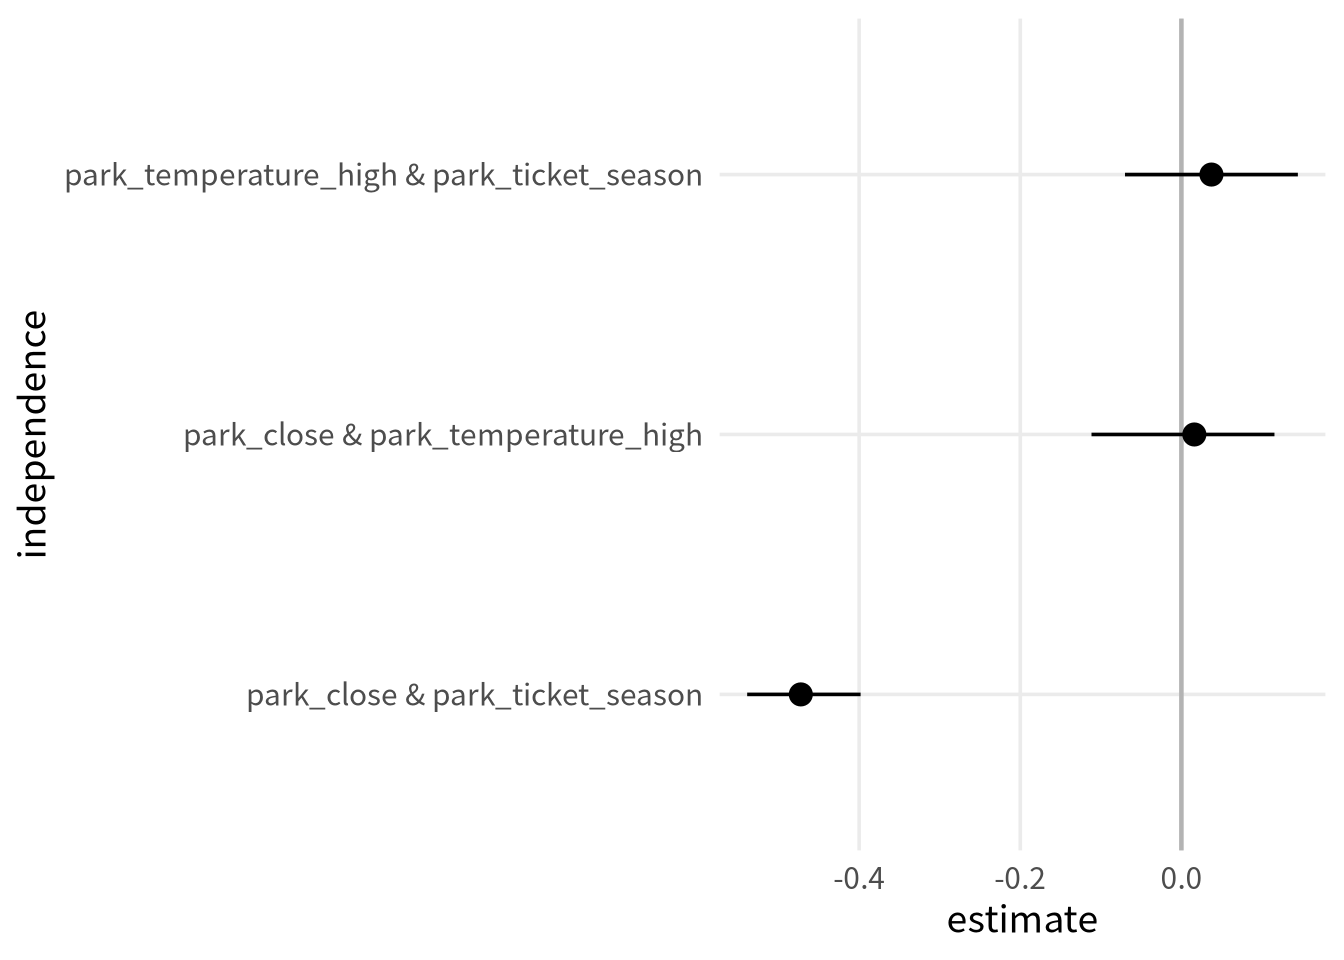
왜 관계가 없어야 할 지점에서 관계가 나타날까요? 단순하게는 우연일 수 있습니다. 모든 통계적 추론이 그렇듯 제한된 표본의 결과를 과도하게 일반화하지 않도록 주의해야 합니다. 하지만 여기서는 2018년 전체 데이터를 사용하므로 우연일 가능성은 낮습니다. 다른 이유는 변수 간 직접적인 화살표가 누락되었기 때문일 수 있습니다. 예컨대 과거 기온에서 공원 폐쇄 시간으로 가는 화살표 같은 경우입니다. 추가 화살표를 그리는 것은 합리적입니다. 공원 폐쇄 시간과 티켓 시즌은 날씨와 밀접하게 관련되기 때문입니다. 이는 화살표가 누락되었다는 증거가 됩니다.
이때 데이터를 DAG에 과적합(overfitting)시키지 않도록 주의해야 합니다. DAG-데이터 일관성 테스트는 DAG의 정답 여부를 증명할 수 없으며, sec-quartets에서 보았듯 통계적 기법만으로는 인과 구조를 결정할 수 없습니다. 그렇다면 왜 이런 테스트를 수행할까요? 부정 대조군처럼 이 테스트도 가정을 검토하는 수단이 됩니다. 확신할 수는 없더라도 데이터가 전하는 정보에 귀를 기울일 필요가 있습니다. 조건부 독립성이 성립함을 확인하는 것은 가정을 뒷받침하는 또 하나의 근거가 됩니다. 주의할 점이 있으므로 이런 확인 작업은 투명하게 공개해야 합니다. 테스트 결과에 따라 수정했다면 원래 DAG도 함께 보고하는 것이 좋습니다. 특히 이 사례에서는 세 관계 모두에 직접적인 화살표를 추가해도 조정 집합은 바뀌지 않습니다.
화살표가 누락되어 잘못 설정된 예시를 살펴봅시다. 공원 폐쇄 시간과 티켓 시즌에서 엑스트라 매직 아워로 가는 화살표를 제거해 보겠습니다.
labels <- c(
  park_extra_magic_morning = "엑스트라 매직\n아워",
  wait_minutes_posted_avg = "평균\n대기 시간",
  park_ticket_season = "티켓\n시즌",
  park_temperature_high = "과거 최고\n기온",
  park_close = "공원 폐쇄\n시간"
)
emm_wait_dag2 <- dagify(
wait_minutes_posted_avg ~ park_extra_magic_morning + park_close +
park_ticket_season + park_temperature_high,
park_extra_magic_morning ~ park_temperature_high,
coords = coord_dag,
labels = labels,
exposure = "park_extra_magic_morning",
outcome = "wait_minutes_posted_avg"
)
query_conditional_independence(emm_wait_dag2) |>
unnest(conditioned_on)# A tibble: 5 × 5
set a b conditioning_set conditioned_on
<chr> <chr> <chr> <chr> <chr>
1 1 park_clo… park… <NA> <NA>
2 2 park_clo… park… <NA> <NA>
3 3 park_clo… park… <NA> <NA>
4 4 park_ext… park… <NA> <NA>
5 5 park_tem… park… <NA> <NA> 이 대안적 DAG는 독립적이어야 할 두 가지 새로운 관계를 도입합니다. 문제의 특성을 고려할 때 그럴 가능성이 높아 보이지만, DAG-데이터 일관성 테스트를 해석하는 데는 한계가 있습니다. 서로 다른 DAG들이 동일한 조건부 독립성 집합을 가질 수 있기 때문입니다.
curvatures <- rep(0, 10)
curvatures[3] <- .25
curvatures[8] <- .25

ggdag_equivalent_dags(emm_wait_dag2, use_edges = FALSE, use_text = FALSE) +
  geom_dag_edges_arc(curvature = curvatures, edge_color = "grey90") +
  geom_dag_point() +
  geom_dag_text_repel(aes(label = label), data = function(x) filter(x, label %in% c("엑스트라 매직\n아워", "과거 최고\n기온")), box.padding = 15, seed = 12, color = "#494949") +
  theme_dag()
Warning in edge_angle - strength: longer object length
is not a multiple of shorter object lengthWarning in edge_angle - pi + strength: longer object
length is not a multiple of shorter object length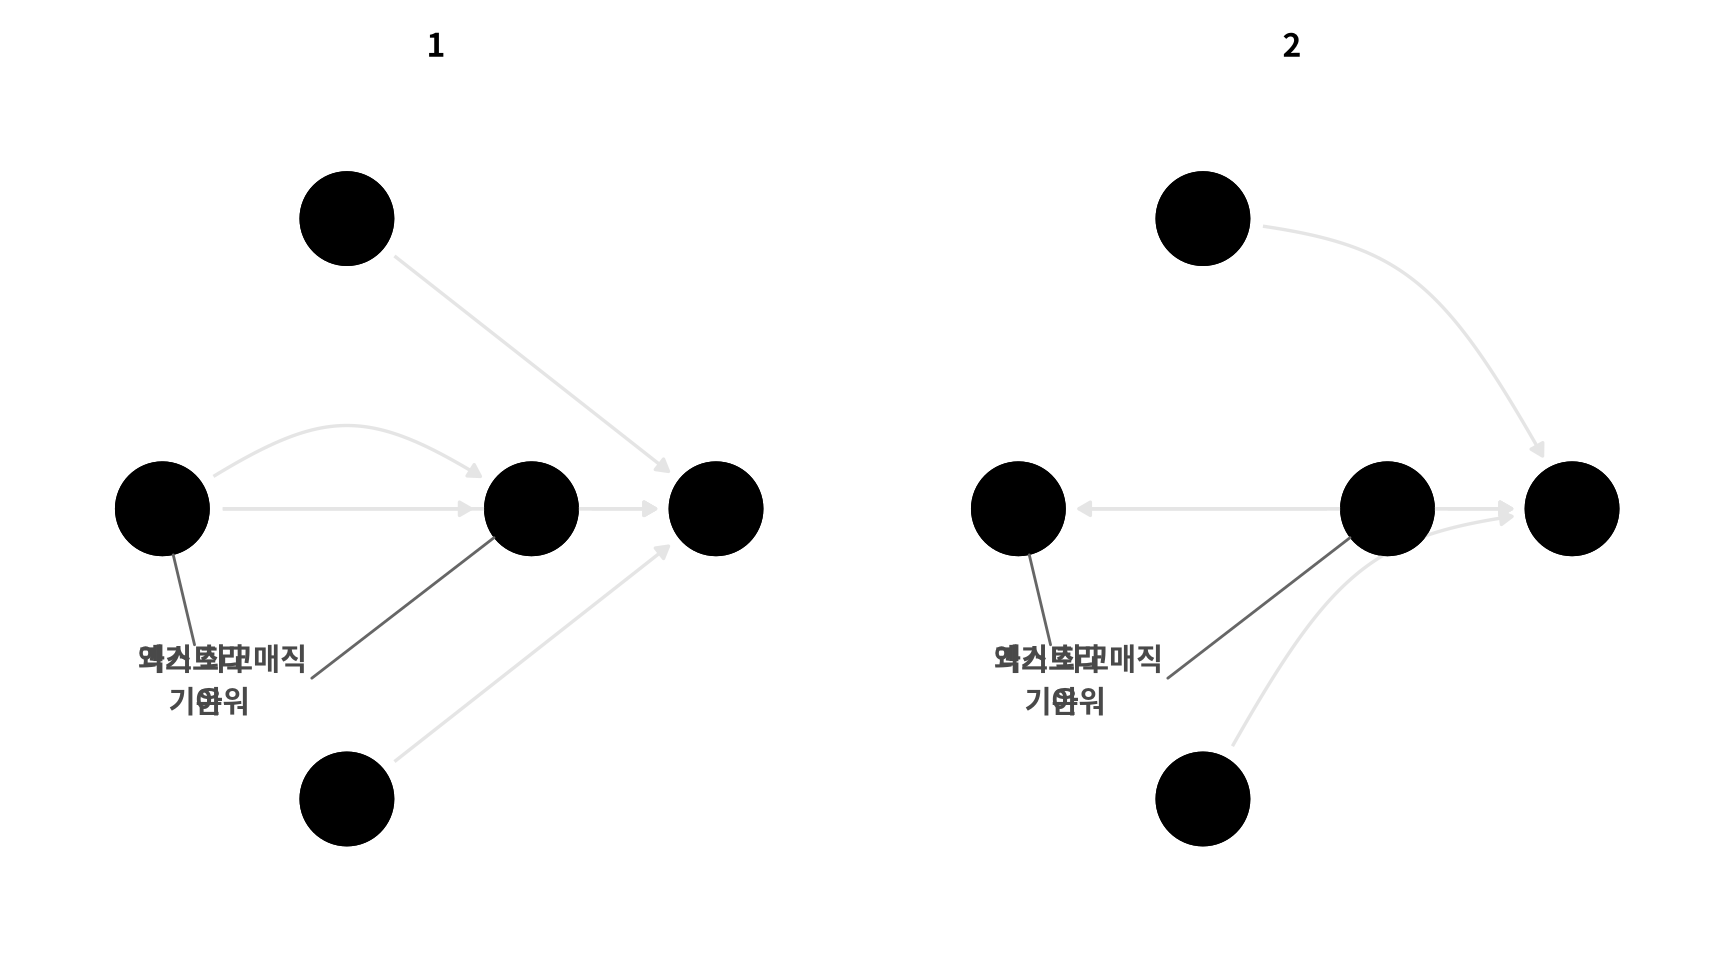
이들은 함의하는 바가 같기 때문에 ‘동등한(equivalent)’ DAG라고 부릅니다. 동등한 DAG는 화살표를 ’반전(reversing)’시켜 생성합니다. 동일한 함의를 가지면서 반전 가능한 화살표를 포함한 DAG들의 집합을 ’동등류(equivalence class)’라고 합니다. 다소 기술적인 내용이지만, 이러한 연결을 통해 반전 가능한 에지를 화살표가 없는 직선으로 표시함으로써 시각화 결과를 하나의 DAG로 응축할 수 있습니다 (그림 16.7).
curvatures <- rep(0, 4)
curvatures[3] <- .25

emm_wait_dag2 |>
  node_equivalent_class() |>
  ggdag(use_edges = FALSE, use_text = FALSE) +
  geom_dag_edges_arc(data = function(x) filter(x, !reversable), curvature = curvatures, edge_color = "grey90") +
  geom_dag_edges_link(data = function(x) filter(x, reversable), arrow = NULL) +
  geom_dag_text_repel(aes(label = label), data = function(x) filter(x, label %in% c("엑스트라 매직\n아워", "과거 최고\n기온")), box.padding = 16, seed = 12, size = 5, color = "#494949") +
  theme_dag()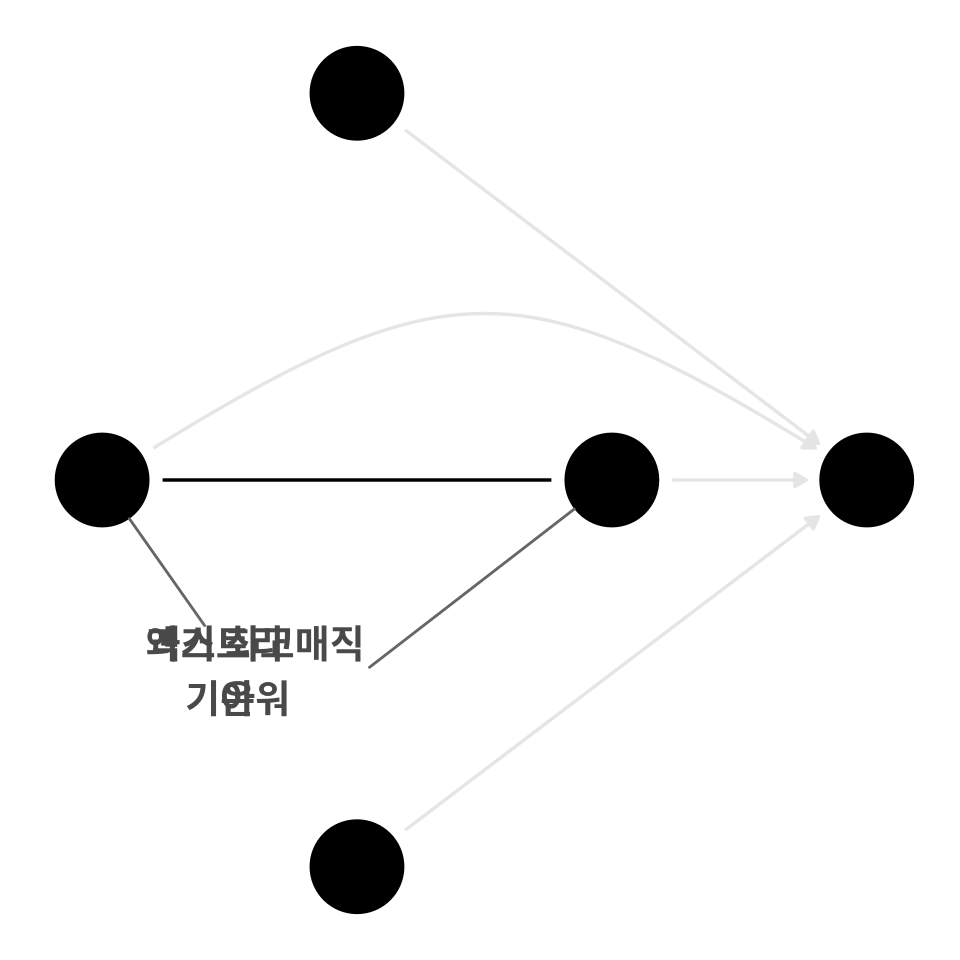
그렇다면 이 정보를 어떻게 활용할 수 있을까요? 여러 DAG가 동일한 조건부 독립성 집합을 생성할 수 있으므로, 모든 동등한 DAG에 대해 유효한 조정 집합을 모두 찾는 전략을 취할 수 있습니다. dagitty 패키지의 equivalenceClass()와 adjustmentSets()를 활용하면 이를 간단히 수행할 수 있습니다. 다만 이 사례에서는 겹치는 조정 집합이 전혀 없습니다.
library(dagitty)
# 모든 동등한 DAG에 대해 유효한 집합 결정
equivalenceClass(emm_wait_dag2) |>
  adjustmentSets(type = "all")
개별적인 동등 DAG들을 살펴보면 이를 확인할 수 있습니다.
dags <- equivalentDAGs(emm_wait_dag2)

# 겹치는 집합이 없음
dags[[1]] |> adjustmentSets(type = "all")
{ park_temperature_high }
{ park_close, park_temperature_high }
{ park_temperature_high, park_ticket_season }
{ park_close, park_temperature_high,
park_ticket_season }dags[[2]] |> adjustmentSets(type = "all") {}
{ park_close }
{ park_ticket_season }
{ park_close, park_ticket_season }다행히 이 사례에서는 동등한 DAG 중 하나가 논리적으로 타당하지 않습니다. 반전 가능한 에지가 ’과거 날씨’에서 ’엑스트라 매직 아워’로 향하고 있는데, 이는 시간적 순서(과거 기온은 이미 발생함)나 현실적인 논리(날씨 조절은 불가능함)로 볼 때 불가능하기 때문입니다. 이런 확인 작업을 할 때는 더 많은 데이터를 사용하더라도 시나리오들의 논리적, 시간적 타당성을 반드시 고려해야 합니다.
sec-dags-iterate장에서 언급했듯이, 다른 전문가들의 충분한 피드백을 받아 미리 DAG를 명시해야 합니다. 그림 fig-dag-extra-days장의 확장된 DAG를 살펴보겠습니다. 여기서는 ’주말 여부’와 ’휴일 여부’라는 두 개의 새로운 교란 요인을 추가했습니다. 공원이 주말이나 휴일에 더 붐비기 때문에 폐쇄 시간이 늦어지고, 동시에 엑스트라 매직 아워 배정과 대기 시간에도 영향을 줄 것이라고 판단했기 때문입니다.
labels <- c(
  park_extra_magic_morning = "엑스트라 매직\n아워",
  wait_minutes_posted_avg = "평균\n대기 시간",
  park_ticket_season = "티켓\n시즌",
  park_temperature_high = "과거 최고\n기온",
  park_close = "공원 폐쇄\n시간",
  is_weekend = "주말",
  is_holiday = "휴일"
)

emm_wait_dag3 <- dagify(
  wait_minutes_posted_avg ~ park_extra_magic_morning + park_close + park_ticket_season + park_temperature_high + is_weekend + is_holiday,
  park_extra_magic_morning ~ park_temperature_high + park_close + park_ticket_season + is_weekend + is_holiday,
  park_close ~ is_weekend + is_holiday,
  coords = time_ordered_coords(),
  labels = labels,
  exposure = "park_extra_magic_morning",
  outcome = "wait_minutes_posted_avg"
)

curvatures <- rep(0, 13)
curvatures[11] <- .25

emm_wait_dag3 |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = curvatures, edge_color = "grey80") +
  geom_dag_point() +
  geom_dag_text_repel(aes(label = label), size = 3.8, seed = 16301, color = "#494949") +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off")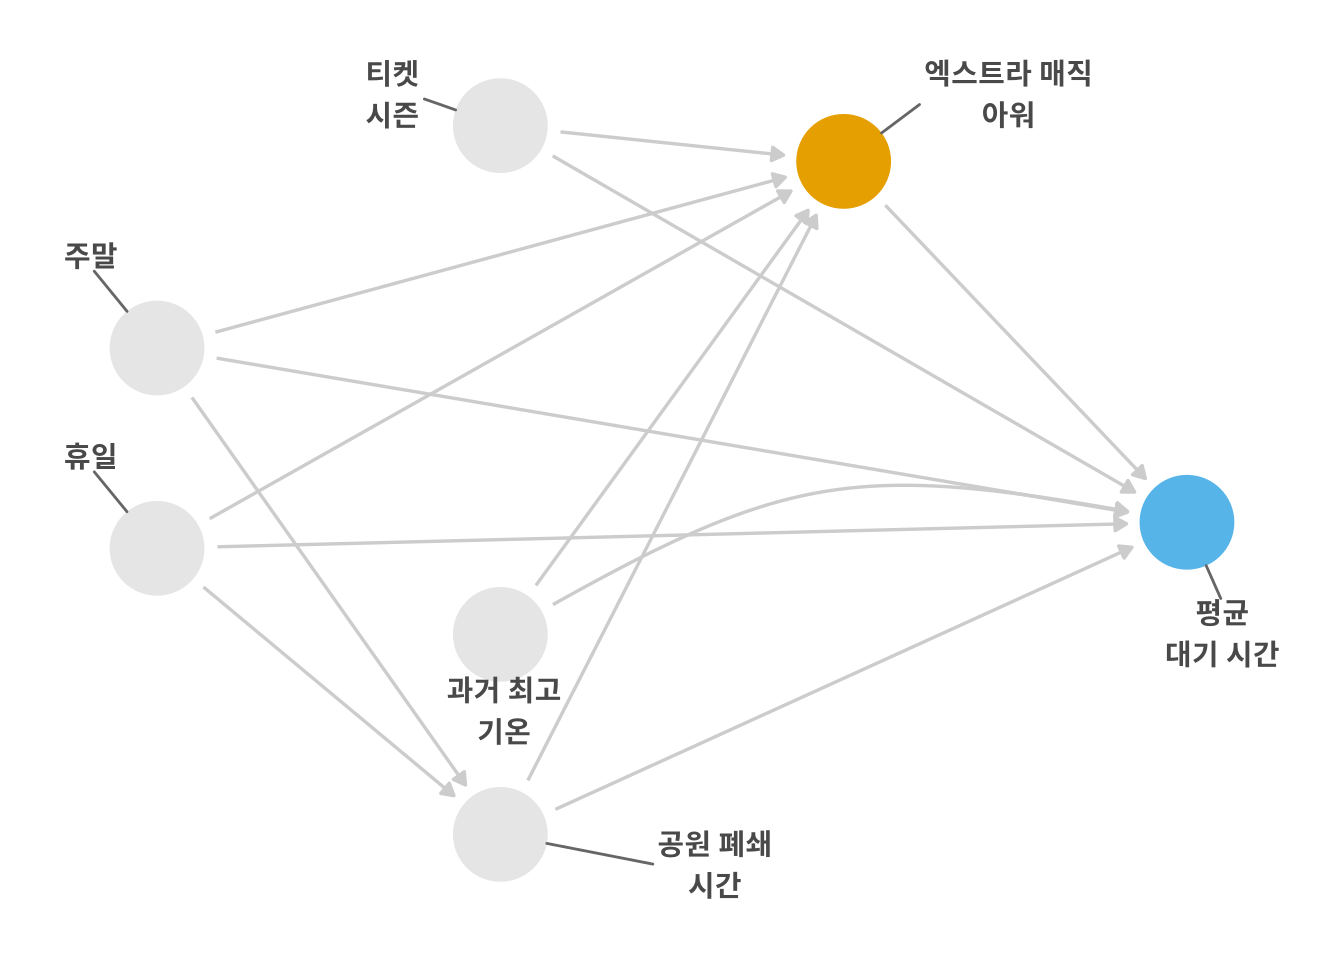
timeDate 패키지를 사용해 park_date로부터 이러한 특징들을 계산할 수 있습니다.
엑스트라 매직 아워와 게시 대기 시간 모두 휴일이나 주말 여부와 연관되어 있습니다 (표 16.2).
library(labelled)
var_label(seven_dwarfs_with_days) <- list(
  is_weekend = "주말",
  is_holiday = "휴일",
  park_extra_magic_morning = "엑스트라 매직 아워",
  wait_minutes_posted_avg = "게시 대기 시간"
)

tbl1 <- gtsummary::tbl_summary(
  seven_dwarfs_with_days,
  by = is_weekend,
  include = c(park_extra_magic_morning, wait_minutes_posted_avg)
)

tbl2 <- gtsummary::tbl_summary(
  seven_dwarfs_with_days,
  by = is_holiday,
  include = c(park_extra_magic_morning, wait_minutes_posted_avg)
)

gtsummary::tbl_merge(list(tbl1, tbl2), c("주말", "휴일"))| Characteristic |
주말
|
휴일
|
||
|---|---|---|---|---|
|
FALSE N = 2531 |
TRUE N = 1011 |
FALSE N = 3461 |
TRUE N = 81 |
|
| 엑스트라 매직 아워 | 55 (22%) | 5 (5.0%) | 58 (17%) | 2 (25%) |
| 게시 대기 시간 | 67 (60, 77) | 65 (56, 75) | 66 (58, 76) | 76 (63, 98) |
| 1 n (%); Median (Q1, Q3) | ||||
IPW 추정량을 다시 적용했을 때 7.24분을 얻었습니다. 이는 두 개의 새로운 교란 요인을 넣지 않았을 때보다 약간 더 큰 수치입니다. 이는 분석 계획과는 조금 다른 결과이므로 두 효과를 모두 보고하는 것이 좋습니다. 다만 이 새로운 DAG가 원래의 것보다 더 정확할 가능성이 큽니다. 의사 결정 관점에서 보면 절대적인 수치 차이는 약 1분 정도로 미미하며, 효과의 방향도 원래 추정치와 같습니다. 현재 가용한 정보들을 종합해 볼 때 이 결과는 큰 영향을 받지 않습니다.
여기서 한 가지 더 주의할 점이 있습니다. 때로는 점점 더 복잡한 조정 집합을 사용한 결과들을 제시하곤 하는데, 이는 복잡한 모델을 단순한 모델과 비교하는 전통에서 기인합니다. 이런 식의 비교 자체가 일종의 민감도 분석이 될 수 있지만 원칙이 있어야 합니다. 단순히 분석을 위해 모델을 복잡하게 만들기보다, 서로 경쟁하는 조정 집합이나 조건들을 비교해야 합니다. 예를 들어 두 DAG가 똑같이 타당하다고 느끼거나, 다른 변수를 추가하는 것이 매직 킹덤의 기준점 군중 흐름을 더 잘 포착하는지 조사하고 싶을 수 있습니다.
지금까지 인과 구조에 대해 세운 가이드라인들을 살펴보았습니다. 이제 수학적 가정을 활용해 서로 다른 조건에서 결과가 어떻게 달라지는지 확인하는 ’정량적 편향 분석’으로 내용을 확장해 보겠습니다.
측정되지 않은 교란 요인에 대한 민감도 분석은 관찰 연구 결과가 잠재적인 미측정 요인들에 대해 얼마나 강건한지 평가하는 중요한 도구입니다 (D’Agostino McGowan 2022). 이 분석은 다음 세 가지 핵심 요소에 의존합니다.
연구자가 이러한 관계들에 대해 타당한 값을 지정하면, 미측정 교란 요인이 존재할 때 관찰된 효과가 얼마나 바뀔지 정량화할 수 있습니다. 위의 예시 상황에서 이것이 왜 효과적인지 생각해 봅시다.
emm_wait_dag |>
  tidy_dagitty() |>
  node_status() |>
  mutate(linetype = if_else(name == "park_temperature_high", "dashed", "solid")) |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status, edge_linetype = linetype)
  ) +
  geom_dag_edges_arc(curvature = curvatures, edge_color = "grey80") +
  geom_dag_point() +
  geom_dag_text_repel(aes(label = label), size = 3.8, seed = 1630, color = "#494949") +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off") +
  scale_x_continuous(
    limits = c(-1.25, 2.25),
    breaks = c(-1, 0, 1, 2)
  )
Warning in edge_angle - strength: longer object length
is not a multiple of shorter object lengthWarning in edge_angle - pi + strength: longer object
length is not a multiple of shorter object lengthWarning in cos(start_angle) * node_dist[!circ]: longer
object length is not a multiple of shorter object
lengthWarning in data2$x[!circ] + cos(start_angle) *
node_dist[!circ]: longer object length is not a
multiple of shorter object lengthWarning in data2$x[!circ] <- data2$x[!circ] +
cos(start_angle) * node_dist[!circ]: number of items
to replace is not a multiple of replacement lengthWarning in sin(start_angle) * node_dist[!circ]: longer
object length is not a multiple of shorter object
lengthWarning in data2$y[!circ] + sin(start_angle) *
node_dist[!circ]: longer object length is not a
multiple of shorter object lengthWarning in data2$y[!circ] <- data2$y[!circ] +
sin(start_angle) * node_dist[!circ]: number of items
to replace is not a multiple of replacement lengthWarning in cos(end_angle) * node_dist[!circ]: longer
object length is not a multiple of shorter object
lengthWarning in data3$x[!circ] + cos(end_angle) *
node_dist[!circ]: longer object length is not a
multiple of shorter object lengthWarning in data3$x[!circ] <- data3$x[!circ] +
cos(end_angle) * node_dist[!circ]: number of items to
replace is not a multiple of replacement lengthWarning in sin(end_angle) * node_dist[!circ]: longer
object length is not a multiple of shorter object
lengthWarning in data3$y[!circ] + sin(end_angle) *
node_dist[!circ]: longer object length is not a
multiple of shorter object lengthWarning in data3$y[!circ] <- data3$y[!circ] +
sin(end_angle) * node_dist[!circ]: number of items to
replace is not a multiple of replacement length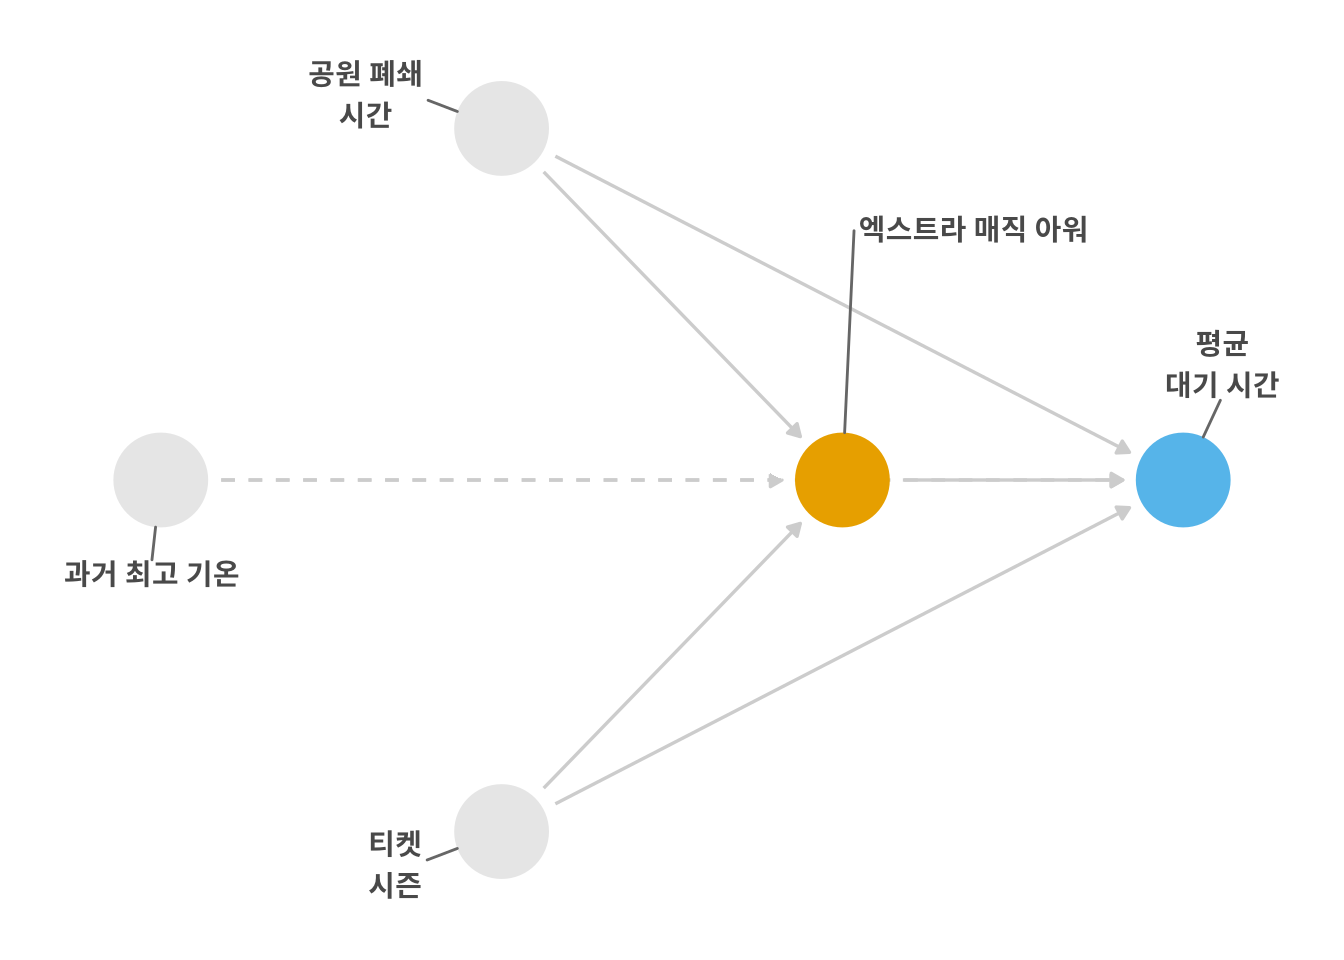
결과 유형(연속형, 이진형, 시간-사건형 등)과 미측정 교란 요인에 대해 알고 있는 정보에 따라 다양한 방법을 적용할 수 있습니다. 이러한 분석이 미측정 교란이 전혀 없음을 증명할 수는 없지만, 인과 추론의 핵심인 ‘미측정 교란 부재’ 가정이 위배되었을 때 결과가 얼마나 민감하게 반응하는지 귀중한 통찰을 제공합니다.
첫 번째 요소인 관찰된 노출-결과 효과는 민감도 분석을 수행하고자 하는 대상 인과 효과입니다. 효과 자체는 결과 모델의 선택에 따라 달라지며, 이는 다시 결과의 분포와 원하는 효과 척도에 따라 결정됩니다.
’공원 폐쇄 시간’과 ’티켓 시즌’만 조정한 표 tbl-alt-sets장의 분석 결과를 사용해 보겠습니다. 그림 fig-dag-magic-sens장에 따르면 ’과거 최고 기온’도 교란 요인이지만, 이것이 측정되지 않아 조정 집합에 포함할 수 없다고 가정하겠습니다. 이로 인해 관찰된 효과는 6.58가 되었습니다.
미측정 교란 요인과 노출 사이의 관계는 세 가지 방식으로 특징지을 수 있습니다.
이러한 분류를 통해 연구자는 교란 요인의 유형과 분포에 대한 지식 수준에 맞춰 민감도 분석 파라미터를 지정할 수 있습니다.
여기서 미측정 교란 요인인 ‘과거 최고 기온’은 연속형입니다. 이 예시를 위해 해당 변수가 정규 분포를 따른다고 가정하겠습니다. ’단위 분산(unit variance, 분산 1)’을 가정하는 이유는 교란 요인의 영향을 표준 편차 단위로 설명하는 것이 더 직관적이기 때문입니다. 엑스트라 매직 아워가 있었던 날의 과거 최고 기온이 평균 80.5도, 표준 편차 9도인 정규 분포를 따른다고 합시다. 마찬가지로 엑스트라 매직 아워가 없었던 날은 평균 82도, 표준 편차 9도인 정규 분포를 따른다고 가정합니다. 이 변수들을 표준 편차 9로 나누면 ’단위 분산’ 정규 분포 변수로 표준화할 수 있습니다. 이렇게 하면 엑스트라 매직 아워가 있었던 날의 표준화된 평균은 8.94, 그렇지 않은 날은 9.11이 되어 평균 차이는 -0.17이 됩니다. 이 수치를 기억해 두세요. 다음 섹션의 민감도 분석에 활용할 것입니다.
미측정 교란 요인과 결과 사이의 관계는 크게 두 가지 방식으로 정량화합니다.
계수 기반 접근법을 사용해 보겠습니다. 사례의 맥락에서 이 효과를 설명하자면 다음과 같습니다. “만약 우리가 엑스트라 매직 아워 여부, 공원 폐쇄 시간, 티켓 시즌을 조정한 후 과거 최고 기온을 1 표준 편차만큼 변화시킨다면, 평균 게시 대기 시간은 어떻게 변할 것인가?” 이 변화가 -2.3분이라고 가정해 봅시다. 즉, 과거 최고 기온이 1 표준 편차만큼 높다면(9도 더 따뜻하다면), 평균 게시 대기 시간은 2.3분 감소할 것으로 예상하는 것입니다.
수학적인 상세 설명은 (d2022sensitivity를?) 참조하세요.
위의 세 가지 수치를 추정했다면, 미측정 요인을 고려해 노출과 결과 사이의 업데이트된 효과 추정치를 계산할 수 있습니다. R의 tipr 패키지를 활용하면 편리합니다. 함수 이름은 {action}_{effect}_with_{what} 형식을 따릅니다.
예를 들어 이진형 미측정 교란 요인(what)으로 계수(effect)를 조정(action)하려면 adjust_coef_with_binary() 함수를 씁니다.
다음은 tipr 패키지의 함수 구조를 정리한 표입니다.
| 카테고리 | 함수 용어 | 용도 |
|---|---|---|
| action | adjust |
관찰된 효과를 조정합니다. 미측정 교란 요인-노출 관계와 미측정 교란 요인-결과 관계를 모두 지정해야 합니다. |
tip |
관찰된 효과를 임계점으로 전환합니다(tipping). 두 관계 중 하나만 지정하면 됩니다. | |
| effect | coef |
선형, 로그 선형, 로지스틱, 콕스 모델 등의 계수를 지정합니다. |
rr |
로그 선형이나 콕스 모델의 위험비(RR)를 지정합니다. | |
or |
로지스틱 회귀 모델의 오즈비(OR)를 지정합니다. | |
hr |
콕스 모델의 하위 위험비(HR)를 지정합니다. | |
| what | binary |
미측정 교란 요인이 이진형인 경우입니다. |
continuous |
미측정 교란 요인이 연속형인 경우입니다. | |
unspecified |
미측정 교란 요인의 분포가 특정되지 않은 경우입니다. |
우리는 연속형 미측정 교란 요인을 다루므로 adjust_coef_with_continuous() 함수를 사용합니다. 추정한 세 가지 수치는 다음과 같습니다.
이제 함수에 대입해 보겠습니다.
library(tipr)
adjust_coef_with_continuous(
  effect = effects[2],
  exposure_confounder_effect = -0.17,
  confounder_outcome_effect = -2.3
)
# A tibble: 1 × 4
effect_adjusted effect_observed
<dbl> <dbl>
1 6.19 6.58
# ℹ 2 more variables:
# exposure_confounder_effect <dbl>,
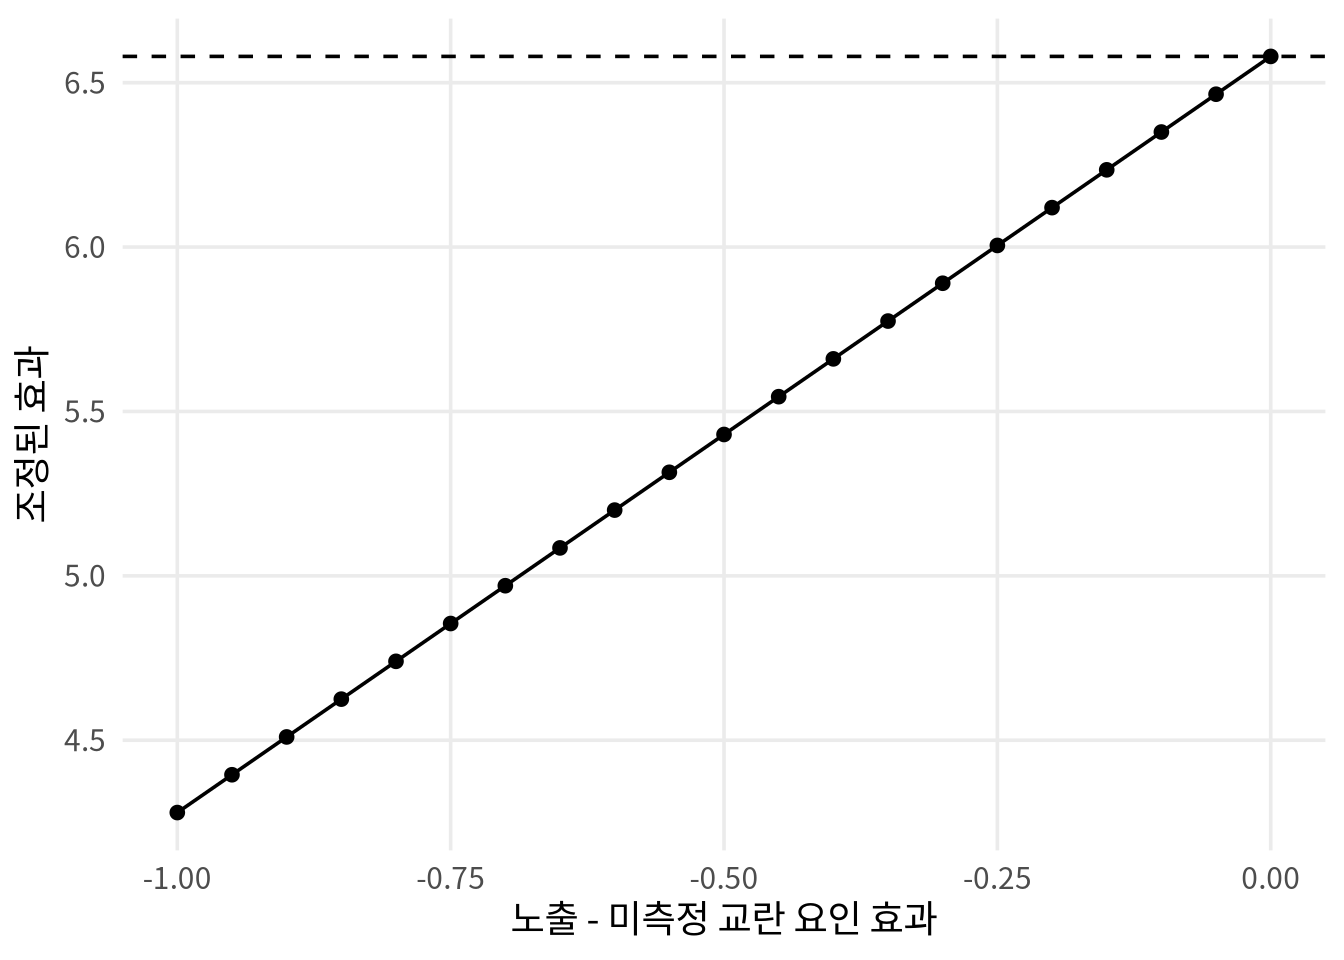
# confounder_outcome_effect <dbl>결과를 보면, 가정한 미측정 교란 요인이 존재할 때 효과가 6.58에서 6.19, 6.58, -0.17, -2.3로 바뀝니다. 이 사례에서 미측정 교란 요인과 노출 및 결과 사이의 관계에 대한 우리의 ’추측’은 결론을 크게 뒤흔들지 않습니다. 하지만 만약 그 관계들이 훨씬 더 강력했다면 어떨까요?
이런 분석 결과는 시각화하여 보여줄 수 있습니다. 그림 fig-sens-array장은 정규 분포를 따르는 미측정 교란 요인과 결과 사이의 관계가 -2.3분일 때, 노출-미측정 교란 요인 관계의 변화에 따라 조정된 효과가 어떻게 달라지는지 보여줍니다. 엑스트라 매직 아워가 있는 날과 없는 날 사이의 기온 차이가 커질수록(x축 값이 왼쪽으로 갈수록), 실제 인과 효과 추정치는 더 작아지는 것을 확인할 수 있습니다.
adjust_df <- adjust_coef_with_continuous(
  effect = 6.58,
  exposure_confounder_effect = seq(0, -1, by = -0.05),
  confounder_outcome_effect = -2.3
)

ggplot(
  adjust_df,
  aes(
    x = exposure_confounder_effect,
    y = effect_adjusted
  )
) +
  geom_hline(yintercept = 6.58, lty = 2) +
  geom_point() +
  geom_line() +
  labs(
    x = "노출 - 미측정 교란 요인 효과",
    y = "조정된 효과"
  )
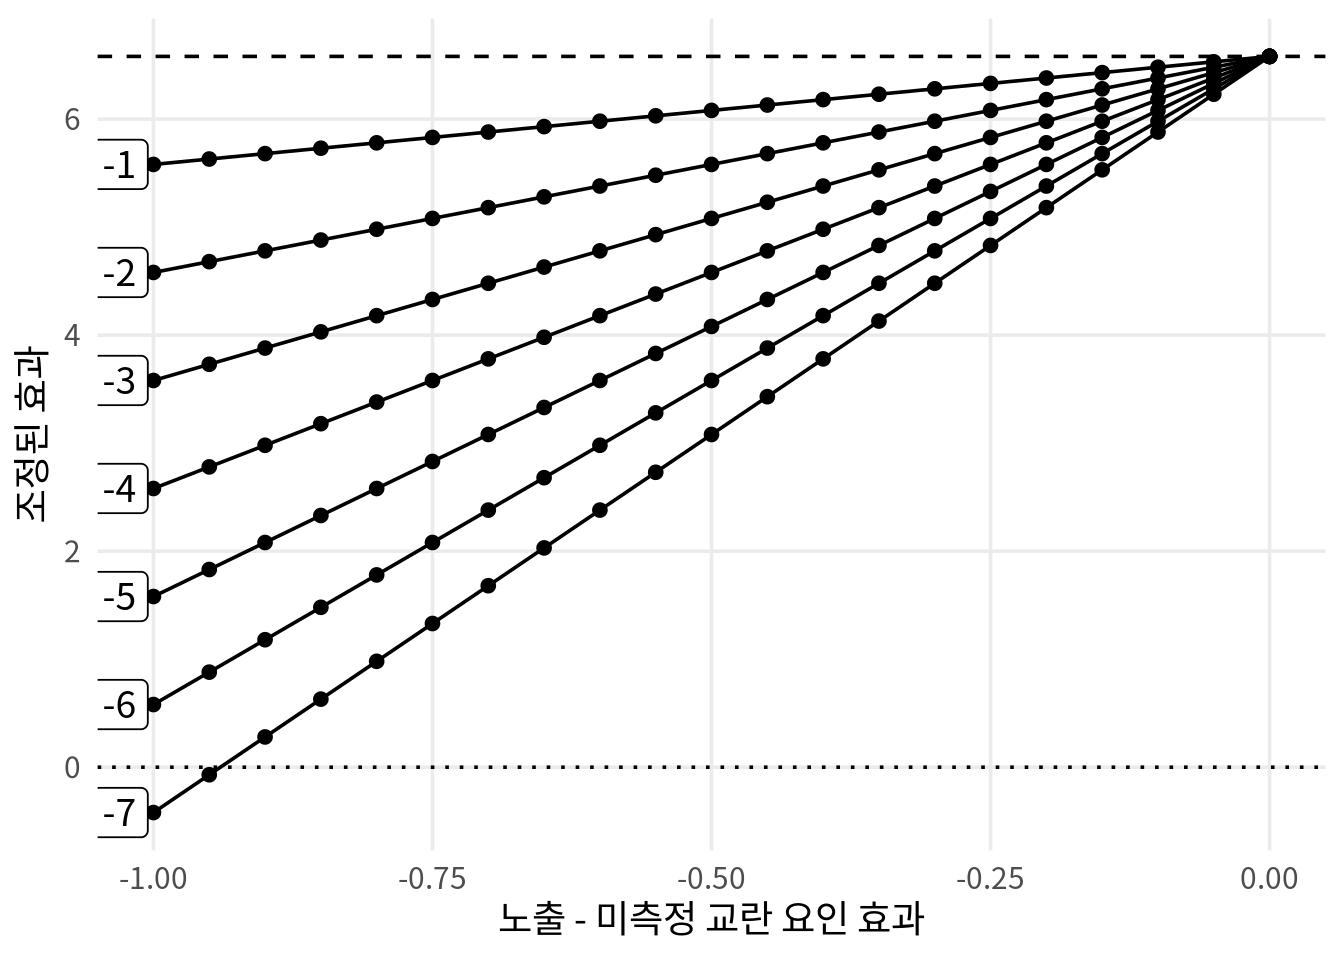
대부분의 경우 미측정 교란 요인이 노출과 결과에 미치는 정확한 영향력을 알기 어렵습니다. 이럴 때는 조사할 두 값의 범위를 결정하는 방식이 효과적입니다. 그림 fig-sens-array-2장이 그 예시입니다. 이 그래프를 보면, 과거 최고 기온의 1 표준 편차 변화가 평균 대기 시간을 최소 7분 정도 변화시키고, 엑스트라 매직 아워가 있는 날과 없는 날의 평균 과거 최고 기온 차이가 약 1 표준 편차일 때 조정된 효과가 0(null)을 지나게 됨을 알 수 있습니다. 이를 임계점(tipping point)이라고 합니다.
adjust_df <- map_df(
  seq(-1, -7, by = -1),
  ~ adjust_coef_with_continuous(
    effect = 6.58,
    exposure_confounder_effect = seq(0, -1, by = -0.05),
    confounder_outcome_effect = .x
  )
)

ggplot(
  adjust_df,
  aes(
    x = exposure_confounder_effect,
    y = effect_adjusted,
    group = factor(confounder_outcome_effect)
  )
) +
  geom_hline(yintercept = 6.58, lty = 2) +
  geom_hline(yintercept = 0, lty = 3) +
  geom_point() +
  geom_line() +
  geom_label(
    data = adjust_df |> filter(exposure_confounder_effect == -1),
    aes(label = confounder_outcome_effect),
    hjust = 1.1
  ) +
  labs(
    x = "노출 - 미측정 교란 요인 효과",
    y = "조정된 효과"
  )
임계점 민감도 분석의 목적은 관찰된 효과를 특정 값(주로 무효값)으로 바꿀 수 있는 미측정 교란 요인의 특성을 찾아내는 것입니다. 알려지지 않은 민감도 파라미터들의 범위를 일일이 탐색하는 대신, 관찰된 효과를 뒤집는(tip) 구체적인 값을 식별합니다. 이 방식은 점 추정치나 신뢰 구간 경계값에 모두 적용할 수 있으며, 뒤집기를 유발하는 미측정 교란 요인의 최소 효과를 계산합니다. 수식을 재배열해 조정된 결과를 무효로 설정하면, 다른 파라미터가 주어졌을 때 단일 민감도 파라미터를 구할 수 있습니다. tipr 패키지는 다양한 시나리오에 대해 이러한 계산을 수행하는 함수들을 제공합니다.
위의 예시를 토대로 tip_coef_with_continuous() 함수를 통해 어떤 값이 관찰된 계수를 뒤집을 수 있는지 확인해 보겠습니다. 노출-미측정 교란 요인 효과 또는 미측정 교란 요인-결과 효과 중 하나만 명시하면, 함수가 관찰된 효과를 무효로 뒤집는 데 필요한 나머지 하나를 계산합니다. 그림 fig-sens-array-2장에서 확인한 내용을 재현해 보겠습니다. 미측정 교란 요인-결과 효과를 -7분으로 설정하면, 관찰된 6.58분의 효과를 뒤집기 위해 노출군과 비노출군 사이에 -0.94의 차이가 필요하다는 결과가 나옵니다.
tip_coef_with_continuous(
  effect = 6.58,
  confounder_outcome_effect = -7
)
# A tibble: 1 × 4
effect_observed exposure_confounder_effect
<dbl> <dbl>
1 6.58 -0.94
# ℹ 2 more variables: confounder_outcome_effect <dbl>,
# n_unmeasured_confounders <dbl>반대로 미측정 교란 요인-결과 효과가 -2.3분이라는 점은 확신하지만, 과거 최고 기온과 엑스트라 매직 아워 배정 사이의 관계가 불확실하다고 가정해 보겠습니다. 관찰된 효과 6.58분을 0분으로 뒤집기 위해 필요한 차이를 확인해 보겠습니다.
tip_coef_with_continuous(
  effect = 6.58,
  confounder_outcome_effect = -2.3
)
# A tibble: 1 × 4
effect_observed exposure_confounder_effect
<dbl> <dbl>
1 6.58 -2.86
# ℹ 2 more variables: confounder_outcome_effect <dbl>,
# n_unmeasured_confounders <dbl>결과를 보면 노출과 교란 요인 사이에 -2.86의 효과가 필요합니다. 즉, 이 사례에서 효과를 무효로 바꾸려면 과거 최고 기온의 평균 차이가 약 25도(-2.86에 표준 편차 9를 곱함)나 되어야 합니다. 이는 현실적으로 일어나기 힘든 매우 큰 수치입니다. 따라서 과거 최고 기온 데이터를 빠뜨렸고 그 효과가 -2.3이라고 가정하더라도, 이 누락이 결론의 방향을 바꿀 정도로 결과를 왜곡하지는 않을 것이라고 자신할 수 있습니다.