경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
데이터 누락(missingness)이나 측정 오차(measurement error)는 실제 데이터셋에서 흔히 발생하는 문제입니다. 이는 묘사, 예측, 인과 추론 등 모든 분석 유형에 영향을 줍니다. 분석 목적이 다르듯, 누락과 측정 오차를 해결하기 위해 다중 대치법(multiple imputation) 같은 동일한 도구를 쓰더라도 그 영향은 분야마다 다르게 나타납니다. 운이 좋으면 단순히 정밀도가 낮아지거나 편향이 조금 심해지는 정도에 그치지만, 최악의 경우에는 해결 불가능한 선택 편향(selection bias)이 생겨 완전히 잘못된 결론에 도달할 수도 있습니다. 이번 장에서는 누락과 측정 오차가 인과 분석에서 어떤 편향을 일으키는지, 그리고 이를 어떻게 해결할 수 있는지(가능하다면!) 살펴보겠습니다.
인과 추론은 근본적으로 ’결측 데이터 문제(missing data problem)’라고 불리기도 합니다. 우리는 반사실적 상태(counterfactual states)를 비교하고 싶어 하지만, 현실에서 관측되는 것 외의 모든 상태는 ’누락’된 것이나 마찬가지이기 때문입니다. 인과 추론을 결측 문제로 바라보는 관점은 철학적으로 흥미로울 뿐 아니라 통계학의 두 방법론을 연결해 주기도 합니다. 여기서는 반대의 관점을 살펴보겠습니다. 즉, 누락과 측정 오차 자체를 하나의 인과 추론 문제로 다루는 것입니다.
지금까지 우리는 DAG에 포함된 변수들이 실제로 데이터에 있는 변수들이라는 큰 가정을 해왔습니다. 다시 말해, 데이터가 완벽하고 완전하게 측정되었다고 가정합니다. 이 가정은 사실이 아닐 때가 많습니다. 측정 오차와 누락이 미치는 영향을 이해하려 인과 다이어그램을 활용한 몇 가지 시나리오를 살펴보겠습니다.
x는 부분적으로 누락되었으나 y는 완전하다면, x의 평균을 구할 때보다 더 큰 표본으로 y의 평균을 측정할 수 있습니다. 그러나 회귀 계수 같은 결합 파라미터(joint parameters)는 x와 y가 모두 완전한 관측치일 때만 계산할 수 있습니다. R 도구(예: lm())는 대개 필요한 변수가 빠진 행을 자동으로 삭제합니다.
필요한 변수가 모두 갖춰진 관측치만 사용하는 방식을 완전 사례 분석(complete-case analysis)이라고 하며, 이 책에서는 지금까지 이 방식을 써왔습니다.
TouringPlans 데이터의 변수는 대부분 누락이 없고 정확하게 측정되었을 것입니다(예: 티켓 시즌이나 과거 날씨 등). 반면 놀이기구의 실제 대기 시간은 누락되거나 잘못 측정될 수 있습니다. 앞서 보았듯 이 데이터는 줄을 서서 기다리는 사람들에게 의존합니다. 자신의 경험을 보고하는 일반 사용자나 대기 시간을 측정하려 고용된 사람들 모두 포함됩니다. 따라서 누락 여부는 주로 대기 시간을 측정할 사람이 현장에 있는지에 좌우됩니다. 측정하는 사람이 있더라도 오차가 생길 수 있는데, 이 오차는 대개 측정 주체가 누구냐에 따라 달라집니다. 예를 들어 디즈니 월드 방문객이 짐작으로 제출한 대기 시간은, 보수를 받고 분 단위로 시간을 재는 사람이 측정한 값보다 오차가 클 가능성이 높습니다.
그 점을 염두에 두고, 측정 오차와 누락을 하나씩 살펴보겠습니다.
먼저 측정 오차를 살펴보겠습니다. 그림 fig-meas-err-dag에서 실제 대기 시간과 게시 대기 시간을 각각 실제 버전과 측정된 버전으로 표현했습니다. 측정된 버전은 실제 값뿐만 아니라 측정 오차를 유발하는 미지의 요인들에 의해서도 결정됩니다. 두 대기 시간이 어떻게 잘못 측정되는지는 서로 독립적입니다. 단순함을 위해 이 DAG에서 교란 요인들은 제거했습니다.
library(ggdag)

glyph <- function(data, params, size) {
  # data$shape <- 15
  data$size <- 5
  ggplot2::draw_key_point(data, params, size)
}

show_edge_color <- function(...) {
  list(
    theme(legend.position = "bottom"),
    ggokabeito::scale_edge_color_okabe_ito(name = NULL, breaks = ~ .x[!is.na(.x)]),
    guides(color = "none")
  )
}

edges_with_aes <- function(..., edge_color = "grey85", shadow = TRUE) {
  list(
    if (shadow) {
      geom_dag_edges_link(
        data = \(.x) filter(.x, is.na(path)),
        edge_color = edge_color
      )
    },
    geom_dag_edges_link(
      aes(edge_color = path),
      data = \(.x) mutate(.x, path = if_else(is.na(to), NA, path))
    )
  )
}

ggdag2 <- function(.dag, ..., order = 1:9, seed = 1633, box.padding = 3.4, edges = geom_dag_edges_link(edge_color = "grey85")) {
  ggplot(
    .dag,
    aes_dag(...)
  ) +
    edges +
    geom_dag_point(key_glyph = glyph) +
    geom_dag_text_repel(aes(label = label), size = 3.8, seed = seed, color = "#494949", box.padding = box.padding) +
    ggokabeito::scale_color_okabe_ito(order = order, na.value = "grey90", breaks = ~ .x[!is.na(.x)]) +
    theme_dag() +
    theme(legend.position = "none") +
    coord_cartesian(clip = "off")
}

add_measured <- function(.df) {
  if (!"label" %in% names(.df)) {
    .df <- mutate(.df, label = labels[name])
  }
  mutate(
    .df,
    measured = case_when(
      str_detect(label, "측정된|measured") ~ "측정됨",
      str_detect(label, "대기|wait") ~ "참값",
      .default = NA
    )
  )
}

add_missing <- function(.df) {
  if (!"label" %in% names(.df)) {
    .df <- mutate(.df, label = labels[name])
  }
  mutate(
    .df,
    missing = case_when(
      str_detect(label, "결측|missing") ~ "결측 지시 변수",
      str_detect(label, "대기|wait") ~ "대기 시간",
      .default = NA
    )
  )
}

labels <- c(
  "actual" = "실제\n대기",
  "actual_star" = "측정된\n실제",
  "posted" = "게시\n대기",
  "posted_star" = "측정된\n게시",
  "u_posted" = "알려지지 않음",
  "u_actual" = "알려지지 않음 "
)

dagify(
  actual ~ posted,
  posted_star ~ u_posted + posted,
  actual_star ~ u_actual + actual,
  coords = time_ordered_coords(),
  labels = labels,
  exposure = "posted_star",
  outcome = "actual_star"
) |>
  tidy_dagitty() |>
  add_measured() |>
  ggdag2(color = measured, order = 6:7) +
  theme(legend.position = "bottom") +
  labs(color = NULL) +
  theme(
    legend.key.spacing.x = unit(4, "points"),
    legend.key.size = unit(1, "points"),
    legend.text = element_text(size = rel(1.25), margin = margin(l = -10.5, b = 2.6)),
    legend.box.margin = margin(b = 20),
    strip.text = element_blank()
  )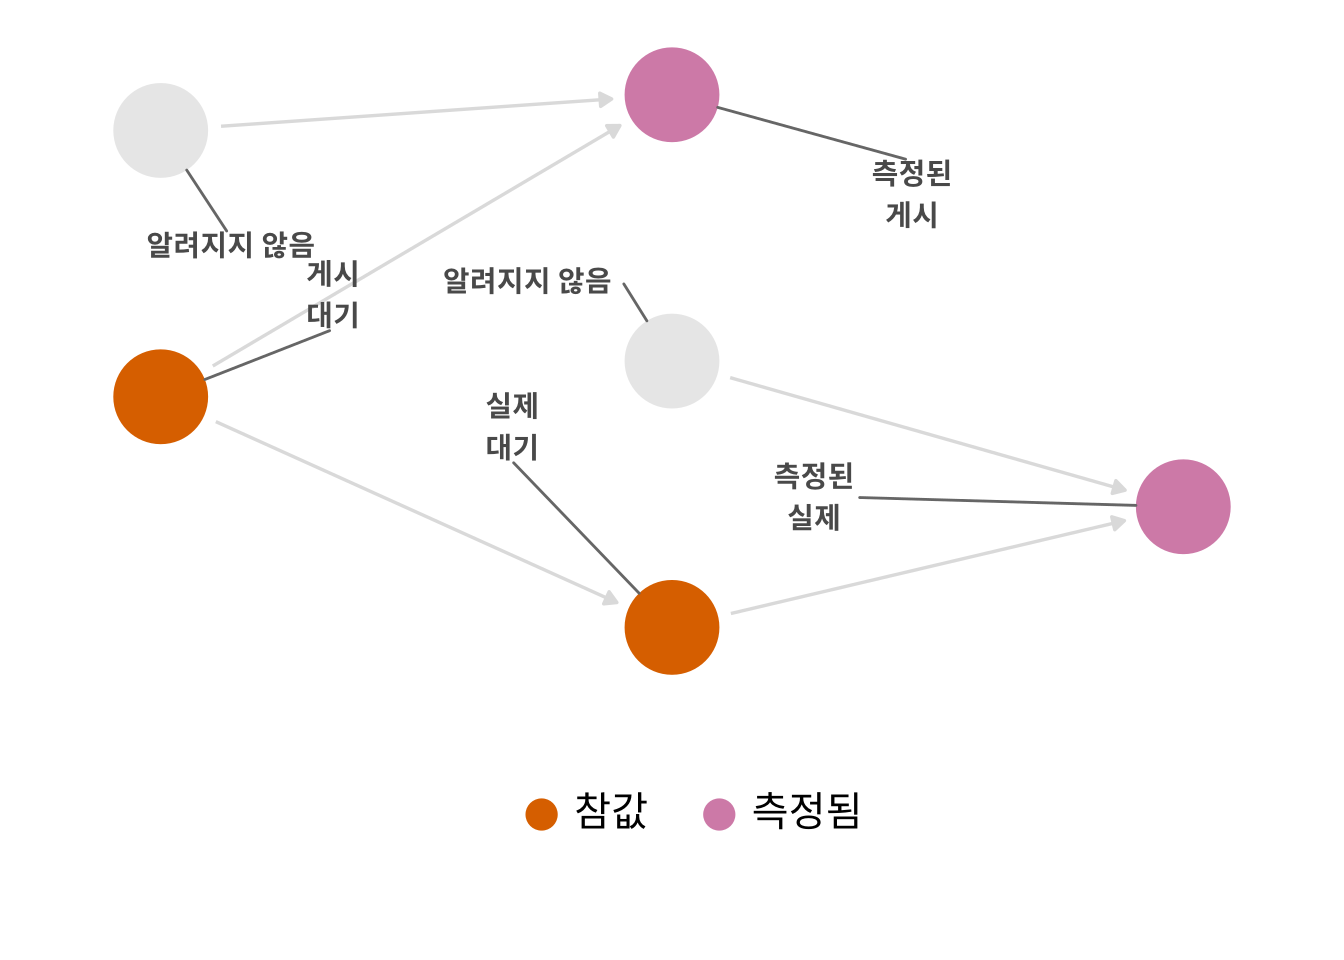
TouringPlans는 디즈니 웹사이트에서 대기 시간을 스크래핑(scraping)해 수집했습니다. 이 과정에서 오측정이 발생할 수도 있습니다. 디즈니가 실제 공원에 게시된 것과 다른 시간을 온라인에 올렸거나, TouringPlans의 데이터 수집 코드에 오류가 있었을 가능성입니다. 하지만 이런 오차는 매우 작다고 보는 것이 합리적입니다.
반면 실제 대기 시간은 측정 오차가 꽤 섞여 있을 것입니다. 사람이 직접 시간을 재야 하므로 자연스럽게 오차가 발생하기 마련입니다. 또한 측정값은 보수 지급 여부에 따라 달라지기도 합니다. 자발적으로 데이터를 입력하는 사용자는 대기 시간을 짐작해서 제출할 가능성이 크지만, 보수를 받는 사람은 더 정밀하게 측정할 것이기 때문입니다.
업데이트된 DAG는 그림 fig-meas-err-other-1과 같습니다. 이 DAG는 ‘실제 대기 시간’ 측정 오차의 구조적 원인을 설명하며, 이 구조는 ’게시 대기 시간’과 연결되어 있지 않습니다. ’게시 대기 시간’에서 ’실제 대기 시간’으로 가는 화살표가 없는 무효(null) DAG(그림 15.3)를 보면 이 점이 더 명확해집니다. 게시 시간은 실제 시간을 측정할 때 오차를 일으키는 메커니즘과 무관합니다. 즉, 이런 측정 오차로 발생하는 편향은 비교환 가능성(nonexchangeability) 문제라기보다 측정값의 수치적 오차 때문에 생깁니다. 인과 그래프의 경로가 열려서 생기는 문제가 아니라는 뜻입니다. 편향의 정도는 측정값이 실제 값과 얼마나 상관관계가 있는지에 좌우됩니다.
labels <- c(
  "actual" = "실제\n대기",
  "actual_star" = "측정된\n실제",
  "posted" = "게시\n대기",
  "posted_star" = "측정된\n게시",
  "employed" = "TP에\n고용됨",
  "u_actual" = "알려지지 않음"
)

dagify(
  actual ~ posted,
  posted_star ~ posted,
  actual_star ~ u_actual + actual + employed,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_measured() |>
  ggdag2(color = measured, order = 6:7, box.padding = 3.7, seed = 123)

dagitty::dagitty(
  'dag {
actual [pos="1.000,-2.000"]
actual_star [pos="2.000,-1.000"]
employed [pos="1.000,-1.000"]
posted [pos="1.000,2.000"]
posted_star [pos="2.000,1.000"]
u_actual [pos="1.000,1.000"]
actual -> actual_star
employed -> actual_star
posted -> posted_star
u_actual -> actual_star
}'
) |>
  dag_label(labels = labels) |>
  add_measured() |>
  ggdag2(color = measured, order = 6:7, box.padding = 2.5)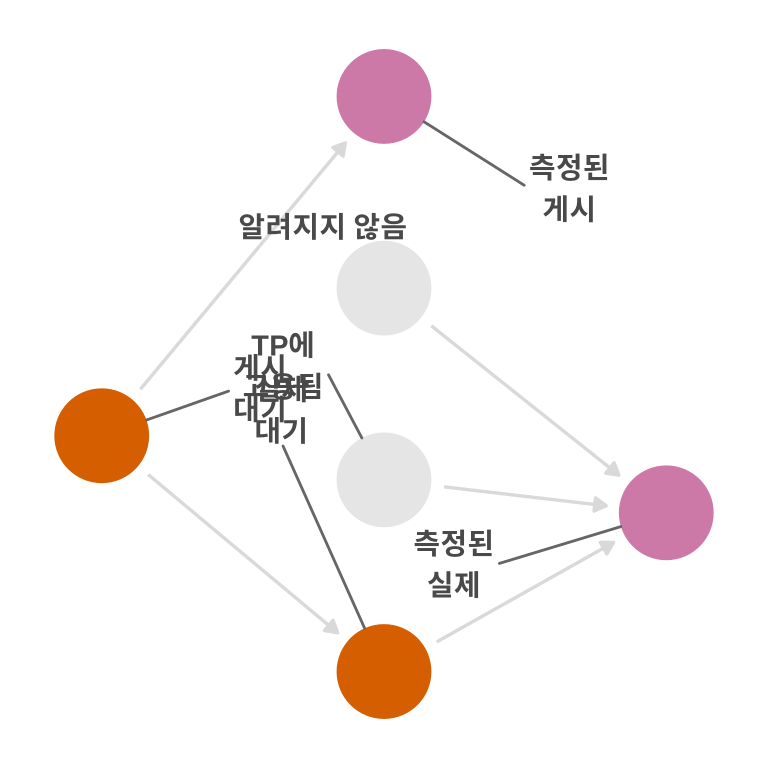
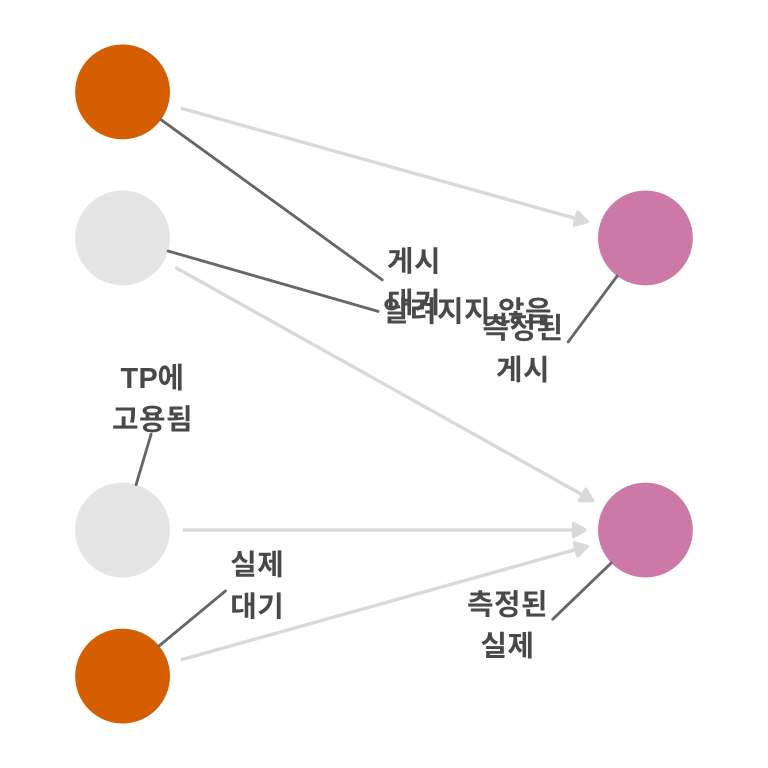
이런 유형의 측정 편향은 교란으로 인한 비교환 가능성 문제와는 다릅니다. 우리가 실제 원인(posted)과 결과(actual) 대신 그 대리인인 측정값(posted_measured, actual_measured) 사이의 효과를 분석하기 때문에 발생합니다. 분석 결과의 정확성은 actual_measured가 actual을 얼마나 잘 반영하느냐에 달려 있습니다. 측정된 변수를 연구 대상인 원인과 결과로 본다면, 실제 변수들의 관계를 파악하려 인과 구조를 이용하고 있음을 알 수 있습니다. 그림 fig-meas-err-other-1의 측정된 변수들은 서로 영향을 주지 않습니다. 하지만 두 변수의 관계를 계산하면 실제 변수들에 의해 교란됩니다. 흥미롭게도 우리는 실제 변수들 사이의 관계를 추정하려 바로 이 교란을 이용하는 셈입니다. 이 방법이 유효한 정도는 실제 변수를 제외한 교환 가능성과, ‘알려지지 않은 요인’ 같은 독립적인 측정 오차의 양에 좌우됩니다.
이를 독립적, 비차별적(independent, non-differential) 측정 오차라고도 합니다. 편향이 구조적 비교환 가능성이 아니라 실제값과 관찰값의 차이에서 비롯되기 때문입니다.
상관관계가 0에 가까워질수록 측정값은 연구 중인 관계에서 무작위성을 갖게 됩니다. 변수가 독립적인 측정 오차를 포함하면, 실제값 사이에 화살표가 있더라도 측정값 사이의 관계는 무효(null)에 가까워집니다. 여기서 x의 계수는 약 1이어야 하지만, 무작위 측정이 부정확할수록 계수는 0에 수렴합니다. 오측정으로 생긴 무작위성(u)과 y 사이에는 아무런 관계가 없기 때문입니다.
[1] -0.02135lm(y ~ x_measured)
Call:
lm(formula = y ~ x_measured)

Coefficients:
(Intercept)   x_measured
     0.0276       0.0187
하지만 모든 무작위 오측정이 효과를 무효화하는 것은 아닙니다. 예를 들어 세 개 이상의 범주가 있는 범주형 변수라면, 오측정은 값의 빈도 분포를 변화시킵니다(이를 범주형 변수의 오분류, misclassification라고도 합니다). 무작위 오분류에서도 일부 관계는 무효 쪽으로, 일부는 무효에서 멀어지는 쪽으로 편향됩니다. 단순히 한 범주에서 빈도가 빠지면 다른 범주로 들어가기 때문입니다. 예를 들어 레이블 “c”와 “d”를 무작위로 섞으면 두 값이 평균화되면서 c의 계수는 과대평가되고 d의 계수는 과소평가되는 반면, 나머지 두 계수는 정확하게 유지됩니다.
x <- sample(letters[1:5], size = n, replace = TRUE)
y <- case_when(
  x == "a" ~ 1 + rnorm(n),
  x == "b" ~ 2 + rnorm(n),
  x == "c" ~ 3 + rnorm(n),
  x == "d" ~ 4 + rnorm(n),
  x == "e" ~ 5 + rnorm(n),
)

x_measured <- if_else(
  x %in% c("c", "d"),
  sample(c("c", "d"), size = n, replace = TRUE),
  x
)

lm(y ~ x_measured)
Call:
lm(formula = y ~ x_measured)

Coefficients:
(Intercept)  x_measuredb  x_measuredc  x_measuredd
      1.028        0.986        2.490        2.530
x_measurede
      3.872
일부 연구자들은 무작위 측정 오차가 예측 가능하게 무효 쪽으로 향할 것이라고 기대하지만, 이것이 항상 사실은 아닙니다. 이 가정이 어긋나는 사례는 (Yland2022를?) 참조하십시오.
하지만 그림 fig-meas-err-dag-dep-1처럼 알려지지 않은 단일 요인이 게시 대기 시간과 실제 대기 시간 측정 모두에 영향을 준다고 가정해 봅시다. 앞서 언급한 문제에 더해, 측정 변수의 교란으로 비교환 가능성 문제도 생깁니다(그림 15.5). 이를 ’종속적, 비차별적(dependent, non-differential) 측정 오차’라 합니다.
labels <- c(
  "actual" = "실제 대기",
  "actual_star" = "측정된\n실제",
  "posted" = "게시 대기",
  "posted_star" = "측정된\n게시",
  "employed" = "TP에 고용됨",
  "u_actual" = "알려지지 않음"
)

depend_dag <- dagify(
  posted_star ~ posted + u_actual,
  actual_star ~ u_actual + actual + employed,
  coords = time_ordered_coords(),
  labels = labels,
  exposure = "posted_star",
  outcome = "actual_star"
)

depend_dag |>
  tidy_dagitty() |>
  add_measured() |>
  ggdag2(color = measured, order = 6:7, box.padding = 3.7, seed = 123)

depend_dag |>
  dagitty::backDoorGraph() |>
  tidy_dagitty() |>
  add_measured() |>
  ggdag2(color = measured, order = 6:7, box.padding = 3.7, seed = 123)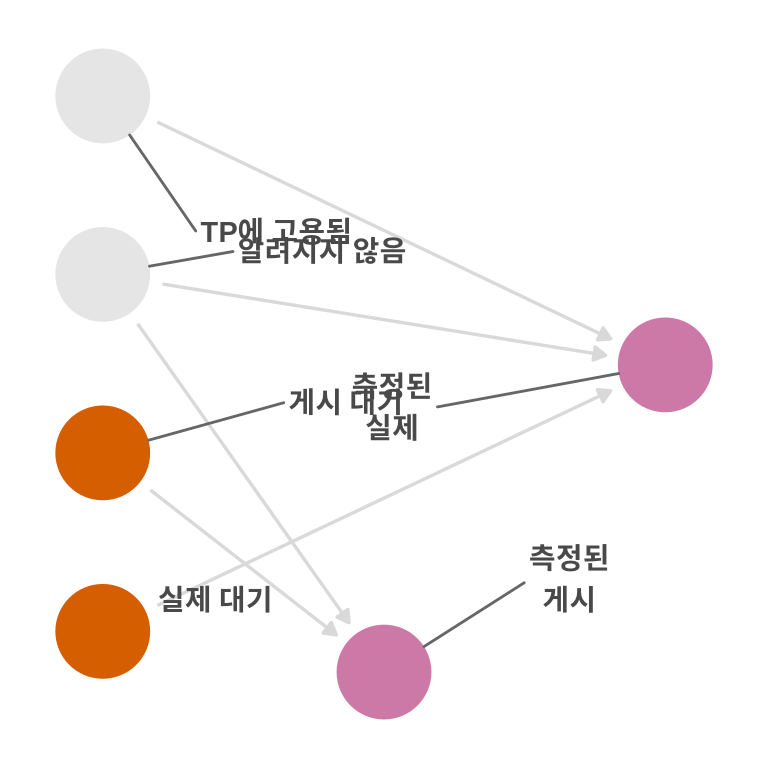
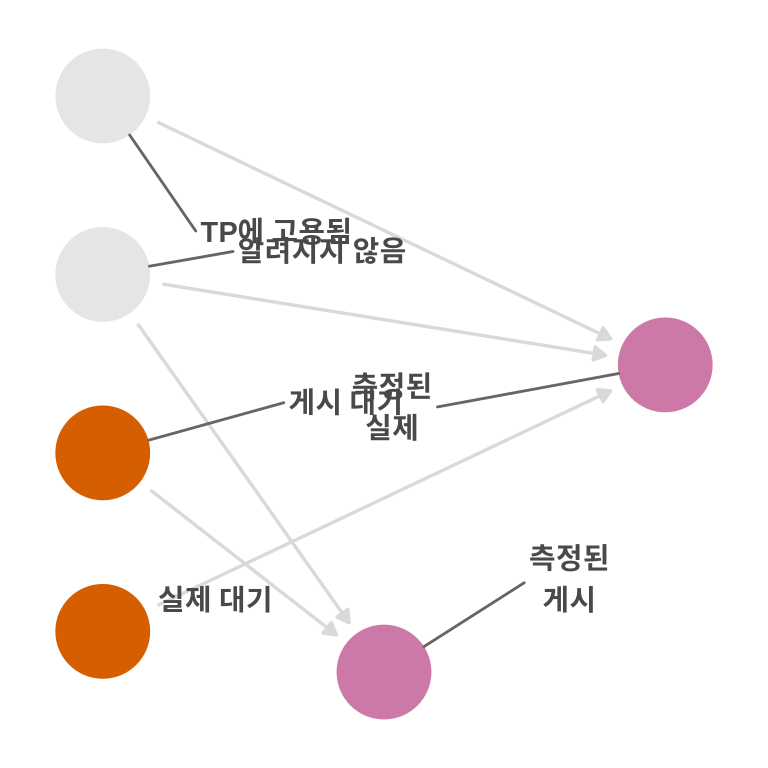
만약 이 요인이 연구 대상 중 일부에만 영향을 준다면 어떨까요? 예를 들어 그림 fig-meas-err-diff처럼 게시 대기 시간이 실제 대기 시간을 측정하는 방식에 영향을 준다고 가정해 봅시다. 이때의 오차는 차별적(differential)입니다. 이러한 오측정은 sec-dags에서 살펴본 선택 편향과 인과 구조가 같습니다. 바로 콜라이더입니다. 결과와 노출 모두 측정 오차를 일으키기에, 측정된 결과값에 조건부화하면 둘 사이에 가짜(spurious) 경로가 열립니다.
dagify(
  actual ~ posted,
  posted_star ~ posted,
  actual_star ~ posted + actual,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_measured() |>
  ggdag2(color = measured, order = 6:7, box.padding = 3.7, seed = 123)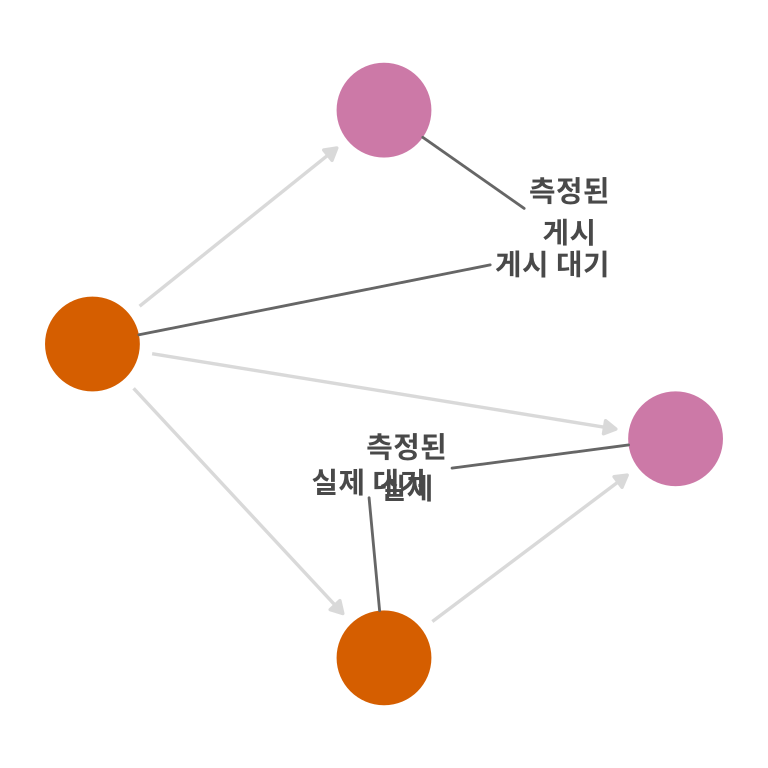
측정 오차에 대처하려면 무엇을 해야 할까요? 아쉽게도 해결책은 대개 더 나은 데이터를 얻는 것뿐입니다. 우리는 sec-sensitivity에서 오측정이 결과에 미치는 영향을 이해하는 데 필요한 민감도 분석 기법을 몇 가지 살펴보겠습니다.
교란 요인을 잘못 측정하는 것도 문제를 일으킵니다. 첫째, 교란 요인을 잘못 측정하면 백도어 경로를 완전히 닫지 못할 수 있습니다. 이는 잔차 교란(residual confounding)으로 이어져 효과 추정치가 여전히 어느 정도 편향될 수 있습니다.
둘째, 측정 오차가 결과에 따라 차별적일 때, 오측정된 교란 요인이 마치 효과 수정자(effect modifier)처럼 보일 수 있습니다. 노출과 교란 요인 사이에 실제로는 상호작용이 없는데도 있는 것처럼 나타날 수 있습니다. 표 tbl-confounder-me는 이러한 현상을 시뮬레이션한 결과입니다.
set.seed(123)
n <- 1000
confounder <- rnorm(n)
exposure <- confounder + rnorm(n)
outcome <- exposure + confounder + rnorm(n)

true_model <- lm(outcome ~ exposure * confounder)

# 교란 요인 오측정
confounder_star <- if_else(
  outcome > 0,
  confounder,
  confounder + 10 * rnorm(n)
)

mismeasured_model <- lm(outcome ~ exposure * confounder_star)

pull_interaction <- function(mdl) {
  mdl |>
    tidy() |>
    filter(term == "exposure:confounder" | term == "exposure:confounder_star") |>
    mutate(
      term = "exposure:confounder"
    ) |>
    select(term, estimate, `p-value` = p.value)
}

map(
  list("실제" = true_model, "오측정" = mismeasured_model),
  pull_interaction
) |>
  list_rbind(names_to = "모델") |>
gt::gt()| 모델 | term | estimate | p-value |
|---|---|---|---|
| 실제 | exposure:confounder | 0.01854 | 0.2726 |
| 오측정 | exposure:confounder | 0.00428 | 0.3728 |
결측에도 인과 구조가 있습니다. 그림 fig-missing-dag에서 우리는 actual 대신 actual_observed를 사용합니다. actual_observed에는 두 가지 원인이 있습니다. 실제 값과 actual이 관찰되었는지 여부를 나타내는 지시 변수(actual_missing)입니다. 만약 actual_missing이 1이면 actual_observed는 실제 값을 갖고, 그렇지 않으면 결측됩니다. 이 DAG는 분석 데이터에서 대기 시간 변수가 생성된 과정을 설명합니다.
labels <- c(
  "actual" = "실제 대기",
  "actual_observed" = "관찰된\n실제",
  "actual_missing" = "결측 지시 변수",
  "u_actual" = "알려지지 않음"
)

dagify(
  actual_observed ~ actual + actual_missing,
  actual_missing ~ u_actual,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_missing() |>
  ggdag2(color = missing, order = 6:7, box.padding = 3.7, seed = 123)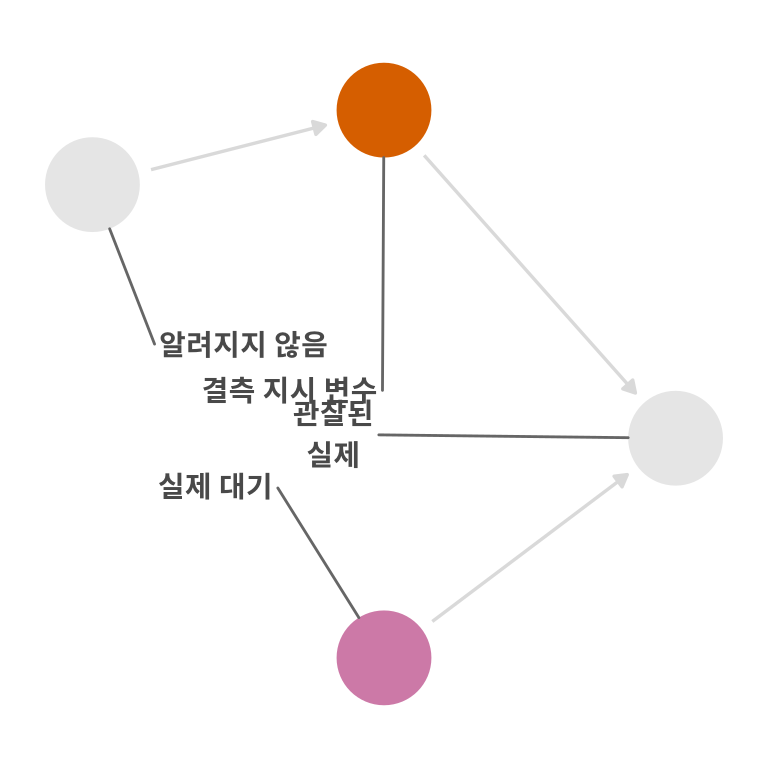
통계학에서는 보통 결측 메커니즘을 세 가지로 분류합니다. 완전 무작위 결측(MCAR), 무작위 결측(MAR), 비무작위 결측(MNAR)입니다. 이러한 통계적 분류를 DAG로 구조화하여 이해할 수 있습니다(Mohan2021?).
먼저 MCAR를 살펴봅시다. MCAR에서 데이터가 결측되는 이유는 데이터셋의 다른 변수와 관련이 없기 때문입니다. 그림 fig-missing-mcar의 DAG에서 보듯, 결측 지시 변수는 노출(posted)이나 결과(actual)와 연결되지 않았습니다. 이때는 결측 데이터를 무시하고 완전 사례 분석(complete-case analysis)을 수행해도 편향되지 않은 결과를 얻습니다. 다만 정보를 버리기 때문에 정밀도는 낮아집니다.
labels <- c(
  "actual" = "실제 대기",
  "actual_observed" = "관찰된\n실제",
  "actual_missing" = "결측 지시 변수",
  "posted" = "게시 대기"
)

dagify(
  actual ~ posted,
  actual_observed ~ actual + actual_missing,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_missing() |>
  ggdag2(color = missing, order = 6:7, box.padding = 3.7, seed = 123)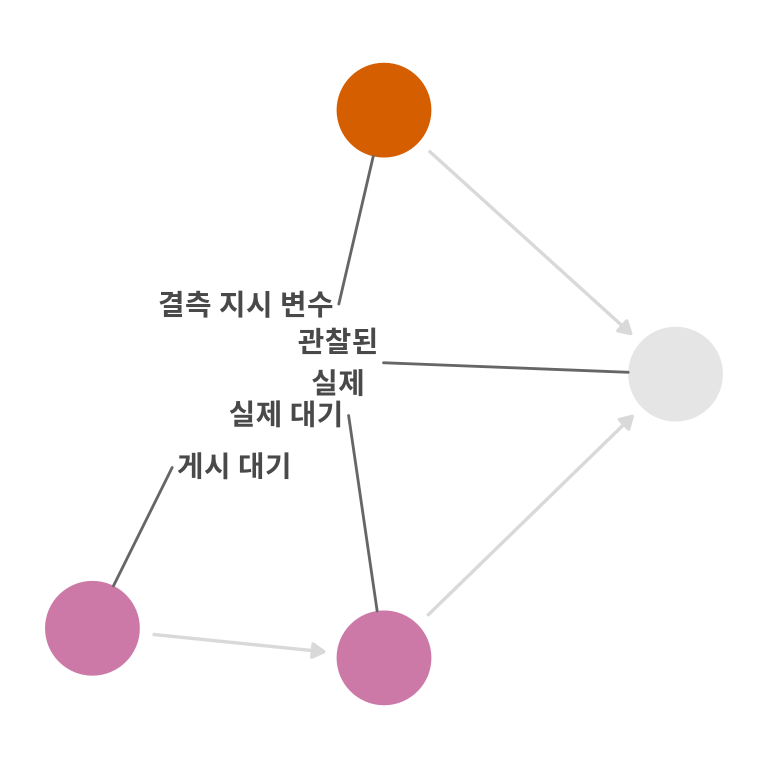
다음은 MAR입니다. MAR에서 데이터가 결측되는 이유는 관찰된 다른 변수로 설명할 수 있습니다. 그림 fig-missing-mar에서 결측 지시 변수는 노출(posted)의 영향을 받습니다. 예를 들어 게시 대기 시간이 매우 길면 사람들이 줄을 서지 않기로 해, 실제 대기 시간을 측정할 수 없어 데이터가 결측될 수 있습니다. posted를 올바르게 조정하면 MAR 상황에서도 편향되지 않은 추정치를 얻습니다.
dagify(
  actual ~ posted,
  actual_observed ~ actual + actual_missing,
  actual_missing ~ posted,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_missing() |>
  ggdag2(color = missing, order = 6:7, box.padding = 3.7, seed = 123)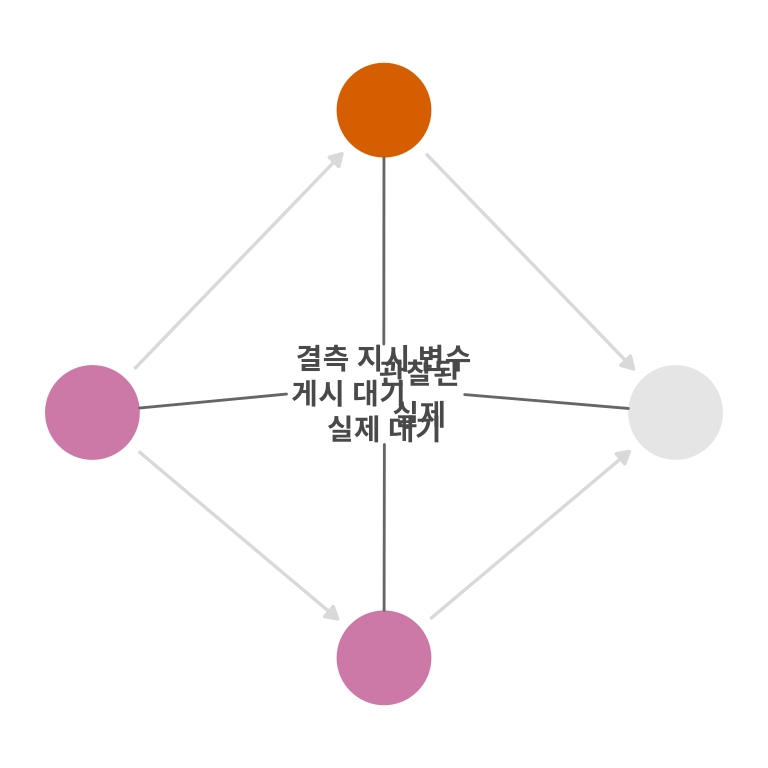
posted)의 영향을 받습니다.
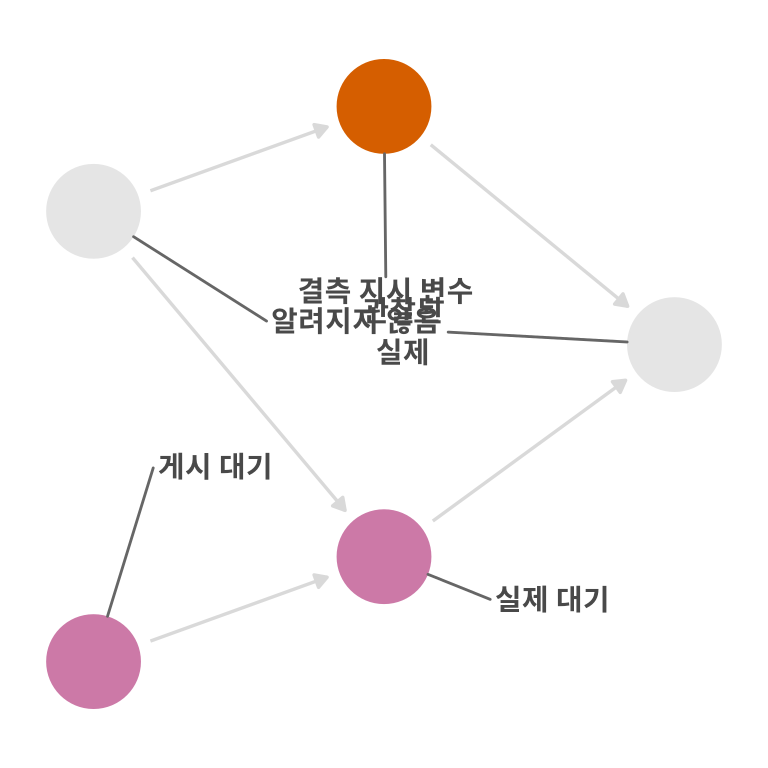
마지막으로 MNAR입니다. MNAR에서 데이터가 결측되는 이유는 변수 자체의 값이나 미지의 요인과 관련이 있기 때문입니다. 그림 fig-missing-mnar-1에서는 실제 값(actual) 자체가 결측 여부를 결정합니다. 예를 들어, 실제 대기 시간이 너무 길면 사람들이 도중에 포기하고 나갈 수 있어 데이터가 기록되지 않을 수 있습니다. 그림 fig-missing-mnar-2에서는 미지의 요인(unknown)이 실제 값과 결측 여부 모두에 영향을 미칩니다. 이 두 경우 모두 단순히 관찰된 변수를 조정해서는 편향을 해결할 수 없습니다.
labels <- c(
  "actual" = "실제 대기",
  "actual_observed" = "관찰된\n실제",
  "actual_missing" = "결측 지시 변수",
  "posted" = "게시 대기",
  "u_actual" = "알려지지 않음"
)

dagify(
  actual ~ posted,
  actual_observed ~ actual + actual_missing,
  actual_missing ~ actual,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_missing() |>
  ggdag2(color = missing, order = 6:7, box.padding = 3.7, seed = 123)

dagify(
  actual ~ posted + u_actual,
  actual_observed ~ actual + actual_missing,
  actual_missing ~ u_actual,
  coords = time_ordered_coords(),
  labels = labels
) |>
  tidy_dagitty() |>
  add_missing() |>
  ggdag2(color = missing, order = 6:7, box.padding = 3.7, seed = 123)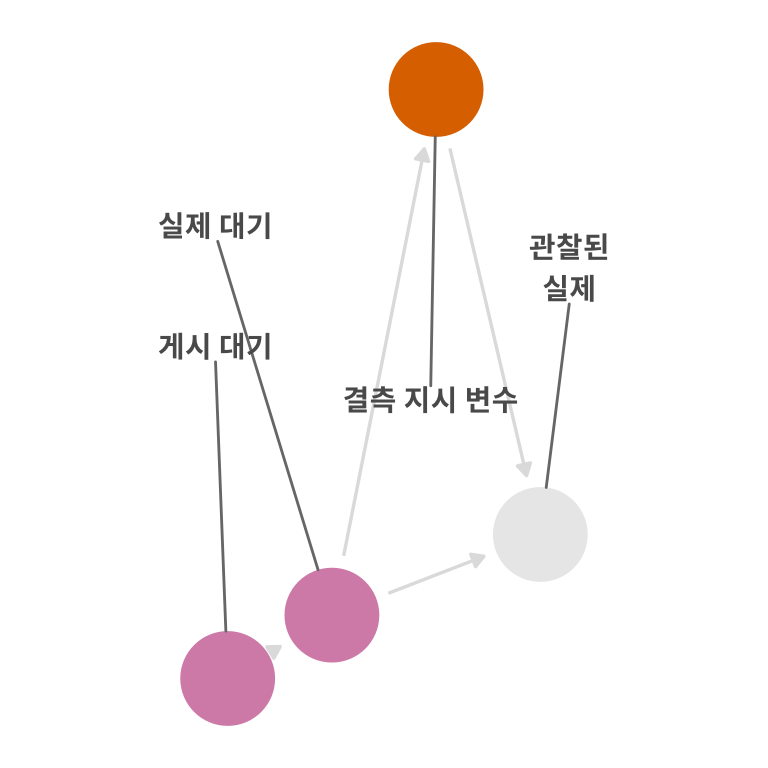
어떤 효과를 복구(recoverable)할 수 있는지 판단하는 일은 단순히 백도어 경로를 찾는 것보다 복잡합니다. 그림 fig-missing-dags-sim의 DAG들을 살펴봅시다. 여기서 a는 actual, p는 posted, u는 unknown, m은 결측 여부입니다.
library(patchwork)

define_dag <- function(..., tag, title) {
  dagify(
    ...,
    coords = time_ordered_coords(),
    exposure = "p",
    outcome = "a"
  ) |>
    ggdag(size = .7) +
    labs(title = paste0(tag, ": ", title)) +
    theme_dag() +
    theme(plot.title = element_text(size = 12)) +
    expand_plot(expand_x = expansion(c(.2, .2)))
}

dag_1 <- define_dag(
  a ~ p,
  m ~ u,
  tag = "1",
  title = "`actual` 결측 (MCAR)"
)

dag_2 <- define_dag(
  a ~ p,
  m ~ u + p,
  tag = "2",
  title = "`actual` 결측 (MAR)"
)

dag_3 <- define_dag(
  a ~ p,
  m ~ u + a,
  tag = "3",
  title = "`actual` 결측 (MNAR)"
)

dag_4 <- define_dag(
  a ~ p,
  m ~ u + p,
  tag = "4",
  title = "`posted` 결측"
)

dag_5 <- define_dag(
  a ~ p,
  m ~ u + a,
  tag = "5",
  title = "`posted` 결측"
)

(dag_1 + dag_2 + dag_3) / (plot_spacer() + dag_4 + dag_5)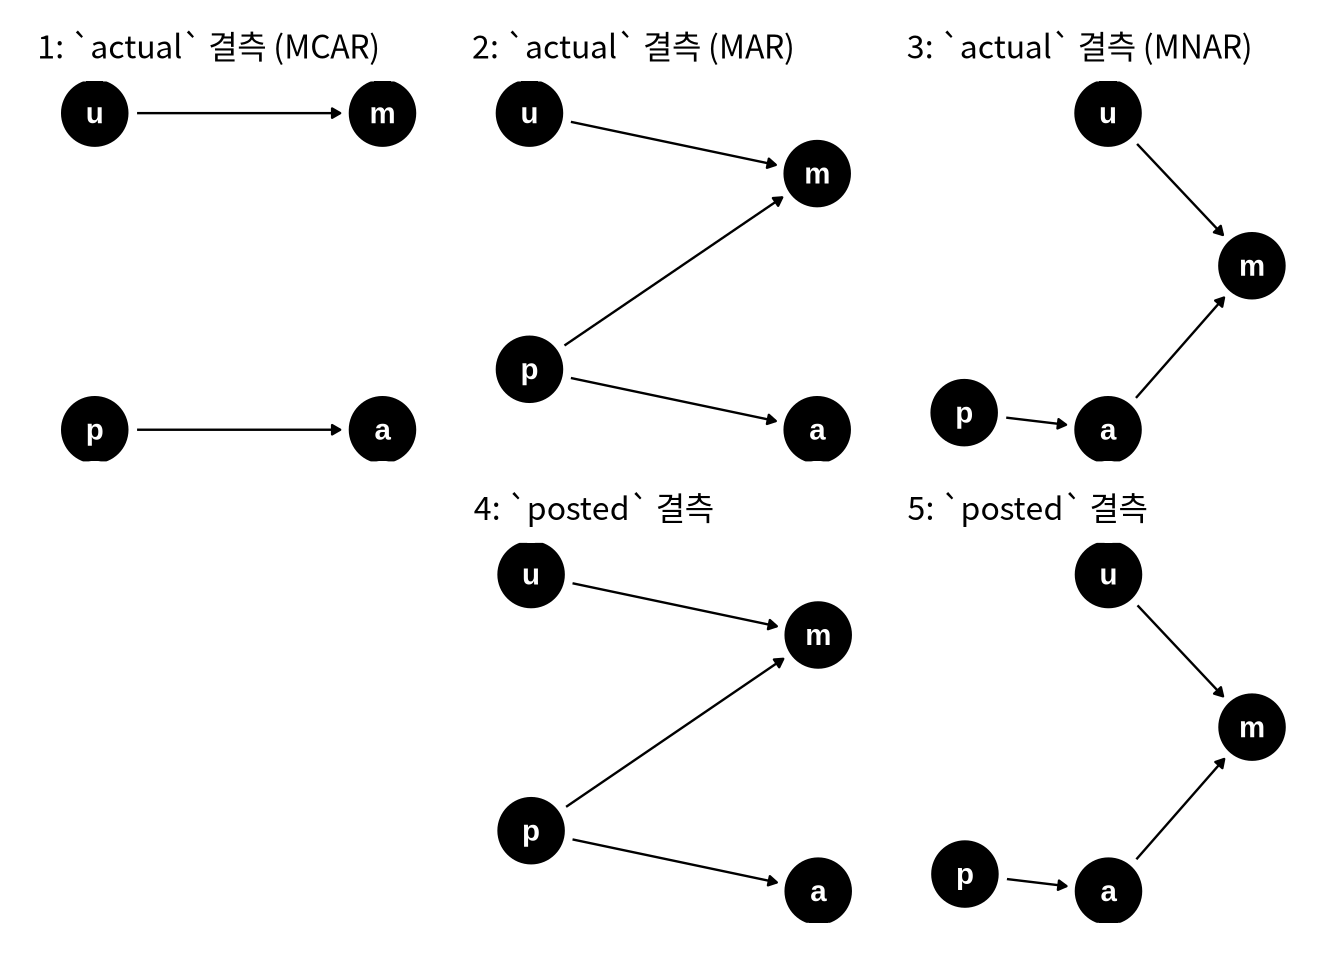
a)에 결측이 있고, DAG 4~5는 게시 대기 시간(p)의 일부가 누락되었습니다. 결측의 인과 구조는 정확한 추정 가능 여부에 영향을 줍니다.
그림 fig-recoverables는 이 DAG들로 시뮬레이션한 데이터의 posted와 actual 평균, 그리고 posted가 actual에 미치는 인과 효과 추정치를 보여줍니다. 결측이 전혀 없다면 세 가지 모두 추정할 수 있습니다. DAG 1도 세 가지 모두 추정할 수 있지만, 결측 때문에 표본 크기가 줄어 정밀도는 낮아집니다. DAG 2는 posted 평균과 인과 효과는 계산할 수 있지만, actual 평균은 계산할 수 없습니다. DAG 3은 인과 효과도 계산할 수 없습니다. DAG 4는 actual 평균과 인과 효과를 계산할 수 있지만 posted 평균은 계산할 수 없고, DAG 5는 actual 평균만 계산할 수 있습니다.
set.seed(123)
posted <- rnorm(365, mean = 30, sd = 5)
# 게시 시간이 한 시간 늘어날 때 실제 시간이 50분 늘어나는 효과 생성
coef <- 50 / 60
actual <- coef * posted + rnorm(365, mean = 0, sd = 2)

posted_60 <- posted / 60
missing_dag_1 <- rbinom(365, 1, .3) |>
  as.logical()
missing_dag_2 <- if_else(posted_60 > .50, rbinom(365, 1, .95), 0) |>
  as.logical()
missing_dag_3 <- if_else(actual > 22, rbinom(365, 1, .99), 0) |>
  as.logical()
# 동일한 구조이지만, 결측이 발생하는 것은 `posted` 변수입니다
missing_dag_4 <- missing_dag_2
missing_dag_5 <- missing_dag_3

fit_stats <- function(dag, actual, posted_60, missing_by = NULL, missing_for = "actual") {
  if (!is.null(missing_by) & missing_for == "actual") {
    actual[missing_by] <- NA
  }

  if (!is.null(missing_by) & missing_for == "posted") {
    posted_60[missing_by] <- NA
  }

  t_actual <- t.test(actual)
  t_posted <- t.test(posted_60 * 60)
  mdl <- lm(actual ~ posted_60)
  mdl_confints <- confint(mdl)

  tibble(
    dag = dag,
    mean_actual_estimate = as.numeric(t_actual$estimate),
    mean_actual_lower = t_actual$conf.int[[1]],
    mean_actual_upper = t_actual$conf.int[[2]],
    mean_posted_estimate = as.numeric(t_posted$estimate),
    mean_posted_lower = t_posted$conf.int[[1]],
    mean_posted_upper = t_posted$conf.int[[2]],
    coef_60_estimate = coefficients(mdl)[["posted_60"]],
    coef_60_lower = mdl_confints[2, 1],
    coef_60_upper = mdl_confints[2, 2]
  ) |>
    pivot_longer(
      cols = -dag,
      names_to = c("stat", ".value"),
      names_pattern = "^(.*)_(estimate|lower|upper)$"
    )
}

dag_stats <- bind_rows(
  fit_stats("결측 없음", actual, posted_60),
  fit_stats("DAG 1", actual, posted_60, missing_by = missing_dag_1),
  fit_stats("DAG 2", actual, posted_60, missing_by = missing_dag_2),
  fit_stats("DAG 3", actual, posted_60, missing_by = missing_dag_3),
  fit_stats("DAG 4", actual, posted_60, missing_by = missing_dag_4, missing_for = "posted"),
  fit_stats("DAG 5", actual, posted_60, missing_by = missing_dag_5, missing_for = "posted"),
)

dag_stats |>
  mutate(
    true_value = if_else(dag == "결측 없음", "참값", "관찰값"),
    dag = factor(dag, levels = c(paste("DAG", 5:1), "결측 없음")),
    stat = factor(
      stat,
      levels = c("mean_posted", "mean_actual", "coef_60"),
      labels = c("게시 대기 평균", "실제 대기 평균", "인과 효과")
    )
  ) |>
  ggplot(aes(color = true_value)) +
  geom_point(aes(estimate, dag)) +
  geom_segment(aes(x = lower, xend = upper, y = dag, yend = dag, group = stat)) +
  facet_wrap(~stat, scales = "free_x") +
  labs(y = NULL, color = NULL)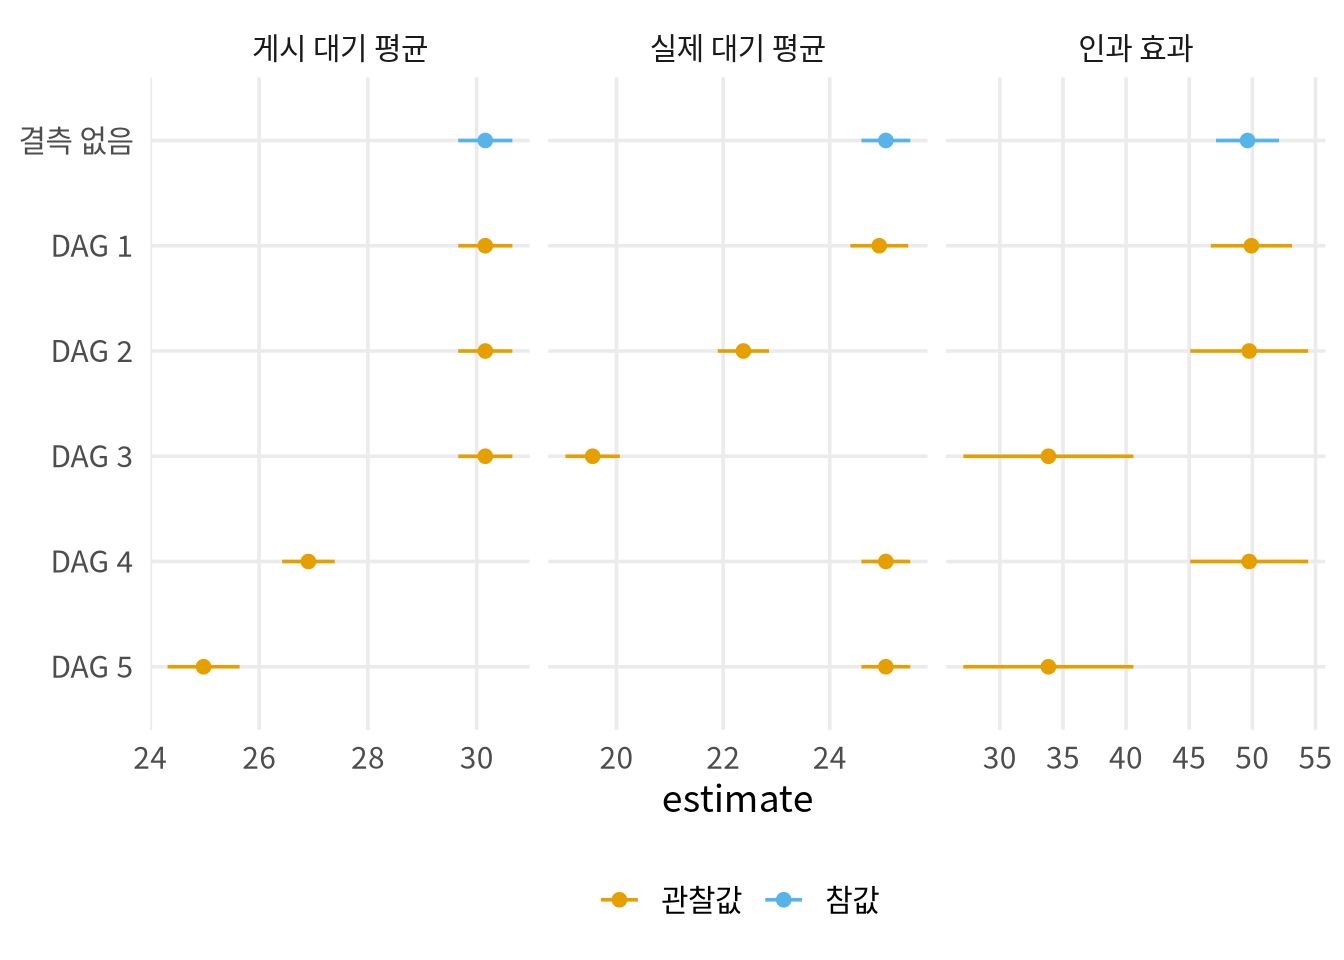
어떤 효과를 복구할 수 있는지 정리한 포괄적인 개요는 (Moreno-Betancur2018을?) 참고하세요.
측정 오차와 마찬가지로 인과 모델의 교란 요인이 실제 대기 시간의 결측 원인이 될 수 있습니다. 예를 들어 시즌이나 기온에 따라 TouringPlans가 측정 인원을 보낼지 결정할 수도 있습니다. 이 데이터의 교란 요인은 모두 관찰되지만, 교란 요인이 결측되면 잔차 교란과 완전 사례(complete case) 층화에 따른 선택 편향이 모두 발생할 수 있습니다.
통계학계의 유구한 작명 전통에 따라, 결측은 흔히 완전 무작위 결측, 무작위 결측, 그리고 비무작위 결측이라는 용어로 논의됩니다.
인과 모델에서는 결측의 인과 구조와 해당 구조와 관련된 변수 및 값의 가용성으로 이를 설명할 수 있습니다.
x가 클수록 결측될 확률이 높은 경우). 정의상 값이 누락되었으므로 그 정보는 알 수 없습니다.이 용어들이 해결책을 명확히 제시해주지는 않으므로, 결측 생성 과정을 명시적으로 설명하는 방식을 권장합니다.
실제 값을 놓친다는 점에서 측정 오차를 결측의 일종으로 볼 수 있을까요? 아니면 일부 값을 NA로 아주 잘못 측정해서 발생하는 측정 오차의 일종이 결측일까요? 우리는 두 문제를 서로 다른 구조로 제시했습니다. 측정 오차는 대리 변수(proxy variables)의 인과 효과를 계산하는 문제로, 결측은 결측을 조건부로 한 실제 변수의 인과 효과를 계산하는 문제로 표현됩니다. 이 두 구조는 각 상황에서 발생하는 편향을 더 명확히 설명합니다. 물론 다른 관점에서 접근하는 것도 도움이 됩니다. 예를 들어 측정 오차를 결측 문제로 간주하면 다중 대치법(multiple imputation) 같은 기술로 해결할 수 있습니다. 현실에서는 일부 데이터는 누락되고 일부는 잘못 측정되므로, 종종 두 방식을 병행합니다.
이제 DAG에서 나타나는 수치적 문제와 구조적 비교환 가능성을 교정하기 위해, 측정 오차와 결측을 해결하는 분석 기법을 살펴보겠습니다. sec-sensitivity장에서는 결측과 측정 오차의 민감도 분석도 다룰 예정입니다.
일부 관측치에는 정확히 측정된 변수가 있지만, 데이터셋 대부분에는 오차가 섞인 변수만 있을 때가 있습니다. 이를 흔히 검증 세트(validation set)라고 부릅니다. 이때 회귀 교정(regression calibration)이라는 간단한 접근 방식을 사용하면, 데이터셋의 나머지 관측치에 대해서도 정확한 값을 예측할 수 있습니다. 정확히 측정된 일부 데이터를 바탕으로 전체 변수를 다시 교정(recalibrating)한다는 뜻에서 붙여진 이름입니다. 본질적으로는 관측수가 많은 변수와 측정 과정에 필수적인 다른 변수들을 포함하는 예측 모델입니다.
알다시피 실제 대기 시간 데이터에는 결측치가 많습니다. 게시 대기 시간을 실제 대기 시간의 대리 변수로 쓰면 어떨까요? 이 경우 교정된 실제 대기 시간으로 엑스트라 매직 아워의 효과를 다시 분석할 수 있습니다.
먼저 wait_minutes_posted_avg로 wait_minutes_actual_avg를 예측하는 모델을 만듭니다. 그 다음 wait_minutes_posted_avg 대신 이 모델로 얻은 교정값을 분석에 사용합니다.
회귀 교정 모델을 만들 때는 이후 분석 모델에 포함될 모든 변수를 동일한 형태(예: 최종 모델에서 스플라인을 사용한다면 교정 모델에서도 동일한 스플라인 사용)로 포함해야 합니다.
library(splines)
library(touringplans)
library(broom)

calib_model <- lm(
  wait_minutes_actual_avg ~
    wait_minutes_posted_avg * wait_hour +
    park_extra_magic_morning +
    park_temperature_high + park_close + park_ticket_season,
  data = seven_dwarfs_train_2018)

seven_dwarves_calib <- calib_model |>
  augment(newdata = seven_dwarfs_train_2018) |>
    rename(wait_minutes_posted_calib = .fitted)
이 모델을 IPW 추정량으로 적합시키면 효과는 4.91분이 되는데, 이는 Chapter 11에서 보정되지 않은 wait_minutes_posted_avg를 사용했을 때 확인한 값에 비해 약간 감쇄된 것입니다.
값을 대치(impute)하는 방법도 있습니다. wait_minutes_actual_avg를 사용할 수 있는 곳에서는 이를 사용하고, 그렇지 않은 곳에서는 예측값을 사용합니다. 실무에서는 앞서 살펴본 교정 모델을 쓰되, 모든 관측치를 교정하기보다 검증 세트의 결측치만 대치하는 방식을 주로 사용합니다. 이 방법은 회귀 대치(regression imputation) 또는 결정론적 대치(deterministic imputation)로도 불립니다. 결측치에 변동성을 추가하지 않고 단일 예측값을 고정해서 부여하므로 결정론적이라고 합니다(이어서 변동성을 약간 도입하는 확률적 대치 방법을 살펴보겠습니다).
seven_dwarves_reg_impute <- calib_model |>
  augment(newdata = seven_dwarfs_train_2018) |>
  rename(wait_minutes_actual_impute = .fitted) |>
  # 실제 값이 존재하는 경우 이를 채워 넣습니다
  mutate(
    wait_minutes_actual_impute = coalesce(
      wait_minutes_actual_avg,
      wait_minutes_actual_impute
    )
  )
이 모델을 IPW 추정량으로 적합시키면 효과는 6.49분이 됩니다.
회귀 교정 모델을 쓰면 교정된 변수의 추정치에 불확실성이 생깁니다. 따라서 회귀 교정이나 대치를 수행할 때 정확한 표준 오차를 구하려면 부트스트랩 과정에 모델 적합 단계를 반드시 포함해야 합니다.
회귀 교정은 단일 모델로 값을 예측해 분석에 활용함으로써 측정 오차와 결측 문제를 직관적으로 해결합니다. 하지만 이런 방식은 대개 비효율적입니다. 불확실성을 정확히 추정하면(예: 교정 모델과 결과 모델 모두 부트스트래핑), 단일 대치 값에 의존한 한계가 반영되어 신뢰 구간이 매우 넓어지곤 합니다.
이럴 때 다중 대치법(MI)이 효율적인 대안이 될 수 있습니다. 결측값 하나를 “최선의 추정치”로 정하는 대신, MI는 분포에서 예측값을 추출해 결측 데이터의 불확실성을 포착합니다. 이를 통해 요약 통계량(대치 변수의 평균 등)과 후속 조건부 효과(결과 모델에 대치 변수가 포함될 때의 처치 효과 등)를 더 정확하게 추정할 수 있습니다. 이 과정에서 대치된 데이터셋을 여러 개 생성합니다. 보통 5개를 기본으로 생성하지만, 결측치가 많다면 안정적인 결과를 얻기 위해 대치 횟수를 늘려야 합니다. 대개 결측 비율과 비슷하게 대치 횟수를 정하는 것이 좋습니다.
인과 분석에서 MI를 사용할 때 주의할 모델링 고려 사항은 다음과 같습니다.
일반적인 인과 분석 절차는 다음과 같습니다.
\(m\) 개의 대치된 데이터셋 각각에 대해 분석을 수행한 후:
다음을 정의합니다.
그러면 총 분산은 다음과 같습니다.
\[T = \bar{U} + \left(1 + \frac{1}{m}\right) B\]
통합 추정치의 표준 오차는 \(\sqrt{T}\) 이며, 이는 신뢰 구간을 구축하거나 가설 검정을 수행하는 데 사용될 수 있습니다.
이 방식은 대치 단계와 처치 효과 추정 단계에서 발생하는 불확실성을 모두 고려합니다. 처치 배정이나 결과 발생에 관여하는 변수에 결측치가 있을 때 특히 유용하며, 이때 완전 사례 분석이나 단일 대치를 쓰면 편향되거나 비효율적인 추정치가 나올 수 있습니다.
실무에서는 주로 MICE(Multivariate Imputation by Chained Equations) 알고리즘으로 다중 대치법을 구현합니다. 이 알고리즘은 각 결측 변수를 다른 변수에 조건부화한 모델로 반복해서 대치하는 방식입니다. R에서는 보통 mice 패키지를 사용합니다.
앞서 살펴본 예시를 활용해, 단일 회귀 대치 대신 확률적(다중) 대치를 10번 수행해 보겠습니다. 우선 데이터를 대치합니다.
library(mice)

seven_dwarfs_to_impute_data <- seven_dwarfs_train_2018 |>
  mutate(park_ticket_season = as.factor(park_ticket_season)) |>
  select(
    park_date,
    wait_minutes_actual_avg,
    wait_minutes_posted_avg,
    wait_hour,
    park_temperature_high,
    park_close,
    park_ticket_season,
    park_extra_magic_morning
  )

predictor_matrix <- make.predictorMatrix(seven_dwarfs_to_impute_data)

# 대치 모델에서 공원 날짜를 제외합니다
predictor_matrix[, 1] <- 0

# 데이터 대치
seven_dwarfs_mi <- mice(
  seven_dwarfs_to_impute_data,
  m = 10, # 10개의 대치 수행
  predictorMatrix = predictor_matrix,
  method = "pmm",  # 예측 평균 매칭 (predictive mean matching)
  seed = 1,
  print = FALSE
)
그런 다음 complete 함수를 사용하여 대치된 데이터셋들을 리스트로 수집할 수 있습니다.
seven_dwarfs_mi_data <- complete(seven_dwarfs_mi, action = "all")마지막으로 여러 데이터셋에 걸쳐 IPW 효과를 적합시키는 함수를 작성해 보겠습니다. 루빈의 법칙(Rubin’s Rules)을 적용하려면 처치 효과와 함께 표준 오차도 확인해야 합니다.
fit_ipw_effect <- function(.fmla, .data = seven_dwarfs, .trt = "park_extra_magic_morning", .outcome_fmla = wait_minutes_posted_calib ~ park_extra_magic_morning) {
  .trt_var <- rlang::ensym(.trt)

  # 성향 점수 모델 적합
  propensity_model <- glm(
    .fmla,
    data = .data,
    family = binomial()
  )

  # ATE 가중치 계산
  .df <- propensity_model |>
    augment(type.predict = "response", data = .data) |>
    mutate(w_ate = wt_ate(.fitted, !!.trt_var, exposure_type = "binary"))

  # 결과 모델 적합
  outcome_model <- lm(.outcome_fmla, data = .df, weights = w_ate)

  # IPW 효과 적합
  ipw_output <- ipw(propensity_model, outcome_model, .df)
  return(c(estimate = ipw_output$estimates$estimate,
           std.err = ipw_output$estimates$std.err))
}
effect_mi_all <- map(seven_dwarfs_mi_data, ~fit_ipw_effect(
park_extra_magic_morning ~ park_temperature_high +
park_close + park_ticket_season,
.outcome_fmla = wait_minutes_actual_avg ~ park_extra_magic_morning,
.data = .x |> filter(wait_hour == 9)
)) |>
bind_rows()이제 대치된 각 데이터셋에서 추정된 효과와 표준 오차를 담은 데이터 프레임이 생성되었습니다.
effect_mi_all# A tibble: 10 × 2
estimate std.err
<dbl> <dbl>
1 6.24 4.61
2 -1.43 3.63
3 11.5 5.27
4 10.6 5.19
5 -1.96 4.07
6 1.36 4.18
7 -2.30 3.60
8 7.20 6.06
9 7.92 4.92
10 2.98 3.86최종 효과를 구하기 위해 estimate 열의 평균을 내고, 루빈의 법칙에 따라 적절한 표준 오차를 산출하겠습니다(Tip 15.1 참고).
# A tibble: 1 × 2
  effect_mi se_mi
      <dbl> <dbl>
1      4.21  7.14
다시 말씀드리지만, 이 효과는 sec-outcome-model장에서 확인한 결과보다 약해졌습니다(다만 표준 오차가 커서 차이가 유의미하지 않을 수 있습니다).
결측치가 결과에 미치는 영향이나 완전 사례 분석 및 다중 대치의 효과는 매우 비직관적일 수 있습니다. 여기에 측정 오차와 여러 편향까지 더해지면 머릿속으로만 계산하기는 거의 불가능에 가깝습니다. 이 문제를 해결하는 한 가지 방법은 추론의 일부를 뇌 대신 컴퓨터에 맡기는 것입니다.
여러분의 연구 질문과 관련된 인과 메커니즘을 정리한 뒤, 시뮬레이션으로 다양한 전략을 검토해 보시길 권합니다.
DAG와 관련된 일반적인 제안처럼, 적절한 DAG를 확신할 수 없다면 사양(specification)에 따라 결과가 어떻게 달라지는지 확인해야 합니다.