노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
여러 면에서 인과 추론을 위한 데이터 준비와 탐색적 분석은 묘사(description)나 예측(prediction)을 위한 것과 동일합니다. 인과 추론에서 다른 점은 이 과정을 인과적 질문 및 목표 시험 모방(target trial emulation)과 어떻게 연결하느냐 하는 것입니다. 또한 이 기회를 빌려 우리 데이터가 인과적 가정을 얼마나 잘 충족하는지 더 잘 이해할 수 있습니다. 비록 sec-quartets에서 보았듯이, 데이터만으로는 우리가 옳은지 그른지 결코 알 수 없지만 말입니다.
이제 다음 몇 장에 걸쳐 살펴볼 데이터와 인과적 질문을 살펴보겠습니다.
이 책의 상당 부분에서 우리는 Touring Plans로부터 얻은 데이터를 사용할 것입니다. Touring Plans는 사람들이 디즈니(Disney)와 유니버설(Universal) 테마파크 여행을 계획하는 것을 돕는 회사입니다. 그들의 목표 중 하나는 데이터와 통계 모델링을 활용하여 테마파크의 어트랙션 대기 시간을 정확하게 예측하는 것입니다. touringplans R 패키지에는 디즈니 테마파크 어트랙션에 대한 정보가 포함된 여러 데이터셋이 들어 있습니다.
library(touringplans)
attractions_metadata
# A tibble: 14 × 8
dataset_name name short_name park land opened_on
<chr> <chr> <chr> <chr> <chr> <date>
1 alien_sauce… Alie… Alien Sau… Disn… Toy … 2018-06-30
2 dinosaur DINO… DINOSAUR Disn… Dino… 1998-04-22
3 expedition_… Expe… Expeditio… Disn… Asia 2006-04-07
4 flight_of_p… Avat… Flight of… Disn… Pand… 2017-05-27
5 kilimanjaro… Kili… Kilimanja… Disn… Afri… 1998-04-22
6 navi_river Na'v… Na'vi Riv… Disn… Pand… 2017-05-27
7 pirates_of_… Pira… Pirates o… Magi… Adve… 1973-12-17
8 rock_n_roll… Rock… Rock Coas… Disn… Suns… 1999-07-29
9 seven_dwarf… Seve… 7 Dwarfs … Magi… Fant… 2014-05-28
10 slinky_dog Slin… Slinky Dog Disn… Toy … 2018-06-30
11 soarin Soar… Soarin' Epcot Worl… 2005-05-05
12 spaceship_e… Spac… Spaceship… Epcot Worl… 1982-10-01
13 splash_moun… Spla… Splash Mo… Magi… Fron… 1992-07-17
14 toy_story_m… Toy … Toy Story… Disn… Toy … 2008-05-31
# ℹ 2 more variables: duration <dbl>,
# average_wait_per_hundred <dbl>또한, 이 패키지에는 매일 기록된 공원에 대한 가공되지 않은 메타데이터(raw metadata) 데이터셋이 포함되어 있습니다. 이 메타데이터에는 특정 날짜의 월트 디즈니 월드 티켓 시즌(성수기 — 크리스마스를 생각해보세요, 비수기 — 개학 직후를 생각해보세요, 또는 평수기), 그날 공원의 과거 기온, 그리고 그날 공원에 엑스트라 매직 아워(Extra Magic Hours, 월트 디즈니 월드 리조트에 숙박하는 고객에게 공원을 일찍 개방하는 시간)와 같은 특별 이벤트가 있었는지 여부와 같은 정보가 포함되어 있습니다.
parks_metadata_raw# A tibble: 2,079 × 181
date wdw_ticket_season dayofweek dayofyear
<date> <chr> <dbl> <dbl>
1 2015-01-01 <NA> 5 0
2 2015-01-02 <NA> 6 1
3 2015-01-03 <NA> 7 2
4 2015-01-04 <NA> 1 3
5 2015-01-05 <NA> 2 4
6 2015-01-06 <NA> 3 5
7 2015-01-07 <NA> 4 6
8 2015-01-08 <NA> 5 7
9 2015-01-09 <NA> 6 8
10 2015-01-10 <NA> 7 9
# ℹ 2,069 more rows
# ℹ 177 more variables: weekofyear <dbl>,
# monthofyear <dbl>, year <dbl>, season <chr>,
# holidaypx <dbl>, holidaym <dbl>, holidayn <chr>,
# holiday <dbl>, wdwticketseason <chr>,
# wdwracen <chr>, wdweventn <chr>, wdwevent <dbl>,
# wdwrace <dbl>, wdwseason <chr>, …매년 며칠은 아침에 엑스트라 매직 아워가 있는 날로 선정됩니다.
parks_metadata_raw |>
  # 0: 엑스트라 매직 아워 없음, 1: 엑스트라 매직 아워 있음
  count(year, mkemhmorn)
# A tibble: 13 × 3
year mkemhmorn n
<dbl> <dbl> <int>
1 2015 0 290
2 2015 1 75
3 2016 0 300
4 2016 1 66
5 2017 0 293
6 2017 1 72
7 2018 0 304
8 2018 1 61
9 2019 0 250
10 2019 1 115
11 2020 0 135
12 2020 1 14
13 2021 0 1042019년까지 매년 총합은 해당 연도의 전체 일수와 일치합니다(2016년은 윤년이었습니다). 물론 2020년과 2021년에는 코로나19 팬데믹으로 인해 공원 운영이 제한되었으므로 이용 가능한 일수가 적습니다.
parks_metadata_raw |>
  # 엑스트라 매직 아워
  count(year, mkemhmorn) |>
  group_by(year) |>
  summarize(days = sum(n))
# A tibble: 7 × 2
year days
<dbl> <int>
1 2015 365
2 2016 366
3 2017 365
4 2018 365
5 2019 365
6 2020 149
7 2021 104또한 개별 어트랙션의 대기 시간에 대한 데이터도 있습니다. 예를 들어, ’세븐 드워프 마인 트레인(Seven Dwarfs Mine Train)’이라는 어트랙션의 데이터는 다음과 같습니다.
seven_dwarfs_train# A tibble: 321,631 × 4
park_date wait_datetime wait_minutes_actual
<date> <dttm> <dbl>
1 2015-01-01 2015-01-01 07:51:12 NA
2 2015-01-01 2015-01-01 08:02:13 NA
3 2015-01-01 2015-01-01 08:05:30 54
4 2015-01-01 2015-01-01 08:09:12 NA
5 2015-01-01 2015-01-01 08:16:12 NA
6 2015-01-01 2015-01-01 08:22:16 55
7 2015-01-01 2015-01-01 08:23:12 NA
8 2015-01-01 2015-01-01 08:29:12 NA
9 2015-01-01 2015-01-01 08:37:13 NA
10 2015-01-01 2015-01-01 08:44:11 NA
# ℹ 321,621 more rows
# ℹ 1 more variable: wait_minutes_posted <dbl>각 park_date에 대해 게시된 대기 시간(wait_minutes_posted, 디즈니 웹사이트에 게시된 시간을 수집한 것)과 실제 대기 시간(wait_minutes_actual, 실제로 줄을 서서 기다린 사람들이 보고한 것)에 대한 여러 보고가 있습니다. 각 행은 특정 wait_datetime에서의 게시된 대기 시간 또는 실제 대기 시간의 기록이며, 해당 행에서 다른 값은 NA로 표시됩니다.
seven_dwarfs_train |>
  count(park_date, sort = TRUE)
# A tibble: 2,334 × 2
park_date n
<date> <int>
1 2021-11-08 363
2 2021-10-01 359
3 2021-11-09 344
4 2021-10-29 333
5 2021-10-15 332
6 2021-10-10 330
7 2021-10-05 329
8 2021-10-17 327
9 2021-10-20 327
10 2021-10-08 323
# ℹ 2,324 more rows이 데이터셋들을 사용하여 답하고자 하는 인과적 질문은 다음과 같습니다:
2018년 매직 킹덤에서 아침에 “엑스트라 매직 아워”가 있었는지 여부와 같은 날 오전 9시에서 10시 사이의 “세븐 드워프 마인 트레인”의 평균 게시 대기 시간 사이에 관계가 있는가?
먼저 이 인과적 질문을 다이어그램으로 그려봅시다 (그림 7.1).
knitr::include_graphics(here::here("images/emm-diagram.png"))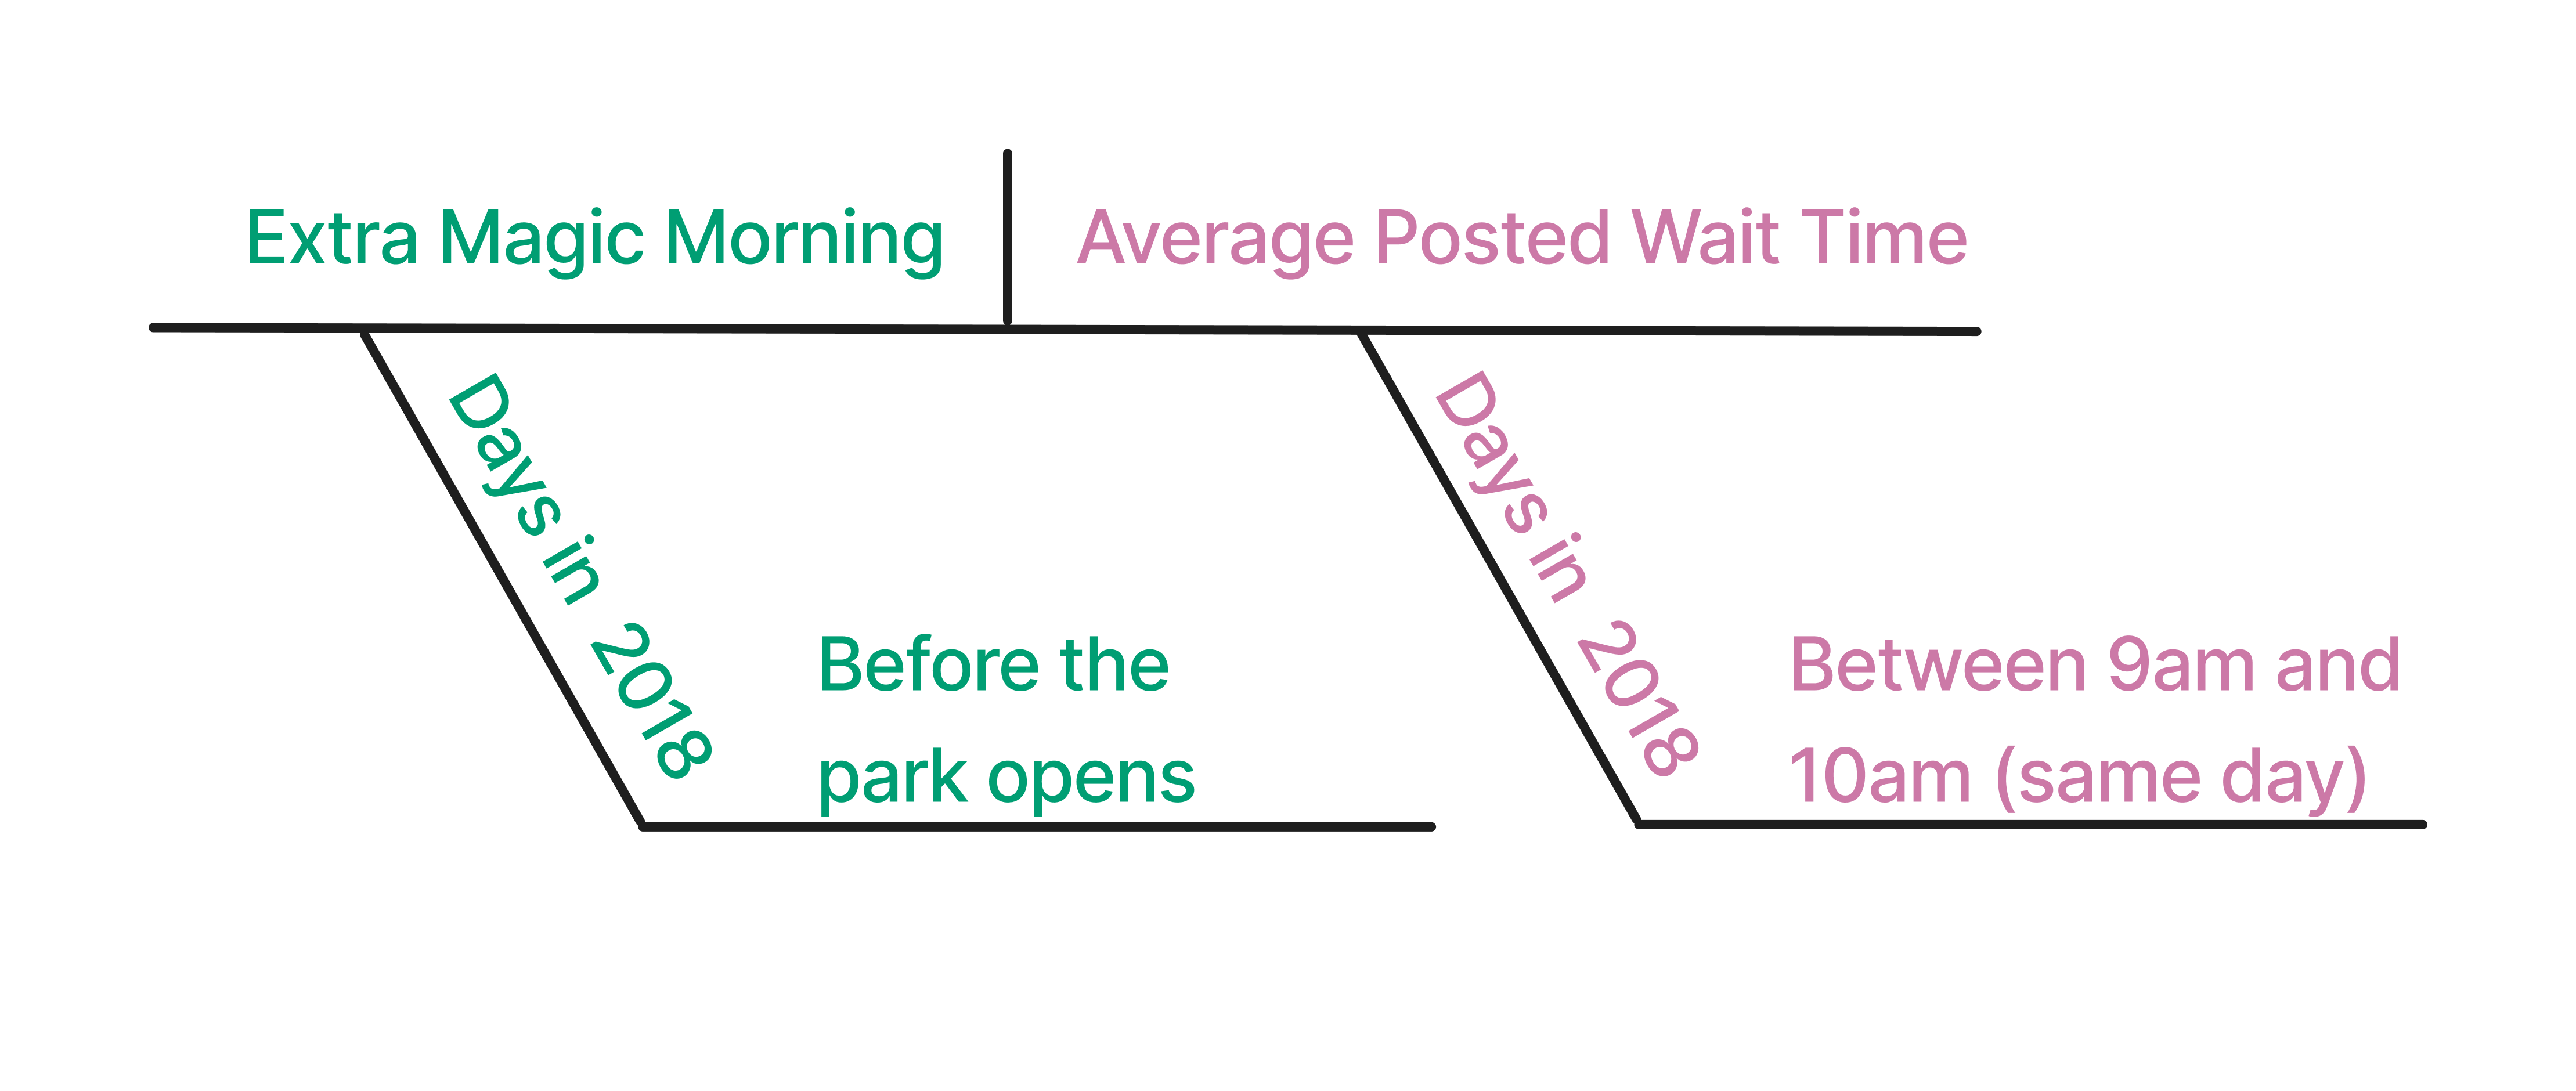
역사적으로 월트 디즈니 월드 리조트 호텔에 숙박하는 투숙객들은 엑스트라 매직 아워 동안 공원을 이용할 수 있었으며, 이 시간 동안 공원은 다른 모든 일반 관람객에게는 폐쇄되었습니다. 이 추가 시간은 아침이나 저녁이 될 수 있습니다. ‘세븐 드워프 마인 트레인’은 월트 디즈니 월드 매직 킹덤에 있는 놀이기구입니다. 매직 킹덤은 매일 엑스트라 매직 아워를 운영할지 여부를 결정합니다. 우리는 아침의 엑스트라 매직 아워(“Extra Magic Morning”)가 같은 날 오전 9시에서 10시 사이의 ’세븐 드워프 마인 트레인’ 평균 게시 대기 시간의 변화를 유발하는지 조사하는 데 관심이 있습니다.
그림 7.2 은 이 질문에 대해 제안된 DAG입니다. 우리는 “Extra Magic Morning”이 공원 폐쇄 시간, 티켓 시즌, 그리고 과거 최고 기온에 근거하여 결정된다고 가정합니다. 마찬가지로, 이 세 가지 변수는 평균 게시 대기 시간의 원인이기도 합니다. 물론 이것은 매우 단순화된 DAG입니다. 게다가, 디즈니의 누군가는 2018년 엑스트라 매직 아워를 결정하는 배정 메커니즘을 알고 있었을 것이므로, 만약 우리가 그곳에서 일하고 있다면 그 과정에 대해 가능한 한 많은 것을 알아내고 싶을 것입니다. 우리는 노출과 결과 모두에 대한 실제 인과 과정이 이보다 훨씬 더 복잡할 것이라고 상상합니다. 하지만 사례 연구를 위해 단순함을 유지하겠습니다.
library(ggdag)
library(ggokabeito)

coord_dag <- list(
  x = c(Season = 0, close = 0, weather = -1, x = 1, y = 2),
  y = c(Season = -1, close = 1, weather = 0, x = 0, y = 0)
)

labels <- c(
  x = "Extra Magic Morning",
  y = "평균 대기 시간",
  Season = "티켓 시즌",
  weather = "과거 최고 기온",
  close = "공원 폐쇄 시간"
)

dagify(
  y ~ x + close + Season + weather,
  x ~ weather + close + Season,
  coords = coord_dag,
  labels = labels,
  exposure = "x",
  outcome = "y"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = c(rep(0, 5), .3)) +
  geom_dag_point() +
  geom_dag_label_repel(seed = 1630) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none") +
  coord_cartesian(clip = "off")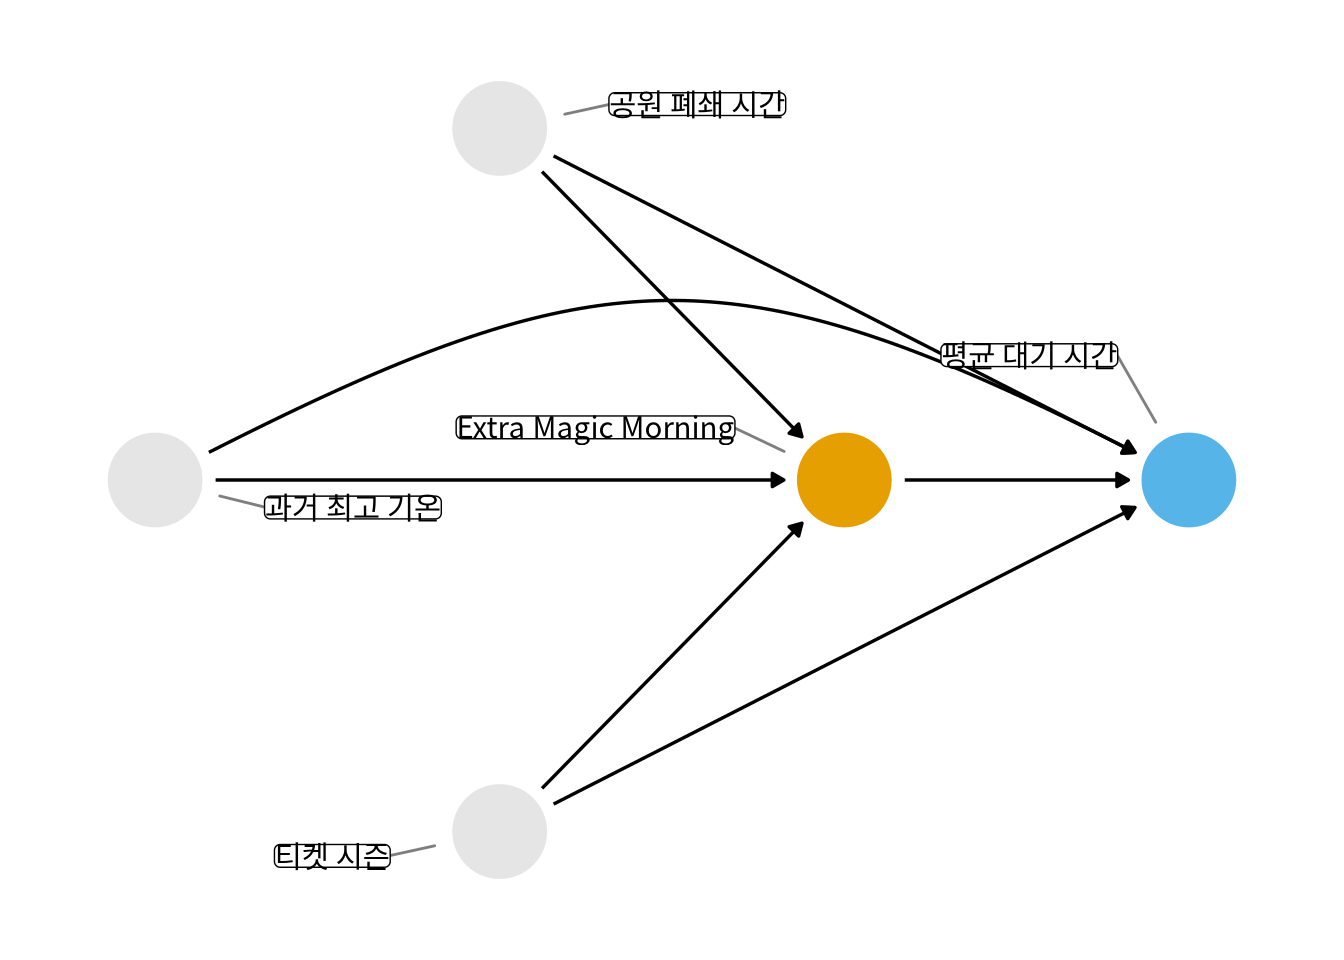
만약 우리가 월트 디즈니 월드의 운영 책임자라면, 특정 날짜에 엑스트라 매직 아워를 (있게 하거나 없게 하도록) 무작위로 배정하고 싶을 것입니다. 우리는 그렇지 않기 때문에, 이전에 수집된 관찰 데이터에 의존해야 하며 가능한 한 우리가 만들었을 법한 목표 시험을 모방하기 위해 최선을 다해야 합니다. 여기서 우리의 관찰 단위는 날짜(days)입니다. 표 7.1 는 인과적 질문의 각 요소를 목표 시험 프로토콜의 요소들에 매핑합니다.
| 프로토콜 단계 | 설명 | 목표 시험 | 모방 연구 |
|---|---|---|---|
| 적격성 기준 | 어떤 날짜를 연구에 포함해야 하는가? | 2018년의 날짜여야 함. | 목표 시험과 동일. |
| 노출 정의 | 적격할 때, 연구 대상이 되는 날짜들이 받게 될 정확한 노출은 무엇인가? | 노출군: 매직 킹덤에서 아침에 엑스트라 매직 아워가 있음. 그 외에는 비노출군. | 목표 시험과 동일. |
| 배정 절차 | 적격한 날짜들이 노출에 어떻게 배정되는가? | 각 날짜는 아침에 엑스트라 매직 아워가 있을 확률 50%로 무작위 배정됨. 배정은 눈가림되지 않음. | 날짜들은 데이터와 일치하는 노출을 배정받음(예: 그날 아침에 엑스트라 매직 아워가 있었는지 여부). 무작위 배정은 교란 조정을 사용하여 모방됨. |
| 추적 관찰 기간 | 추적 관찰은 언제 시작하고 끝나는가? | 시작: 노출 당일 공원 개장 시점; 종료: 같은 날 오전 10시. | 목표 시험과 동일. |
| 결과 정의 | 어떤 정확한 결과가 측정될 것인가? | 같은 날 오전 9시에서 10시 사이의 세븐 드워프 마인 트레인 평균 게시 대기 시간. | 목표 시험과 동일. |
| 관심 있는 인과적 대비 | 어떤 인과 추정 대상을 추정할 것인가? | 평균 처치 효과 (ATE). | 목표 시험과 동일. |
| 분석 계획 | 관심 있는 인과적 대비를 추정하기 위해 어떤 데이터 조작 및 통계적 절차가 적용될 것인가? | ATE는 과거 최고 기온, 티켓 시즌, 공원 폐쇄 시간에 대해 가중치를 둔 역확률 가중치 부여를 사용하여 계산됨. | 목표 시험과 동일. 이 사례에서 변수들은 교란 요인이며, 조정 집합은 그림 7.2 에서 제시된 인과 구조를 가정하여 결정됨. |
프로토콜의 단계들을 수행해야 할 행동(actions)으로 생각할 수 있습니다. 무작위 시험에서 이러한 행동들 중 다수는 시험 설계 및 데이터 수집 단계의 일부입니다. 목표 시험 모방에서는 인과적 질문에 답하기 위해 준비 중인 데이터에 이러한 행동들을 우리가 직접 적용해야 할 때가 많습니다. 표 7.2 은 우리가 취해야 할 행동의 유형(여기서는 tidyverse의 함수들)을 보여줍니다.
우리의 인과적 질문에 답하기 위해 seven_dwarfs_train 데이터셋과 parks_metadata_raw 데이터셋을 모두 가공해야 합니다. 먼저 seven_dwarfs_train 데이터셋부터 시작하겠습니다. touringplans 패키지의 seven_dwarfs_train 데이터셋은 특정 대기 시간이 기록된 날짜(park_date), 대기 시간 기록 시각(wait_datetime), 실제 대기 시간(wait_minutes_actual), 그리고 게시된 대기 시간(wait_minutes_posted)에 대한 정보를 포함하고 있습니다.
이 데이터셋을 살펴봅시다.
# A tibble: 2 × 3
  park_date  wait_minutes_actual wait_minutes_posted
  <date>                   <dbl>               <dbl>
1 2015-01-01              -92918                   0
2 2021-12-28                 217                 300
날짜의 범위와 게시된 대기 시간은 합리적으로 보입니다. 하지만 실제 대기 시간의 최솟값이 -9.2918^{4}이군요! 우리는 아직 이 변수를 사용하지는 않겠지만, 이 행은 미리 제거하는 것이 좋겠습니다.
대기 시간의 분포는 상당히 넓으며, 실제 대기 시간은 평균적으로 게시된 대기 시간보다 짧은 것으로 보입니다.
seven_dwarfs_train |>
  pivot_longer(
    starts_with("wait_minutes"),
    names_to = "wait_type",
    values_to = "wait_minutes"
  ) |>
  ggplot(aes(wait_minutes, fill = wait_type)) +
  geom_density(color = NA, alpha = .8) +
  facet_wrap(~wait_type)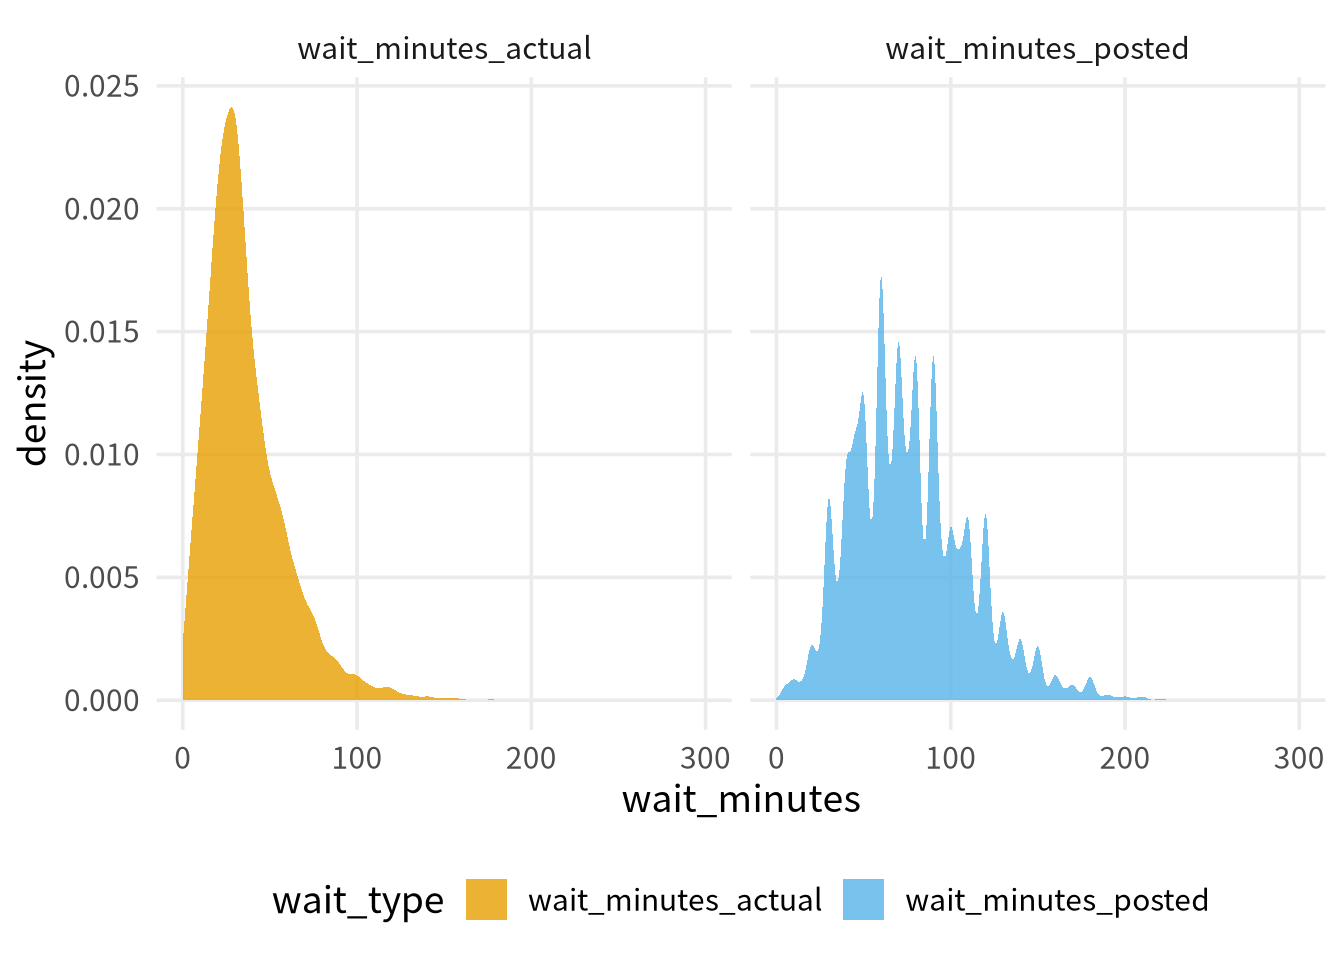
게시된 대기 시간은 또한 더 삐죽삐죽(jagged)합니다. 5분 단위로 반올림되는 것으로 보입니다.
 [1]   0   5  10  15  20  25  30  35  40  45  50  55
[13]  60  65  70  75  80  85  90  95 100 105 110 115
[25] 120 125 130 135 140 145 150 155 160 165 170 175
[37] 180 185 190 195 200 205 210 215 220 225 230 235
[49] 240 250 260 270 280 300
이러한 종류의 데이터 확인을 수행하는 것은 데이터의 한계와 잠재적인 문제를 이해하는 데 필수적입니다. R에는 skimr::skim()이나 pointblank::scan_data()와 같이 데이터셋을 빠르게 요약할 수 있는 훌륭한 도구들이 많이 있습니다. 또한 pointblank와 같은 데이터 검증 도구를 사용하여 데이터에 대한 기대를 기록하고 테스트할 것을 권장합니다.
우리는 이 데이터셋을 사용하여 오전 9시에서 10시 사이의 평균 게시 대기 시간으로 정의된 결과를 계산해야 합니다. 우리의 적격성 기준에 따라 분석을 2018년의 날짜들로 제한해야 합니다.
seven_dwarfs_9 <- seven_dwarfs_train |>
  # 적격성 기준
  filter(year(park_date) == 2018) |>
  # 대기 시간 기록에서 시간을 추출합니다
  mutate(hour = hour(wait_datetime)) |>
  # 결과 정의:
  # 날짜와 시간별로 평균 대기 시간을 계산합니다
  group_by(park_date, hour) |>
  summarize(
    across(
      c(
        wait_minutes_posted,
        wait_minutes_actual
      ),
      \(.x) mean(.x, na.rm = TRUE),
      .names = "{.col}_avg"
    ),
    .groups = "drop"
  ) |>
  # NaN을 NA로 대체합니다
  # 이는 해당 시간에 관측치가 없어 벡터의 길이가 0일 때 발생합니다
  mutate(across(
    c(
      wait_minutes_posted_avg,
      wait_minutes_actual_avg
    ),
    \(.x) if_else(is.nan(.x), NA, .x)
  )) |>
  # 결과 정의:
  # 9시에서 10시 사이의 평균 대기 시간만 유지합니다
  filter(hour == 9)

seven_dwarfs_9
# A tibble: 362 × 4
park_date hour wait_minutes_posted_avg
<date> <int> <dbl>
1 2018-01-01 9 60
2 2018-01-02 9 60
3 2018-01-03 9 60
4 2018-01-04 9 68.9
5 2018-01-05 9 70.6
6 2018-01-06 9 33.3
7 2018-01-07 9 46.4
8 2018-01-08 9 69.5
9 2018-01-09 9 64.3
10 2018-01-10 9 74.3
# ℹ 352 more rows
# ℹ 1 more variable: wait_minutes_actual_avg <dbl>이제 결과가 정해졌으므로, 노출 변수와 분석에서 조정할 해당 날짜의 공원 관련 변수들을 가져와야 합니다. 그림 7.2 을 살펴보면, 세 개의 열린 백도어 경로가 있음을 알 수 있습니다. 우리는 각 경로 상의 세 가지 교란 요인인 티켓 시즌, 공원 폐쇄 시간, 그리고 과거 최고 기온을 통해 이들을 닫을 수 있습니다. 이 변수들은 parks_metadata_raw 데이터셋에 들어 있습니다. 이 데이터는 이름이 원래 형식으로 되어 있으므로 추가적인 정리가 필요할 것입니다.
종종 인과적 질문에 답하려고 할 때, 결과, 노출, 교란 요인들이 함께 결합되도록 여러 소스로부터 데이터를 병합하게 됩니다. 이 데이터를 정리하고 결과 데이터와 결합해 봅시다.
parks_metadata_raw는 seven_dwarfs_train보다 훨씬 많은 변수를 포함하고 있습니다.
parks_metadata_raw |>
  length()
[1] 181이 분석을 위해 우리는 date (조인을 위한 ID 역할을 할 관찰 날짜), wdw_ticket_season (해당 날짜의 티켓 시즌), wdwmaxtemp (과거 최고 기온), mkclose (매직 킹덤 폐쇄 시간), 그리고 mkemhmorn (매직 킹덤에 아침 엑스트라 매직 아워가 있었는지 여부) 변수가 필요합니다.
parks_metadata <- parks_metadata_raw |>
  ## 노출 정의, 배정 절차,
  ## 그리고 분석 계획: ID, 노출, 교란 요인들을 선택합니다
  select(
    # id
    park_date = date,
    # 노출
    park_extra_magic_morning = mkemhmorn,
    # 교란 요인들
    park_ticket_season = wdw_ticket_season,
    park_temperature_high = wdwmaxtemp,
    park_close = mkclose
  ) |>
  ## 적격성 기준: 2018년의 날짜들
  filter(year(park_date) == 2018)
우리는 변수 이름이 깔끔한 관례를 따르는 것을 선호합니다; 이를 위한 한 가지 방법은 Emily Riederer의 “계약으로서의 열 이름(Column Names as Contracts)” 형식을 따르는 것입니다 (Riederer 2020). 기본 아이디어는 정보를 인덱싱하기 위해 정밀한 의미를 가진 단어, 문구 또는 스텁(stubs) 세트를 미리 정의하고, 변수 이름을 지을 때 이를 일관되게 사용하는 것입니다. 예를 들어, 이 데이터에서 특정 대기 시간과 관련된 변수들은 wait라는 용어로 시작하고(예: wait_datetime, wait_minutes_actual), 공원 메타데이터에서 가져온 특정 날짜의 공원 관련 변수들은 park라는 용어로 시작합니다(예: park_date, park_temperature_high).
2018년에는 매월 약 12~16%의 날에 아침 엑스트라 매직 아워가 있었는데, 한 가지 예외가 있습니다: 12월에는 42%의 날에 아침 엑스트라 매직 아워가 있었습니다.
parks_metadata |>
  group_by(month = month(park_date)) |>
  summarise(prop = sum(park_extra_magic_morning) / n())
# A tibble: 12 × 2
month prop
<dbl> <dbl>
1 1 0.129
2 2 0.143
3 3 0.161
4 4 0.133
5 5 0.129
6 6 0.167
7 7 0.129
8 8 0.161
9 9 0.133
10 10 0.161
11 11 0.133
12 12 0.419교란 요인들에 대해서도 조금 더 알아봅시다.
모든 티켓 시즌 유형이 매달 발생하는 것은 아닙니다. 8월이나 9월에는 성수기(peak) 티켓이 없었고, 6월, 7월 또는 12월에는 비수기(value) 티켓이 없었습니다.
count_by_month <- function(parks_metadata, .var) {
  parks_metadata |>
    mutate(
      month = month(
        park_date,
        label = TRUE,
        abbr = TRUE
      )
    ) |>
    count(month, {{ .var }}) |>
    # 암묵적으로 누락된 조합을 채웁니다
    complete(
      month,
      {{ .var }},
      fill = list(n = 0)
    )
}

ticket_season_by_month <- parks_metadata |>
  count_by_month(park_ticket_season)

ticket_season_by_month |>
  arrange(n, park_ticket_season)
# A tibble: 36 × 3
month park_ticket_season n
<ord> <chr> <int>
1 Aug peak 0
2 Sep peak 0
3 Jun value 0
4 Jul value 0
5 Dec value 0
6 Jan peak 3
7 May value 3
8 Feb peak 4
9 Jul peak 4
10 Oct peak 4
# ℹ 26 more rows여름에는 평수기(regular) 티켓 날짜가 훨씬 더 많았고, 3월, 5월, 12월에는 성수기 티켓 날짜가 더 많았습니다 (그림 7.3).
ticket_season_by_month |>
  ggplot(aes(month, n, fill = park_ticket_season)) +
  geom_col(position = "fill", alpha = .8) +
  labs(
    y = "날짜 비율",
    x = NULL,
    fill = "티켓 시즌"
  ) +
  theme(panel.grid.major.x = element_blank())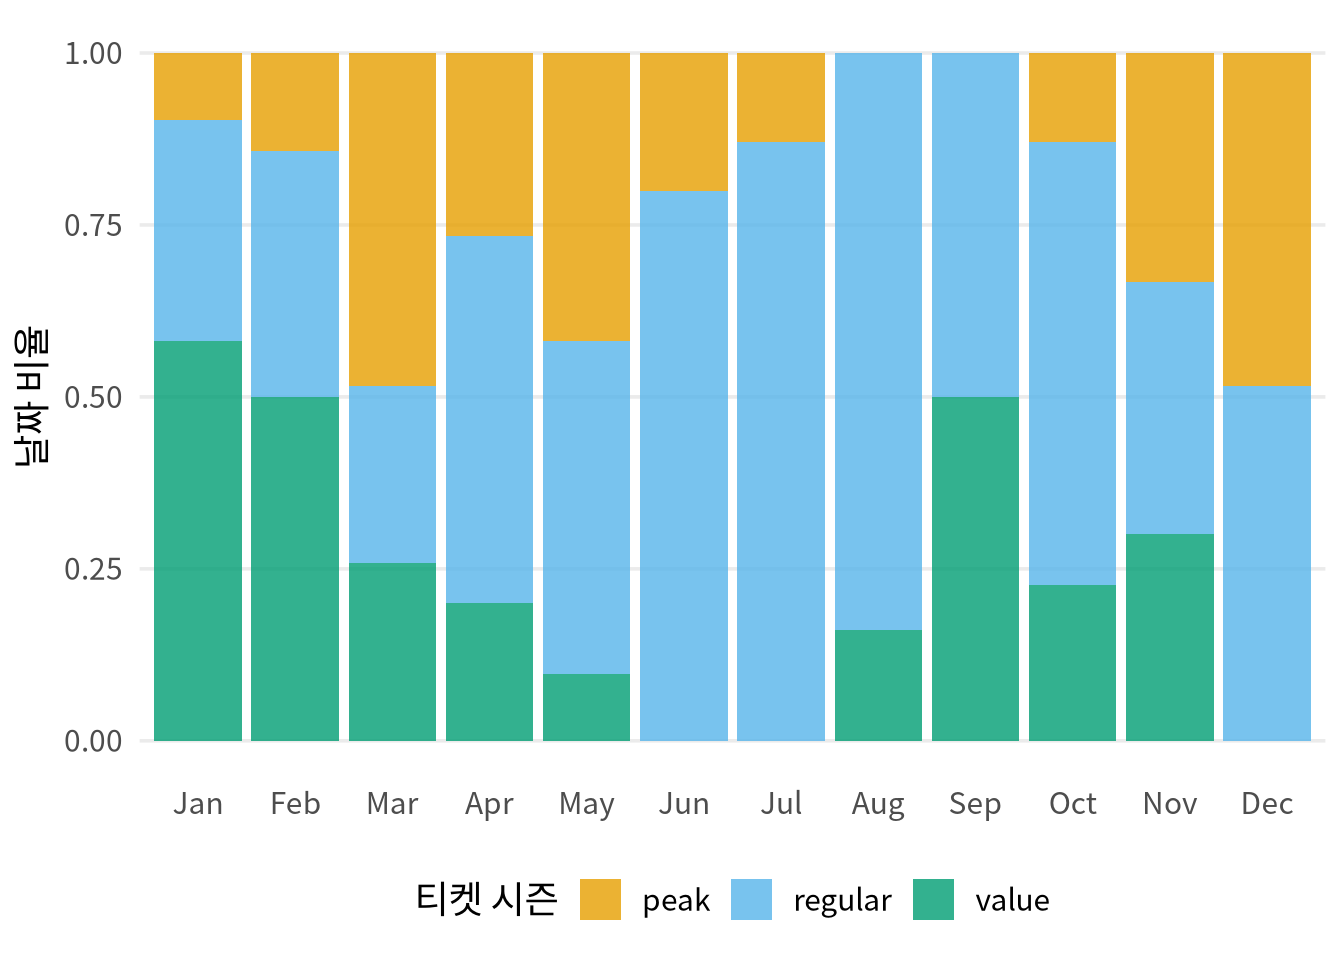
연중 대부분의 기간 동안 매직 킹덤은 22:00, 21:00 또는 자정까지 운영되었지만, 16:30에 끝나는 날을 포함하여 상당히 다양했습니다.
parks_metadata |>
  count(park_close, sort = TRUE)
# A tibble: 8 × 2
park_close n
<time> <int>
1 22:00 105
2 23:00 93
3 24:00 58
4 18:00 57
5 21:00 28
6 20:00 21
7 25:00 2
8 16:30 1폐쇄 시간은 연중 내내 달라지며, 늦가을과 겨울에 더 이른 시간에 폐쇄하는 경우가 더 많습니다 (그림 7.4). 여름에는 이른 폐쇄 시간이 거의 없고, 늦가을에는 늦은 폐쇄 시간이 거의 없습니다.
parks_metadata |>
  count_by_month(park_close) |>
  ggplot(aes(month, n, fill = ordered(park_close))) +
  geom_col(position = "fill", alpha = .85) +
  labs(
    y = "날짜 비율",
    x = NULL,
    fill = "폐쇄 시간"
  ) +
  theme(panel.grid.major.x = element_blank())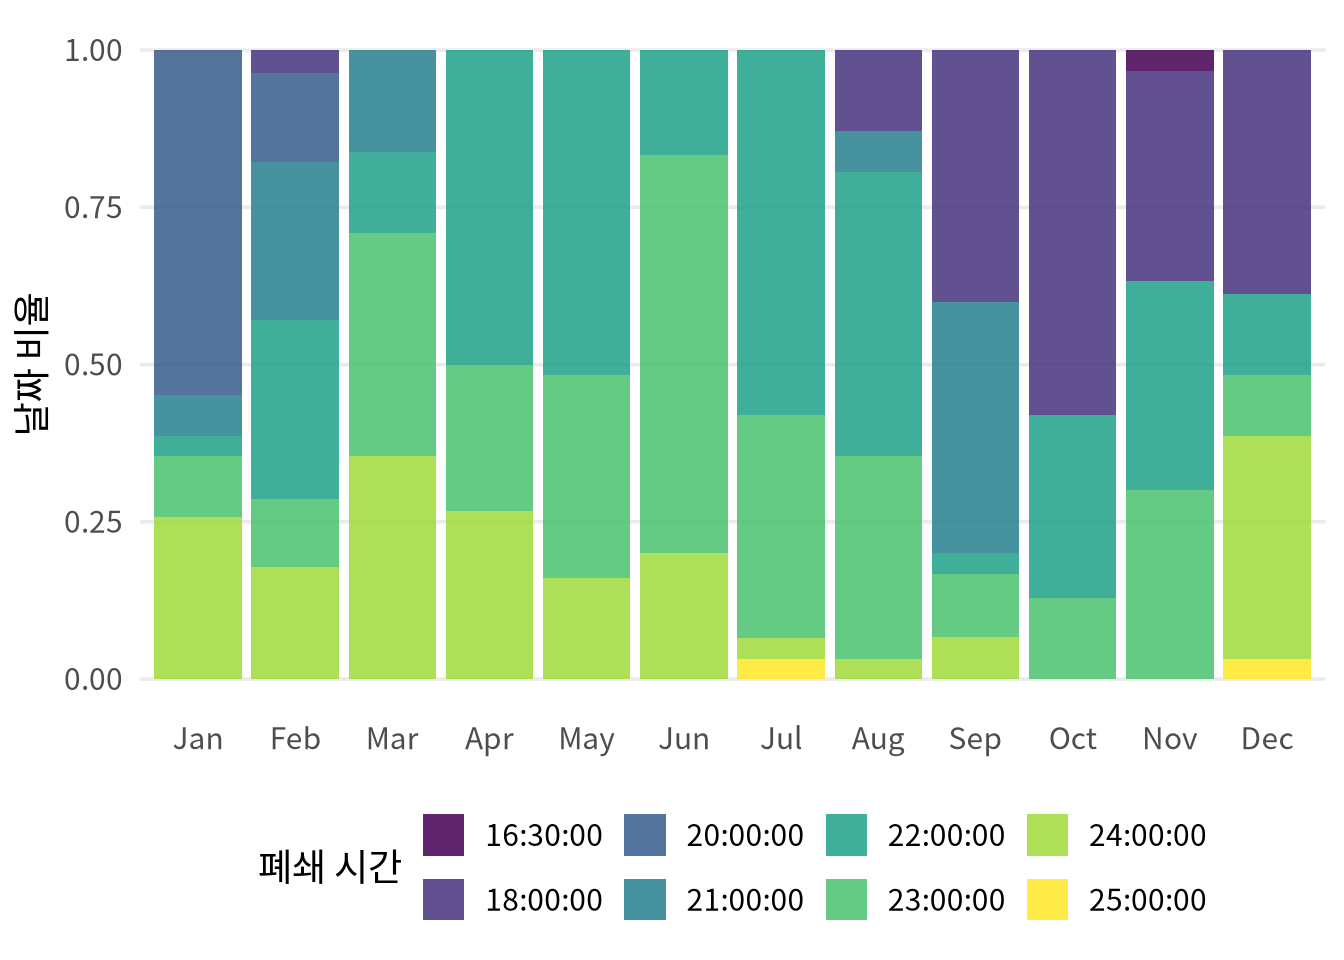
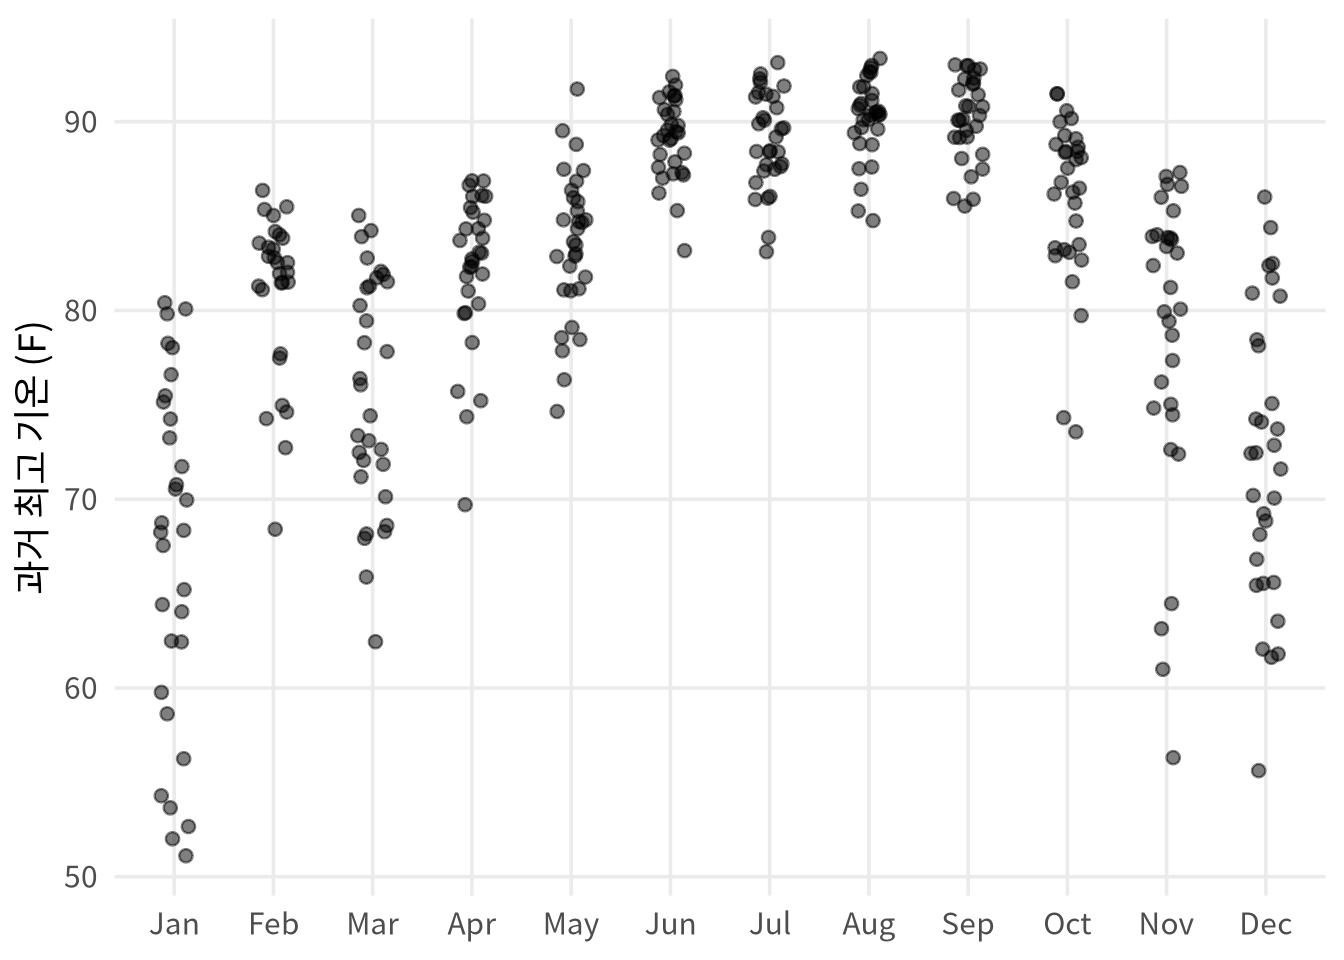
디즈니 월드는 플로리다에 있어서 특별히 추워지지는 않지만, 여름에는 매우 덥습니다 (그림 7.5).
parks_metadata |>
  mutate(
    month = month(
      park_date,
      label = TRUE,
      abbr = TRUE
    )
  ) |>
  ggplot(aes(month, park_temperature_high)) +
  geom_jitter(height = 0, width = .15, alpha = .5) +
  labs(
    y = "과거 최고 기온 (F)",
    x = NULL
  )
이제 교란 요인 및 노출 데이터(parks_metadata)를 결과 데이터(seven_dwarfs_9)와 결합하여 하나의 분석용 데이터셋을 만들어 봅시다. 이 경우에는 간단한 1:1 매칭이며 seven_dwarfs_9에 parks_metadata를 붙이려고 하므로, 왼쪽 조인(left join)을 사용할 수 있습니다.
조인(Joining)은 미묘한 데이터 조작 주제이지만, 분석용 데이터셋을 만드는 데 필수적인 경우가 많습니다. 조인에 대한 자세한 논의는 R for Data Science를 추천합니다.
특히, 모든 날짜에 대해 매칭되는 것은 아닙니다. 2018년은 365일이었고, 이는 parks_metadata의 행 수와 일치합니다. 하지만 seven_dwarfs_9는 362개 행만 가지고 있습니다. 안티 조인(anti-join)을 사용하여 seven_dwarfs_9에 어떤 날짜가 없는지 확인할 수 있습니다.
parks_metadata |>
  anti_join(seven_dwarfs_9, by = "park_date")
# A tibble: 3 × 5
park_date park_extra_magic_morn…¹ park_ticket_season
<date> <dbl> <chr>
1 2018-05-10 0 regular
2 2018-05-11 1 regular
3 2018-05-12 0 peak
# ℹ abbreviated name: ¹park_extra_magic_morning
# ℹ 2 more variables: park_temperature_high <dbl>,
# park_close <time>연속된 이 사흘 동안은 오전 9시의 게시 대기 시간 기록이 누락되어 있습니다.
# A tibble: 0 × 4
# ℹ 4 variables: park_date <date>,
#   wait_datetime <dttm>, wait_minutes_actual <dbl>,
#   wait_minutes_posted <dbl>
어쨌든, 데이터셋들을 날짜별로 결합합시다. 이제 우리의 인과 분석을 수행할 단일 분석용 데이터셋을 갖게 되었습니다.
seven_dwarfs_9 <- seven_dwarfs_9 |>
  left_join(parks_metadata, by = "park_date")

seven_dwarfs_9
# A tibble: 362 × 8
park_date hour wait_minutes_posted_avg
<date> <int> <dbl>
1 2018-01-01 9 60
2 2018-01-02 9 60
3 2018-01-03 9 60
4 2018-01-04 9 68.9
5 2018-01-05 9 70.6
6 2018-01-06 9 33.3
7 2018-01-07 9 46.4
8 2018-01-08 9 69.5
9 2018-01-09 9 64.3
10 2018-01-10 9 74.3
# ℹ 352 more rows
# ℹ 5 more variables: wait_minutes_actual_avg <dbl>,
# park_extra_magic_morning <dbl>,
# park_ticket_season <chr>,
# park_temperature_high <dbl>, park_close <time>기술 통계 표를 만들어 데이터셋을 조감해 봅시다. R에는 이를 위한 많은 도구들이 있으며, 우리는 gtsummary 패키지의 tbl_summary() 함수를 사용할 것입니다. 또한 표의 변수 이름을 정리하기 위해 labelled 패키지를 사용할 것입니다.
표 10.1 에서 아침에 엑스트라 매직 아워가 없었던 날이 더 많았음을 알 수 있습니다. 약간의 차이로 평수기 티켓 시즌이었던 날이 가장 많았으며, 노출군과 비노출군 날짜 모두 세 종류의 티켓 가격 시즌을 모두 포함하고 있었습니다. 폐쇄 시간 중에서는 22:00와 23:00가 가장 흔했습니다. 또한 폐쇄 시간 등에서 관측치가 희소하거나 비어 있는 셀들이 보이는데, 여기서 긍정성 위배(positivity violations)가 발생할 수 있습니다. 엑스트라 매직 아워가 있었던 날은 아주 약간 더 시원했지만, 큰 차이는 아니었습니다.
library(gtsummary)
library(labelled)
seven_dwarfs_9 |>
  set_variable_labels(
    park_ticket_season = "티켓 시즌",
    park_close = "폐쇄 시간",
    park_temperature_high = "과거 최고 기온"
  ) |>
  mutate(
    park_close = as.character(park_close),
    park_extra_magic_morning = factor(
      park_extra_magic_morning,
      labels = c("Magic Hours 없음", "엑스트라 매직 아워")
    )
  ) |>
  tbl_summary(
    by = park_extra_magic_morning,
    include = c(
      park_ticket_season,
      park_close,
      park_temperature_high
    )
  ) |>
  # 표에 전체 열을 추가합니다
add_overall(last = TRUE)| Characteristic |
Magic Hours 없음 N = 3021 |
엑스트라 매직 아워 N = 601 |
Overall N = 3621 |
|---|---|---|---|
| 티켓 시즌 | |||
| peak | 63 (21%) | 18 (30%) | 81 (22%) |
| regular | 161 (53%) | 35 (58%) | 196 (54%) |
| value | 78 (26%) | 7 (12%) | 85 (23%) |
| park_close | |||
| 16:30:00 | 1 (0.3%) | 0 (0%) | 1 (0.3%) |
| 18:00:00 | 39 (13%) | 18 (30%) | 57 (16%) |
| 20:00:00 | 19 (6.3%) | 2 (3.3%) | 21 (5.8%) |
| 21:00:00 | 28 (9.3%) | 0 (0%) | 28 (7.7%) |
| 22:00:00 | 93 (31%) | 11 (18%) | 104 (29%) |
| 23:00:00 | 81 (27%) | 11 (18%) | 92 (25%) |
| 24:00:00 | 40 (13%) | 17 (28%) | 57 (16%) |
| 25:00:00 | 1 (0.3%) | 1 (1.7%) | 2 (0.6%) |
| 과거 최고 기온 | 84 (78, 89) | 83 (76, 87) | 84 (78, 89) |
| 1 n (%); Median (Q1, Q3) | |||
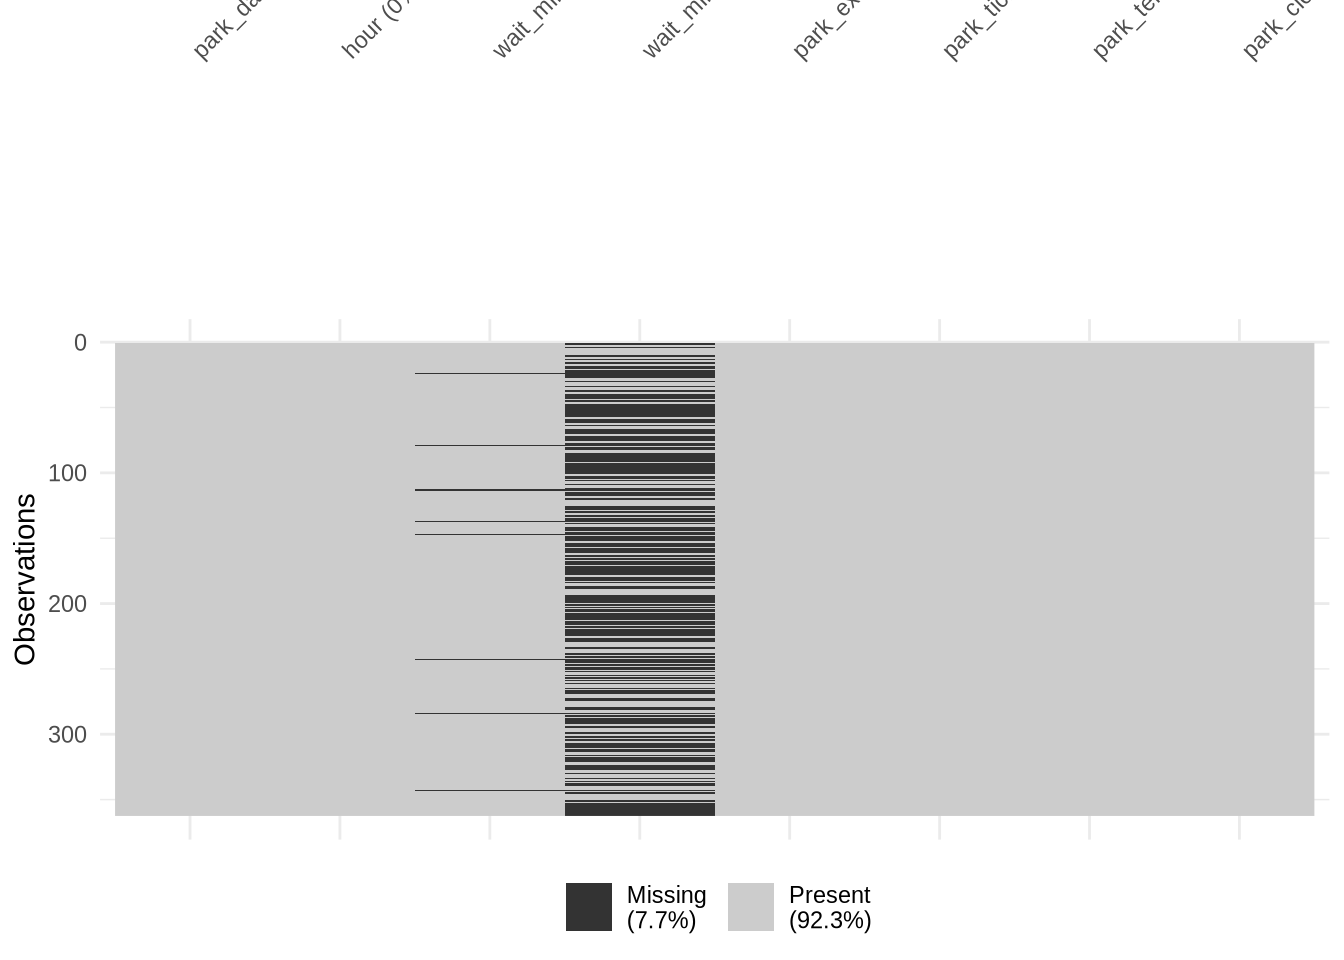
우리의 변수들에 결측 데이터가 있는지 파악하는 것은 장 4 에서 보았고 장 15 에서 더 자세히 탐구할 이유들로 인해 매우 중요합니다. 안티 조인 결과에서 보았듯이, 실제로 일부 데이터가 누락되어 있습니다. 좀 더 자세히 살펴봅시다. visdat 패키지는 결측 데이터가 있는지 빠르게 파악하는 데 유용합니다.
게시된 대기 시간의 누락된 관측치는 기록이 아예 없는 날짜들에만 국한되지 않았습니다. 일부 날짜들은 레코드는 있었지만 비어 있었습니다. 예를 들어 1월 24일에는 9개의 레코드가 있었지만, 두 종류의 대기 시간 모두 누락되었습니다.
seven_dwarfs_train |>
  filter(
    park_date == "2018-01-24",
    hour(wait_datetime) == 9
  ) |>
  select(starts_with("wait_minutes"))
# A tibble: 9 × 2
wait_minutes_actual wait_minutes_posted
<dbl> <dbl>
1 NA NA
2 NA NA
3 NA NA
4 NA NA
5 NA NA
6 NA NA
7 NA NA
8 NA NA
9 NA NA결과적으로, 기록이 없는 3일을 포함하여 총 8일 동안의 게시 대기 시간 데이터가 누락되었으며, 이는 연간 총 일수의 약 3%에 해당합니다. 이 정도의 결측치는 우리 결과에 큰 영향을 미칠 가능성이 낮습니다. 이번 첫 분석에서는 게시된 대기 시간의 결측값을 무시할 것입니다. 실제 대기 시간(actual wait times)에는 훨씬 많은 결측치가 있으며, 이 주제는 장 15 에서 다시 다룰 것입니다. 아직 이 결과를 사용하고 있지 않으므로, 이 또한 일단 제쳐두겠습니다.
sec-assump와 sec-quartets에서 보았듯이, 데이터만으로는 인과 추론에 필요한 검증 불가능한 가정 문제를 해결할 수 없습니다. 하지만 여전히 귀중한 정보를 제공합니다.
교환 가능성(Exchangeability)은 확인하기 어려운 가정입니다. 많은 경우, 교란 요인은 노출과 결과 모두와 연관됩니다. 하지만 교란 요인과 이 두 변수 사이의 관계 자체가 교란되어 있을 수도 있습니다. 교환 가능성에 대한 데이터 확인은 sec-eval-ps-model에서 더 나은 도구를 써서 이 가정을 조사할 때까지 미루겠습니다.
일관성(Consistency)을 확인하는 한 가지 방법은 여러 버전의 처치 데이터를 쓰는 것입니다. 예를 들어, 질문이 “아침 엑스트라 매직 아워” 대신 단순히 “엑스트라 매직 아워”였다면 일관성 위배가 발생했을 수도 있습니다. 엑스트라 매직 아워는 저녁에도 있으며, 이것이 아침 시간대와 다른 효과를 낼 수 있다는 것은 타당해 보입니다. 우리는 두 가지 엑스트라 매직 아워 유형을 별개의 노출로 분리하여 데이터를 탐색할 수 있습니다. 우리는 이미 구체적으로 명시하고 있으므로 이를 직접 계산하지는 않겠지만, 아이디어는 다른 종류의 층화와 동일합니다. 여기서는 할당된 exposure 값과 exposure_type(예: “아침” 또는 “저녁” 노출)을 그룹화하여 살펴볼 것입니다.
dataset |>
  group_by(exposure, exposure_type) |>
  summarize(...)
또한 측정하기 어려운 방식으로 아침 엑스트라 매직 아워들이 서로 다를 수도 있습니다; 우리는 많은 조사를 하지 않고는 이를 확인하지 못할 수도 있습니다. 이미 아침 엑스트라 매직 아워를 사용한다고 명확히 했으므로 이 가정을 더 이상 조사하지 않겠습니다. 실무에서는 이러한 결정에 신중해야 하며, 자신의 노출과 그 다양한 발현 양상에 대해 전문가가 되어야 합니다.
이제 긍정성(positivity)을 파헤쳐 봅시다. 긍정성 가정은 교환 가능성을 달성하기 위해 사용되는 변수들의 각 수준과 조합 내에서 노출된 대상과 노출되지 않은 대상이 모두 존재할 것을 요구합니다. 우리는 제안된 각 교란 요인의 분포를 노출에 따라 층화하여 시각화함으로써 이를 탐색할 수 있습니다. 이는 특정 수준에서 노출된 날짜나 노출되지 않은 날짜가 누락되었는지 이해하는 데 도움을 줄 것입니다. 하지만 확률적(stochastic) 긍정성 위배와 구조적(structural) 긍정성 위배의 차이를 구분할 수 있는 유일한 방법은 배경 지식뿐입니다. 예를 들어, 특정 폐쇄 시간에 엑스트라 매직 아워가 없었던 것이 단지 우연일 수도 있지만(확률적 위배), 교란 요인들을 고려할 때 엑스트라 매직 아워를 가질 자격이 없는 날들이 있을 수도 있습니다(구조적 위배).
그림 7.6 는 아침 엑스트라 매직 아워 여부에 따른 매직 킹덤 공원 폐쇄 시간의 분포를 보여줍니다. 두 노출 수준 모두 대부분의 공변량 공간을 포괄하고 있지만, 매직 킹덤이 16:30과 21:00에 폐쇄된 날 중에는 아침 엑스트라 매직 아워가 있었던 날이 없었습니다.
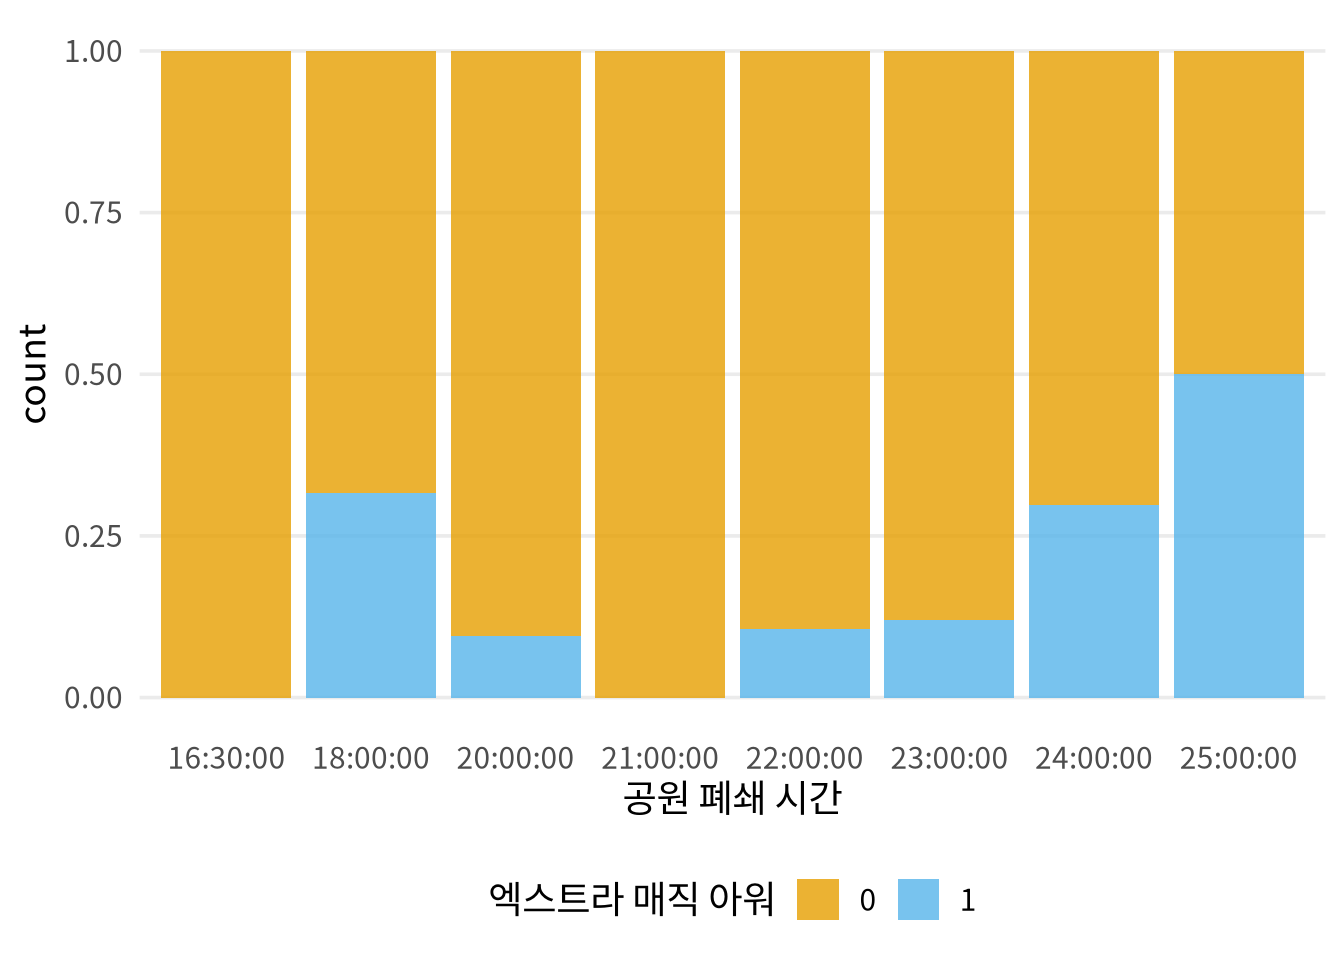
우리가 알다시피 16:30에 끝난 날은 하루뿐이었지만, 21:00에 끝난 날은 28일이었으며 그중 아침 엑스트라 매직 아워가 있었던 날은 하루도 없었습니다. 이는 추가적인 통계적 가정이나 질문의 변경 없이는 데이터의 이 공변량 공간 영역에 대해 추론을 이끌어내기 어렵게 만듭니다. 나중에 이에 대해 자세히 살펴보겠습니다.
# A tibble: 4 × 3
  park_close park_extra_magic_morning     n
  <time>                        <dbl> <int>
1 16:30                             0     1
2 16:30                             1     0
3 21:00                             0    28
4 21:00                             1     0
우리는 대칭 히스토그램(mirrored histogram)을 사용하여 아침 엑스트라 매직 아워 여부에 따른 매직 킹덤의 과거 최고 기온 분포를 조사할 수 있습니다. 이를 만들기 위해 halfmoon 패키지의 geom_mirror_histogram()을 사용할 것입니다. 그림 7.7 를 살펴보면, 노출군(EMM 있음) 중에서 최고 기온이 60도 미만인 날은 거의 없습니다.
library(halfmoon)
ggplot(
  seven_dwarfs_9,
  aes(
    x = park_temperature_high,
    group = factor(park_extra_magic_morning),
    fill = factor(park_extra_magic_morning)
  )
) +
  geom_mirror_histogram(bins = 20, alpha = .8) +
  scale_y_continuous(labels = abs) +
  labs(
    fill = "엑스트라 매직 아워",
    x = "과거 최고 기온 (F)"
  )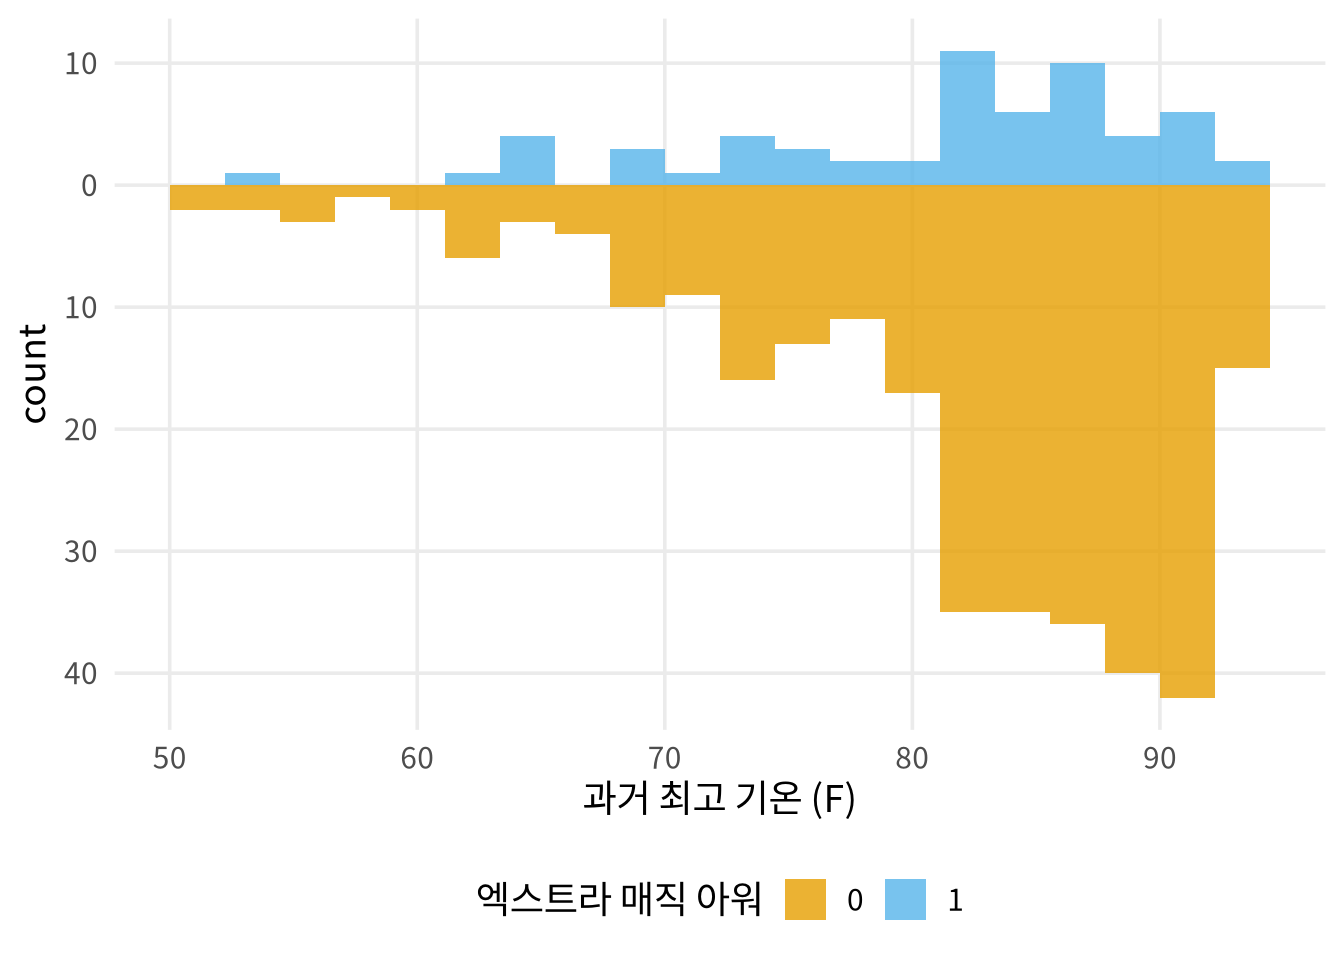
실제로 이 과거 최고 기온 범위에서 아침 엑스트라 매직 아워가 있었던 날은 단 하루뿐입니다. 우리의 문제 이해도에 비추어 볼 때 이것이 특히 우려된다면, 분석 대상을 더 따뜻한 날로 제한하도록 인과적 질문을 변경하는 것을 고려할 수 있습니다. 그러한 변경은 또한 우리가 결론을 내릴 수 있는 날짜들을 제한하게 될 것입니다.
seven_dwarfs_9 |>
  filter(park_temperature_high < 60) |>
  count(park_extra_magic_morning)
# A tibble: 2 × 2
park_extra_magic_morning n
<dbl> <int>
1 0 9
2 1 1마지막으로, 아침 엑스트라 매직 아워 여부에 따른 티켓 시즌의 분포를 살펴봅시다. 그림 7.8 을 살펴보면, 어떠한 긍정성 위배도 보이지 않습니다.
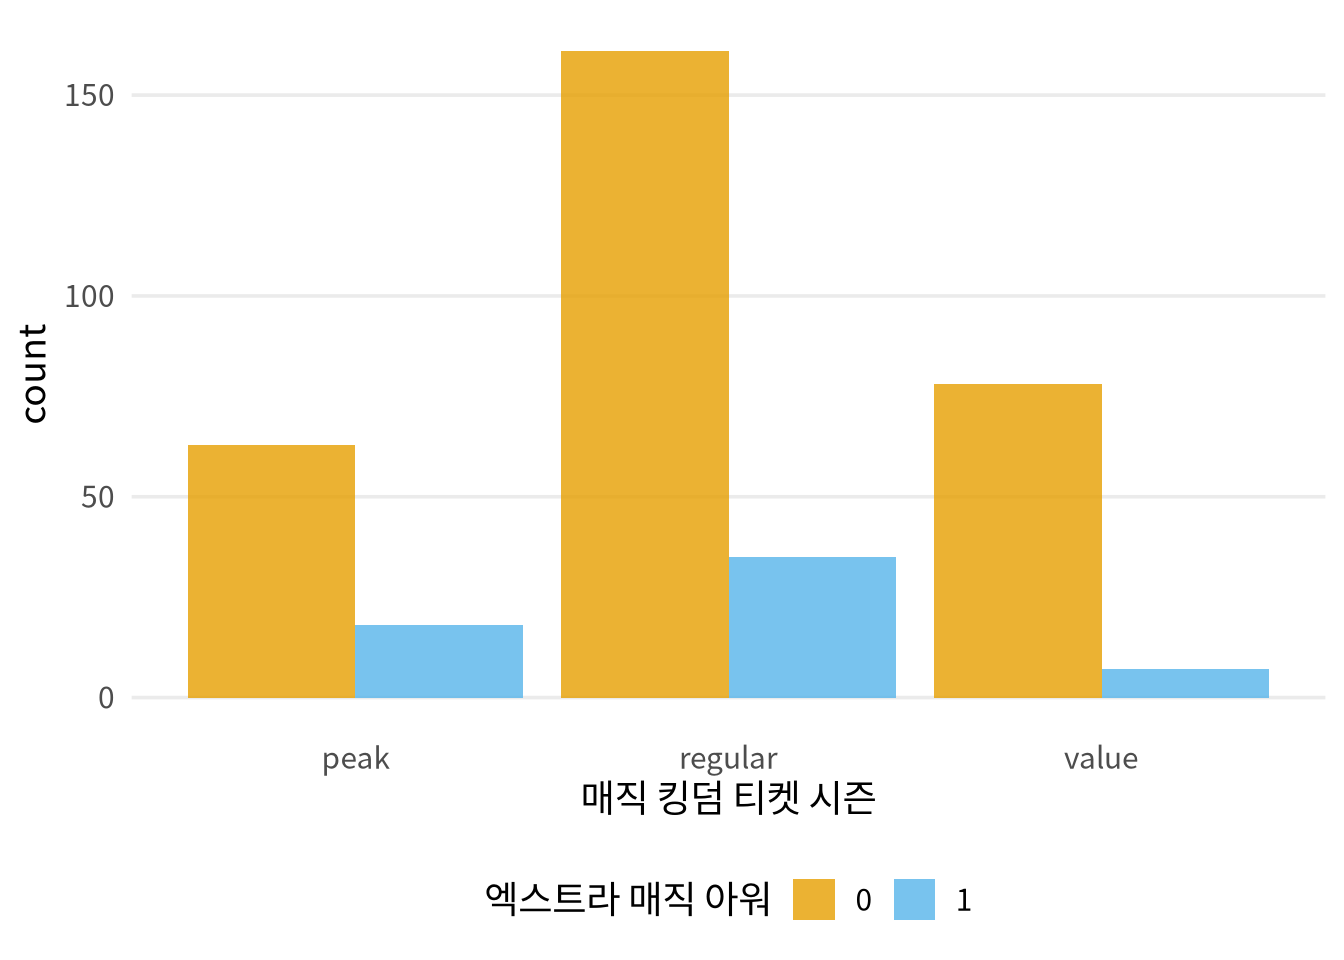
세 가지 교란 요인들 사이에서 긍정성 위배의 잠재적 증거가 보입니다. 여기서는 변수가 아주 적기 때문에 이를 더 자세히 살펴볼 수 있습니다. 먼저 park_temperature_high 변수를 3분위수로 나누어 이산화하는 것부터 시작하겠습니다.
prop_exposed <- seven_dwarfs_9 |>
  ## park_temperature_high를 3분위수로 나눕니다
  mutate(park_temperature_high_bin = cut(
    park_temperature_high,
    breaks = 3
  )) |>
  ## 공원 폐쇄 시간을 구간화합니다
  mutate(park_close_bin = case_when(
    hour(park_close) < 19 & hour(park_close) > 12 ~ "(1) early",
    hour(park_close) >= 19 & hour(park_close) < 24 ~ "(2) standard",
    hour(park_close) >= 24 | hour(park_close) < 12 ~ "(3) late"
  )) |>
  group_by(
    park_close_bin,
    park_temperature_high_bin,
    park_ticket_season
  ) |>
  ## 각 구간에서의 노출 비율을 계산합니다
  summarize(
    prop_exposed = mean(park_extra_magic_morning == "엑스트라 매직 아워"),
    .groups = "drop"
  ) |>
  complete(
    park_close_bin,
    park_temperature_high_bin,
    park_ticket_season,
    fill = list(prop_exposed = 0)
  )

prop_exposed |>
  ggplot(
    aes(
      x = park_close_bin,
      y = park_temperature_high_bin,
      fill = prop_exposed
    )
  ) +
  geom_tile() +
  scale_fill_viridis_c(begin = .1, end = .9) +
  facet_wrap(~ park_ticket_season) +
  labs(
    y = "과거 최고 기온 (F)",
    x = "매직 킹덤 공원 폐쇄 시간",
    fill = "노출된\n날짜 비율"
  ) +
  theme(panel.grid = element_blank())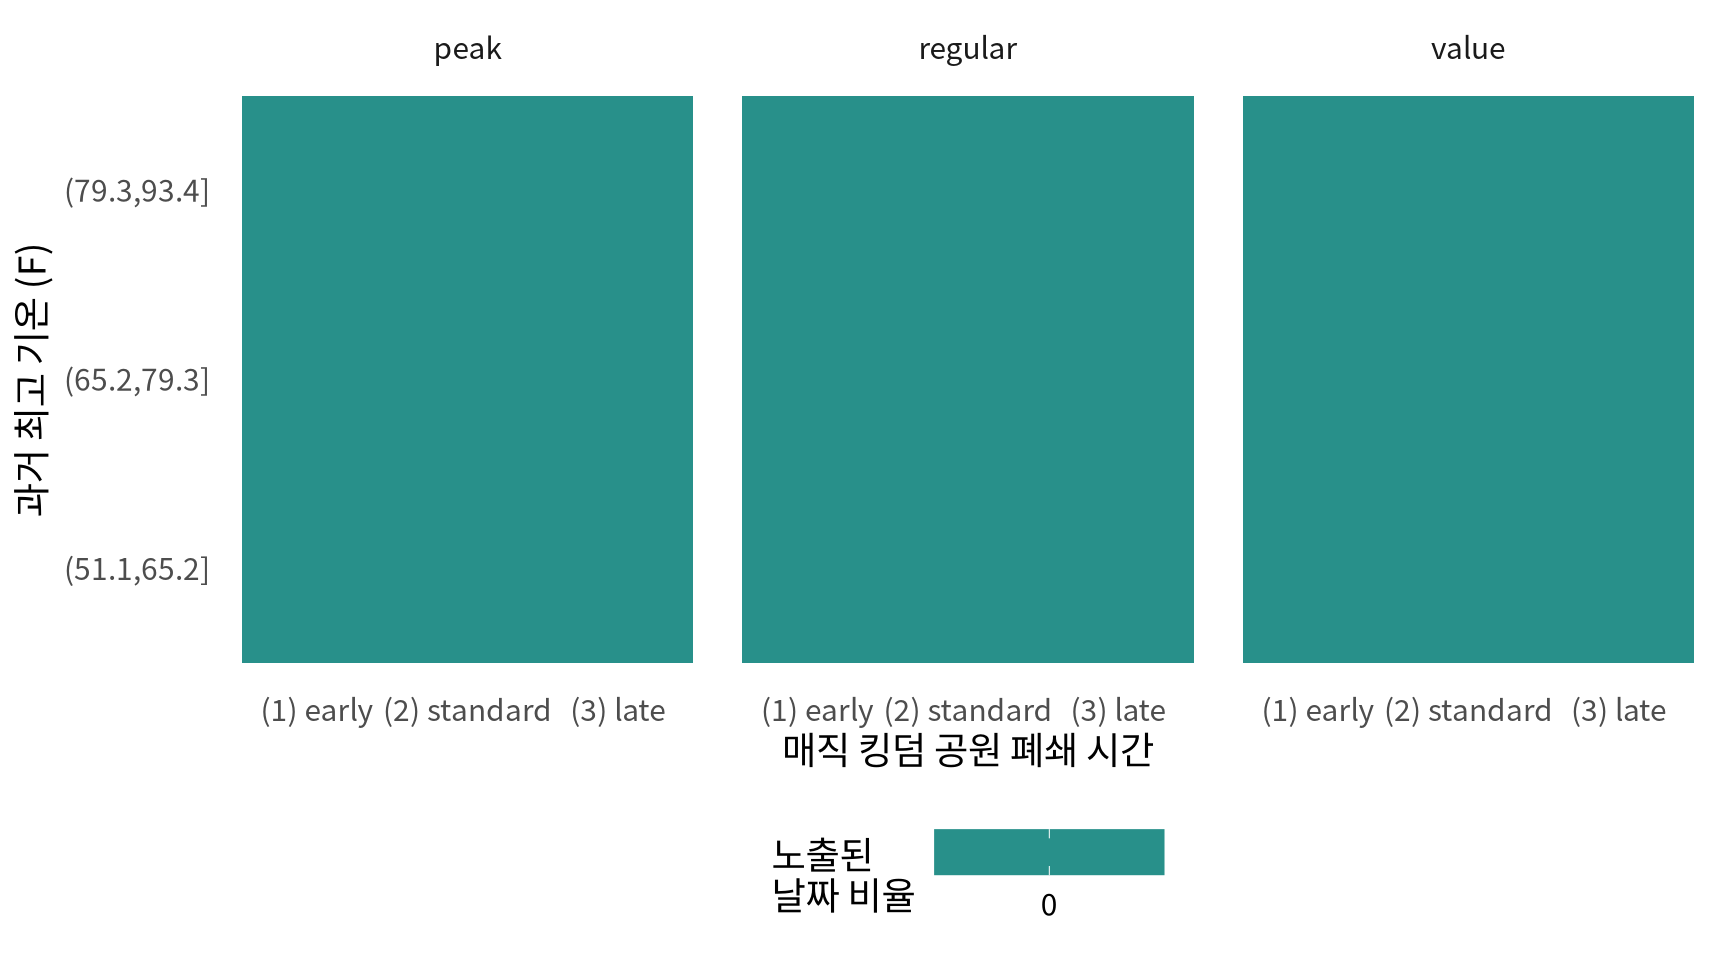
그림 7.9 는 흥미로운 잠재적 위배 사항을 보여줍니다. 기온이 낮은 날(과거 최고 기온 51~65도 사이)이면서 성수기 티켓 시즌인 경우, 100%의 날짜에 아침 엑스트라 매직 아워가 있었습니다. 이 데이터셋에 대해 조금만 생각해 보면 이는 실제로 말이 됩니다. 플로리다에서 기온이 낮으면서 동시에 월트 디즈니 월드를 방문하기에 “성수기”로 간주될 만한 날은 크리스마스와 새해 연휴뿐이기 때문입니다. 이 기간 동안에는 역사적으로 항상 엑스트라 매직 아워가 있었습니다.
또한 노출된 적이 없는 조합이 여러 개 있습니다.
| 폐쇄 시간 | 기온 | 티켓 시즌 | 노출 비율 |
|---|---|---|---|
| (1) early | (51.1,65.2] | peak | 0 |
| (1) early | (51.1,65.2] | regular | 0 |
| (1) early | (51.1,65.2] | value | 0 |
| (1) early | (65.2,79.3] | peak | 0 |
| (1) early | (65.2,79.3] | regular | 0 |
| (1) early | (65.2,79.3] | value | 0 |
| (1) early | (79.3,93.4] | peak | 0 |
| (1) early | (79.3,93.4] | regular | 0 |
| (1) early | (79.3,93.4] | value | 0 |
| (2) standard | (51.1,65.2] | peak | 0 |
| (2) standard | (51.1,65.2] | regular | 0 |
| (2) standard | (51.1,65.2] | value | 0 |
| (2) standard | (65.2,79.3] | peak | 0 |
| (2) standard | (65.2,79.3] | regular | 0 |
| (2) standard | (65.2,79.3] | value | 0 |
| (2) standard | (79.3,93.4] | peak | 0 |
| (2) standard | (79.3,93.4] | regular | 0 |
| (2) standard | (79.3,93.4] | value | 0 |
| (3) late | (51.1,65.2] | peak | 0 |
| (3) late | (51.1,65.2] | regular | 0 |
| (3) late | (51.1,65.2] | value | 0 |
| (3) late | (65.2,79.3] | peak | 0 |
| (3) late | (65.2,79.3] | regular | 0 |
| (3) late | (65.2,79.3] | value | 0 |
| (3) late | (79.3,93.4] | peak | 0 |
| (3) late | (79.3,93.4] | regular | 0 |
| (3) late | (79.3,93.4] | value | 0 |
이들이 단지 우연한 발생일까요, 아니면 이 날짜들이 아침 엑스트라 매직 아워를 가질 수 없는 구조적인 부적격성 때문일까요? 만약 우연한 발생이라면, 우리 데이터의 공변량 공간에서 이러한 빈 영역들에 대해 유효하게 외삽(extrapolate)할 수 있게 해주는 통계적 가정을 세울 수 있을까요? 어떤 경우든, 적격성이나 추정 대상을 통해 우리가 묻고 있는 질문을 변경해야 할까요? 일단은 연구 질문이나 목표 시험 모방을 변경하지 않고 계속 진행하겠지만, 이러한 관찰 결과들을 염두에 두고 향후 섹션에서 다른 옵션들을 탐구해 볼 것입니다.
이제 인과적 질문과 데이터(그리고 그 한계)에 대해 더 잘 이해하게 되었으므로, 우리가 찾고 있는 답의 추정치를 개선하기 위해 통계 모델을 사용하는 것으로 관심을 돌려봅시다. 통계 모델을 사용하는 것으로 관심을 돌려봅시다.