경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
지금까지 이 책에서 살펴본 대부분의 예시는 단일 시점에서의 노출과 결과를 다루었습니다. 그러나 많은 실제 연구에서 노출과 결과, 그리고 교란 요인은 시간에 따라 변화(time-varying)합니다. 예를 들어, 장기간의 식이 패턴이 건강 결과에 미치는 영향, 또는 반복적인 약물 처치가 질병 진행에 미치는 영향을 연구할 때 단순한 단면적 분석만으로는 부족합니다.
18장에서는 종단(longitudinal) 데이터에서 인과 추론을 수행하는 데 필요한 주요 개념과 방법을 소개합니다:
종단 연구에서는 연구 기간 동안 일부 참가자가 중도 이탈(drop out)하기도 합니다. 이를 추적 관찰 소실(loss to follow-up, LTFU)이라고 합니다.
추적 관찰 소실이 단순히 무작위로 발생한다면(완전 무작위 결측, MCAR) 편향을 일으키지 않습니다. 그러나 현실에서는 이탈 여부가 종종 노출이나 결과와 관련된 요인에 의해 결정됩니다. 이때 선택 편향(selection bias)이 발생하며, 이를 정보적 검열(informative censoring)이라고도 부릅니다.
library(ggdag)
library(ggokabeito)

dagify(
  Y ~ X + C,
  X ~ C,
  S ~ X + C + Y,
  coords = list(
    x = c(X = 0, C = 0.5, Y = 2, S = 1),
    y = c(X = 0, C = 1,   Y = 0, S = -0.5)
  ),
  labels = c(
    X = "노출",
    Y = "결과",
    C = "교란 요인",
    S = "이탈(이탈=1)"
  ),
  exposure = "X",
  outcome = "Y"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(aes(x, y, xend = xend, yend = yend, color = status)) +
  geom_dag_edges() +
  geom_dag_point() +
  geom_dag_label_repel(seed = 42) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(legend.position = "none")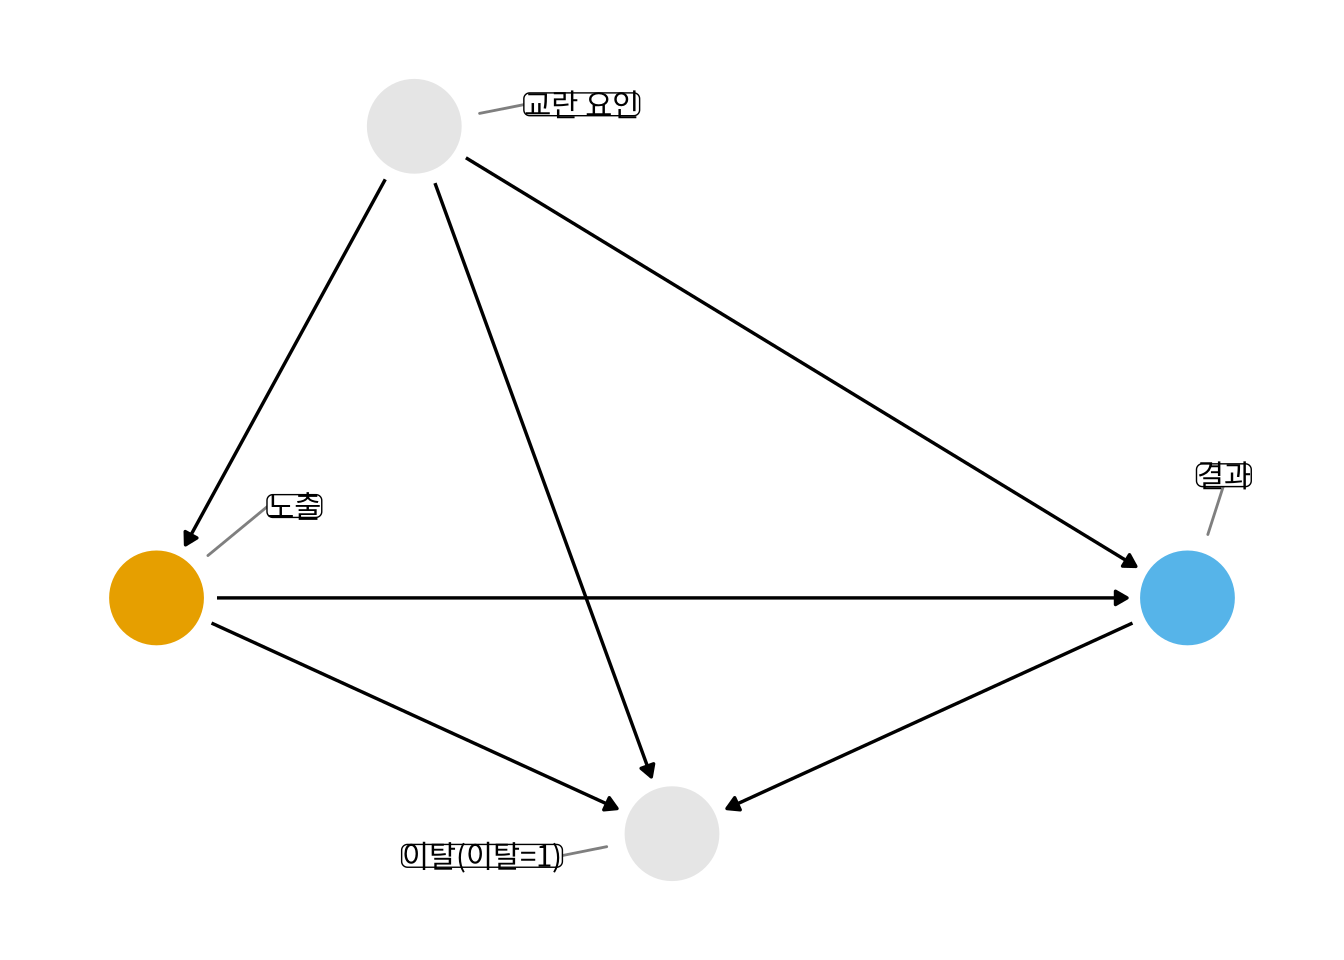
추적 관찰 소실에 따른 선택 편향은 역확률 검열 가중치(Inverse Probability of Censoring Weights, IPCW)를 사용하여 교정할 수 있습니다. 이는 이탈하지 않을 확률의 역수를 각 관측치에 가중치로 부여하여, 남아 있는 참가자들을 통해 이탈한 참가자들의 정보를 복원하는 방법입니다.
library(dplyr)
library(touringplans)
library(broom)

# 디즈니 월드 예시: 특정 시간대의 데이터 분석
# 시뮬레이션: 더운 날에 게시 대기 시간이 긴 경우 데이터가 누락되는 상황
set.seed(2024)

seven_dwarfs_complete <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  drop_na(wait_minutes_posted_avg) |>
  mutate(
    # 더운 날 + 긴 대기 시간일수록 기록이 빠진 확률 높다고 가정
    p_censored = plogis(
      -3 + 0.02 * park_temperature_high +
      0.01 * wait_minutes_posted_avg
    ),
    censored = rbinom(n(), 1, p_censored),
    # 검열된 관측치의 결과를 NA로 처리
    wait_observed = ifelse(censored == 0, wait_minutes_posted_avg, NA)
  )

cat("전체 관측치:", nrow(seven_dwarfs_complete), "\n")
전체 관측치: 354 검열된 관측치: 124 완전 관측치: 230 library(propensity)
# 검열 모델: 어떤 관측치가 이탈하지 않는지(censored = 0) 예측
censoring_model <- glm(
I(censored == 0) ~
park_extra_magic_morning + park_temperature_high +
park_ticket_season + park_close,
data = seven_dwarfs_complete,
family = binomial()
)
# IPCW 계산: 이탈하지 않은 사람들에게 가중치 부여
seven_dwarfs_with_ipcw <- censoring_model |>
augment(type.predict = "response", data = seven_dwarfs_complete) |>
filter(censored == 0) |>
mutate(
ipcw = 1 / .fitted
)
cat("IPCW 가중치 요약:\n")IPCW 가중치 요약:summary(seven_dwarfs_with_ipcw$ipcw) Min. 1st Qu. Median Mean 3rd Qu. Max.
1.24 1.42 1.49 1.54 1.58 2.29 검열 보정 전 효과:# A tibble: 1 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 park_extra_magi… 6.48 3.08 2.11 0.0363cat("\nIPCW 검열 보정 후 효과:\n")
IPCW 검열 보정 후 효과:# A tibble: 1 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 park_extra_magi… 4.95 3.00 1.65 0.0999종단 데이터에서 가장 어려운 문제 중 하나는 시간 가변적 교란(time-varying confounding)입니다. 시간 가변적 교란 요인은 시간에 따라 변하는 교란 요인이며, 이전 노출의 영향도 받는다는 점이 핵심입니다.
예를 들어 다음과 같은 인과 구조를 생각해 봅시다:
X_t: 시점 t에서의 노출L_t: 시점 t에서의 교란 요인 (시간에 따라 변함)Y: 결과여기서 L_t는 이전 노출 X_{t-1}의 영향을 받고, 동시에 현재 노출 X_t와 최종 결과 Y에도 영향을 미칩니다.
dagify(
  L2 ~ X1 + L1,
  X2 ~ L2 + X1,
  Y ~ X2 + L2 + X1,
  X1 ~ L1,
  coords = list(
    x = c(L1 = 0, X1 = 1, L2 = 2, X2 = 3, Y = 4),
    y = c(L1 = 1, X1 = 0, L2 = 1, X2 = 0, Y = 0)
  ),
  labels = c(
    L1 = "L(t=1)\n교란",
    X1 = "X(t=1)\n노출",
    L2 = "L(t=2)\n교란",
    X2 = "X(t=2)\n노출",
    Y = "Y\n결과"
  )
) |>
  tidy_dagitty() |>
  ggplot(aes(x, y, xend = xend, yend = yend)) +
  geom_dag_edges() +
  geom_dag_point(color = "grey50") +
  geom_dag_label_repel(aes(label = label), seed = 100, size = 3) +
  theme_dag()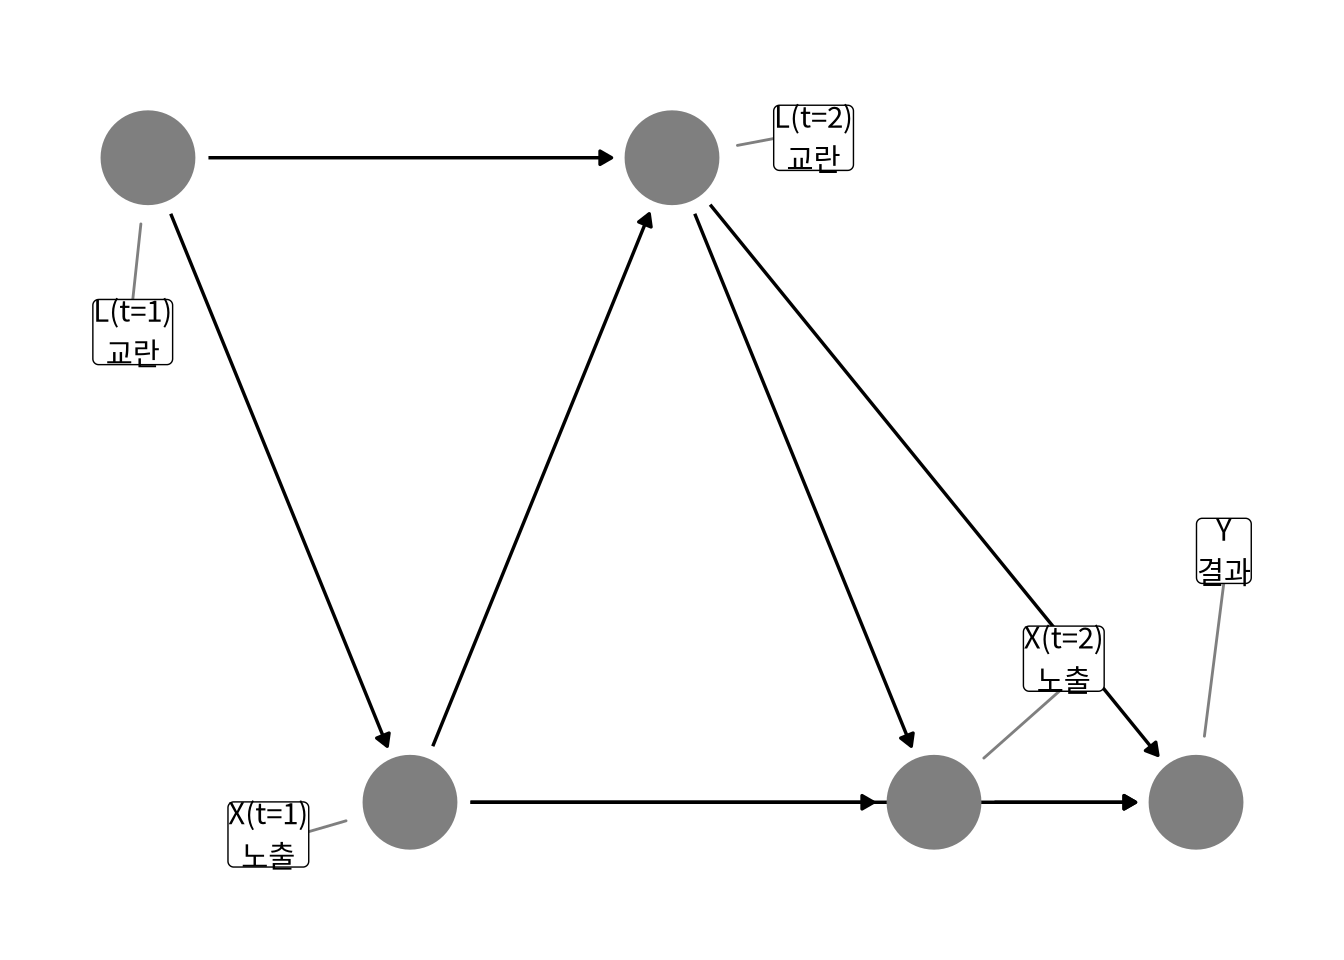
위의 DAG에서 L_t를 표준 회귀 방법으로 보정하면 충돌체 편향(collider bias)이 발생합니다. L_t는 X_{t-1}의 결과이자 X_t와 Y의 원인이므로, L_t를 통제하면 X_{t-1}과 Y 사이의 경로가 열리기 때문입니다.
이 문제를 해결하기 위해 Robins(1986)가 개발한 한계 구조 모델(Marginal Structural Model, MSM)을 사용합니다.
한계 구조 모델은 시간 가변적 처치와 교란을 다루는 데 유용한 도구입니다. 각 시점에서의 처치 확률의 역수를 가중치로 사용합니다:
\[SW_t = \prod_{k=0}^{t} \frac{P(X_k = x_k \mid \bar{X}_{k-1})}{P(X_k = x_k \mid \bar{X}_{k-1}, \bar{L}_k)}\]
여기서: - 분자: 과거 처치 이력만을 기반으로 한 처치 확률 (안정화 가중치) - 분모: 과거 처치 이력과 시간 가변적 교란 요인을 모두 기반으로 한 처치 확률
# 예시: 두 시점의 데이터를 사용한 시간 가변적 IPTW 계산
# 디즈니 월드 예시: 오전 8시와 9시 시점의 데이터

eight_for_longitudinal <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 8) |>
  select(
    park_date,
    park_extra_magic_morning,
    park_temperature_high,
    park_ticket_season,
    park_close,
    wait_minutes_posted_avg
  ) |>
  rename_with(~ paste0(.x, "_t1"), -park_date)

nine_for_longitudinal <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  select(
    park_date,
    park_extra_magic_morning,
    park_temperature_high,
    park_ticket_season,
    park_close,
    wait_minutes_posted_avg
  ) |>
  rename_with(~ paste0(.x, "_t2"), -park_date)

longitudinal_data <- eight_for_longitudinal |>
  inner_join(nine_for_longitudinal, by = "park_date") |>
  drop_na()

cat("종단 데이터 차원:", nrow(longitudinal_data), "x", ncol(longitudinal_data), "\n")
종단 데이터 차원: 217 x 11 # t=1 시점의 처치 확률 모델 (분모)
ps_model_t1_denom <- glm(
park_extra_magic_morning_t1 ~
park_temperature_high_t1 + park_ticket_season_t1 + park_close_t1,
data = longitudinal_data,
family = binomial()
)
# t=1 시점의 처치 확률 모델 (분자: 안정화)
ps_model_t1_num <- glm(
park_extra_magic_morning_t1 ~ 1,
data = longitudinal_data,
family = binomial()
)
# t=2 시점의 처치 확률 모델 (분모: 과거 처치 이력 + 시간 가변적 교란 포함)
ps_model_t2_denom <- glm(
park_extra_magic_morning_t2 ~
park_extra_magic_morning_t1 +
park_temperature_high_t2 + park_ticket_season_t2 + park_close_t2 +
wait_minutes_posted_avg_t1, # 과거 결과가 새로운 교란 역할
data = longitudinal_data,
family = binomial()
)Warning: glm.fit: algorithm did not convergeWarning: glm.fit: algorithm did not convergelibrary(broom)
# 각 시점의 가중치 계산
longitudinal_with_weights <- longitudinal_data |>
mutate(
ps_t1_denom = predict(ps_model_t1_denom, type = "response"),
ps_t1_num = predict(ps_model_t1_num, type = "response"),
ps_t2_denom = predict(ps_model_t2_denom, type = "response"),
ps_t2_num = predict(ps_model_t2_num, type = "response"),
# 각 시점에서의 실제 처치를 받을 확률
prob_t1_denom = ifelse(park_extra_magic_morning_t1 == 1, ps_t1_denom, 1 - ps_t1_denom),
prob_t1_num = ifelse(park_extra_magic_morning_t1 == 1, ps_t1_num, 1 - ps_t1_num),
prob_t2_denom = ifelse(park_extra_magic_morning_t2 == 1, ps_t2_denom, 1 - ps_t2_denom),
prob_t2_num = ifelse(park_extra_magic_morning_t2 == 1, ps_t2_num, 1 - ps_t2_num),
# 시간 가변적 안정화 IPTW (두 시점의 가중치 곱)
sw = (prob_t1_num * prob_t2_num) / (prob_t1_denom * prob_t2_denom)
)
cat("시간 가변적 IPTW 요약:\n")시간 가변적 IPTW 요약:summary(longitudinal_with_weights$sw) Min. 1st Qu. Median Mean 3rd Qu. Max.
0.429 0.909 0.965 1.000 1.077 2.113 # A tibble: 3 × 7
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 67.5 1.41 48.0 7.34e-117
2 park_extra_m… 7.50 2.72 2.76 6.33e- 3
3 park_extra_m… NA NA NA NA
# ℹ 2 more variables: conf.low <dbl>, conf.high <dbl>한계 구조 모델의 핵심은 결과 모델(MSM)에서 시간 가변적 교란 요인(L_t)을 포함하지 않는다는 점입니다. 교란은 이미 IPTW 가중치를 거쳐 처리되었기 때문입니다. MSM에 교란 요인을 다시 포함시키면 가중치 부여 효과가 상쇄됩니다.
이는 단면 분석에서 IPTW를 사용할 때와 원리는 같으나(장 11), 종단 데이터에서는 각 시점의 가중치를 곱해서 사용한다는 점이 다릅니다.