노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
성향 점수는 본질적으로 균형(balancing) 점수입니다. 목표는 교란 요인 전반에 걸쳐 노출군들 사이의 균형을 맞추는 것입니다.
균형을 평가하는 한 가지 방법은 표준화된 평균 차이(standardized mean difference, SMD)입니다. 이 척도는 교란 요인의 평균값이 노출군 사이에 균형이 잡혀 있는지 평가하는 데 도움이 됩니다. 예를 들어, 어떤 연속형 교란 요인 \(Z\) 가 있고, \(\bar{z}_{exposed} = \frac{\sum Z_i(X_i)}{\sum X_i}\) 가 노출군에서 \(Z\) 의 평균값, \(\bar{z}_{unexposed} = \frac{\sum Z_i(1-X_i)}{\sum 1-X_i}\) 가 비노출군에서 \(Z\) 의 평균값이며, \(s_{exposed}\) 가 노출군에서 \(Z\) 의 표본 표준 편차, \(s_{unexposed}\) 가 비노출군에서 \(Z\) 의 표본 표준 편차라고 할 때, 표준화된 평균 차이는 다음과 같이 표현될 수 있습니다:
\[ d =\frac{\bar{z}_{exposed}-\bar{z}_{unexposued}}{\frac{\sqrt{s^2_{exposed}+s^2_{unexposed}}}{2}} \]
이진 변수 \(Z\) (두 개의 수준만 있는 교란 요인)의 경우, \(\bar{z}\) 는 각 그룹의 표본 비율(예: \(\hat{p}_{exposed}\) 또는 \(\hat{p}_{unexposed}\) )로 대체되고 \(s^2=\hat{p}(1-\hat{p})\) 가 됩니다. \(Z\) 가 세 개 이상의 범주를 가진 범주형 변수인 경우, \(\bar{z}\) 는 그룹 내 각 범주 수준의 비율 벡터이고 분모는 다항 공분산 행렬(\(S\))이 되며, 위의 식은 다음과 같이 더 일반적으로 쓰일 수 있습니다:
\[ d = \sqrt{(\bar{z}_{exposed} - \bar{z}_{unexposed})^TS^{-1}(\bar{z}_{exposed} - \bar{z}_{unexposed})} \]
종종 우리는 조정되지 않은 전체 데이터셋에서 각 교란 요인에 대한 표준화된 평균 차이를 계산한 다음, 이를 조정된 표준화된 평균 차이와 비교합니다. 만약 성향 점수가 매칭(matching)을 사용하여 통합되었다면, 이 조정된 표준화된 평균 차이는 위와 정확히 같은 공식을 사용하지만, 표본을 매칭된 사람들로만 제한합니다. 만약 성향 점수가 가중치 부여(weighting)를 사용하여 통합되었다면, 이 조정된 표준화된 평균 차이는 구성된 성향 점수 가중치를 사용하여 위의 각 구성 요소에 가중치를 부여합니다.
R에서 halfmoon 패키지는 데이터셋에 대해 이를 계산해 주는 tidy_smd 함수를 가지고 있습니다.
섹션 8.2 와 동일한 데이터를 사용한 예시를 살펴보겠습니다.
library(broom)
library(touringplans)
library(propensity)
library(halfmoon)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |> filter(wait_hour == 9)

seven_dwarfs_9_with_ps <-
  glm(
    park_extra_magic_morning ~
      park_ticket_season + park_close + park_temperature_high,
    data = seven_dwarfs_9,
    family = binomial()
 ) |>
  augment(type.predict = "response", data = seven_dwarfs_9)
seven_dwarfs_9_with_wt <- seven_dwarfs_9_with_ps |>
  mutate(
    w_ate = wt_ate(.fitted, park_extra_magic_morning),
    park_extra_magic_morning = factor(park_extra_magic_morning)
 )
이제 tidy_smd 함수를 사용하여 가중치 부여 전후의 표준화된 평균 차이를 검토해 보겠습니다.
library(halfmoon)
balance_metrics <-
  seven_dwarfs_9_with_wt |>
  mutate(park_close = as.numeric(park_close)) |>
  check_balance(
    .vars = c(park_ticket_season, park_close, park_temperature_high),
    .exposure = park_extra_magic_morning,
    .weights = w_ate
 )

balance_metrics
# A tibble: 32 × 5
variable group_level method metric estimate
<chr> <chr> <chr> <chr> <dbl>
1 park_close 0 obser… ks 0.171
2 park_close 0 w_ate ks 0.139
3 park_close 0 obser… smd -0.126
4 park_close 0 w_ate smd 0.0566
5 park_close 0 obser… vr 1.92
6 park_close 0 w_ate vr 1.42
7 park_temperature… 0 obser… ks 0.151
8 park_temperature… 0 w_ate ks 0.148
9 park_temperature… 0 obser… smd -0.157
10 park_temperature… 0 w_ate smd -0.0598
# ℹ 22 more rowscheck_balance()는 다른 지표들도 계산하지만, 여기서는 표준화된 평균 차이에 집중하겠습니다.
smds <- balance_metrics |>
  filter(metric == "smd")

smds
# A tibble: 10 × 5
variable group_level method metric estimate
<chr> <chr> <chr> <chr> <dbl>
1 park_close 0 obser… smd -0.126
2 park_close 0 w_ate smd 0.0566
3 park_temperature… 0 obser… smd -0.157
4 park_temperature… 0 w_ate smd -0.0598
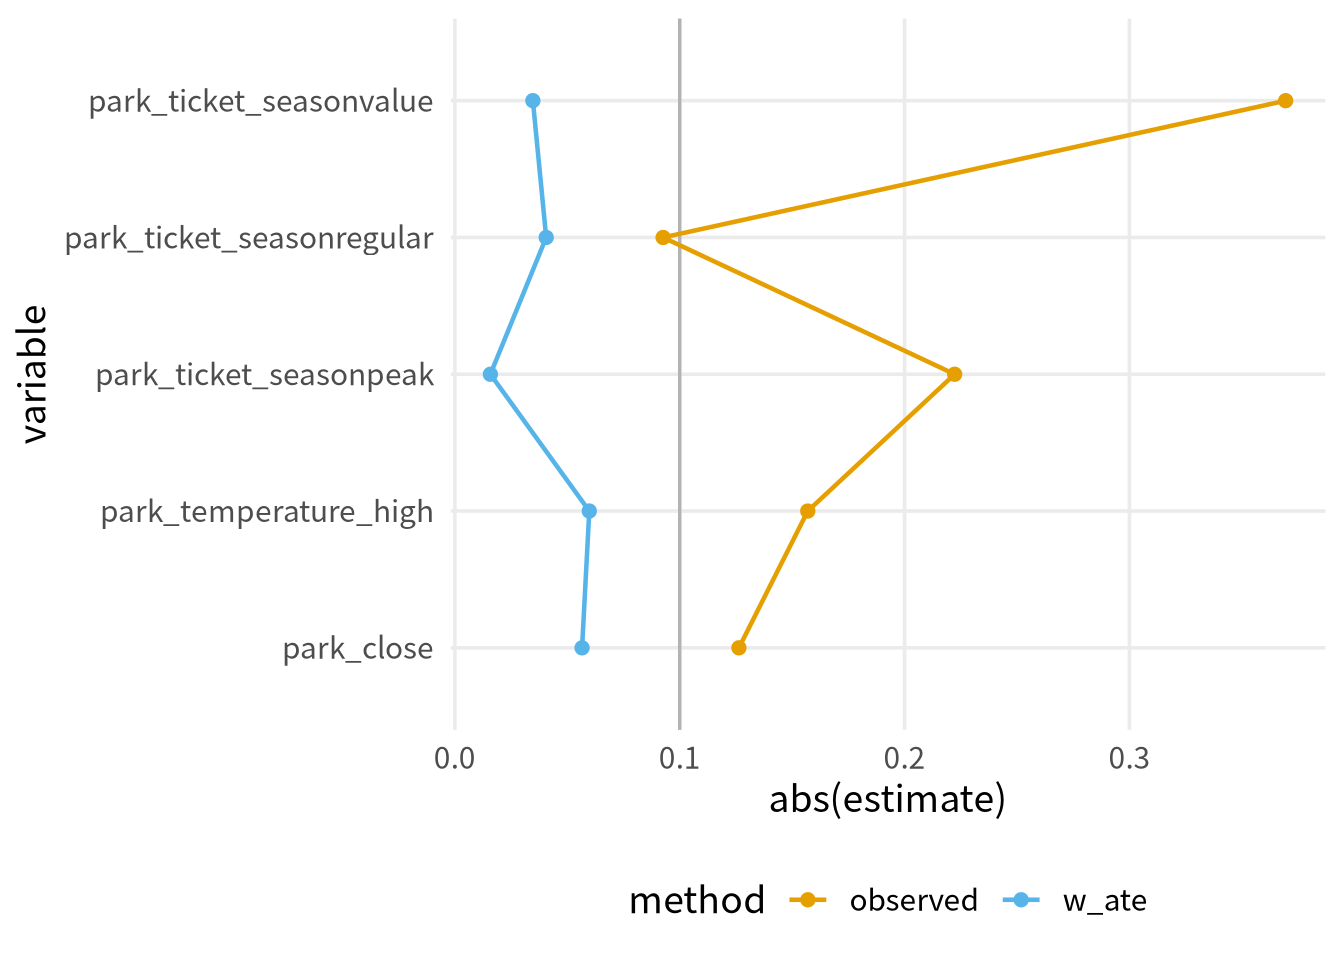
5 park_ticket_seas… 0 obser… smd 0.222
6 park_ticket_seas… 0 w_ate smd 0.0158
7 park_ticket_seas… 0 obser… smd 0.0926
8 park_ticket_seas… 0 w_ate smd -0.0406
9 park_ticket_seas… 0 obser… smd -0.369
10 park_ticket_seas… 0 w_ate smd 0.0347예를 들어, 위에서 티켓 시즌에 대한 관찰된 표준화된 평균 차이(성향 점수를 반영하기 전)는 임을 볼 수 있습니다. 하지만 성향 점수 가중치를 반영한 후에는 이 수치가 감소하여 가 되었습니다.
이 지표의 한 가지 단점은 오직 평균에서의 균형만을 정량화한다는 것입니다. 이는 연속형 교란 요인에 대해서는 충분하지 않을 수 있는데, 평균에서는 균형이 잡혀 있더라도 꼬리 부분에서는 심각하게 불균형할 수 있기 때문입니다. 이 장의 끝에서 우리는 교란 요인의 전체 분포에 걸쳐 균형을 검토하기 위한 몇 가지 도구들을 보여줄 것입니다.
이러한 표준화된 평균 차이를 시각화하는 것부터 시작해 봅시다. 이를 위해 우리는 러브 플롯(Love Plot)을 즐겨 사용합니다(토마스 러브의 이름을 딴 것인데, 그가 이를 처음으로 대중화한 사람 중 한 명이기 때문입니다). halfmoon 패키지는 이 구현을 단순화해주는 geom_love 함수를 가지고 있습니다.
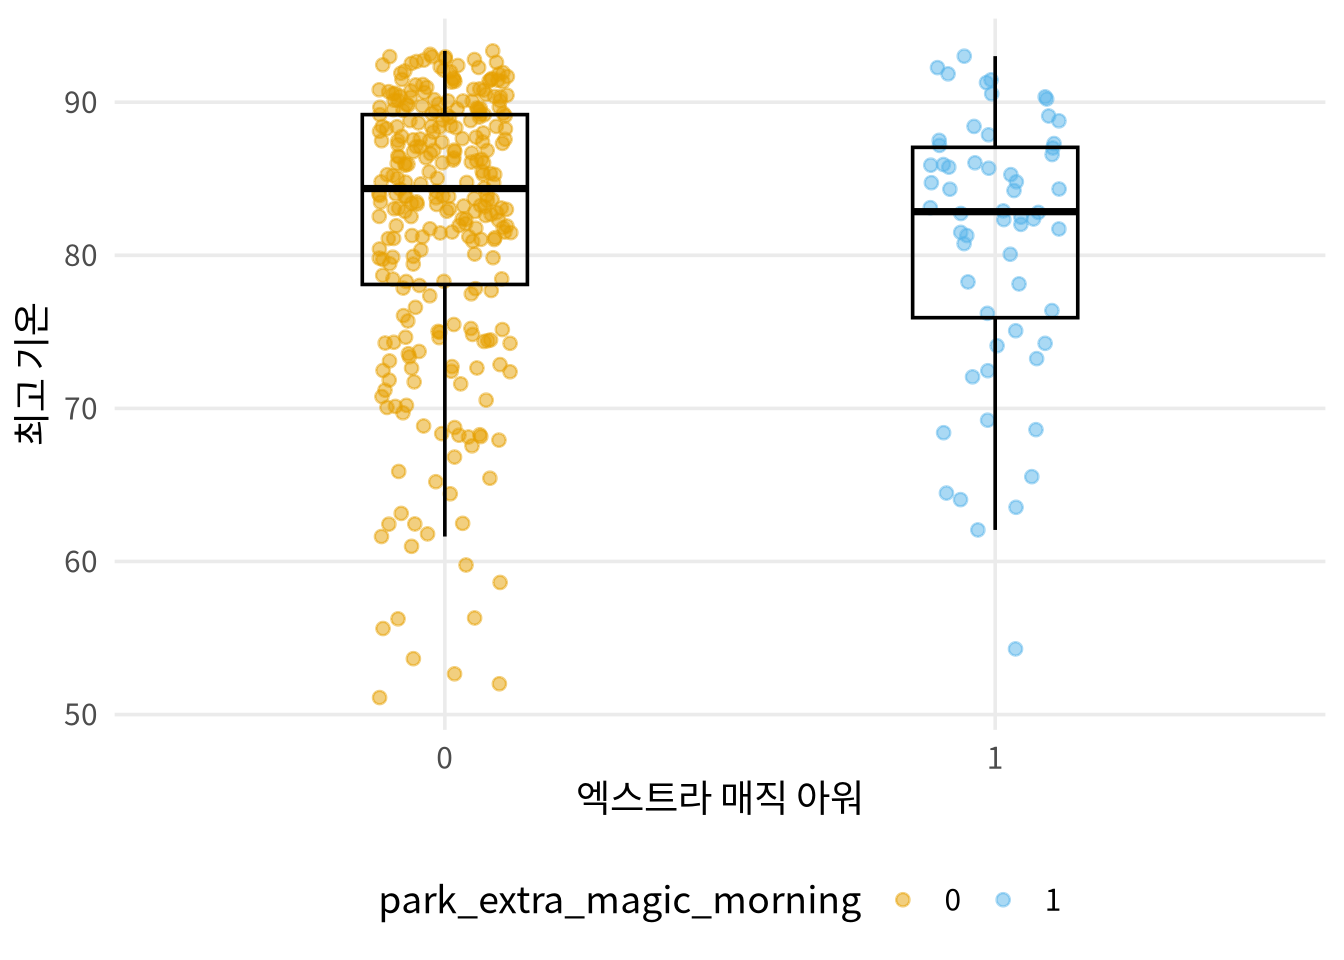
위에서 언급했듯이, 표준화된 평균 차이의 한 가지 문제는 연속형 교란 요인에 대해 단 한 지점(평균)에서의 균형 만을 정량화한다는 점입니다. 꼬리 부분에 잔차 불균형(residual imbalance)이 남아 있지 않은지 확인하기 위해 전체 분포를 시각화하는 것이 도 움이 될 수 있습니다. 먼저 박스 플롯(boxplot)을 사용해 봅시다. 예시로 park_temperature_high 변수를 사용하겠습니다. 우리는 박스 플롯을 만들 때 데이터의 이상치를 가리지 않도록 항상 점들을 그 위에 흩뿌려(jitter) 그리는 것을 선 호합니다 — 이를 위해 geom_jitter를 사용합니다. 먼저, 가중치가 적용되지 않은 박스 플롯을 만들어 보겠습니다.
ggplot(
  seven_dwarfs_9_with_wt,
  aes(
    x = factor(park_extra_magic_morning),
    y = park_temperature_high,
    color = park_extra_magic_morning
 )
) +
  geom_jitter(width = .12, height = 0, alpha = .5) +
  geom_boxplot(
    outlier.color = NA,
    fill = NA,
    width = .3,
    color = "black"
 ) +
  labs(
x = "엑스트라 매직 아워",
    y = "최고 기온"
  )
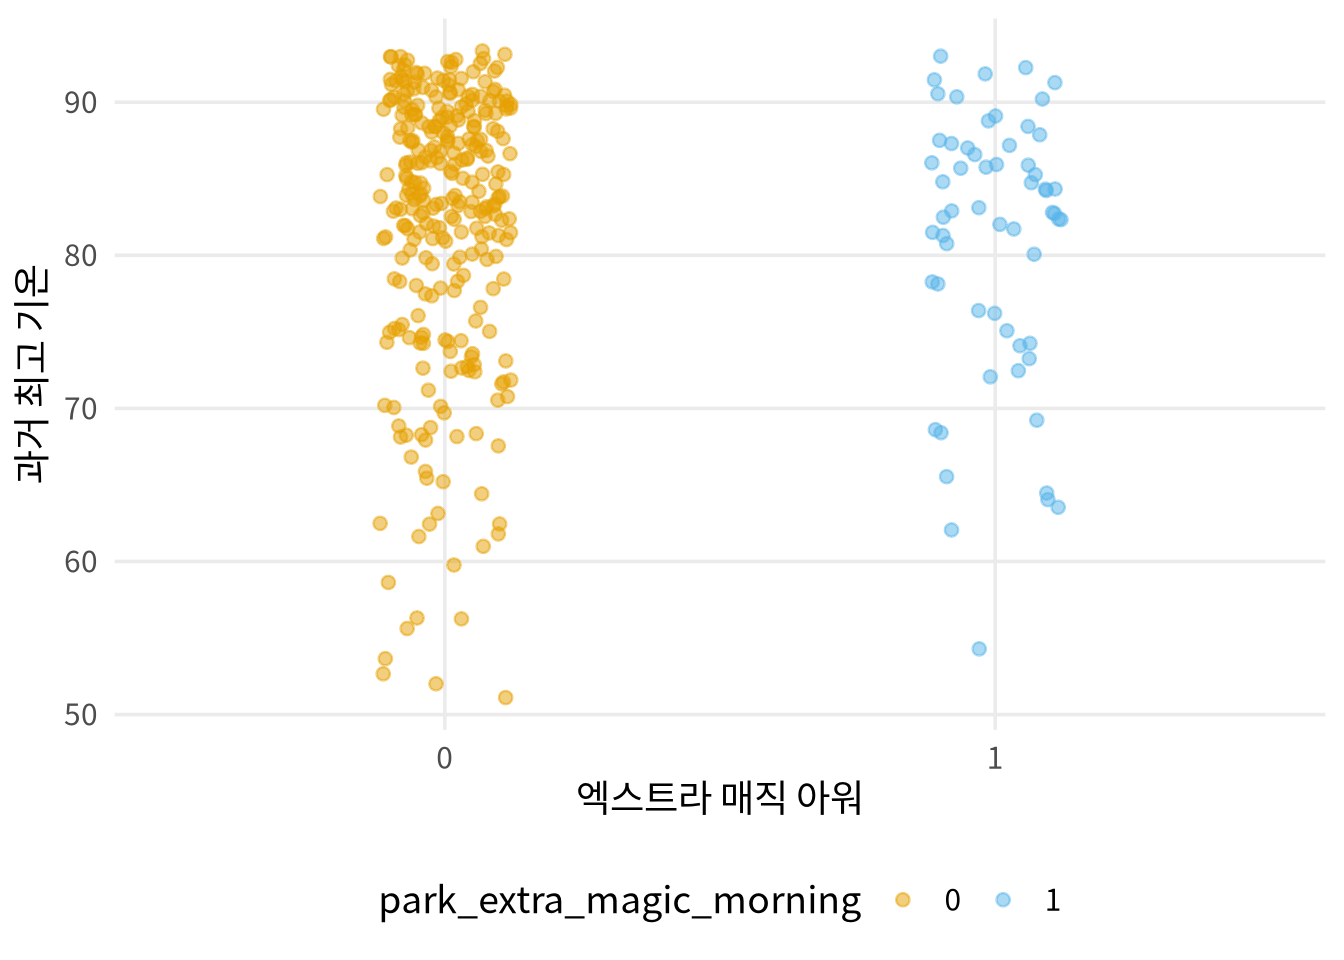
이제 가중 박스 플롯을 살펴봅시다.
ggplot(
  seven_dwarfs_9_with_wt,
  aes(
    x = factor(park_extra_magic_morning),
    y = park_temperature_high,
    color = park_extra_magic_morning,
    weight = w_ate
 )
) +
  geom_jitter(width = .12, height = 0, alpha = .5) +
  geom_boxplot(
    outlier.color = NA,
    fill = NA,
    width = .3,
    color = "black"
 ) +
  labs(
x = "엑스트라 매직 아워",
    y = "과거 최고 기온"
  )
마찬가지로, 우리는 각 노출 그룹별로 층화된 교란 요인의 경험적 누적 분포 함수(empirical cumulative distribution function, eCDF)를 살펴볼 수도 있습니다. 가중치를 적용하지 않은 eCDF는 geom_ecdf를 사용하여 시각화할 수 있습니다.
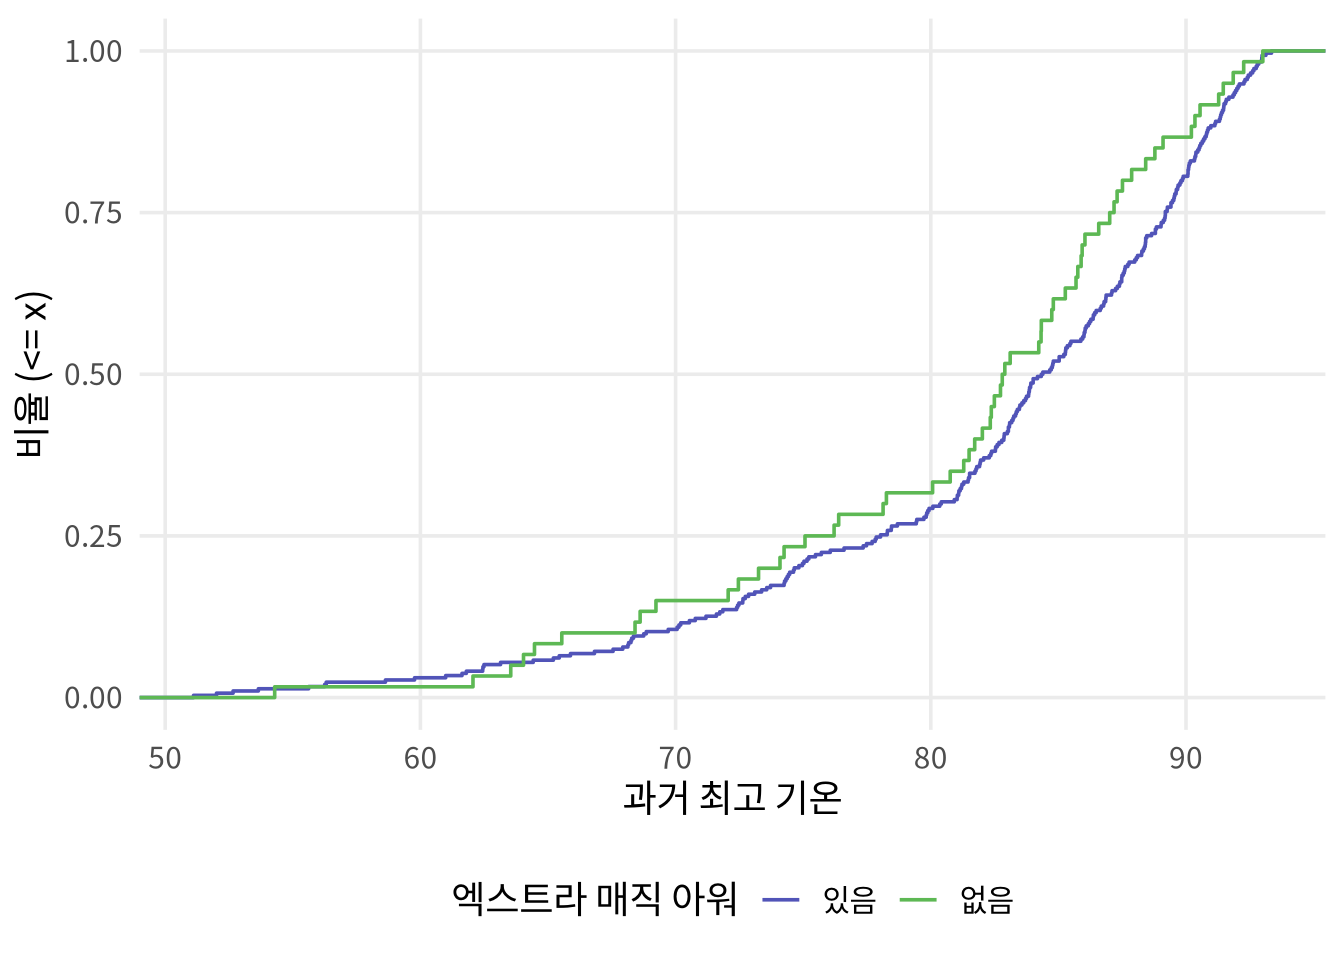
halfmoon 패키지는 geom_ecdf에 추가적인 weight 인자를 전달하여 가중치가 적용된 eCDF 그래프를 표시할 수 있게 해줍니다.
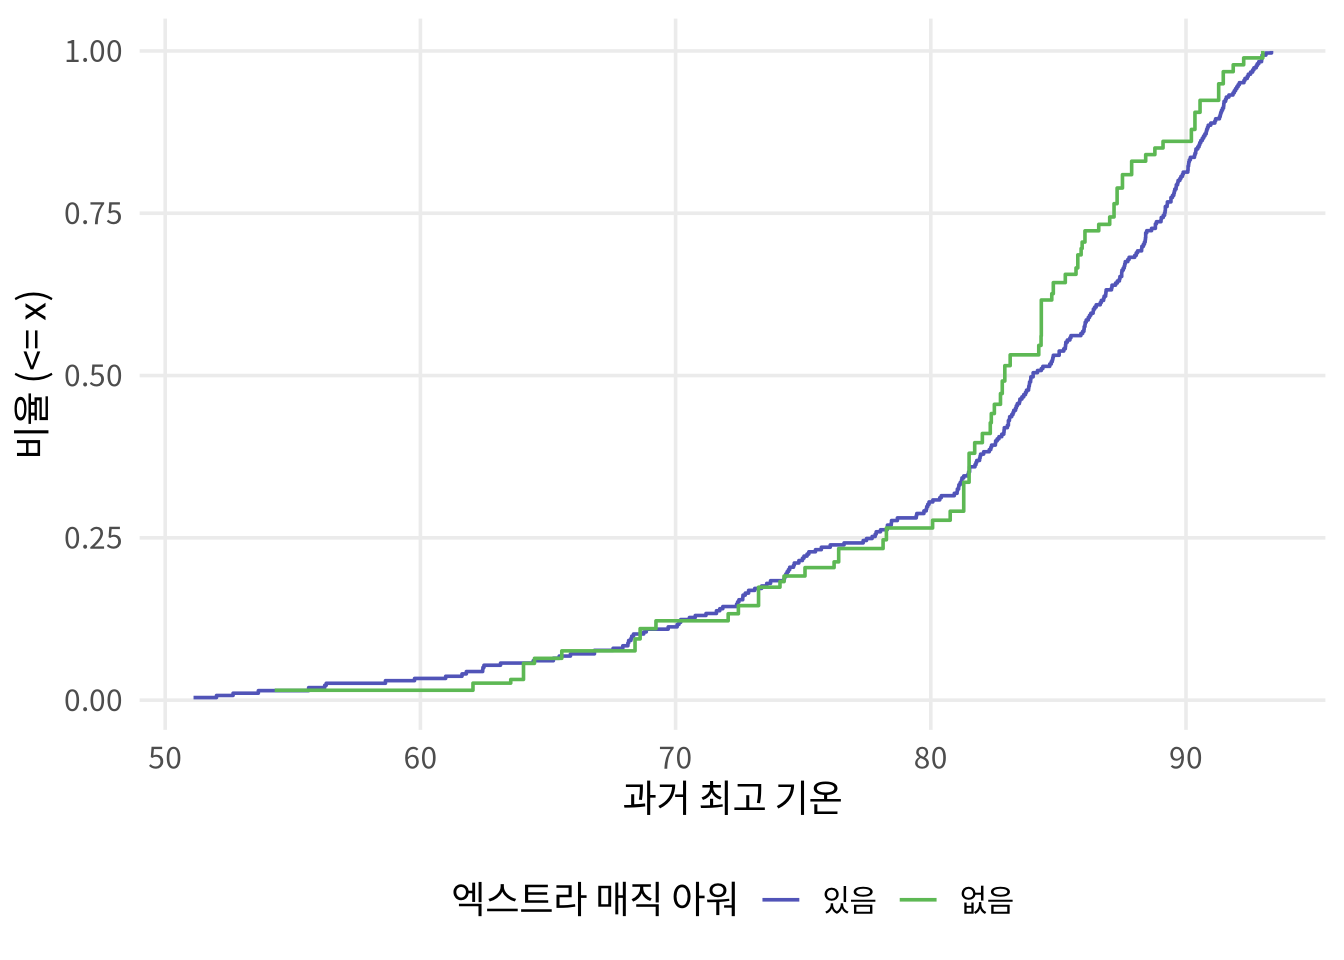
그림 9.5 를 살펴보면 몇 가지 사항을 알 수 있습니다. 첫째, 그림 9.4 와 비교했을 때 두 분포 사이의 중첩이 개선되었습니다. 그림 9.4 에서는 초록색 선이 보라색 선보다 거의 항상 뚜렷하게 위에 있는 반면, 그림 9.5 에서는 두 선이 80도를 약간 넘을 때까지 대부분 겹쳐 보입니다. 80도를 넘어서면 가중치 적용 그래프에서 두 선이 갈라지는 것처럼 보입니다. 이것이 바로 단일 요약 지표보다는 전체 분포를 살펴보는 것이 유용한 이유입니다. 만약 우리가 표준화된 평균 차이(SMD)만 사용했다면, 아마도 이 두 그룹이 균형을 이루고 있다고 말하고 넘어갔을 것입니다. 그림 9.5 를 보면 아침 엑스트라 매직 아워가 있을 확률과 과거 최고 기온 사이에 비선형 관계가 있을 수 있음을 시사합니다. 자연 스플라인(natural spline)을 사용하여 성향 점수 모델을 다시 적합시켜 봅시다. 이를 위해 splines::ns 함수를 사용할 수 있습니다.
자연 큐빅 스플라인(natural cubic splines)은 변수 사이의 복잡한 비선형 관계를 모델링하기 위해 사용되는 도구입니다. 전체 범위를 “매듭(knots)”이라고 불리는 여러 구간으로 나누고, 각 구간 내에서 3차 다항식(cubic polynomial)을 적합시킵니다. “자연(natural)”이라는 수식어는 데이터의 양 끝단 밖에서 관계가 선형이 되도록 제약을 가한다는 것을 의미하며, 이는 이상치에 대한 모델의 안정성을 높여줍니다.
seven_dwarfs_9_with_ps <-
  glm(
    park_extra_magic_morning ~ park_ticket_season + park_close +
splines::ns(park_temperature_high, df = 5), # 스플라인을 사용하여 모델 재적합
    data = seven_dwarfs_9,
    family = binomial()
 ) |>
  augment(type.predict = "response", data = seven_dwarfs_9)
seven_dwarfs_9_with_wt <- seven_dwarfs_9_with_ps |>
  mutate(w_ate = wt_ate(.fitted, park_extra_magic_morning))
이제 그것이 가중 eCDF 그래프에 어떤 영향을 미치는지 봅시다.
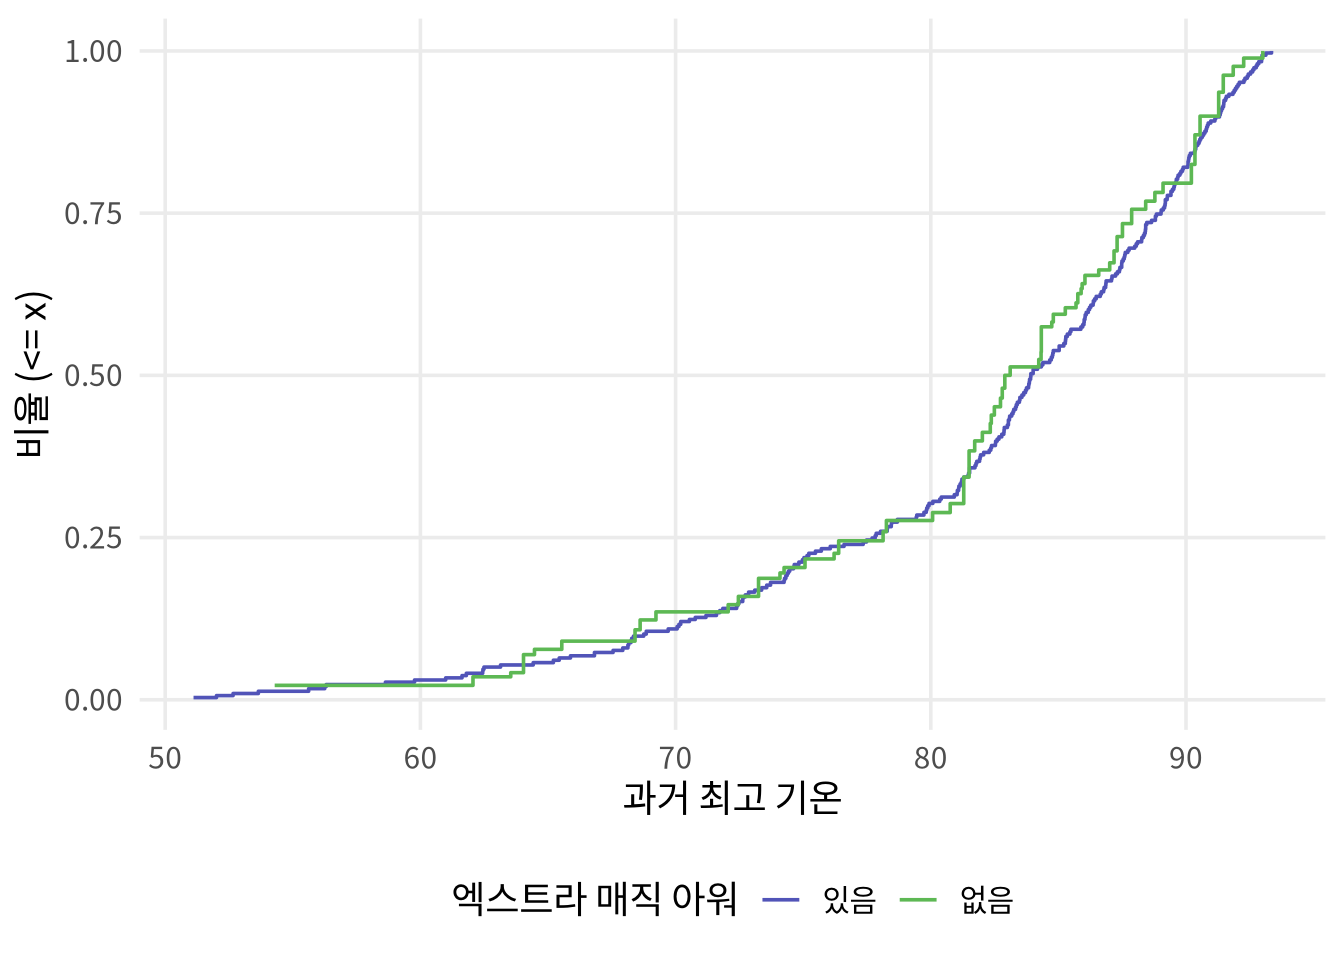
이제 그림 9.6 에서는 전체 공간에 걸쳐 선들이 겹쳐 보입니다.
대체로 예측 모델을 구축할 때 흔히 사용되는 지표들은 인과 모델을 구축하는 데 부적절합니다. 연구자와 데이터 과학자들은 종종 R2, AUC, 정확도(accuracy), 그리고 (종종 부적절하게) p-값과 같은 지표들을 사용하여 모델에 대한 결정을 내립니다. 그러나 인과 모델의 목표는 결과에 대해 가능한 한 많이 예측하는 것이 아닙니다 (Hernán 와/과 Robins 2021); 목표는 노출과 결과 사이의 관계를 정확하게 추정하는 것입니다. 인과 모델은 편향되지 않기 위해 특별히 예측을 잘 할 필요가 없습니다.
하지만 이러한 지표들은 모델의 최적의 함수 형태(functional form)를 식별하는 데 도움이 될 수 있습니다. 일반적으로 우리는 모델 자체를 구축하기 위해 DAG와 도메인 지식을 사용합니다. 그러나 교란 요인과 결과 또는 노출 사이의 수학적 관계에 대해서는 확신이 없을 수 있습니다. 예를 들어, 그 관계가 선형인지 모를 수 있습니다. 이 관계를 잘못 명시하면 잔차 교란(residual confounding)이 발생할 수 있습니다: 해당 교란 요인을 부분적으로만 통제하게 되어 추정치에 약간의 편향이 남게 될 수 있습니다. 예측 중심의 지표들을 사용하여 다양한 함수 형태를 테스트하는 것은 모델의 정확도를 높이는 데 도움이 될 수 있으며, 잠재적으로 더 나은 통제를 가능하게 합니다.
예측 모델링에서 데이터 과학자들은 종종 모델이 데이터의 우연한 패턴에 과적합되는 것을 방지해야 합니다. 모델이 그러한 우연한 패턴을 포착하면, 다른 데이터셋에 대해서는 예측력이 떨어집니다. 그렇다면 인과 모델도 과적합될 수 있을까요?
짧은 대답은 ’예’입니다. 하지만 로지스틱 회귀 등보다는 머신러닝 기술을 사용할 때 더 발생하기 쉽습니다. 과적합된 모델은 본질적으로 잘못 명시된 모델(misspecified model)입니다 (Gelman 2017). 잘못 명시된 모델은 잔차 교란으로 이어지고, 결과적으로 편향된 인과 효과를 낳게 됩니다. 과적합은 또한 확률적 긍정성 위배를 악화시킬 수 있습니다 (Zivich, Cole, 와/과 Westreich 2022). 올바른 인과 모델(데이터 생성 메커니즘과 일치하는 함수 형태)은 과적합될 수 없습니다. 이는 올바른 예측 모델의 경우에도 마찬가지입니다.
하지만 이 답변에는 몇 가지 미묘한 차이가 있습니다. 인과 추론과 예측에서의 과적합은 서로 다릅니다; 우리는 인과 추정치를 다른 데이터셋에 적용하는 것이 아니기 때문입니다(그나마 유사한 것이 운송 가능성(transportability)과 일반화 가능성(generalizability) 문제인데, 이는 Chapter 24장에서 논의할 것입니다). 인과 모델이 편향되지 않기 위해 특별히 예측을 잘 할 필요가 없다는 사실은 여전히 유효합니다.
예측 모델링에서 사람들은 외부 데이터에 대한 예측력을 높이기 위해 종종 편향-분산 트레이드오프(bias-variance trade-off)를 사용합니다. 요컨대, 모델 적합의 분산을 개선하고 외부 데이터에 대해 더 나은 예측을 하기 위해 표본에 대한 약간의 편향을 도입합니다. 그러나 우리는 주의해야 합니다: 여기서 ’편향’이라는 단어는 모델 추정치와 데이터셋 내 종속 변수의 실제 값 사이의 불일치를 나타냅니다. 이를 통계적 편향(statistical bias)이라고 부릅시다. 우리가 인과 효과에 대해 말할 때 관심을 갖는 편향(인과적 편향)은 이와 다릅니다. 인과적 편향은 우리의 추정치와 진정한 인과 효과 사이의 불일치입니다. 데이터를 더 잘 예측하기 위해 (통계적) 편향을 도입하는 것이 반드시 인과적 편향을 줄이는 것은 아니며, 실제로는 인과적 편향을 악화시킬 수도 있습니다. 따라서 우리의 목표는 항상 예측력이 아닌, 인과적 가정을 충족하고 올바른 인과 구조를 모델링하는 데 있어야 합니다.
또 다른 미묘한 점은 과적합이 표본 내 추정치의 표준 오차를 팽창시킬 수 있다는 것인데, 이는 편향-분산 트레이드오프에서의 분산과는 다릅니다 (Schuster, Lowe, 와/과 Platt 2016). 빈도주의적 관점에서 볼 때, 추정치의 인과적 편향 때문에 신뢰 구간 또한 명목상 커버리지를 갖지 못하게 될 것입니다 (부록 A 참조).
실무적으로는, 과적합을 줄이는 기술인 교차 검증(cross-validation)이 머신러닝을 사용하는 인과 모델에서 자주 사용되며, 이에 대해서는 Chapter 21 에서 논의할 것입니다.
성향 점수 매칭의 한 가지 특이한 점은, 충분한 균형을 달성한 후에도 매칭을 계속해서 솎아내면(pruning) 반대의 효과가 나타난다는 것입니다. 즉, 불균형이 오히려 증가하게 됩니다. 그 이유는 성향 점수 매칭의 경우 균형이 달성된 후에는 솎아내기 관점에서 어떤 매칭을 다른 매칭보다 선호해야 할 타당한 이유가 없기 때문입니다. 즉, 솎아내기가 무작위적으로 변하게 됩니다. 문제는 균형을 유지하기보다 잘 매칭된 쌍들을 제거할 가능성이 더 커진다는 것입니다.
그림 9.7 를 보면 캘리퍼(caliper)를 좁힐수록(매칭된 쌍의 수가 줄어듦에 따라) 처음에는 균형이 개선되다가, 캘리퍼가 0에 가까워지면 균형이 악화되는 것을 볼 수 있습니다.
library(MatchIt)
caliper_widths <- c(0.25, 0.1, 0.05, 0.025, 0.01)

check_balance_by_cal <- function(caliper) {
  match_obj <- matchit(
    park_extra_magic_morning ~
      park_ticket_season + park_close + park_temperature_high,
    data = seven_dwarfs_9,
    method = "nearest",
    caliper = caliper,
    distance = "glm"
 )

  matched_data <- match.data(match_obj)

  balance <- matched_data |>
    mutate(park_close = as.numeric(park_close)) |>
    check_balance(
      .vars = c(park_ticket_season, park_close, park_temperature_high),
      .exposure = park_extra_magic_morning
 )

  balance |>
    filter(metric == "smd") |>
    mutate(
      caliper = caliper,
      n_matched = nrow(matched_data)
 )
}

balance_by_caliper <- map(caliper_widths, check_balance_by_cal) |>
  bind_rows()

ggplot(
  balance_by_caliper,
  aes(x = caliper, y = abs(estimate), color = variable)
) +
  geom_line() +
  geom_point() +
  scale_x_reverse() +
  labs(
    x = "caliper",
    y = "smd"
 ) +
  theme(legend.position = "right")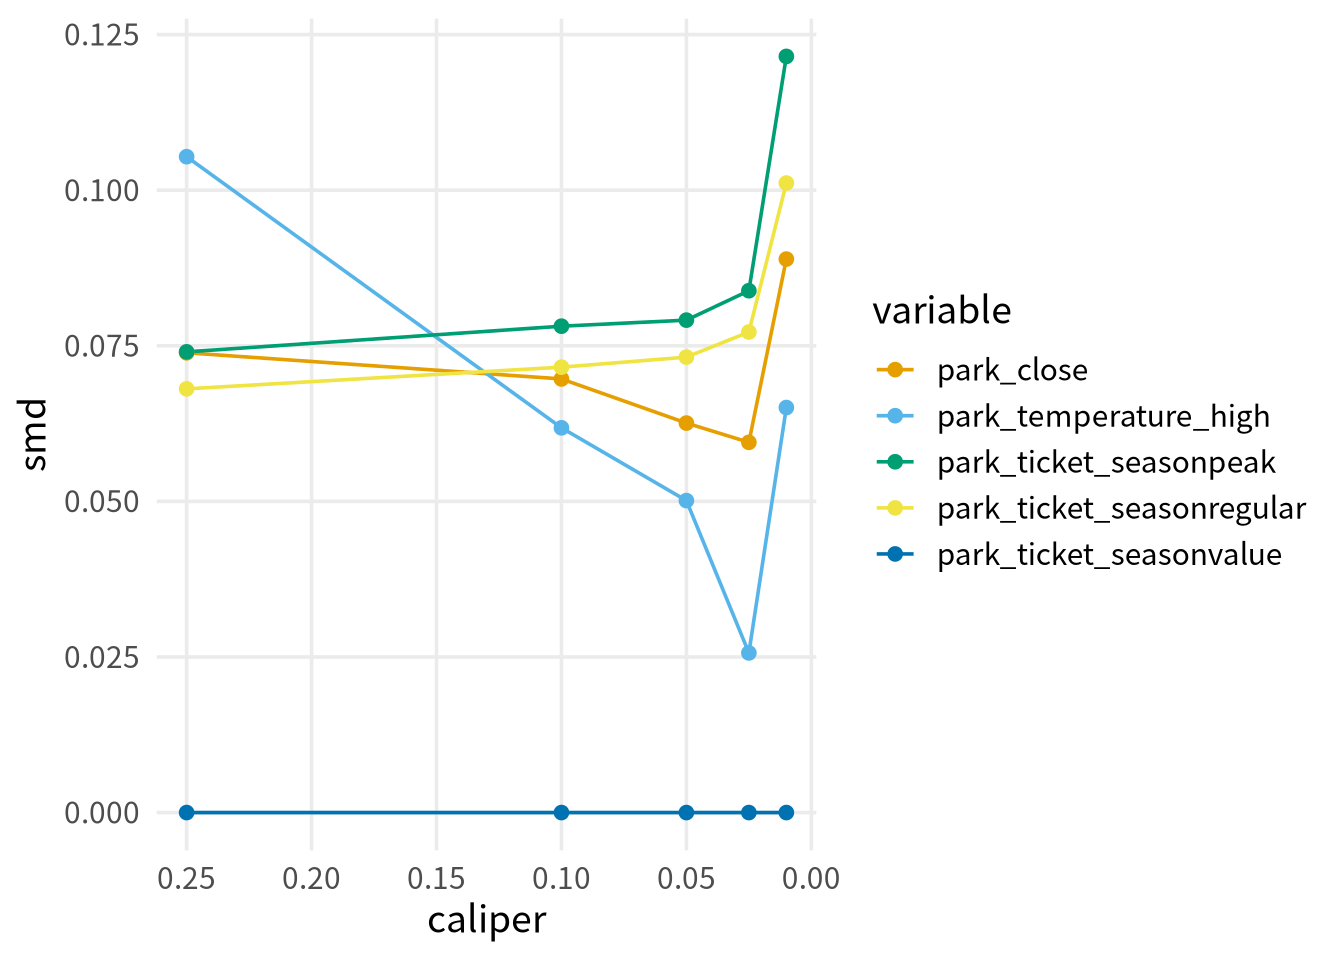
실무적으로 성향 점수 역설은 두 가지 이유로 그리 큰 문제가 되지 않습니다. 첫째, 많은 데이터셋에서 역설이 발생하기 훨씬 전에 매칭을 솎아냄으로써 균형이 개선되는 것을 확인할 수 있습니다. 둘째, 만약 캘리퍼가 너무 엄격하여 균형을 악화시킨다는 것을 알게 된다면, 간단히 덜 엄격한 캘리퍼를 사용하면 됩니다. 그렇긴 하지만, MatchIt에서 사용할 수 있는 거친 정확 매칭(coarsened exact matching)이나 마할라노비스 거리 매칭(Mahalanobis distance matching)과 같은 다른 매칭 알고리즘들은 이러한 문제를 겪지 않으므로, 만약 역설이 발생하고 있지만 계속해서 솎아내기가 필요하다고 느껴진다면 고려해 볼 만한 대안입니다. ��.