경고작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 활발히 작업 중이며 구조가 변경되거나 수정될 수 있습니다. 또한 내용이 불완전할 수 있습니다.
지금까지 이 책에서 다룬 인과 분석의 전형적인 목표를 정리해 봅시다. 연구에 참여한 모든 사람이 노출되었을 때 일어날 일과 아무도 노출되지 않았을 때 일어날 일을 추정하는 것입니다. 이를 위해 교란 요인의 균형이 잡힌 가상 인구(pseudopopulations)를 생성하는 가중치 부여 기술을 사용해 왔으며, 이는 다시 한계 결과 모델(marginal outcome models)에서 편향되지 않은 인과 효과 추정치를 제공합니다. 가중치 부여의 대안인 모수적 G-공식(parametric G-formula)은 일반적으로 다음 4단계를 거쳐 실행합니다.
적절한 시간 순서의 DAG를 그립니다(sec-dags에서 설명한 대로).
기준점(baseline) 이후 각 시점마다, DAG에서 이전에 측정된 변수를 기반으로 각 변수 값을 예측하는 모수적 모델(parametric model)을 결정합니다. 주로 연속형 변수일 때는 선형 모델을, 이진 변수일 때는 로지스틱 회귀 모델을 씁니다.
기준점의 관찰 데이터 분포에서 추출된 표본으로 시작하여 2단계 모델에 따라 이후 모든 변수 값을 생성합니다(즉, 몬테카를로 시뮬레이션을 수행합니다). 이때 한 가지를 수정합니다. 비교하려는 각 노출 체계(예: 모두 노출됨 vs 모두 노출되지 않음)에 맞춰 노출 변수를 할당합니다(즉, 시뮬레이션이 노출 변수 값을 정하게 두지 않습니다).
각 노출 그룹에서 시뮬레이션된 결과에 기반하여 관심 있는 인과적 대비(causal contrast)를 계산합니다.
몬테카를로 시뮬레이션은 무작위 프로세스에 대한 결과 표본을 생성하는 계산적 접근 방식입니다. 한 가지 예로, 두 개의 6면체 주사위를 한 번 던졌을 때 “뱀의 눈(snake eyes, 두 눈이 모두 1인 경우)”이 나올 확률을 계산하는 것이 있습니다. 우리는 이 확률을 수학적으로 확실히 계산할 수 있지만(\(\frac{1}{6}*\frac{1}{6}=\frac{1}{36}\approx 2.8\)%), 해당 프로세스에 대한 몬테카를로 시뮬레이션을 작성하는 것도 그만큼 빠를 수 있습니다(아래에 1,000,000번의 던지기 결과가 나와 있습니다).
[1] 0.02807몬테카를로 시뮬레이션은 닫힌 수학적 해(closed mathematical solutions)를 결정하기 쉽지 않은 복잡한 프로세스의 결과를 추정하는 데 매우 유용합니다. 실제로, 그것이 바로 이 책에서 설명하는 현실 세계의 인과 메커니즘에 몬테카를로 시뮬레이션이 매우 유용하게 쓰이는 이유입니다!
sec-outcome-model에서 아침 엑스트라 매직 아워가 오전 9시와 10시 사이 ‘세븐 드워프’ 놀이기구 평균 게시 대기 시간에 미치는 효과를 추정했습니다. 이를 위해 교란 요인인 park_ticket_season, park_close, park_temperature_high를 써서 노출(park_extra_magic_morning)에 대한 성향 점수 모델을 만들었습니다. 이 성향 점수들은 결과 모델을 위한 회귀 가중치로 변환됐으며, 엑스트라 매직 아워가 있을 때 오전 9시에서 10시 사이 평균 게시 대기 시간에 미치는 기대 효과가 6.2분이라는 결론을 내렸습니다.
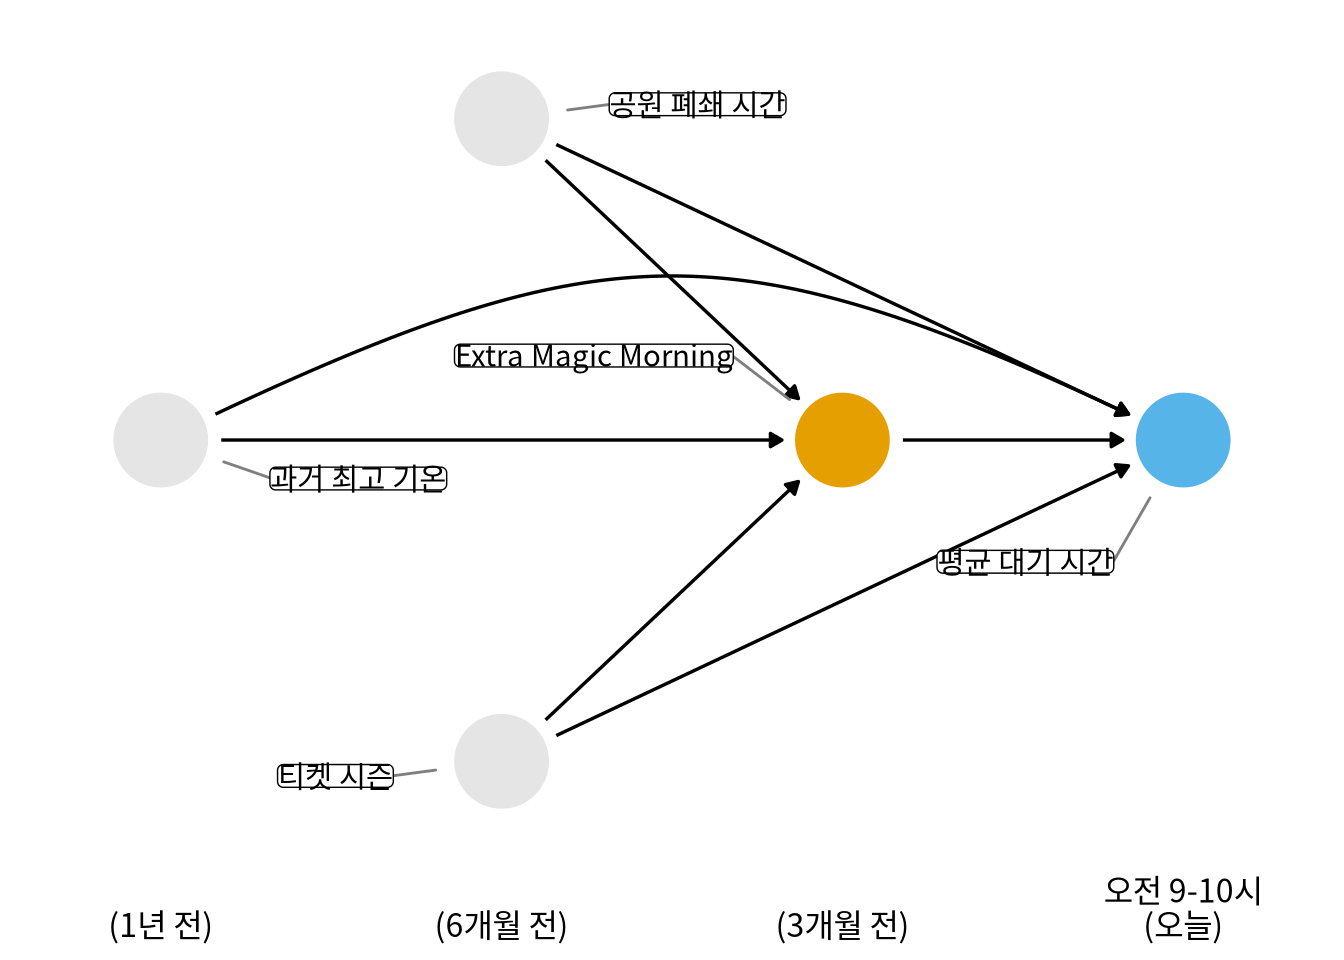
이제 g-공식 접근법으로 이 분석을 재현합니다. 위에서 설명한 4단계를 따라 이 질문과 관련된 시간 순서의 DAG를 다시 살펴보는 것부터 시작하겠습니다.
library(ggdag)
library(ggokabeito)

coord_dag <- list(
  x = c(Season = 0, close = 0, weather = -1, x = 1, y = 2),
  y = c(Season = -1, close = 1, weather = 0, x = 0, y = 0)
)

labels <- c(
  x = "Extra Magic Morning",
  y = "평균 대기 시간",
  Season = "티켓 시즌",
  weather = "과거 최고 기온",
  close = "공원 폐쇄 시간"
)

dagify(
  y ~ x + close + Season + weather,
  x ~ weather + close + Season,
  coords = coord_dag,
  labels = labels,
  exposure = "x",
  outcome = "y"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = c(rep(0, 5), .3)) +
  geom_dag_point() +
  geom_dag_label_repel(seed = 1630) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(
    legend.position = "none",
    axis.text.x = element_text()
  ) +
  coord_cartesian(clip = "off") +
  scale_x_continuous(
    limits = c(-1.25, 2.25),
    breaks = c(-1, 0, 1, 2),
    labels = c(
      "\n(1년 전)",
      "\n(6개월 전)",
      "\n(3개월 전)",
      "오전 9-10시\n(오늘)"
    )
  )
두 번째 단계는 기준점이 아닌 각 변수마다, DAG에서 이전에 측정된 변수를 기반으로 모수적 모델을 지정하는 것입니다. 이 예시는 이전 특성에 영향받는 변수가 두 개(park_extra_magic_morning, wait_minutes_posted_avg)뿐이므로 간단합니다. 두 변수에 대한 적절한 모델이 아래처럼 단순한 로지스틱 및 선형 모델이라고 가정합시다. 아직 노출(park_extra_magic_morning) 모델을 쓰지는 않겠지만, 다음 섹션(섹션 13.4)에서 보게 될 패턴의 중요한 부분이라 이 단계를 넣었습니다.
# 패키지 및 데이터 불러오기
library(broom)
library(touringplans)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9)

# park_extra_magic_morning에 대한 로지스틱 회귀
fit_extra_magic <- glm(
  park_extra_magic_morning ~
    park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9,
  family = "binomial"
)

# wait_minutes_posted_avg에 대한 선형 모델
fit_wait_minutes <- lm(
  wait_minutes_posted_avg ~
    park_extra_magic_morning +
    park_ticket_season +
    park_close +
    park_temperature_high,
  data = seven_dwarfs_9
)
다음으로, 기준점 특성들의 분포로부터 큰 샘플을 추출해야 합니다. 이 샘플의 크기를 얼마나 크게 할지는 대개 계산 자원의 가용성에 따라 결정됩니다; 샘플 크기가 클수록 시뮬레이션 오차로 인한 정밀도 손실 위험을 최소화할 수 있습니다 (Keil 기타 2014). 현재 사례에서는 크기가 10,000인 데이터 프레임을 생성하기 위해 복원 추출(sampling with replacement)을 사용할 것입니다.
# 몬테카를로 실행에서 재현성을 위해 시드를 설정하는 것이 중요합니다
set.seed(8675309)

df_sim_baseline <- seven_dwarfs_9 |>
  select(park_ticket_season, park_close, park_temperature_high) |>
  slice_sample(n = 10000, replace = TRUE)
이 모집단을 확보했으므로, 이제 방금 정의한 모수적 모델에 따라 각 후속 시점에 어떤 일이 일어날지 시뮬레이션할 수 있습니다. 3단계에서 중요한 주의 사항은, 우리가 개입하려는 변수(이 경우 park_extra_magic_morning)에 대해서는 모델이 값을 결정하도록 내버려 두지 않고, 우리가 직접 값을 설정한다는 점입니다. 구체적으로, 처음 5,000개는 park_extra_magic_morning = 1로 설정하고, 나머지 5,000개는 park_extra_magic_morning = 0으로 설정할 것입니다. 다른 시뮬레이션(이 경우 유일하게 남은 변수인 wait_minutes_posted_avg)은 예상대로 진행됩니다.
이제 남은 일은 우리가 추정하고자 하는 인과적 대비를 계산하는 것입니다. 여기서 그 대비는 엑스트라 매직 아워가 있는 아침과 없는 아침 사이의 기대 대기 시간 차이입니다.
df_outcome |>
  group_by(park_extra_magic_morning) |>
  summarize(wait_minutes = mean(wait_minutes_posted_avg))
# A tibble: 2 × 2
park_extra_magic_morning wait_minutes
<dbl> <dbl>
1 0 68.1
2 1 74.3차이가 약 6.2분(\(74.3-68.1=6.2\))임을 알 수 있는데, 이는 우리가 IP 가중치 부여를 사용했을 때 얻은 추정치인 6.2와 동일합니다.
앞서 언급했듯, G-공식의 주요 장점 중 하나는 연속형 노출을 다룰 수 있다는 점입니다. 연속형 노출은 IP 가중치 부여가 불안정한 추정치를 낼 수 있는 상황입니다. 여기서는 sec-continuous-exposures의 예시를 반복해 이를 보여줍니다. 패턴을 확장해 신뢰 구간 계산 방식을 보여주려 이 기술 실행 과정을 부트스트랩으로 감싸겠습니다.
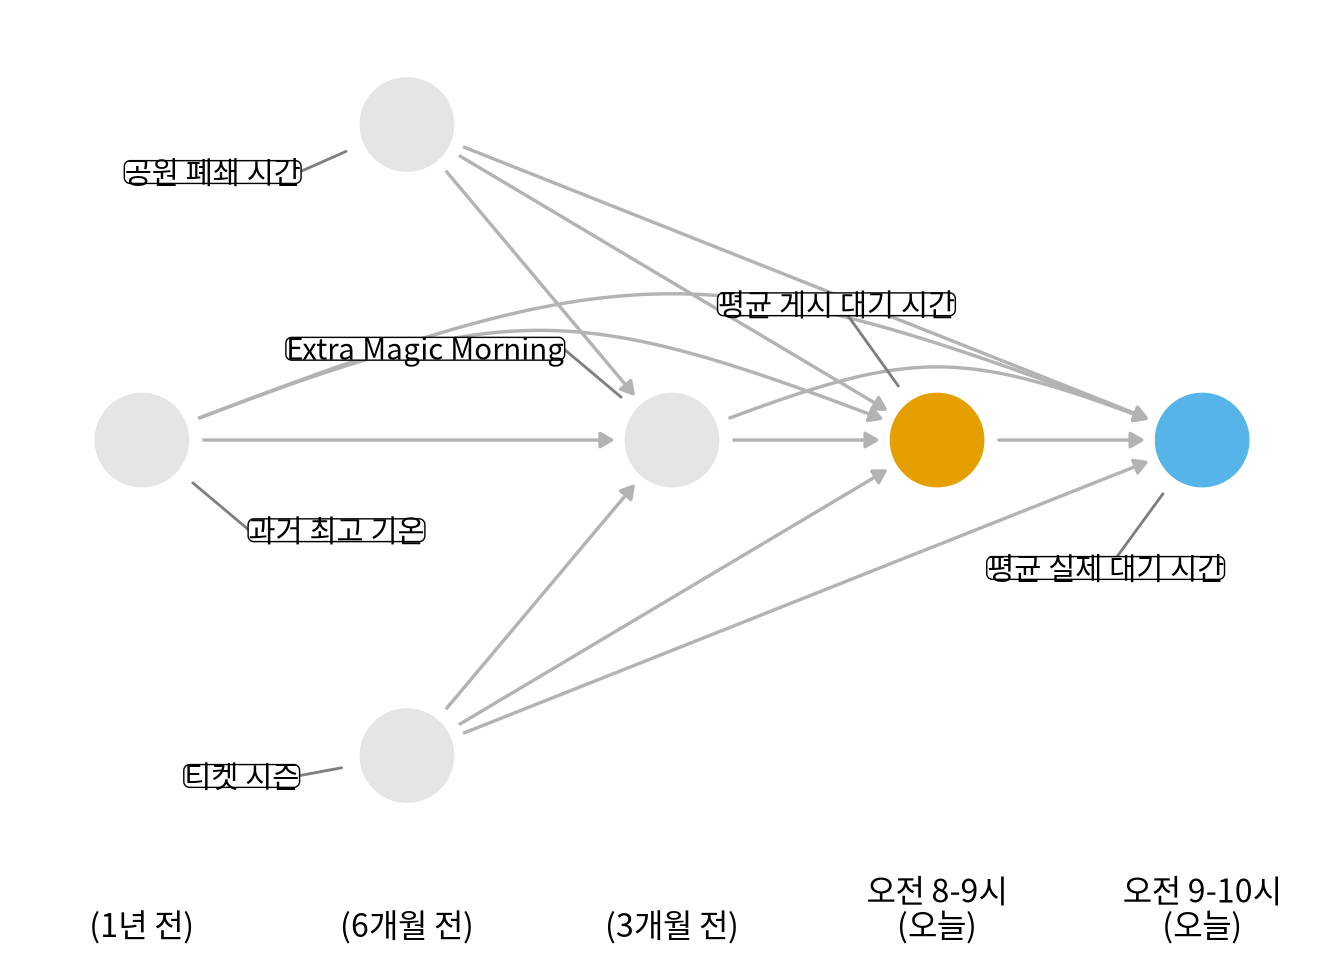
우리의 관심 있는 인과적 질문은 “오전 8시의 ‘세븐 드워프 마인 트레인’ 게시 대기 시간이 오전 9시의 실제 대기 시간에 영향을 미치는가?”였습니다. 이 질문에 대한 시간 순서의 DAG(1단계)는 다음과 같습니다:
coord_dag <- list(
  x = c(Season = -1, close = -1, weather = -2, extra = 0, x = 1, y = 2),
  y = c(Season = -1, close = 1, weather = 0, extra = 0, x = 0, y = 0)
)

labels <- c(
  extra = "Extra Magic Morning",
  x = "평균 게시 대기 시간",
  y = "평균 실제 대기 시간",
  Season = "티켓 시즌",
  weather = "과거 최고 기온",
  close = "공원 폐쇄 시간"
)

dagify(
  y ~ x + close + Season + weather + extra,
  x ~ weather + close + Season + extra,
  extra ~ weather + close + Season,
  coords = coord_dag,
  labels = labels,
  exposure = "x",
  outcome = "y"
) |>
  tidy_dagitty() |>
  node_status() |>
  ggplot(
    aes(x, y, xend = xend, yend = yend, color = status)
  ) +
  geom_dag_edges_arc(curvature = c(rep(0, 7), .2, 0, .2, .2, 0), edge_colour = "grey70") +
  geom_dag_point() +
  geom_dag_label_repel(seed = 1602) +
  scale_color_okabe_ito(na.value = "grey90") +
  theme_dag() +
  theme(
    legend.position = "none",
    axis.text.x = element_text()
  ) +
  coord_cartesian(clip = "off") +
  scale_x_continuous(
    limits = c(-2.25, 2.25),
    breaks = c(-2, -1, 0, 1, 2),
    labels = c(
      "\n(1년 전)",
      "\n(6개월 전)",
      "\n(3개월 전)",
      "오전 8-9시\n(오늘)",
      "오전 9-10시\n(오늘)"
    )
  )
2단계를 위해, 우리는 DAG에서 기준점이 아닌 변수들(즉, 화살표가 들어오는 모든 변수들)에 대한 모수적 모델을 명시해야 합니다. 이 경우, 우리는 park_extra_magic_morning, wait_minutes_posted_avg, 그리고 wait_minutes_actual_avg에 대한 모델이 필요합니다; 우리는 아래의 로지스틱 및 선형 모델들이 적절하다고 가정할 것입니다. 이전 구현에서 확장된 한 가지는, 프로세스의 각 단계를 함수 안에 포함시킬 것이라는 점입니다. 이를 통해 전체 파이프라인을 부트스트래핑하고 신뢰 구간을 얻을 수 있습니다.
library(splines)

fit_models <- function(.data) {
  # park_extra_magic_morning에 대한 로지스틱 회귀
  fit_extra_magic <- glm(
    park_extra_magic_morning ~
      park_ticket_season + park_close + park_temperature_high,
    data = .data,
    family = "binomial"
  )

  # wait_minutes_posted_avg에 대한 선형 모델
  fit_wait_minutes_posted <- lm(
    wait_minutes_posted_avg ~
      park_extra_magic_morning + park_ticket_season + park_close +
      park_temperature_high,
    data = .data
  )

  # wait_minutes_actual_avg에 대한 선형 모델
  # 더 유연하게 만들기 위해 스플라인을 추가해 봅시다.
  # 여기에는 상호작용 등 많은 옵션을 추가할 수 있지만,
  # 데이터가 충분하지 않으면 경고가 뜨거나 모델이 수렴하지 않을 수 있음에 유의하십시오.
  fit_wait_minutes_actual <- lm(
    wait_minutes_actual_avg ~
      ns(wait_minutes_posted_avg, df = 3) +
      park_extra_magic_morning +
      park_ticket_season + park_close +
      park_temperature_high,
    data = .data
  )

  # 다음 시뮬레이션 단계로 넘길 수 있도록 리스트를 반환합니다
  return(
    list(
      .data = .data,
      fit_extra_magic = fit_extra_magic,
      fit_wait_minutes_posted = fit_wait_minutes_posted,
      fit_wait_minutes_actual = fit_wait_minutes_actual
    )
  )
}
다음으로, 3단계를 수행할 함수를 작성합니다: 기준점 변수들의 무작위 표본으로부터, 우리가 정의한 모델에 따라 (개입 변수를 제외한) 모든 후속 변수의 값을 생성합니다.
# simulate_process의 인자들은 다음과 같습니다:
# fit_obj는 fit_models 함수로부터 반환된 리스트입니다
# contrast는 노출 그룹(기본값 60)과 대조 그룹(기본값 30) 설정을 제공합니다
# n_sample은 .data의 기준점 재표본 크기입니다
simulate_process <- function(
  fit_obj,
  contrast = c(60, 30),
  n_sample = 10000
) {
  # 기준점 변수들의 무작위 표본을 추출합니다
  df_baseline <- fit_obj |>
    pluck(".data") |>
    select(park_ticket_season, park_close, park_temperature_high) |>
    slice_sample(n = n_sample, replace = TRUE)

  # park_extra_magic_morning을 시뮬레이션합니다
  df_sim_time_1 <- fit_obj |>
    pluck("fit_extra_magic") |>
    augment(newdata = df_baseline, type.predict = "response") |>
    # .fitted는 park_extra_magic_morning이 1일 확률이므로,
    # 이를 사용하여 0/1 결과를 생성합니다
    mutate(
      park_extra_magic_morning = rbinom(n(), 1, .fitted)
    )

  # 개입 변수이므로 wait_minutes_posted_avg를 할당합니다
  df_sim_time_2 <- df_sim_time_1 |>
    mutate(
      wait_minutes_posted_avg =
        c(rep(contrast[1], n_sample / 2), rep(contrast[2], n_sample / 2))
    )

  # 결과를 시뮬레이션합니다
  df_outcome <- fit_obj |>
    pluck("fit_wait_minutes_actual") |>
    augment(newdata = df_sim_time_2) |>
    rename(wait_minutes_actual_avg = .fitted)

  # 대비 추정 단계로 파이프할 수 있도록 리스트를 반환합니다
  return(
    list(
      df_outcome = df_outcome,
      contrast = contrast
    )
  )
}
마지막으로 4단계에서는, 시뮬레이션된 데이터를 사용하여 요약 통계량과 관심 있는 인과적 대비를 계산합니다.
# sim_obj는 simulate_process() 함수에 의해 생성된 리스트입니다
compute_stats <- function(sim_obj) {
  exposure_val <- sim_obj |>
    pluck("contrast", 1)

  sim_obj |>
    pluck("df_outcome") |>
    group_by(wait_minutes_posted_avg) |>
    summarize(avg_wait_actual = mean(wait_minutes_actual_avg)) |>
    pivot_wider(
      names_from = wait_minutes_posted_avg,
      values_from = avg_wait_actual,
      names_prefix = "x_"
    ) |>
    summarize(
      x_60,
      x_30,
      estimate = x_60 - x_30
    )
}
이제 이 모든 것을 하나로 합쳐서 단일 점 추정치를 구해 봅시다. 그 과정을 확인한 후에는, 신뢰 구간을 얻기 위해 부트스트래핑을 수행할 것입니다.
# 우리가 던지는 인과적 질문을 반영하도록 데이터를 가공합니다
eight <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 8) |>
  select(-wait_minutes_actual_avg)

nine <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9) |>
  select(park_date, wait_minutes_actual_avg)

wait_times <- eight |>
  left_join(nine, by = "park_date") |>
  drop_na(wait_minutes_actual_avg)
# 모든 것이 계획대로 작동하는지 확인하기 위해 단일 점 추정치를 구합니다
wait_times |>
  fit_models() |>
  simulate_process() |>
  compute_stats() |>
  # rsample은 결과가 이런 식으로 이름 붙여지는 것을 선호합니다
  pivot_longer(
    names_to = "term",
    values_to = "estimate",
    cols = everything()
  )
# A tibble: 3 × 2
term estimate
<chr> <dbl>
1 x_60 29.9
2 x_30 40.6
3 estimate -10.7# 부트스트랩 신뢰 구간을 계산합니다
library(rsample)
boots <- bootstraps(wait_times, times = 1000, apparent = TRUE) |>
mutate(
models = map(
splits,
\(.x) as.data.frame(.x) |>
fit_models() |>
simulate_process() |>
compute_stats() |>
pivot_longer(
names_to = "term",
values_to = "estimate",
cols = everything()
)
)
)Warning: There was 1 warning in `mutate()`.
ℹ In argument: `models = map(...)`.
Caused by warning:
! glm.fit: fitted probabilities numerically 0 or 1 occurredresults <- int_pctl(boots, models)
results# A tibble: 3 × 6
term .lower .estimate .upper .alpha .method
<chr> <dbl> <dbl> <dbl> <dbl> <chr>
1 estimate -30.8 -10.0 11.7 0.05 percentile
2 x_30 33.1 40.6 48.8 0.05 percentile
3 x_60 14.0 30.5 47.6 0.05 percentile요약하자면, 우리의 결과는 다음과 같이 해석됩니다: 오전 8시의 게시 대기 시간을 60분으로 설정하면 오전 9시의 실제 대기 시간은 30.5분이 되는 반면, 게시 대기 시간을 30분으로 설정하면 실제 대기 시간은 이보다 더 긴 40.6분이 됩니다. 달리 말하면, 오전 8시의 게시 대기 시간을 30분에서 60분으로 늘리면 오전 9시의 실제 대기 시간은 약 10분 짧아지는 결과를 낳습니다.
우리 모델 중 하나에서 완전 분류(perfect discrimination)에 관한 경고(fitted probabilities numerically 0 or 1 occurred)가 발생했음에 유의하십시오; 이는 표본 크기가 크지 않고 모델 중 하나가 복잡성으로 인해 과하게 명시되었을 때 발생할 수 있습니다. 이 실습에서는 wait_minutes_actual_avg에 대한 회귀 모델에서 스플라인이 추가한 유연성이 문제를 일으켰습니다. 이런 일이 발생했을 때의 한 가지 해결책은 문제가 되는 모델을 단순화하는 것입니다(예: wait_minutes_actual_avg 모델을 wait_minutes_posted_avg에 대한 단순 선형 항을 포함하도록 수정하면 경고가 해결됩니다). 우리는 중소 규모의 데이터셋에서 모수적 G-공식을 사용할 때 해결해야 할 흔한 과제를 강조하기 위해 이 경고를 그대로 남겨두었습니다.