노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
우리가 어떤 것을 그 자체로만 떼어내려 할 때, 그것이 우주의 모든 것과 끊을 수 없는 수천 개의 보이지 않는 끈으로 단단히 묶여 있음을 발견하게 된다. – 존 뮤어(John Muir)
인과 다이어그램(Causal diagrams)은 답하고자 하는 질문의 인과 구조 가정을 시각화하는 도구입니다. 무작위 실험에서 인과 구조는 매우 간단합니다. 결과(outcome)에는 원인이 많을 수 있지만, 노출(exposure)의 유일한 원인은 무작위 배정 과정 그 자체입니다(그러기를 바랍니다!). 그러나 많은 비무작위 설정에서 질문 구조는 복잡한 인과 관계의 그물망일 수 있습니다. 인과 다이어그램은 우리가 생각하는 이 구조가 어떤 모습인지 전달하는 데 도움이 됩니다. 인과 구조를 투명하게 공개하는 것 외에도, 인과 다이어그램은 관측 데이터만으로도 편향되지 않은 인과 효과를 추정하는 방법을 식별하게 해주는 놀라운 수학적 속성을 가지고 있습니다. 즉, 올바르게 명시된다면 교환 가능성(exchangeability)을 달성하는 데 도움이 됩니다.
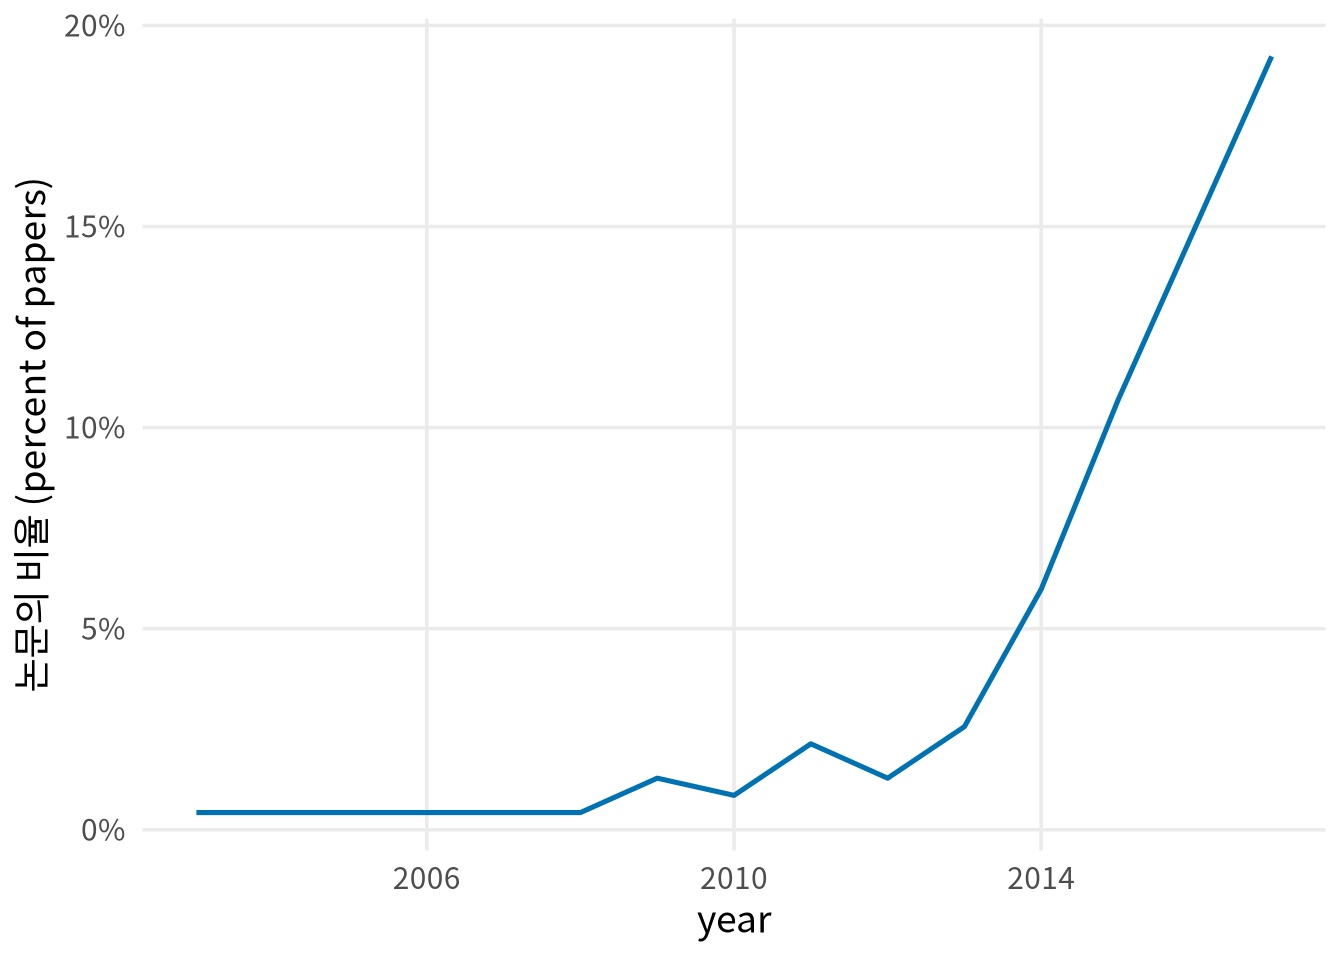
인과 다이어그램은 점점 더 보편화되고 있습니다. 응용 건강 연구 논문의 인과 다이어그램에 대한 검토 결과 수집된 데이터에 따르면, 시간이 지남에 따라 사용량이 급격히 증가하고 있음을 보여줍니다 (Tennant 기타 2020).
우리가 사용하는 인과 다이어그램의 유형은 방향성 비순환 그래프(directed acyclic graphs, DAGs)라고도 불립니다1. 이 그래프들은 특정 방향으로 향하는 화살표를 포함하기 때문에 ’방향성(directed)’입니다. 또한 ’비순환(acyclic)’인 이유는 원을 그리며 순환하지 않기 때문입니다. 예를 들어, 어떤 변수가 자기 자신의 원인이 될 수는 없습니다. DAG는 다양한 문제에 사용되지만, 우리는 특히 인과적 DAG(causal DAGs)에 관심이 있습니다. 이러한 종류의 DAG는 질문의 인과 구조에 대한 모델이기 때문에 때때로 구조적 인과 모델(Structural Causal Models, SCMs)이라고도 불립니다 (Hernán 와/과 Robins 2021; Pearl, Glymour, 와/과 Jewell 2021).
DAG는 변수들 사이의 인과 관계를 묘사합니다. 시각적으로 변수들은 에지(edges)와 노드(nodes)로 묘사됩니다. 에지는 한 변수에서 다른 변수로 가는 화살표이며, 때로는 아크(arcs) 또는 그냥 화살표라고도 합니다. 노드는 변수 그 자체이며, 때로는 정점(vertices), 점(points), 또는 그냥 변수라고도 합니다. 그림 4.2 에는 x와 y라는 두 개의 노드가 있고, x에서 y로 가는 하나의 에지가 있습니다. 여기서 우리는 x가 y를 유발한다고 말합니다. y는 x의 말을 “듣습니다” (Pearl, Glymour, 와/과 Jewell 2021).
library(ggdag)
dagify(y ~ x, coords = time_ordered_coords()) |>
  ggdag() +
  theme_dag() +
  expand_plot(expand_x = expansion(c(.2, .2)))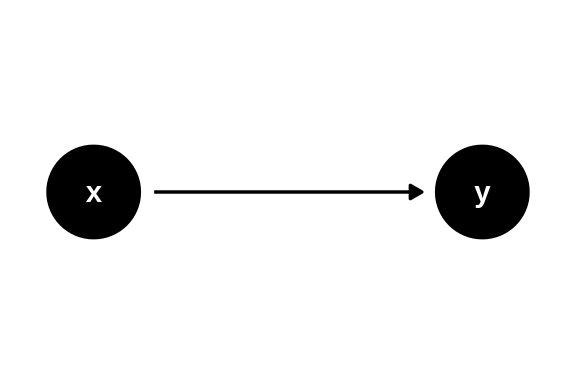
x가 y를 유발한다는 것입니다.
만약 우리가 y에 대한 x의 인과 효과에 관심이 있다면, 우리는 그 화살표의 수치적 표현을 추정하려고 노력하는 것입니다. 하지만 일반적으로 주어진 질문의 인과 구조에는 다른 많은 변수와 화살표가 있습니다. 일련의 화살표들을 경로(path)라고 부릅니다. DAG에서 볼 수 있는 경로에는 세 가지 유형이 있습니다: 포크(forks), 체인(chains), 그리고 콜라이더(colliders)(때때로 역포크라고도 함)입니다.
coords <- list(x = c(x = 0, y = 2, q = 1), y = c(x = 0, y = 0, q = 1))

fork <- dagify(
  x ~ q,
  y ~ q,
  exposure = "x",
  outcome = "y",
  coords = coords
)

chain <- dagify(
  q ~ x,
  y ~ q,
  exposure = "x",
  outcome = "y",
  coords = coords
)

collider <- dagify(
  q ~ x + y,
  exposure = "x",
  outcome = "y",
  coords = coords
)

dag_flows <- map(list(fork = fork, chain = chain, collider = collider), tidy_dagitty) |>
  map("data") |>
  list_rbind(names_to = "dag") |>
  mutate(dag = factor(dag, levels = c("fork", "chain", "collider")))

dag_flows |>
  ggplot(aes(x = x, y = y, xend = xend, yend = yend)) +
  geom_dag_edges(edge_width = 1) +
  geom_dag_point() +
  geom_dag_text() +
  facet_wrap(~dag) +
  expand_plot(
    expand_x = expansion(c(0.2, 0.2)),
    expand_y = expansion(c(0.2, 0.2))
  ) +
  theme_dag()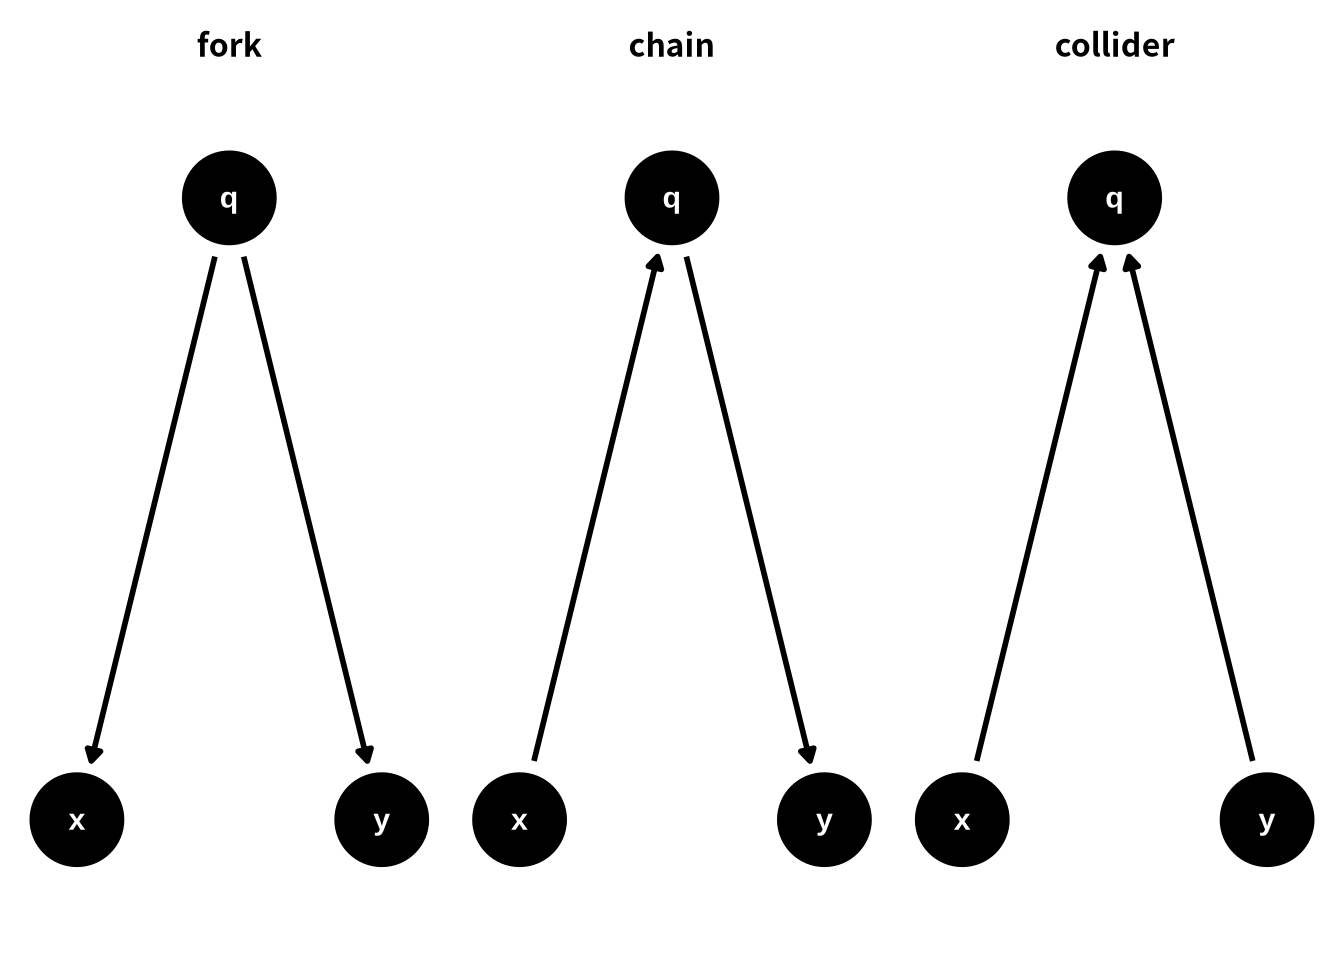
심리학 및 기타 사회과학 분야에서 흔히 사용되는 모델링 기법인 구조 방정식 모델(structural equation models, SEM)에 익숙하다면, SEM과 DAG 사이의 몇 가지 유사점을 발견할 수 있을 것입니다. DAG는 비모수적(non-parametric) SEM의 한 형태입니다. SEM은 모수적 가정을 사용하여 전체 그래프를 추정합니다. 반면, 인과적 DAG는 아무것도 추정하지 않습니다; 한 변수에서 다른 변수로 가는 화살표는 그 관계의 강도나 함수 형태에 대해 아무것도 말해주지 않으며, 단지 그 관계가 존재한다고 우리가 생각한다는 것만을 나타냅니다.
DAG의 큰 장점 중 하나는 편향의 원인을 식별하는 데 도움이 되고, 종종 이를 해결하는 방법에 대한 단서를 제공한다는 점입니다. 그러나 편향되지 않은 효과 추정치에 대해 논의하는 것은 우리가 염두에 두고 있는 구체적인 인과적 질문이 있을 때만 의미가 있습니다. 각 화살표가 원인을 나타내므로, 이는 끝까지 인과 관계입니다; 어떤 개별 화살표도 본질적으로 문제가 되지는 않습니다. 여기서 우리는 y에 대한 x의 효과에 관심이 있습니다. 이 질문은 우리가 어떤 경로에 관심이 있고 어떤 경로에 관심이 없는지를 정의합니다.
이 세 가지 유형의 경로는 x와 y 사이의 통계적 관계에 대해 서로 다른 함의를 갖습니다. 이러한 가정 하에서 두 변수 사이의 상관관계만 본다면 다음과 같습니다:
x와 y는 x에서 y로 가는 화살표가 없음에도 불구하고 서로 연관될 것입니다.x와 y는 오직 q를 통해서만 관련됩니다.x와 y는 서로 관련되지 않을 것입니다.연관성(association)을 전달하는 경로를 열린 경로(open paths)라고 부릅시다. 연관성을 전달하지 않는 경로를 닫힌 경로(closed paths)라고 부릅시다. 포크와 체인은 열려 있는 반면, 콜라이더는 닫혀 있습니다.
그렇다면 q를 조정해야 할까요? 그것은 경로의 성격에 달려 있습니다. 포크는 교란 경로(confounding paths)입니다. q가 x와 y 모두를 유발하기 때문에, x와 y는 허위 연관성(spurious association)을 갖게 됩니다. 그들은 둘 다 공통 원인인 q로부터의 정보를 포함하고 있습니다. 그 공통된 인과 관계가 x와 y를 통계적으로 연관되게 만듭니다. q를 조정하면 교란으로 인한 편향을 차단(block)하고 x와 y 사이의 진정한 관계를 얻을 수 있습니다.
우리는 변수를 고려하기 위해 다양한 기술을 사용할 수 있습니다. 우리는 우리가 관심 없는 변수의 효과를 제거하는 모든 기술을 지칭하기 위해 “조정(adjustment)” 또는 “통제(controlling for)”라는 용어를 사용합니다.
그림 4.4 는 이 효과를 시각적으로 묘사합니다. 여기서 x와 y는 연속형이며, DAG의 정의에 따라 서로 관련이 없습니다. 그러나 q는 둘 모두를 유발합니다. 조정되지 않은 효과는 q를 통해 x에서 y로 이어지는 열린 경로에 대한 정보를 포함하고 있기 때문에 편향되어 있습니다. 그러나 q의 수준 내에서는 x와 y가 서로 관련이 없습니다.
set.seed(123)
library(patchwork)
n <- 1000

### q
q <- rbinom(n, size = 1, prob = .35)
###

### x
x <- 2 * q + rnorm(n)
###

### y
y <- -3 * q + rnorm(n)
###

confounder_data <- tibble(x, y, q = as.factor(q))

p1 <- confounder_data |>
  ggplot(aes(x, y)) +
  geom_point(alpha = .2) +
  geom_smooth(method = "lm", se = FALSE, color = "black") +
  facet_wrap(~"not adjusting for `q`\n(biased)")

p2 <- confounder_data |>
  ggplot(aes(x, y, color = q)) +
  geom_point(alpha = .2) +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~"adjusting for `q`\n(unbiased)")

p1 + p2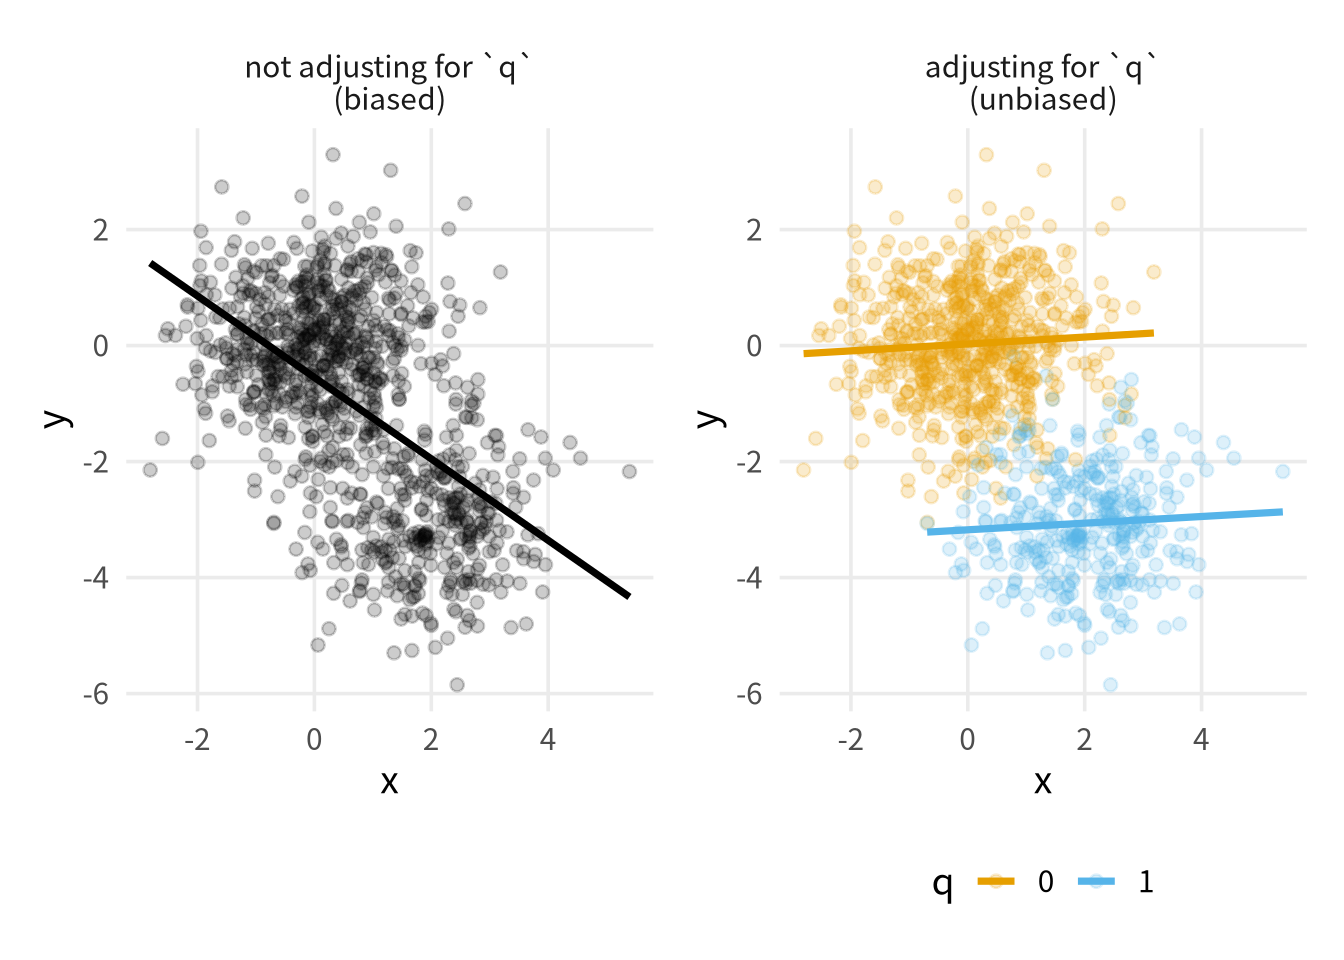
x와 y 사이 관계를 나타낸 두 산점도. 포크의 경우, 관계는 q에 의해 편향됩니다. q를 고려하면 진정한 무효 관계를 볼 수 있습니다.
체인의 경우, 매개 요인을 조정할지 여부는 연구 질문에 따라 달라집니다. 여기서 q를 조정하면 y대한 x의 효과가 무효(null)로 추정될 것입니다. y에 대한 x의 유일한 효과가 q를 통한 것이기 때문에, 다른 효과는 남지 않기 때문입니다. q에 의해 매개되는 y에 대한 x의 효과를 간접 효과(indirect effect)라고 부르며, y에 대한 x의 직접적인 효과를 직접 효과(direct effect)라고 부릅니다. 만약 우리가 직접 효과에만 관심이 있다면, q를 통제하는 것이 우리가 원하는 것일 수 있습니다. 만약 우리가 두 효과 모두를 알고 싶다면, q를 조정하려고 해서는 안 됩니다. 이러한 매개 효과 및 다른 매개 효과들을 추정하는 방법은 장 17 에서 더 자세히 배울 것입니다.
그림 4.5 는 이 효과를 시각적으로 보여줍니다. 조정되지 않은 y에 대한 x의 효과는 총 효과(total effect)를 나타냅니다. 총 효과는 전적으로 q에 의해 매개되는 경로 때문이므로, q를 조정하면 더 이상 관계가 남지 않습니다. 이 무효 효과(null effect)가 직접 효과입니다. 이 두 효과 중 어느 것도 편향에 의한 것은 아니며, 각각 서로 다른 연구 질문에 답하는 것입니다.
### x
x <- rnorm(n)
###

### q
linear_pred <- 2 * x + rnorm(n)
prob <- 1 / (1 + exp(-linear_pred))
q <- rbinom(n, size = 1, prob = prob)
###

### y
y <- 2 * q + rnorm(n)
###

mediator_data <- tibble(x, y, q = as.factor(q))

p1 <- mediator_data |>
  ggplot(aes(x, y)) +
  geom_point(alpha = .2) +
  geom_smooth(method = "lm", se = FALSE, color = "black") +
  facet_wrap(~"`q`를 조정하지 않음\n(총 효과)")

p2 <- mediator_data |>
  ggplot(aes(x, y, color = q)) +
  geom_point(alpha = .2) +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~"`q`를 조정함\n(직접 효과)")

p1 + p2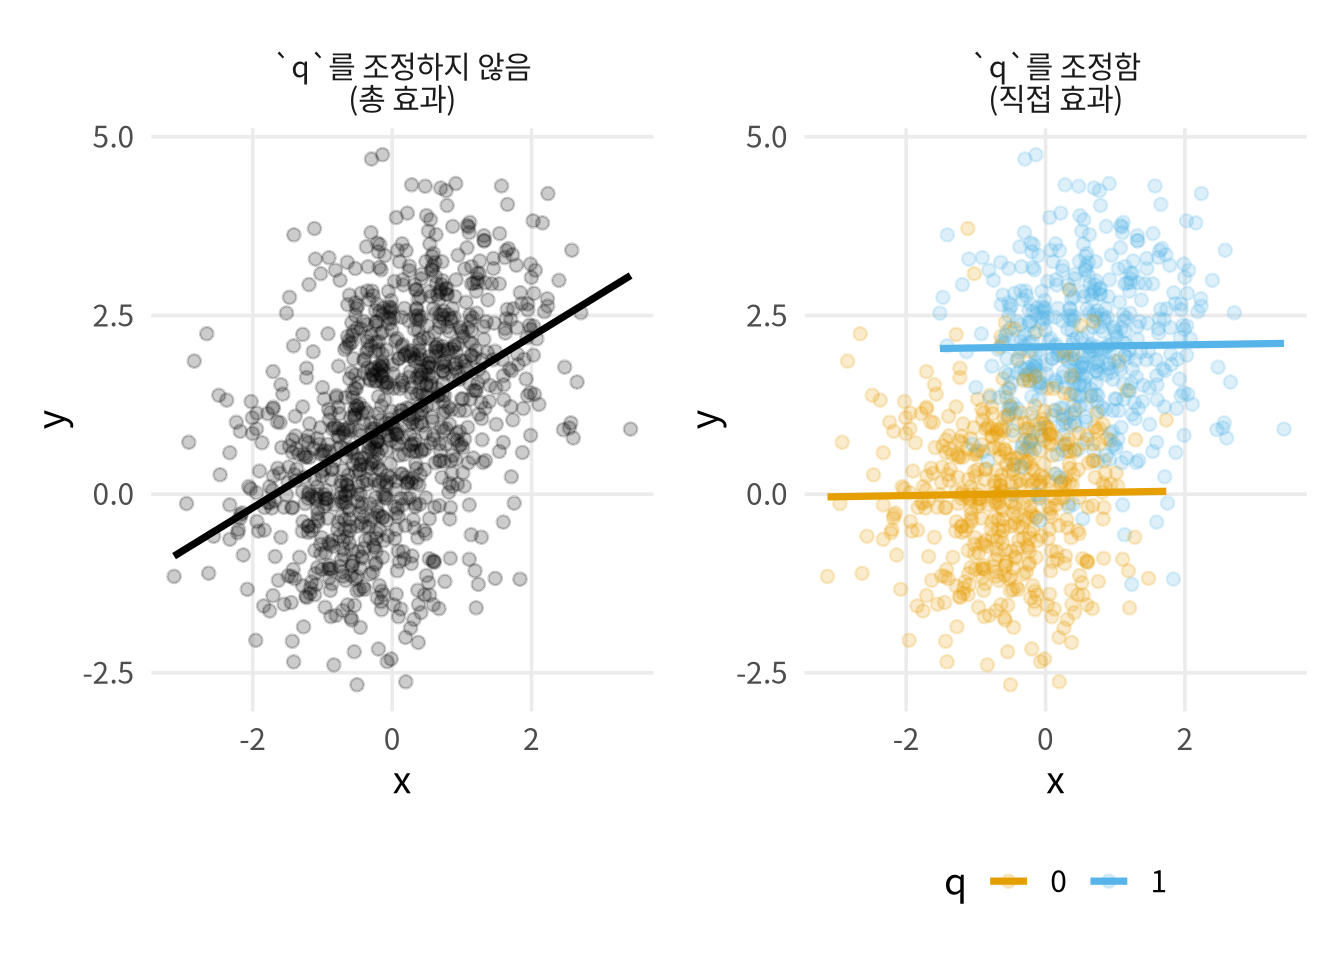
x와 y 사이의 관계를 나타낸 두 개의 산점도. 체인의 경우, q를 고려해야 할지 여부와 그 방법은 연구 질문에 따라 달라집니다. 고려하지 않을 경우, q를 통한 간접 효과를 포함하여 x와 y의 총 효과의 영향을 보게 됩니다. q를 고려할 경우, y에 대한 x의 직접(무효) 효과를 보게 됩니다.
시각적으로, x와 y가 연속형이고 q가 이진형일 때 이런 현상이 일어나는 것을 볼 수 있습니다. 그림 4.6 에서, q를 포함하지 않을 때 우리는 x와 y 사이에 아무런 관계도 발견하지 못합니다. 그것이 올바른 결과입니다. 그러나 q를 포함하면 x와 y 모두에 대한 정보를 감지할 수 있으며, 그들은 상관관계가 있는 것처럼 보입니다: x의 각 수준에서 q = 0인 사람들은 더 낮은 수준의 y를 갖습니다. 연관성이 마치 시간을 거꾸로 거슬러 흐르는 것처럼 보입니다. 물론 인과적 관점에서는 그런 일이 일어날 수 없으므로, q를 통제하는 것은 잘못된 일입니다. 결국 우리는 y에 대한 x의 효과에 대해 편향된 결과를 얻게 됩니다.
#|
### x
x <- rnorm(n)
###

### y
y <- rnorm(n)
###

### q
linear_pred <- 2 * x + 3 * y + rnorm(n)
prob <- 1 / (1 + exp(-linear_pred))
q <- rbinom(n, size = 1, prob = prob)
###

collider_data <- tibble(x, y, q = as.factor(q))

p1 <- collider_data |>
  ggplot(aes(x, y)) +
  geom_point(alpha = .2) +
  geom_smooth(method = "lm", se = FALSE, color = "black") +
  facet_wrap(~"`q`를 조정하지 않음\n(편향되지 않음)")

p2 <- collider_data |>
  ggplot(aes(x, y, color = q)) +
  geom_point(alpha = .2) +
  geom_smooth(method = "lm", se = FALSE, color = "black") +
  facet_wrap(~"`q`를 조정함\n(편향됨)")

p1 + p2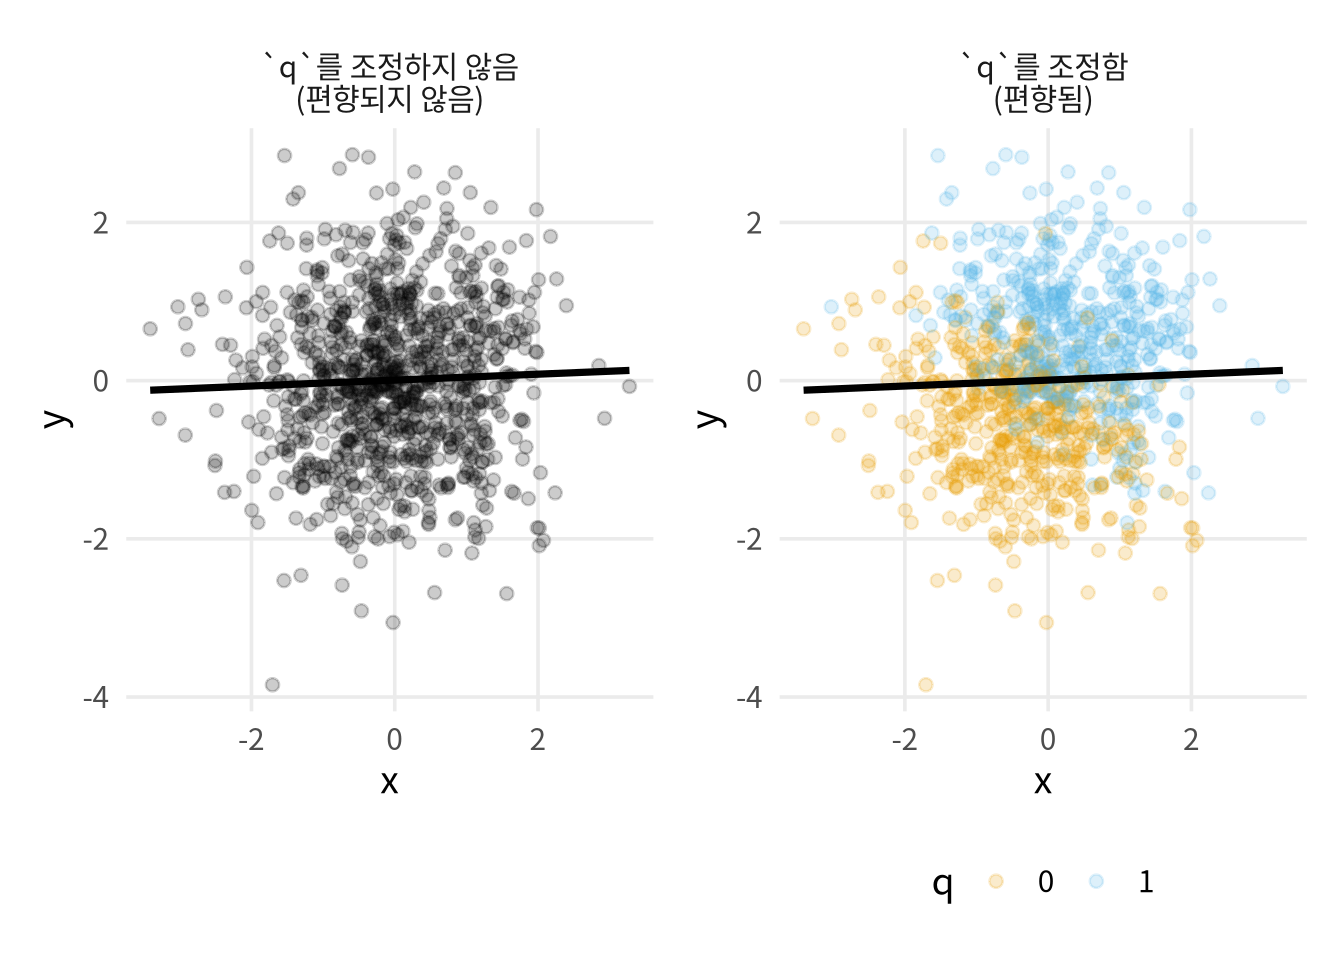
x와 y 사이의 관계를 나타낸 두 개의 산점도. 둘 사이의 조정되지 않은 관계는 편향되지 않았습니다. q를 고려할 때, 우리는 콜라이더 백도어 경로를 열게 되어 x와 y 사이의 관계를 편향시킵니다.
어떻게 이런 일이 일어날 수 있을까요? x와 y가 q보다 먼저 발생하기 때문에, q는 그들에게 영향을 미칠 수 없습니다. DAG를 옆으로 돌려서 그림 4.7 을 고려해 봅시다. 두 시점으로 나누어 보면, 시점 1에서 q는 아직 발생하지 않았고 x와 y는 서로 관련이 없습니다. 시점 2에서 q는 x와 y로 인해 발생합니다. 하지만 인과 관계는 오직 시간상 앞으로만 나아갑니다. 나중에 발생하는 q가 과거에 x와 y가 독립적으로 발생했다는 사실을 바꿀 수는 없습니다.
coords <- list(x = c(x = 0, y = 2, q = 1), y = c(x = 0, y = 0, q = -1))
collider <- dagify(
  q ~ x + y,
  exposure = "x",
  outcome = "y",
  coords = time_ordered_coords()
)

collider_t <- collider |>
  tidy_dagitty() |>
  mutate(time = "시점 1", direction = NA, to = NA) |>
  filter(name != "q")

t2 <- collider |>
  tidy_dagitty() |>
  mutate(time = "시점 2") |>
  pull_dag_data()

collider_t$data <- bind_rows(collider_t$data, t2)

collider_t |>
  mutate(deemphasize = (name %in% c("x", "y") & time ==
    "시점 2")) |>
  ggplot(aes(x = x, y = y, xend = xend, yend = yend)) +
  geom_dag_edges(edge_width = 1, edge_color = "grey85") +
  geom_dag_point(aes(color = deemphasize), show.legend = FALSE) +
  geom_dag_text() +
  facet_wrap(~time) +
  theme_dag() +
  scale_color_manual(values = c("TRUE" = "grey85", "FALSE" = "black"))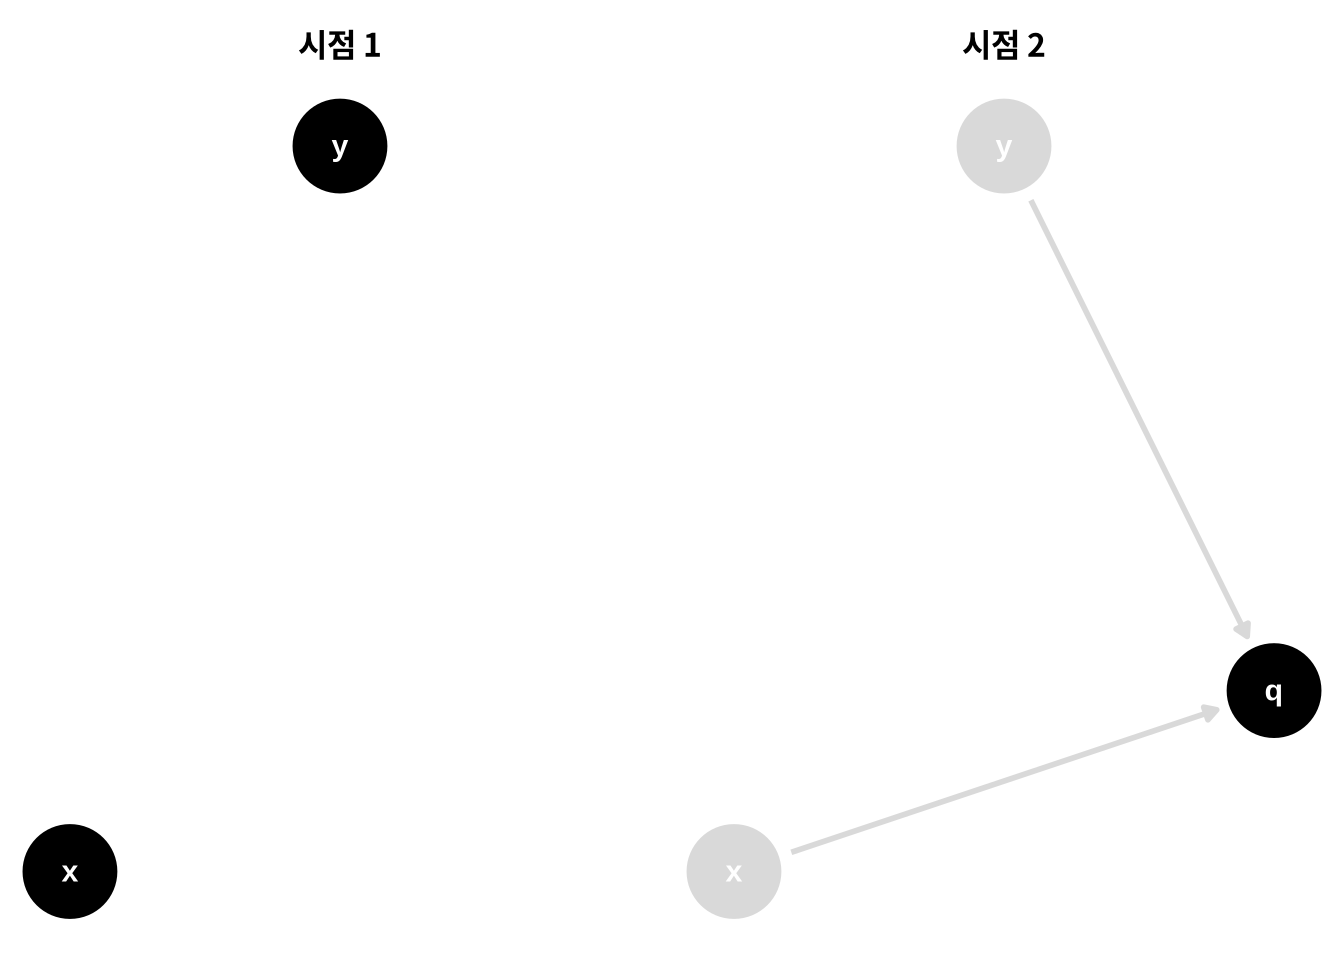
x와 y 사이에 아무런 관계가 없습니다. 시점 2까지 둘 다 q를 유발하지만, 이것이 시점 1에서 이미 일어난 일을 바꾸지는 않습니다.
인과 관계는 오직 앞으로만 나아갑니다. 그러나 연관성(association)은 시간에 구애받지 않습니다. 그것은 단지 변수들 사이의 수치적 관계에 대한 관찰일 뿐입니다. 우리가 미래를 통제할 때, 우리는 편향을 도입할 위험이 있습니다. 이에 대한 직관을 기르는 데는 시간이 걸립니다. x와 y가 q를 유발하는 유일한 원인이고 세 변수 모두 이진 변수인 경우를 생각해 보십시오. x 또는 y 중 하나가 1일 때 q가 발생합니다. 만약 우리가 q = 1이고 x = 0이라는 것을 안다면, 논리적으로 y = 1임에 틀림없습니다. 따라서 q에 대해 아는 것은 x를 통해 y에 대한 정보를 제공합니다. 이 예시는 극단적이지만, 때때로 콜라이더 층화 편향(collider-stratification bias) 또는 선택 편향(selection bias)이라고 불리는 이 유형의 편향이 어떻게 발생하는지를 보여줍니다: q에 대한 조건부화(conditioning)는 x와 y에 대한 통계적 정보를 제공하고 그들의 관계를 왜곡합니다 (Banack 기타 2023).
우리는 흔히 교환 가능성을 교란이 없다는 가정으로 언급합니다. 사실 이는 완전히 정확한 표현은 아닙니다. 잠재적 결과의 교환 가능성을 위해서는 열린 비인과적 경로(open, non-causal paths)가 없어야 합니다 (Hernán 와/과 Robins 2021). 대부분의 경우 이들은 교란 경로입니다. 그러나 콜라이더에 대한 조건부화 또한 경로를 열 수 있습니다. 이들은 교란 요인이 아님에도 불구하고, 그렇게 함으로써 두 그룹 사이에 비교환 가능성(non-exchangeability)을 생성합니다: 그들은 노출과 결과에 중요한 방식으로 서로 다릅니다.
열린 비인과적 경로를 백도어 경로(backdoor paths)라고도 부릅니다. 우리는 이 용어를 자주 사용할 것인데, 그 이유는 우리가 추정하고자 하는 효과를 편향시키는 모든 열린 경로를 잘 포착하기 때문입니다.
따라서 노출과 결과 사이의 인과 구조를 올바르게 식별하는 것은 1) 변수들 사이의 관계에 대해 우리가 내리는 가정을 전달하고 2) 편향의 원인을 식별하는 데 도움이 됩니다. 중요하게도, 2)를 수행함으로써 우리는 종종 1)의 가정을 바탕으로 편향을 방지하는 방법을 식별할 수도 있습니다. 그림 4.3 에 있는 세 가지 DAG의 단순한 사례에서, 우리는 인과 구조의 성격에 따라 q를 통제해야 할지 말아야 할지를 알 수 있습니다. 우리가 조정해야 할 변수들의 집합을 조정 집합(adjustment set)이라고 부릅니다. DAG는 복잡한 설정에서도 조정 집합을 식별하는 데 도움을 줄 수 있습니다 (Zander, Liśkiewicz, 와/과 Textor 2019).
DAG는 추론의 중요한 부분임에도 불구하고 상호작용(interaction)이나 효과 추정치 수정(effect estimate modification)에 대해 직접적으로 언급하지 않습니다. 엄밀히 말하면, 상호작용은 DAG에 있는 관계들의 함수 형태(functional form)의 문제입니다. 우리가 DAG에서 변수를 어떻게 모델링할지(예: 스플라인 사용) 명시할 필요가 없는 것처럼, 변수들이 통계적으로 어떻게 상호작용하는지 결정할 필요도 없습니다. 그것은 모델링 단계의 문제입니다.
우리는 인과 추론에서 여러 방식으로 상호작용을 사용합니다. 한 극단적인 경우로, 상호작용은 단순히 함수 형태의 문제입니다: 상호작용 항이 모델에 포함되지만 전체적인 인과 효과를 얻기 위해 한계화(marginalized)됩니다. 반대로, 우리는 상호작용하는 두 변수가 모두 원인인 결합 인과 효과(joint causal effects)에 관심이 있을 수 있습니다. 그 중간 지점에서, 우리는 인과적이라고 가정되지 않는 두 번째 변수에 따라 달라지는 이질적 인과 효과(heterogeneous causal effects)를 식별하기 위해 상호작용 항을 사용할 수 있습니다. 인과 추론의 많은 도구들과 마찬가지로, 우리는 동일한 통계적 기술을 서로 다른 질문에 답하기 위해 여러 방식으로 사용합니다. 우리는 Chapter 14 에서 이 주제를 자세히 다시 다룰 것입니다.
많은 사람들이 다양한 유형의 아크, 노드 및 기타 주석을 사용하여 DAG에서 상호작용을 표현하려고 시도했지만, 선호되는 방식으로 정착된 접근법은 아직 없습니다 (Weinberg 2007; Nilsson 기타 2020).
R에서의 예시를 살펴보겠습니다. 우리는 DAG를 구축하고, 시각화하며, 조정 집합과 같은 중요한 정보를 식별하는 방법을 배울 것입니다.
먼저, 다음과 같은 연구 질문을 고려해 봅시다: 시험 전날 아침에 코미디 팟캐스트를 듣는 것이 대학원생들의 시험 점수를 향상시키는가? 우리는 섹션 1.2 (그림 4.8)에서 설명한 방법을 사용하여 이를 도식화할 수 있습니다.
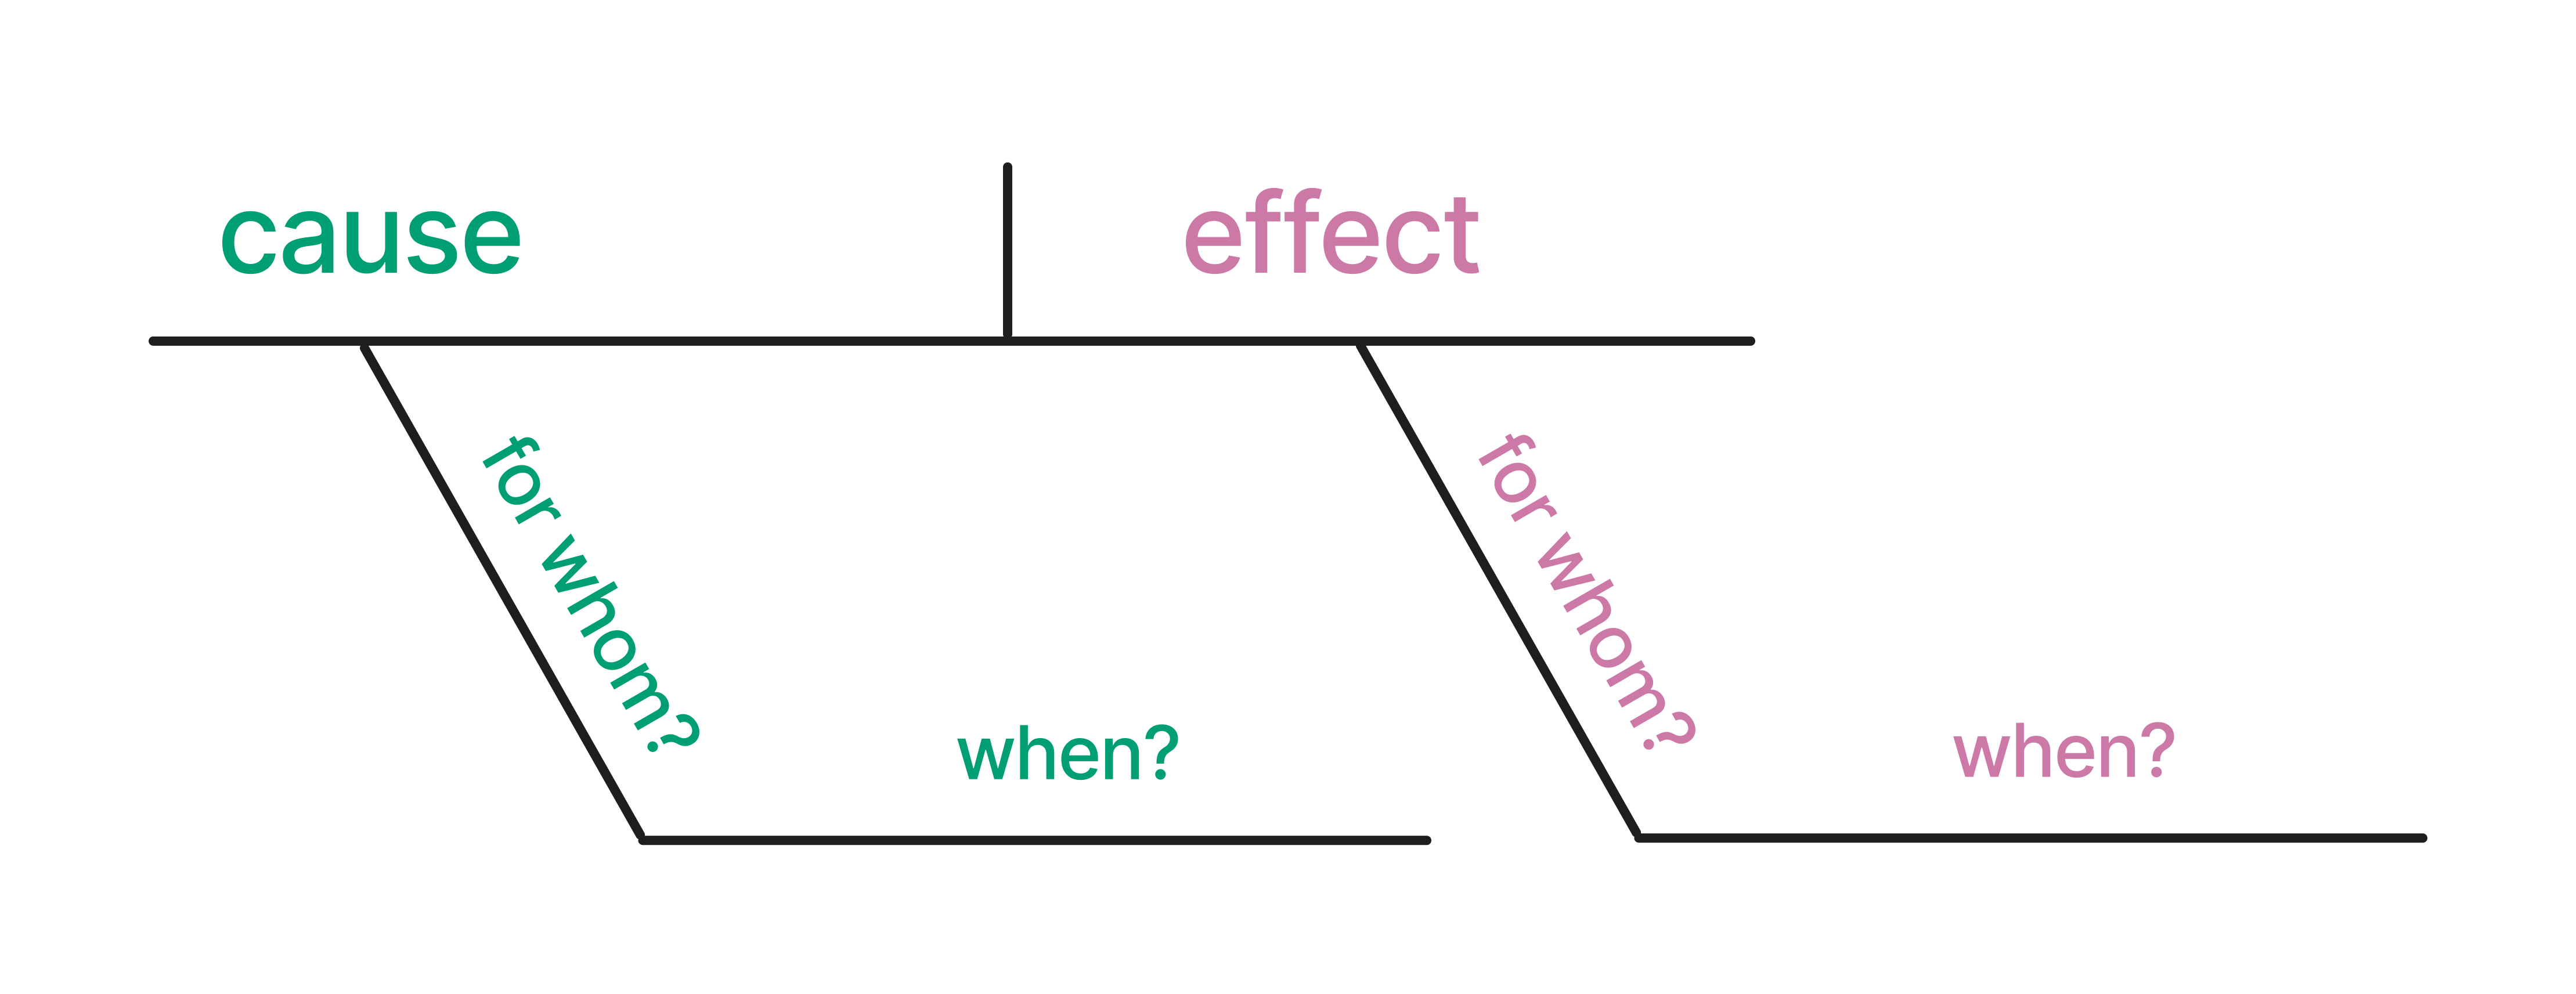
DAG를 만드는 데 사용할 도구는 ggdag입니다. ggdag는 R에서 가장 강력한 시각화 도구인 ggplot2를 DAG 쿼리를 위한 정교한 알고리즘을 가진 R 패키지인 dagitty에 연결해 주는 패키지입니다.
DAG 객체를 생성하기 위해 우리는 dagify() 함수를 사용합니다. dagify()는 dagitty 패키지와 ggdag 패키지 모두에서 작동하는 dagitty 객체를 반환합니다. dagify() 함수는 쉼표로 구분된 공식(formulas)을 인자로 받아 원인과 결과를 지정합니다. 공식의 왼쪽 요소는 결과를 정의하고 오른쪽 요소는 그 결과를 유발하는 모든 요인들을 정의합니다. 이는 R의 대부분의 회귀 모델에서 지정하는 공식 유형과 매우 유사합니다.
dagify(
  결과1 ~ 원인1 + 원인2 + 원인3,
  결과2 ~ 원인1 + 원인4,
  ...
)
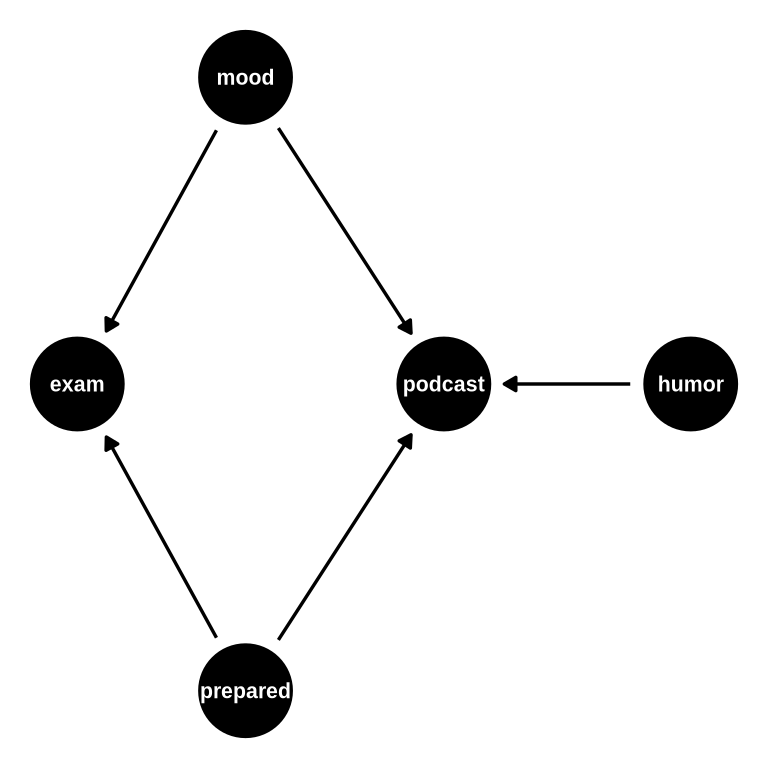
대학원생들이 시험 전날 아침에 팟캐스트를 듣게 만드는 모든 요인들은 무엇일까요? 대학원생이 시험을 잘 보게 만들 수 있는 모든 요인들은 무엇일까요? 여기서 몇 가지를 가정해 봅시다.
dag {
exam
humor
mood
podcast
prepared
humor -> podcast
mood -> exam
mood -> podcast
prepared -> exam
prepared -> podcast
}
위의 코드에서 우리는 다음과 같이 가정합니다:
exam 방정식에 podcast가 포함되지 않았음을 주목하십시오; 이는 팟캐스트와 시험 점수 사이에 직접적인 인과 관계가 없다고 가정함을 의미합니다.
dagify()에 자주 제공하게 될 다른 유용한 인자들이 있습니다:
exposure 및 outcome: 연구 질문의 노출과 결과가 되는 변수들을 ggdag에 알려주는 것은 DAG로부터 가장 가치 있는 쿼리를 수행하는 데 필수적입니다.latent: 이 인자는 DAG의 일부 변수가 측정되지 않았음을 ggdag에 알려줍니다. latent는 실제로 우리가 가진 데이터를 사용하여 유효한 조정 집합을 식별하는 데 도움을 줍니다.coords: 변수들의 좌표입니다. 아래에서 논의할 알고리즘 방식 또는 수동 레이아웃 중에서 선택할 수 있습니다. 여기서는 time_ordered_coords()를 사용할 것입니다.labels: 변수들에 대한 레이블 문자 벡터입니다.이러한 속성들 중 일부를 포함하여 DAG 객체인 podcast_dag를 생성한 다음, ggdag()로 DAG를 시각화해 보겠습니다. ggdag()는 ggplot2 객체를 반환하므로 테마와 같은 추가 레이어를 그래프에 추가할 수 있습니다.
podcast_dag <- dagify(
  podcast ~ mood + humor + prepared,
  exam ~ mood + prepared,
  coords = time_ordered_coords(
    list(
      # 시점 1
      c("prepared", "humor", "mood"),
      # 시점 2
      "podcast",
      # 시점 3
      "exam"
    )
  ),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "기분",
    humor = "유머 감각",
    prepared = "준비 상태"
  )
)
ggdag(podcast_dag, use_labels = TRUE, use_text = FALSE) +
  theme_dag()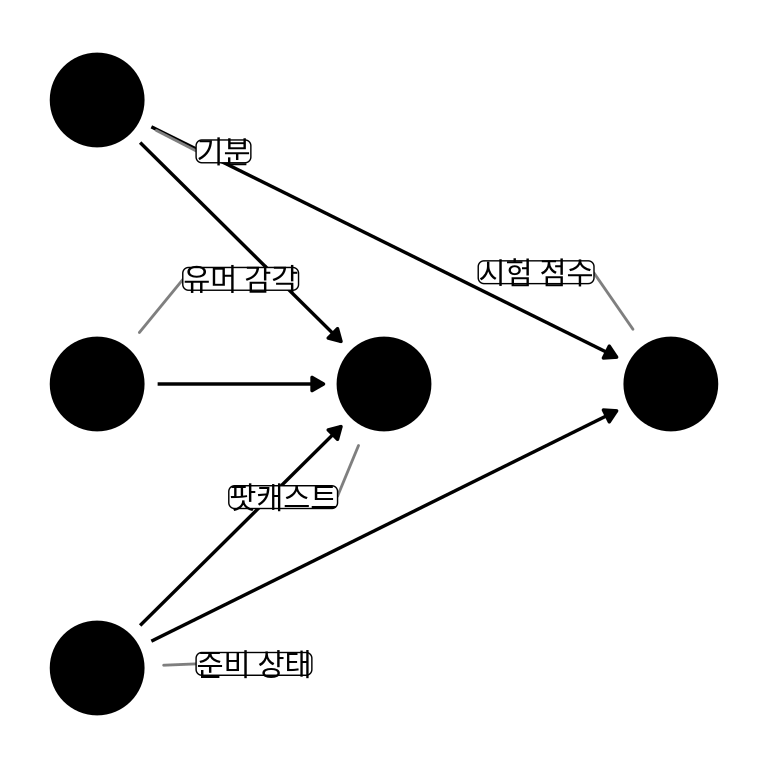
이 장의 나머지 부분에서는 DAG를 위해 고안된 ggdag의 ggplot 테마인 theme_dag()를 사용할 것입니다.
theme_set(
  theme_dag() %+replace%
    # 몇 가지 추가 스타일링을 더합니다
    theme(
      legend.position = "bottom",
      strip.text.x = element_text(margin = margin(2, 0, 2, 0, "mm"))
    )
)ggdag에서 좌표를 꼭 지정할 필요는 없습니다. 좌표를 지정하지 않으면, 자동 레이아웃을 위해 설계된 알고리즘을 사용합니다. 그러한 알고리즘은 많이 있으며, 모양, 노드 간의 간격, 에지 교차 최소화 등 레이아웃의 서로 다른 측면에 집중합니다. 이러한 레이아웃 알고리즘은 대개 무작위성을 포함하므로, 동일한 결과를 얻으려면 시드(seed)를 사용하는 것이 좋습니다.
우리는 또한 특정 레이아웃을 요청할 수도 있습니다. 예를 들어 DAG에 널리 쓰이는 스기야마(Sugiyama) 알고리즘이 있습니다 (Sugiyama, Tagawa, 와/과 Toda 1981).
pod_dag |>
  ggdag(layout = "sugiyama", text_size = 2.8)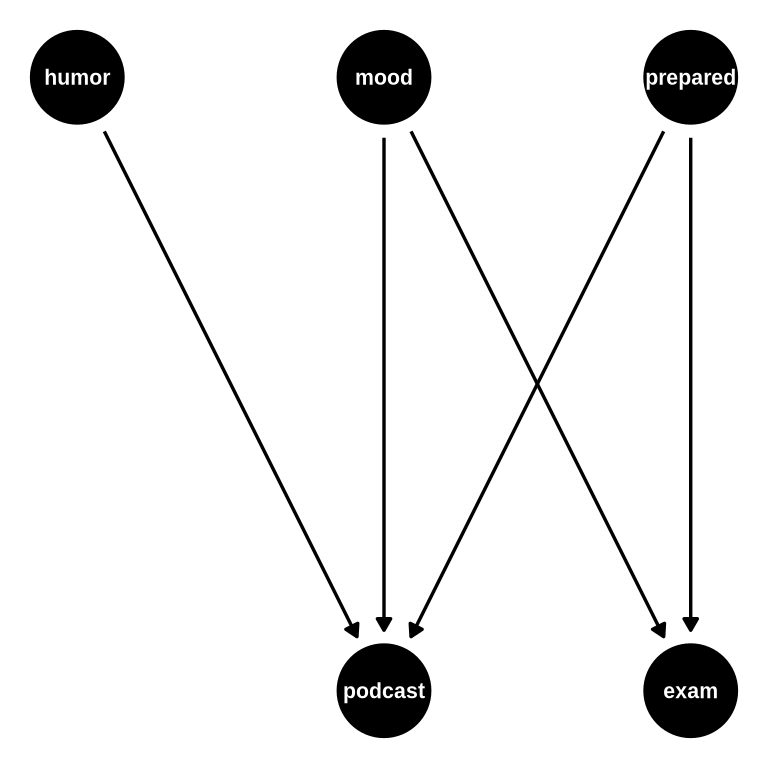
인과적 DAG의 경우, 시간 순서 레이아웃(time-ordered layout) 알고리즘이 가장 좋을 때가 많은데, 이는 time_ordered_coords() 또는 layout = "time_ordered"로 지정할 수 있습니다. 시간 순서에 대해서는 아래에서 더 자세히 논의하겠습니다. 앞서 우리는 ggdag에 어떤 변수가 어떤 시점에 있는지 명시적으로 알려주었지만, 꼭 그럴 필요는 없습니다. 하지만 시간 순서 알고리즘은 podcast와 exam이 서로를 유발하지 않기 때문에(따라서 하나가 다른 것보다 앞서지 않기 때문에) 동일한 시점에 배치한다는 점에 유의하십시오. 우리는 그것이 사실이 아님을 알고 있습니다: 팟캐스트를 듣는 일은 시험을 보기 전에 일어났습니다.
pod_dag |>
  ggdag(layout = "time_ordered", text_size = 2.8)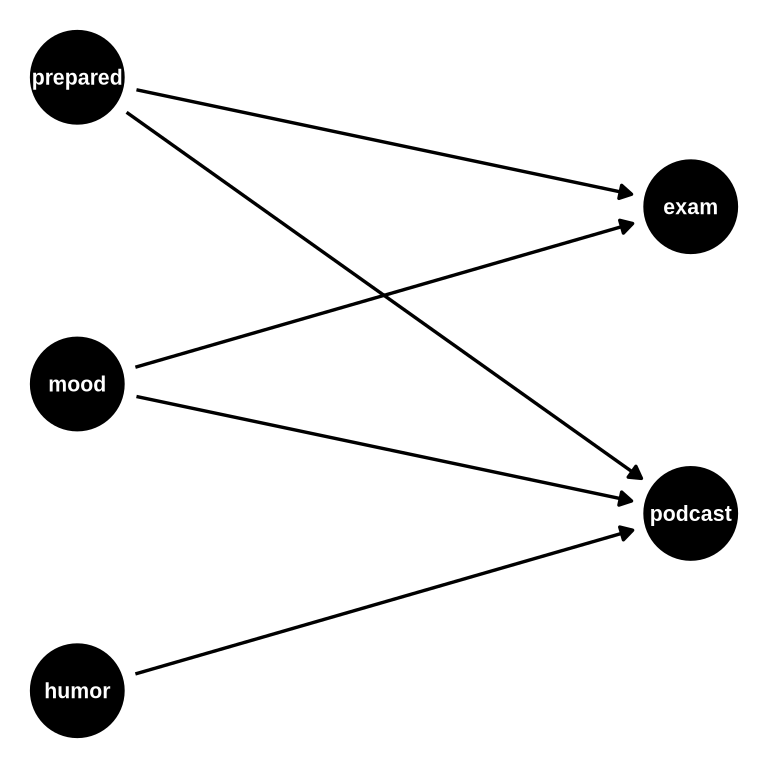
리스트나 데이터 프레임을 사용하여 좌표를 수동으로 지정하고 이를 dagify()의 coords 인자에 제공할 수 있습니다. 또한 ggdag는 dagitty를 기반으로 하기 때문에, dagitty 웹 앱을 사용하여 그래픽 인터페이스로 DAG를 만들고 구성한 다음, 그 결과를 ggdag에서 사용할 수 있도록 dagitty 코드로 내보낼 수 있습니다.
알고리즘 기반 레이아웃은 DAG를 빠르게 시각화하거나 특히 복잡한 그래프를 그릴 때 매우 훌륭합니다. 일단 여러분의 DAG를 공유하고 싶다면, 아마도 좌표를 수동으로 지정하는 등 레이아웃에 대해 더 의도적으로 접근하는 것이 좋습니다. time_ordered_coords()는 종종 두 세계의 장점을 모두 갖춘 방식이며, 우리는 이 책의 대부분의 DAG에 이 방식을 사용할 것입니다.
우리는 이 질문에 대한 DAG를 명시했고 ggdag에 관심 있는 노출과 결과를 알려주었습니다. 이 DAG에 따르면, 팟캐스트를 듣는 것과 시험 점수 사이에는 직접적인 인과 관계가 없습니다. 다른 열린 경로가 있을까요? ggdag_paths()는 DAG를 인자로 받아 열린 경로들을 시각화합니다. 그림 4.10 에서 우리는 두 개의 열린 경로를 봅니다: podcast <- mood -> exam과 podcast <- prepared -> exam입니다. 이들은 둘 다 포크 — 교란 경로 — 입니다. 팟캐스트 청취와 시험 점수 사이에 인과 관계가 없기 때문에, 유일한 열린 경로들은 이 두 교란 경로와 같은 백도어 경로들뿐입니다.
podcast_dag |>
  # 경로뿐만 아니라 전체 DAG를 연한 회색 "그림자"로 보여줍니다
  ggdag_paths(shadow = TRUE, use_text = FALSE, use_labels = TRUE)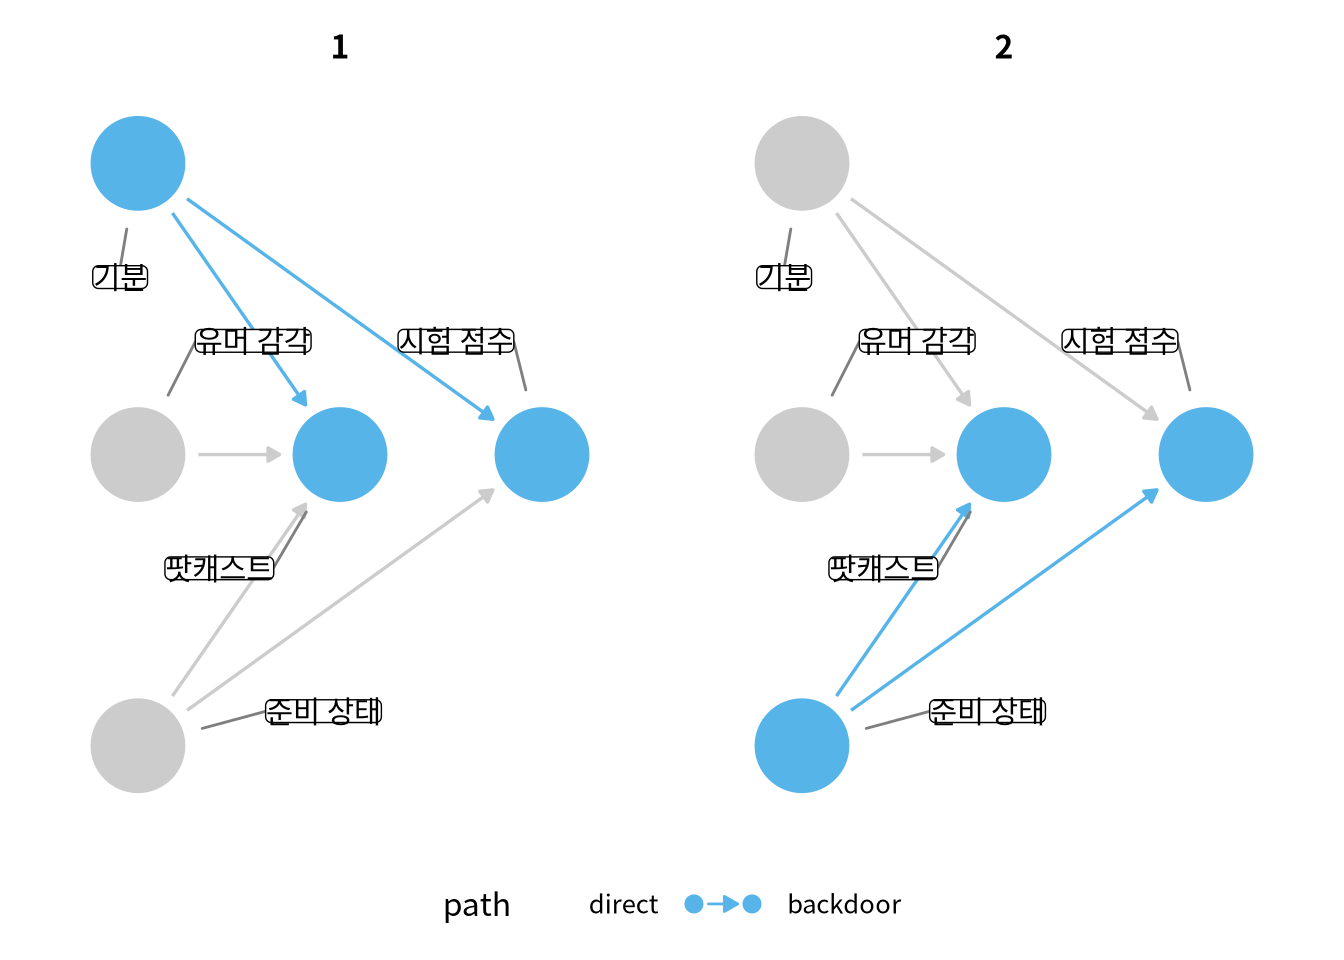
ggdag_paths()는 DAG의 열린 경로들을 시각화합니다. podcast_dag에는 두 개의 열린 경로가 있습니다: mood로부터의 포크와 prepared로부터의 포크입니다.
dagify()는 dagitty() 객체를 반환하지만, 내부적으로 ggdag는 dagitty 객체를 tidy DAG로 변환합니다. 이는 dagitty 객체와 DAG에 대한 dataframe을 모두 보유하는 구조입니다. 이는 여러분이 프로그램 방식으로 DAG를 조작하고 싶을 때 유용합니다.
podcast_dag_tidy <- podcast_dag |>
  tidy_dagitty()

podcast_dag_tidy
# DAG:
# A `dagitty` DAG with: 5 nodes and 5 edges
# Exposure: podcast
# Outcome: exam
#
# Data:
# A tibble: 7 × 8
name x y direction to xend yend label
<chr> <int> <int> <fct> <chr> <int> <int> <chr>
1 exam 3 0 <NA> <NA> NA NA 시험 점…
2 humor 1 0 -> podc… 2 0 유머 감…
3 mood 1 1 -> exam 3 0 기분
4 mood 1 1 -> podc… 2 0 기분
5 podcast 2 0 <NA> <NA> NA NA 팟캐스트…
6 prepar… 1 -1 -> exam 3 0 준비 상…
7 prepar… 1 -1 -> podc… 2 0 준비 상…
#
# ℹ Use `pull_dag() (`?pull_dag`)` to retrieve the DAG object and `pull_dag_data() (`?pull_dag_data`)` for the data frame대부분의 빠른 그래프 함수들은 dagitty 객체가 아직 tidy DAG라 아니라면 변환한 다음, 어떤 식으로든 데이터를 조작합니다. 예를 들어, dag_paths()는 ggdag_paths()의 기초가 되는 함수입니다; 이는 경로에 대한 데이터를 포함하는 tidy DAG를 반환합니다. 여러분은 이러한 객체들에 대해 여러 dplyr 함수들을 직접 사용할 수 있습니다.
# DAG:
# A `dagitty` DAG with: 5 nodes and 5 edges
# Exposure: podcast
# Outcome: exam
# Paths: 2 open paths: {podcast <- mood -> exam}, {podcast <- prepared -> exam}
#
# Data:
# A tibble: 4 × 11
  set   name        x     y direction to     xend  yend
  <chr> <chr>   <int> <int> <fct>     <chr> <int> <int>
1 2     exam        3     0 <NA>      <NA>     NA    NA
2 2     podcast     2     0 <NA>      <NA>     NA    NA
3 2     prepar…     1    -1 ->        exam      3     0
4 2     prepar…     1    -1 ->        podc…     2     0
# ℹ 3 more variables: label <chr>, path <chr>,
#   path_type <chr>
#
# ℹ Use `pull_dag() (`?pull_dag`)` to retrieve the DAG object and `pull_dag_data() (`?pull_dag_data`)` for the data frame
Tidy DAG는 순수한 데이터 프레임은 아니지만, pull_dag_data() 또는 pull_dag()를 사용하여 dataframe이나 dagitty 객체를 추출하여 직접 작업할 수 있습니다. pull_dag()는 dagitty 함수들과 함께 작업하고 싶을 때 유용할 수 있습니다:
백도어 경로(backdoor paths)는 podcast와 exam 사이의 통계적 연관성을 왜곡하므로, 우리는 이를 처리해야 합니다. ggdag_adjustment_set()은 DAG에 의해 암시된 모든 유효한 조정 집합을 시각화합니다. 그림 4.11 은 조정된 변수들을 사각형으로 보여줍니다. 조정된 변수에서 나오는 모든 화살표는 DAG에서 제거되는데, 이는 해당 변수에서 경로가 더 이상 열려 있지 않기 때문입니다.
ggdag_adjustment_set(
  podcast_dag,
  use_text = FALSE,
  use_labels = TRUE
)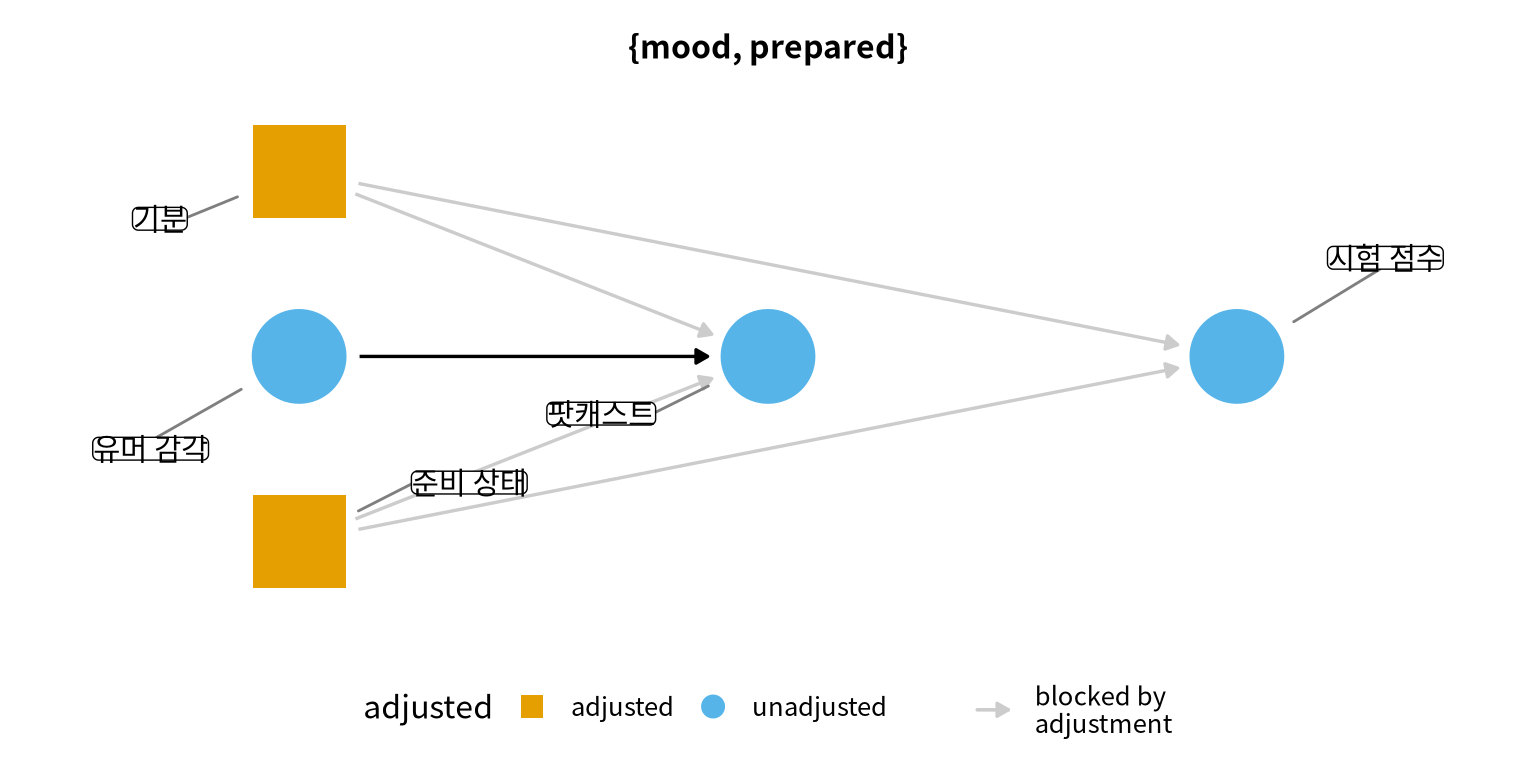
mood와 prepared라는 두 변수가 필요합니다.
그림 4.11 은 최소 조정 집합(minimal adjustment set)을 보여줍니다. 기본적으로 ggdag는 가능한 가장 적은 수의 변수로 모든 백도어 경로를 닫을 수 있는 집합(들)을 반환합니다. 이 DAG에서는 {mood, prepared}라는 단 하나의 집합만이 존재합니다. 이 집합은 타당해 보입니다. 노출과 결과를 제외하고 백도어 경로 상에 있는 변수는 이 두 가지뿐이기 때문입니다. 따라서 유효한 추정치를 얻으려면 최소한 이 두 가지를 모두 고려해야 합니다.
ggdag()와 그 일족들은 대개 tidy_dagitty()와 dag_*() 또는 node_*() 함수들을 사용하여 기저의 데이터 프레임을 변경합니다. 마찬가지로, 빠른 그래프 함수들은 ggdag의 geom들을 사용하여 결과 DAG(들)를 시각화합니다. 즉, 여러분이 매일 사용하는 것과 동일한 데이터 조작 및 시각화 전략을 ggdag와 함께 직접 사용할 수 있습니다.
다음은 ggdag_adjustment_set()이 수행하는 작업의 요약 버전입니다:
podcast_dag_tidy |>
  # 데이터에 조정 집합 추가
  dag_adjustment_sets() |>
  ggplot(aes(
    x = x,
    y = y,
    xend = xend,
    yend = yend,
    color = adjusted,
    shape = adjusted
  )) +
  # ggdag의 커스텀 geom: 노드, 에지, 레이블 추가
  geom_dag_edges() +
  geom_dag_point() +
  # 조정된 경로 제거
  geom_dag_label_repel() +
  # 일반적인 ggplot 함수들도 사용할 수 있습니다
  scale_shape_manual(values = c(adjusted = 15, unadjusted = 19))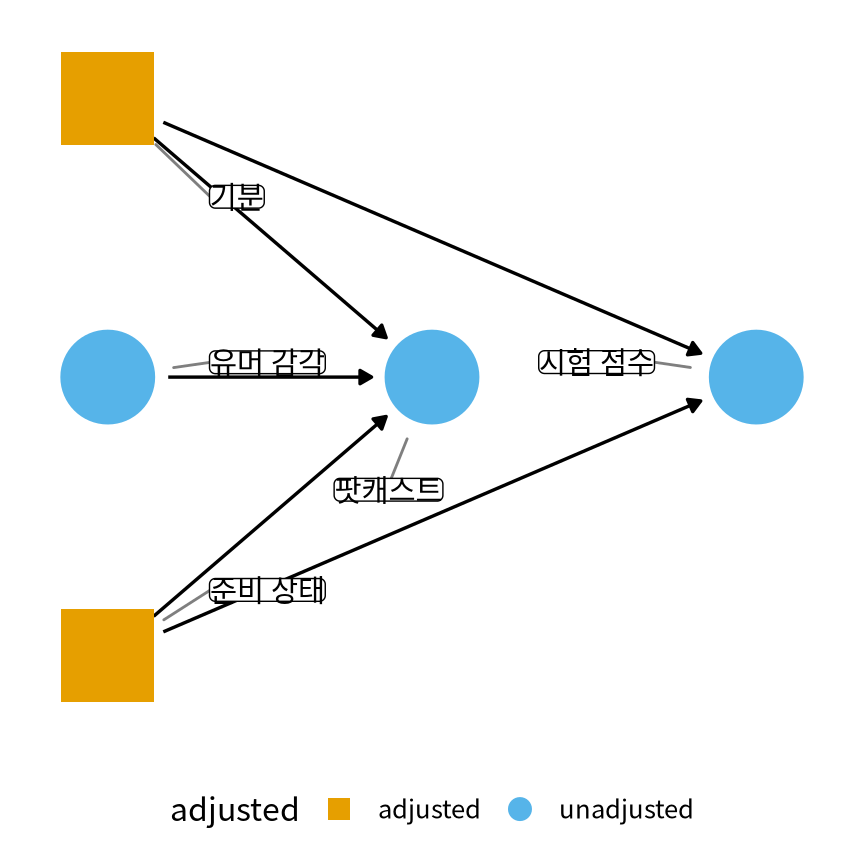
최소 조정 집합은 유효한 조정 집합의 한 유형일 뿐입니다 (Zander, Liśkiewicz, 와/과 Textor 2019). 때때로 다른 변수들의 조합을 통해서도 편향되지 않은 효과 추정치를 얻으낼 수 있습니다. ggdag에서 사용할 수 있는 다른 두 가지 옵션은 전체 조정 집합(full adjustment sets)과 표준 조정 집합(canonical adjustment sets)입니다. 전체 조정 집합은 유효한 결과를 낳는 모든 변수 조합을 의미합니다.
ggdag_adjustment_set(
  podcast_dag,
  use_text = FALSE,
  use_labels = TRUE,
  # 모든 조정 집합 가져오기
  type = "all"
)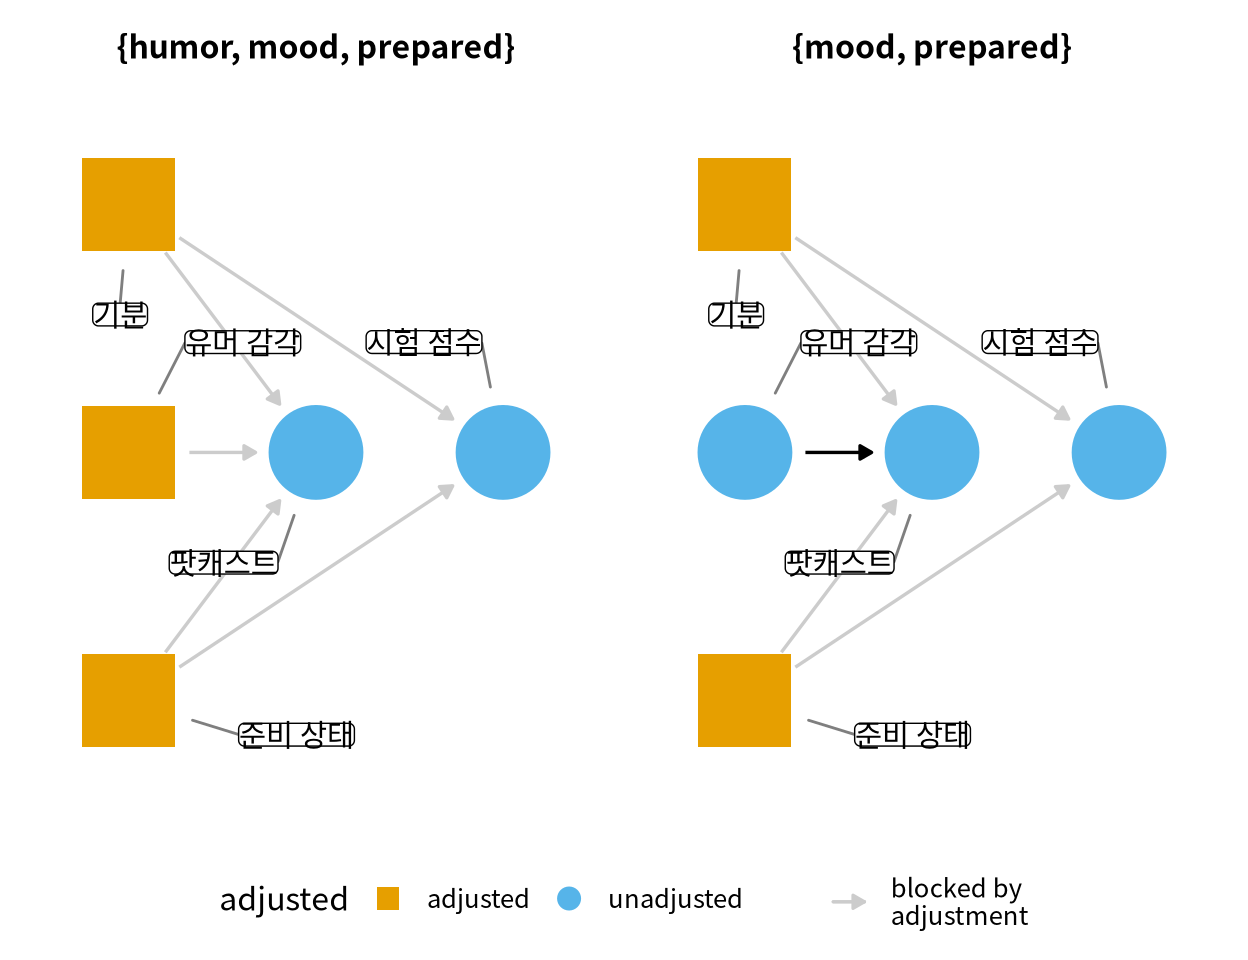
podcast_dag에 대한 모든 유효한 조정 집합.
우리는 humor 또한 통제할 수 있다는 사실을 알게 되었습니다.
표준 조정 집합은 조금 더 복잡합니다: 이들은 노출과 결과의 모든 가능한 조상(ancestors)에서 가능성 있는 후손들을 제외한 것입니다. 완전히 포화된 DAG(모든 노드가 시간상 뒤에 나오는 모든 것에 영향을 미치는 DAG)에서 표준 조정 집합은 최소 조정 집합과 동일합니다.
ggdag의 대부분의 함수는 내부적으로 dagitty를 사용합니다. dagitty 함수들을 직접 호출하는 것이 도움이 될 때가 많습니다.
adjustmentSets(podcast_dag, type = "canonical"){ humor, mood, prepared }우리가 제안한 DAG를 사용하여, 실무에서 최소 조정 집합을 고려하는 것이 어떻게 이루어지는지 보기 위해 데이터를 시뮬레이션해 봅시다.
set.seed(10)
sim_data <- podcast_dag |>
  simulate_data()

sim_data
# A tibble: 500 × 5
exam humor mood podcast prepared
<dbl> <dbl> <dbl> <dbl> <dbl>
1 -0.435 0.263 -0.100 -0.630 1.07
2 -0.593 0.317 0.143 -1.55 0.0640
3 0.786 1.97 -0.591 -0.318 -0.439
4 -0.103 2.86 -0.139 1.07 0.754
5 -0.614 -2.39 0.702 0.464 0.356
6 1.01 1.21 0.910 0.769 0.561
7 0.167 -1.37 -0.559 -0.866 0.214
8 1.16 0.164 -0.743 0.969 -1.67
9 0.650 0.215 -0.248 0.691 -0.303
10 0.156 0.713 1.19 -1.02 -0.219
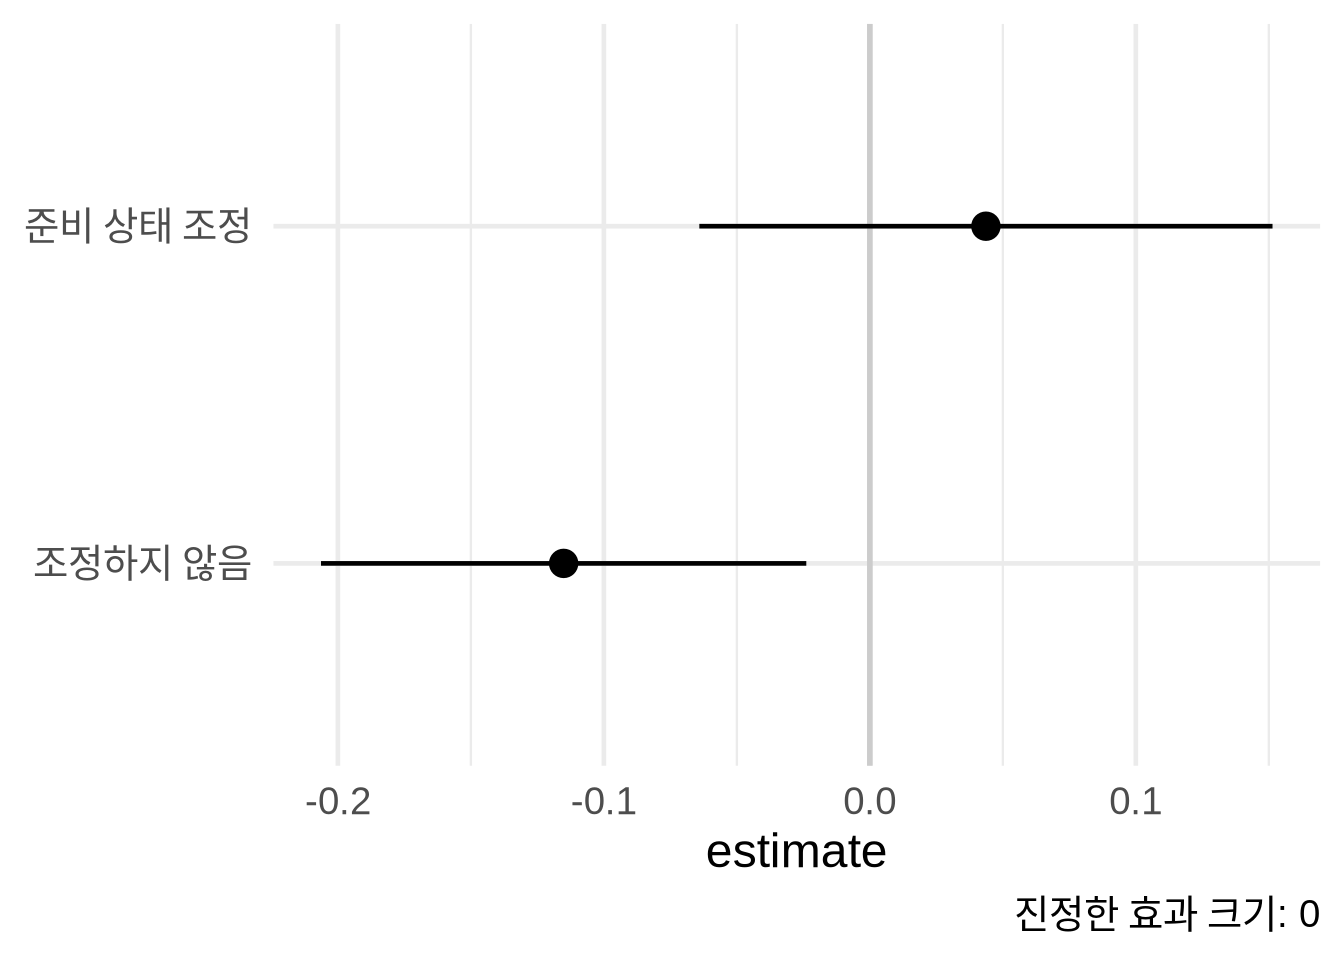
# ℹ 490 more rows그림 4.13 은 우리의 DAG를 기반으로 시뮬레이션된 데이터를 사용한 추정치의 포레스트 플롯(forest plot)을 보여줍니다. 하나의 추정치는 조정되지 않은 것이고, 다른 하나는 mood와 prepared에 대해 조정된 것입니다. 조정되지 않은 추정치는 허위 효과(우리는 참값이 0임을 알고 있음에도 불구하고 -0.1로 추정됨)를 낳았음을 주목하십시오. 반면에 ggdag_adjustment_set()이 제안한 대로 두 변수를 조정한 추정치는 허위가 아닙니다(0에 훨씬 더 가깝습니다).
## 백도어 경로를 닫지 않은 모델
library(broom)
unadjusted_model <- lm(exam ~ podcast, sim_data) |>
  tidy(conf.int = TRUE) |>
  filter(term == "podcast") |>
  mutate(formula = "조정하지 않음")

## 백도어 경로를 닫은 모델
adjusted_model <- lm(exam ~ podcast + mood + prepared, sim_data) |>
  tidy(conf.int = TRUE) |>
  filter(term == "podcast") |>
  mutate(formula = "기분 + 준비 상태 조정")

bind_rows(
  unadjusted_model,
  adjusted_model
) |>
  ggplot(aes(estimate, formula, xmin = conf.low, xmax = conf.high)) +
  geom_vline(xintercept = 0, linewidth = 1, color = "grey80") +
  geom_pointrange(fatten = 3, size = 1) +
  theme_minimal(18) +
  labs(
    y = NULL,
    caption = "진정한 효과 크기: 0"
  )
Warning: The `fatten` argument of `geom_pointrange()` is
deprecated as of ggplot2 4.0.0.
ℹ Please use the `size` aesthetic instead.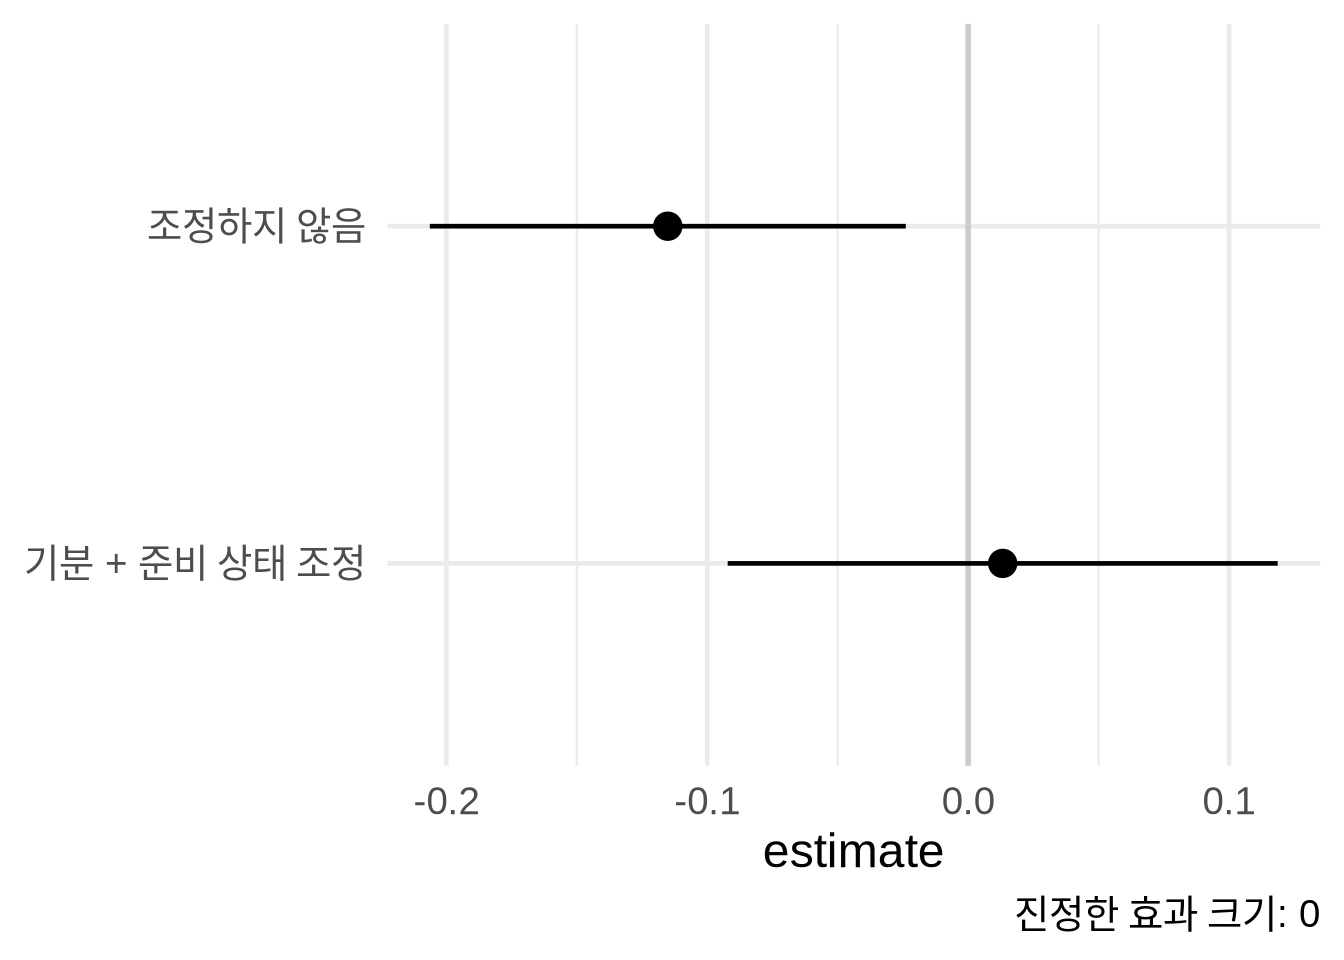
물론 우리는 우리가 실제 DAG로 작업하고 있다는 것을 알고 있습니다. 만약 실제 DAG(그림 4.9)를 모르는 상태에서, 그림 4.14 을 그렸다고 가정해 봅시다.
podcast_dag_wrong <- dagify(
  podcast ~ humor + prepared,
  exam ~ prepared,
  coords = time_ordered_coords(
    list(
      # 시점 1
      c("prepared", "humor"),
      # 시점 2
      "podcast",
      # 시점 3
      "exam"
    )
  ),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    humor = "유머 감각",
    prepared = "준비 상태"
  )
)
ggdag(podcast_dag_wrong, use_labels = TRUE, use_text = FALSE) +
  theme_dag()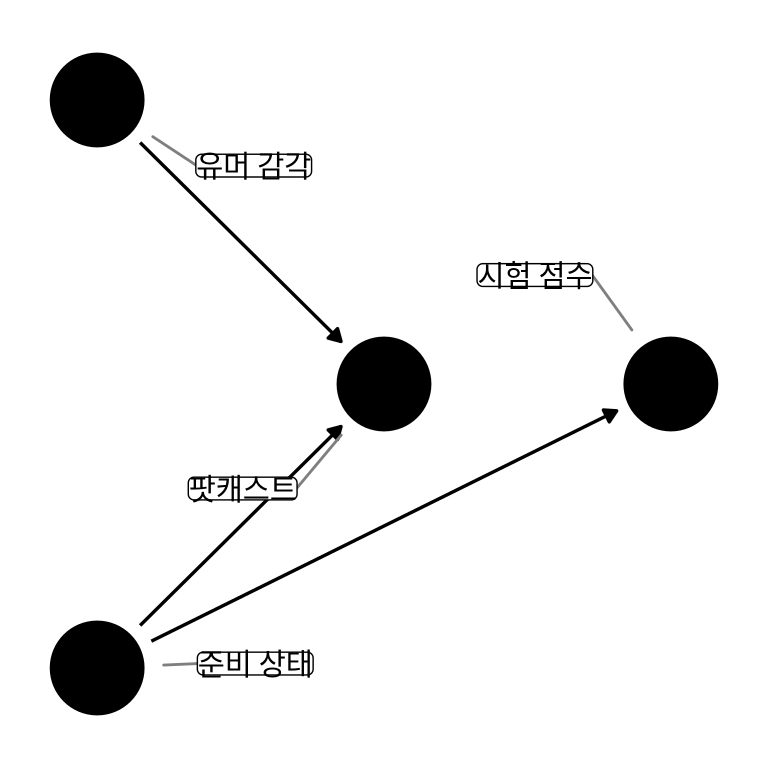
DAG가 틀렸기 때문에, 그것은 우리가 정답을 얻는 데 도움이 되지 않습니다. 그것은 우리가 prepared만 조정하면 된다고 말하지만, 우리는 관계를 교란시키는 인과 경로를 하나 놓치고 있습니다. 이제 두 추정치 모두 옳지 않습니다.
## 백도어 경로를 닫지 않은 모델
library(broom)
unadjusted_model <- lm(exam ~ podcast, sim_data) |>
  tidy(conf.int = TRUE) |>
  filter(term == "podcast") |>
  mutate(formula = "조정하지 않음")

## 백도어 경로를 닫은 모델
adjusted_model <- lm(exam ~ podcast + prepared, sim_data) |>
  tidy(conf.int = TRUE) |>
  filter(term == "podcast") |>
  mutate(formula = "준비 상태 조정")

bind_rows(
  unadjusted_model,
  adjusted_model
) |>
  ggplot(aes(estimate, formula, xmin = conf.low, xmax = conf.high)) +
  geom_vline(xintercept = 0, linewidth = 1, color = "grey80") +
  geom_pointrange(fatten = 3, size = 1) +
  theme_minimal(18) +
  labs(
    y = NULL,
    caption = "진정한 효과 크기: 0"
)podcast_dag에서 mood와 prepared는 직접적인 교란 요인이었습니다: 그들로부터 podcast와 exam으로 화살표가 직접 향했기 때문입니다. 종종 백도어 경로는 이보다 더 복잡합니다. alertness와 skills_course라는 두 가지 새로운 변수를 추가하여 그러한 사례를 고려해 봅시다. alertness는 좋은 기분에서 오는 기민함(alertness)을 나타내며, 따라서 mood에서 alertness로 화살표가 향합니다. skills_course는 학생이 “대학 기술 과정(College Skills Course)”을 수강하고 시간 관리 기술을 배웠는지 여부를 나타냅니다. 이제 skills_course는 팟캐스트를 들을 시간을 확보해줄 뿐만 아니라 시험 준비도 더 잘하게 만듭니다. mood와 prepared는 더 이상 직접적인 교란 요인이 아닙니다: 그들은 더 복잡한 백도어 경로 상에 있는 두 변수가 되었습니다. 추가적으로, 우리는 humor에서 mood로 가는 화살표를 추가했습니다. 그림 4.16 를 살펴봅시다.
podcast_dag2 <- dagify(
  podcast ~ mood + humor + skills_course,
  alertness ~ mood,
  mood ~ humor,
  prepared ~ skills_course,
  exam ~ alertness + prepared,
  coords = time_ordered_coords(),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "기분",
    alertness = "기민함",
    skills_course = "대학\n기술 과정",
    humor = "유머 감각",
    prepared = "준비 상태"
  )
)

ggdag(podcast_dag2, use_labels = TRUE, use_text = FALSE)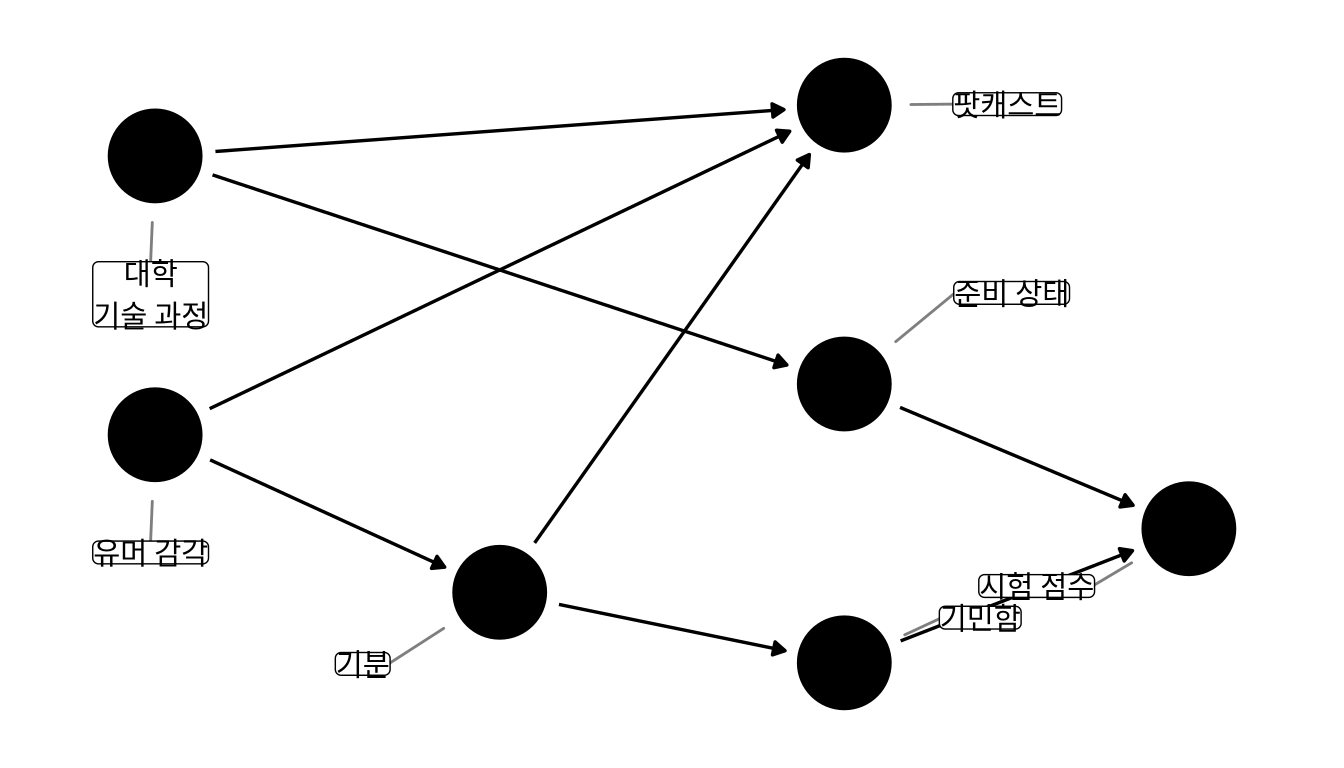
skills_course(대학 기술 과정)와 alertness(기민함)를 포함하도록 확장된 podcast_dag.
이제 우리가 닫아야 할 백도어 경로가 세 개 있습니다: podcast <- humor -> mood -> alertness -> exam, podcast <- mood -> alertness -> exam, andpodcast <- skills_course -> prepared -> exam.
ggdag_paths(podcast_dag2, use_labels = TRUE, use_text = FALSE, shadow = TRUE)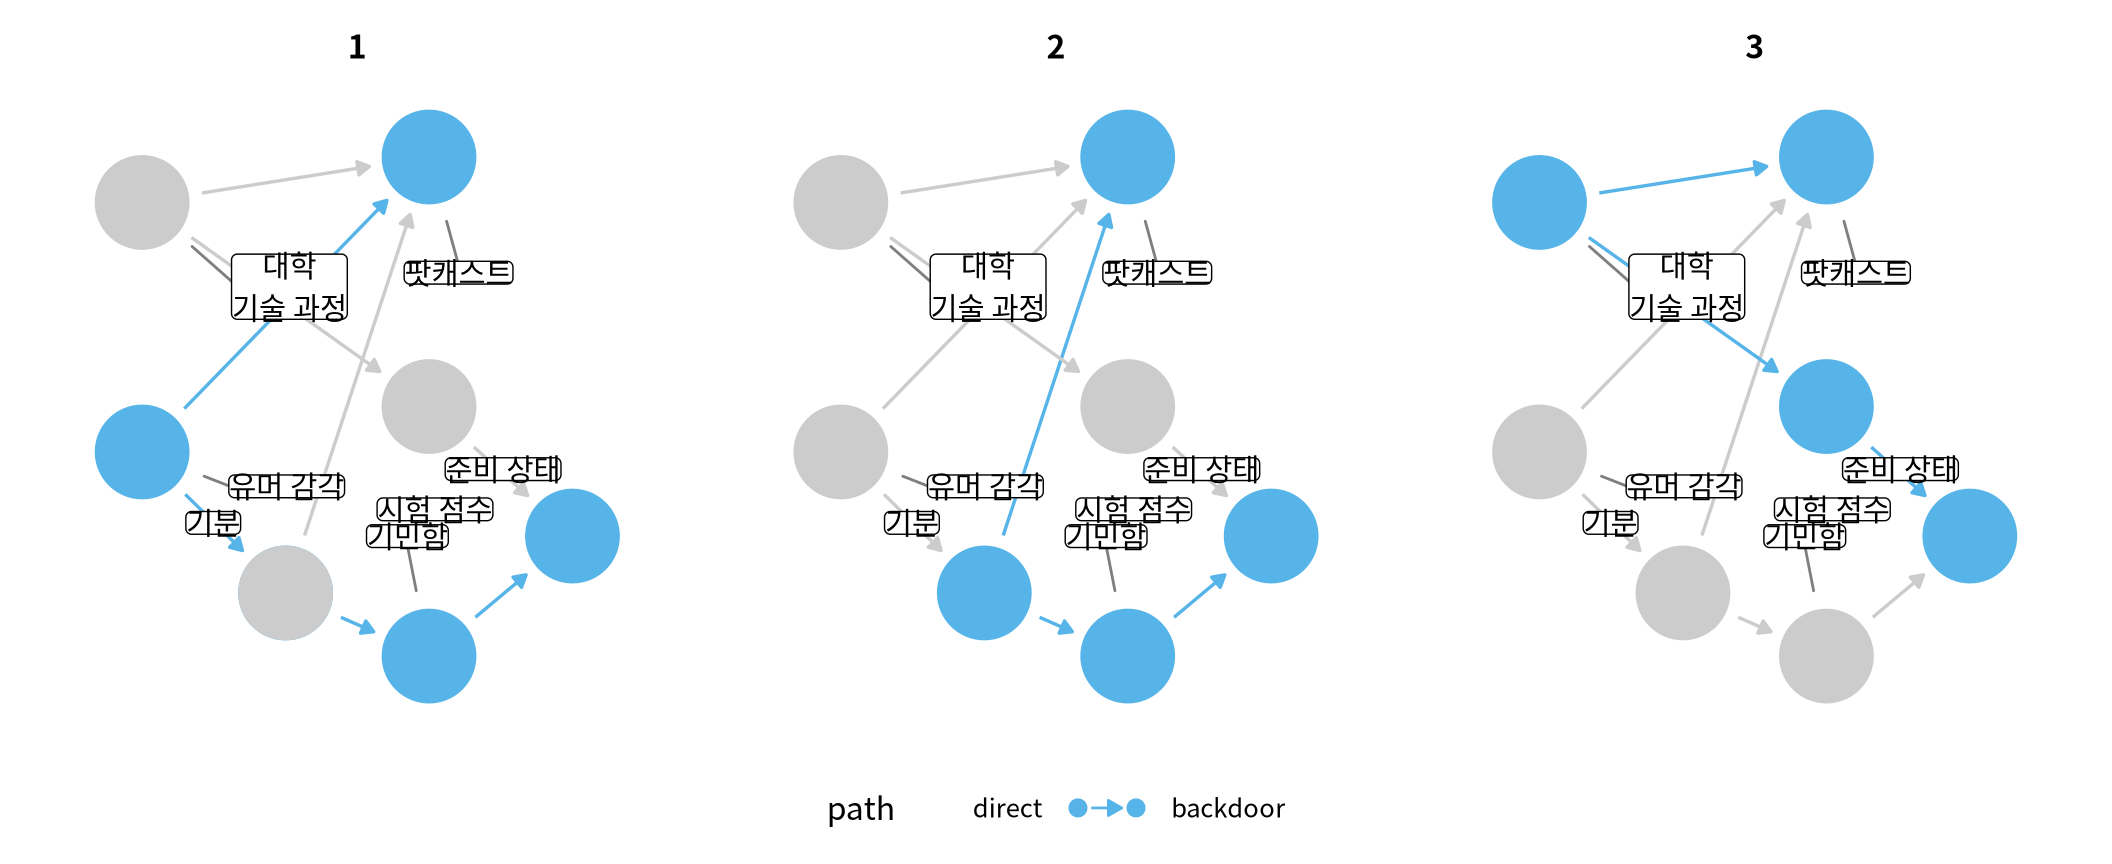
podcast_dag2에 있는 세 개의 열린 경로. podcast가 exam에 미치는 효과가 없으므로, 정확한 효과를 얻기 위해서는 이 세 개의 백도어 경로를 모두 닫아야 합니다.
세 경로를 모두 닫기 위한 네 개의 최소 조정 집합이 있습니다(그리고 전체 조정 집합은 18개나 됩니다!). 최소 조정 집합은 alertness + prepared, alertness + skills_course, mood + prepared, mood + skills_course입니다. 우리는 이제 여러 방법으로 열린 경로를 차단할 수 있습니다. mood와 prepared는 여전히 유효하지만, 이제 다른 선택지들도 생겼습니다. 특히, prepared와 alertness는 podcast와 동시에 또는 심지어 그 이후에 일어날 수도 있습니다. skills_course와 mood는 여전히 podcast와 exam 모두보다 먼저 일어나므로, 교란 경로가 노출과 결과보다 먼저 시작된다는 아이디어는 여전히 동일합니다.
ggdag_adjustment_set(podcast_dag2, use_labels = TRUE, use_text = FALSE)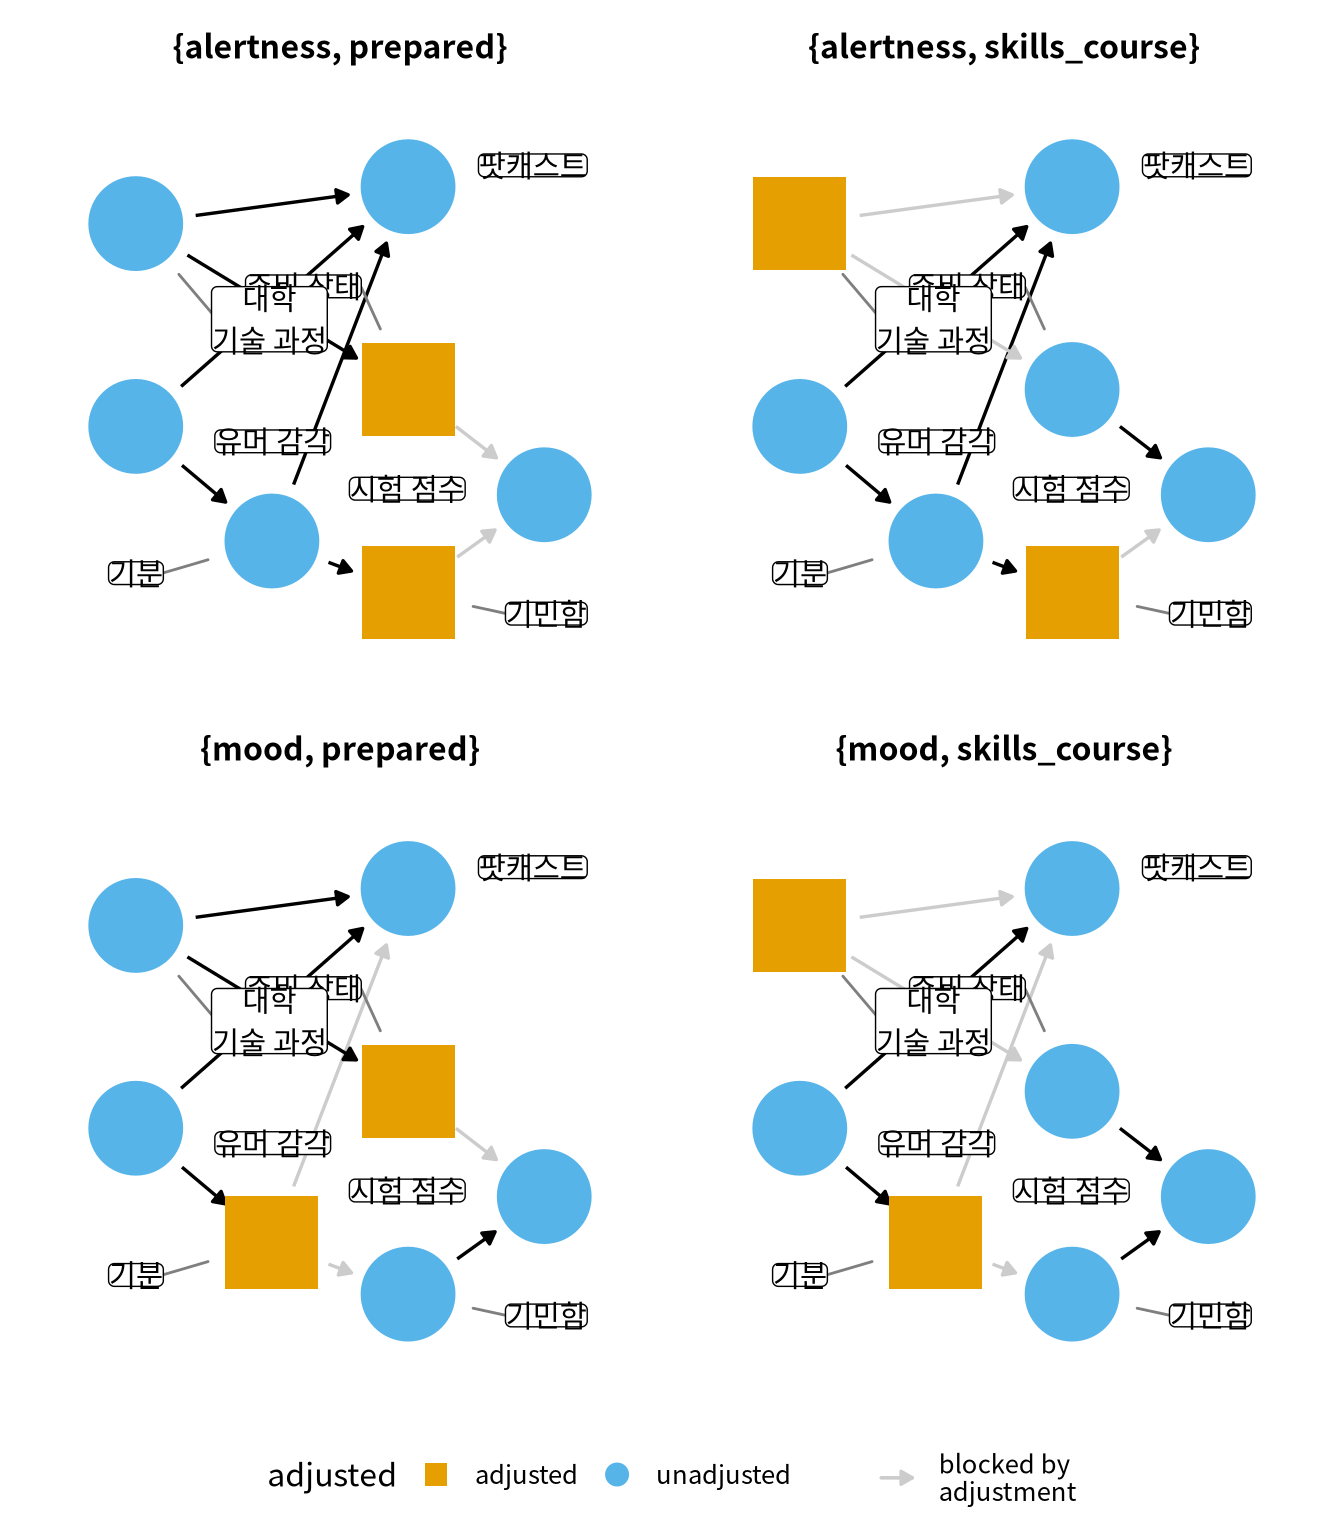
이러한 조정 집합들 중에서 선택하는 것은 판단의 문제입니다: 만약 모든 데이터가 완벽하게 측정되었고, DAG가 옳으며, 우리가 그것들을 올바르게 모델링했다면, 어떤 것을 사용하든 상관없습니다. 각 조정 집합은 편향되지 않은 추정치를 제공할 것입니다. 하지만 이 세 가지 가정은 대개 어느 정도는 틀리기 마련입니다. skills_course와 prepared를 통과하는 경로를 고려해 봅시다. 누군가가 “대학 기술 과정”을 수강했는지 여부를 평가하는 것이 시험에 얼마나 준비되었는지를 평가하는 것보다 더 정확할 수 있습니다. 그럴 경우, skills_course가 포함된 조정 집합이 더 나은 선택입니다. 하지만 준비 상태와 시험 결과 사이의 관계를 더 잘 이해하고 있을 수도 있습니다. 그것이 측정되어 있다면, 이를 통제하는 것이 더 나을 수 있습니다. 두 변수를 모두 포함함으로써 두 세계의 장점을 모두 얻을 수도 있습니다: skills_course의 더 나은 측정과 prepared의 더 나은 모델링 사이에서, 이 경로로부터의 교란을 최소화할 더 좋은 기회를 가질 수 있기 때문입니다.
선택 편향(selection bias)은 콜라이더를 조정함으로써 유발되는 편향의 또 다른 이름입니다 (Lu 기타 2022). 이것이 “선택 편향”이라고 불리는 이유는 콜라이더 유발 편향의 흔한 형태가 연구 설계에 의해 본질적으로 층화된 변수 — 즉 연구 대상으로의 선택 — 이기 때문입니다. 원래의 podcast_dag를 기반으로 하되 한 가지 변수를 추가한 사례를 고려해 봅시다: 학생이 시험장에 나타났는지 여부(showed_up)입니다. 이제 podcast가 exam에 미치는 간접 효과가 존재합니다: 팟캐스트를 듣는 것이 학생들이 시험에 응시하는지 여부에 영향을 미칩니다. 시험장에 나타나지 않은 학생들의 실제 exam 결과는 누락되었습니다; 시험장에 나타난 학생 그룹을 연구함으로써, 우리는 본질적으로 이 변수에 대해 층화하고 있는 것입니다.
podcast_dag3 <- dagify(
  podcast ~ mood + humor + prepared,
  exam ~ mood + prepared + showed_up,
  showed_up ~ podcast + mood + prepared,
  coords = time_ordered_coords(
    list(
      # 시점 1
      c("prepared", "humor", "mood"),
      # 시점 2
      "podcast",
      "showed_up",
      # 시점 3
      "exam"
    )
  ),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "기분",
    humor = "유머 감각",
    prepared = "준비 상태",
    showed_up = "시험 응시 여부"
  )
)
ggdag(podcast_dag3, use_labels = TRUE, use_text = FALSE)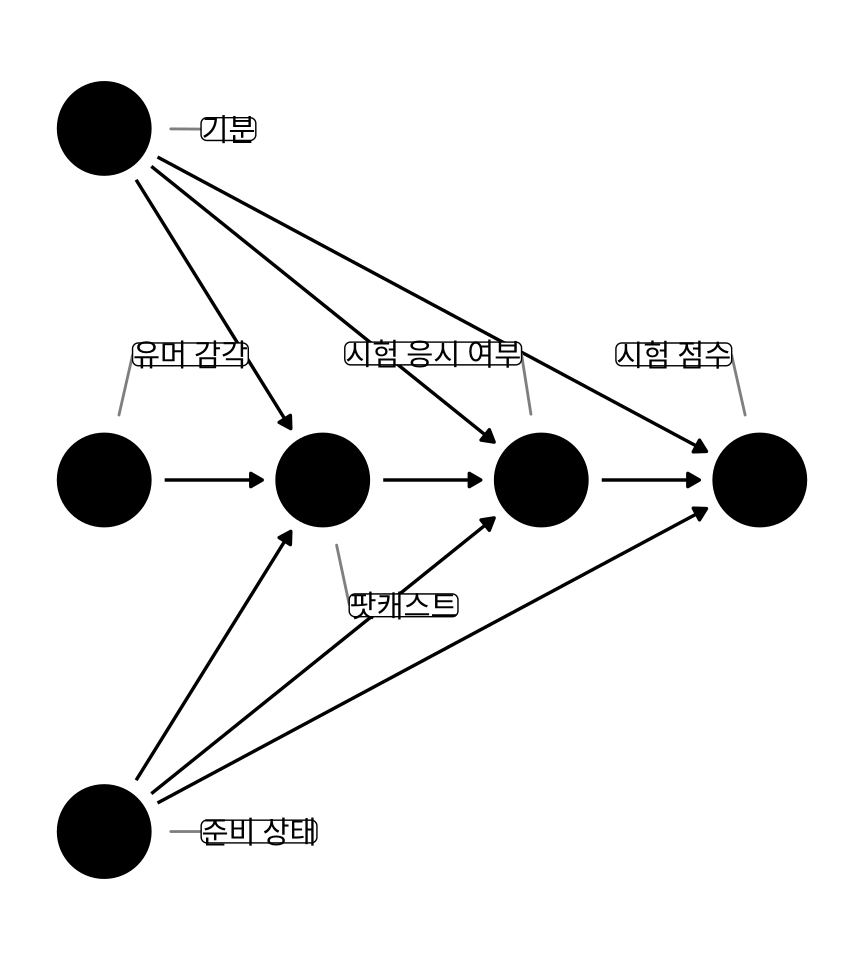
podcast_dag의 또 다른 변형으로, 이번에는 시험장에 나타난 사람들에 대한 고유한 층화를 포함합니다. 여전히 podcast가 exam에 미치는 직접 효과는 없지만, showed_up을 통한 간접 효과가 존재합니다.
문제는 showed_up이 콜라이더이자 매개 요인이라는 점입니다: 이 변수에 대해 층화하는 것은 DAG의 많은 변수들 사이에 관계를 유발하지만, podcast가 exam에 미치는 간접 효과를 차단합니다. 다행히 조정 집합이 첫 번째 문제를 처리할 수 있습니다; showed_up이 exam 보다 먼저 일어나기 때문에, 노출과 결과 사이의 콜라이더 편향 위험이 적습니다. 불행히도, 우리는 podcast가 exam에 미치는 총 효과를 계산할 수 없습니다. 효과의 일부가 누락되었기 때문입니다: 간접 효과가 showed_up에서 닫혀 버립니다.
podcast_dag3 |>
  adjust_for("showed_up") |>
  ggdag_adjustment_set(use_text = FALSE, use_labels = TRUE)
Warning in dag_adjustment_sets(if_not_tidy_daggity(.tdy_dag), exposure = exposure, : Failed to close all backdoor paths.
! Common reasons include:
• Graph is not acyclic
• Backdoor paths are not closeable with given set of
variables
• Necessary variables are unmeasured (latent)Warning: Removed 3 rows containing missing values or values
outside the scale range (`geom_label_repel()`).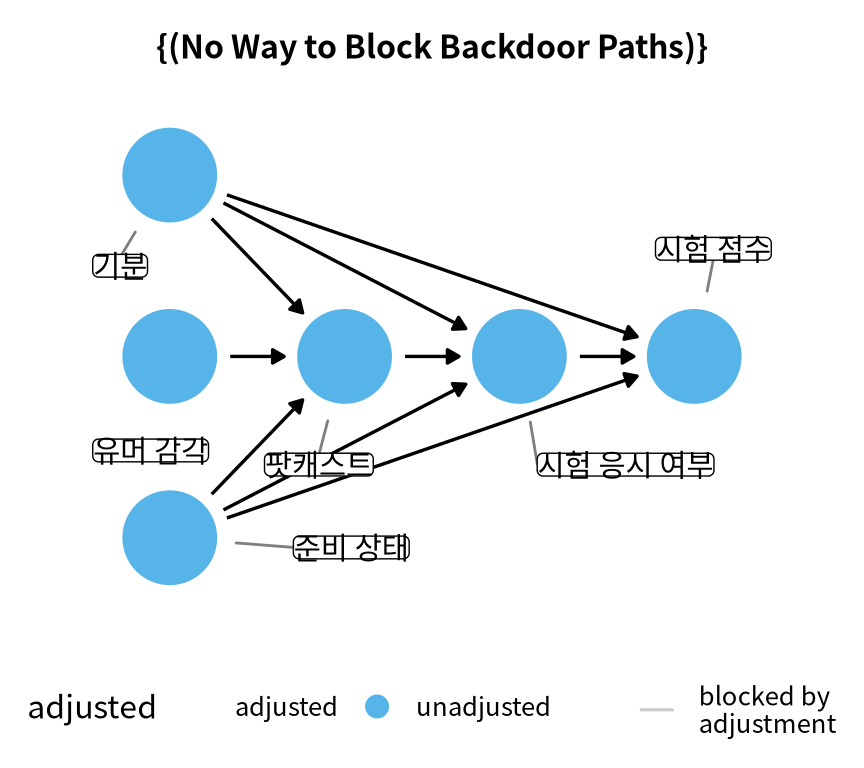
podcast_dag3에 대한 조정 집합. 이 경우, podcast가 exam에 미치는 총 효과에 대해 편향되지 않은 추정치를 복구할 방법이 없습니다.
이런 상황에서도 여러분이 추정하고자 하는 추정 대상을 변경함으로써 여전히 효과를 추정할 수 있는 경우가 있습니다. 우리는 간접 효과를 놓치고 있기 때문에 총 효과를 계산할 수는 없지만, podcast가 exam에 미치는 직접 효과는 여전히 계산할 수 있습니다.
podcast_dag3 |>
  adjust_for("showed_up") |>
  ggdag_adjustment_set(effect = "direct", use_text = FALSE, use_labels = TRUE)
Warning: Removed 3 rows containing missing values or values
outside the scale range (`geom_label_repel()`).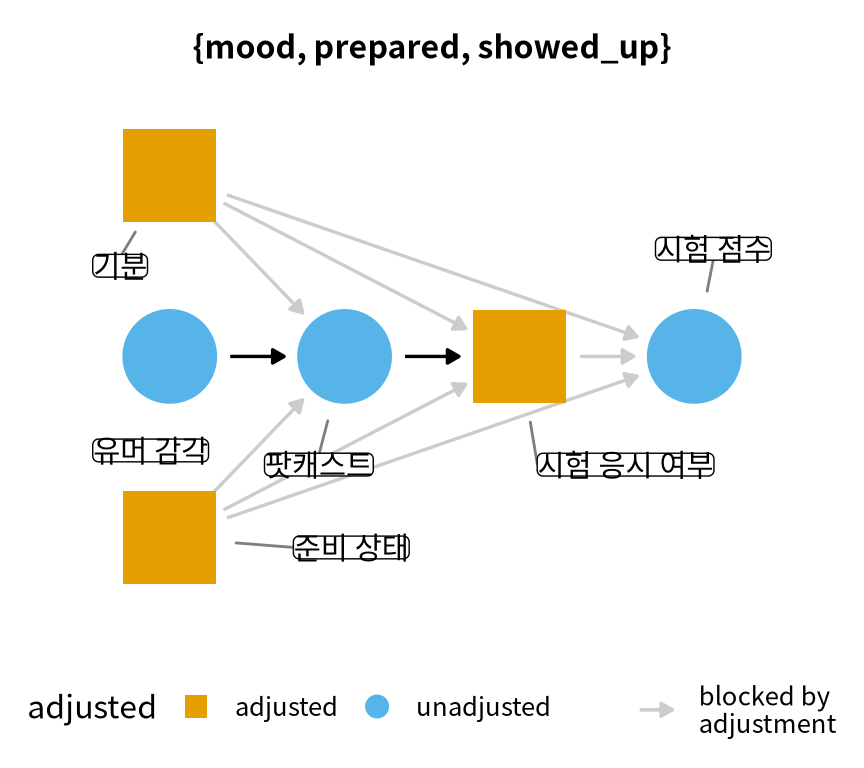
podcast_dag3에 대한 조정 집합. podcast가 exam에 미치는 직접 효과를 추정하기 위해 사용할 수 있는 하나의 최소 조정 집합이 있습니다.
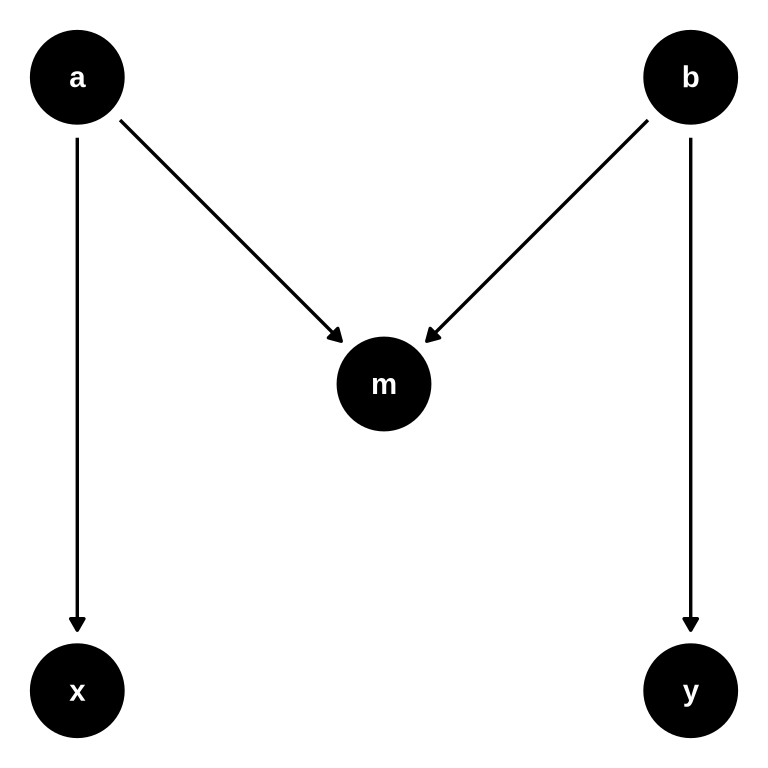
사람들이 자주 이야기하는 선택 편향의 특별한 사례 중 하나는 M-편향(M-bias)입니다. 위에서 아래로 배치했을 때 M자 모양처럼 보이기 때문에 M-편향이라고 불립니다.
ggdag에는 confounder_triangle(), collider_triangle(), m_bias(), butterfly_bias() 등 기본적인 인과 구조를 보여주기 위한 몇 가지 ‘빠른 DAG(quick-DAGs)’ 함수들이 있습니다.
M-편향에서 이론적으로 흥미로운 점은 m이 콜라이더이지만 x와 y보다 먼저 발생한다는 것입니다. 연관성은 콜라이더에서 차단되므로, x와 y 사이에는 열린 경로가 없음을 기억하십시오.
팟캐스트-시험 DAG의 mood 경로에 집중해 봅시다. 만약 우리가 기분에 대해 틀렸고, 실제 관계가 M자 모양이었다면 어떨까요? mood가 podcast와 exam을 유발하는 것이 아니라, 그림 4.23 에서처럼 podcast와 exam의 두 공통 원인인 u1과 u2에 의해 mood 자체가 유발되었다고 가정해 봅시다. 우리는 u1과 u2가 무엇인지 모르고, 측정하지도 않았습니다. 위와 마찬가지로, 이 DAG의 하위 집합에는 열린 경로가 없습니다.
podcast_dag4 <- dagify(
  podcast ~ u1,
  exam ~ u2,
  mood ~ u1 + u2,
  coords = time_ordered_coords(list(
    c("u1", "u2"),
    "mood",
    "podcast",
    "exam"
  )),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "기분",
    u1 = "측정되지 않음",
    u2 = "측정되지 않음"
  ),
  # 측정되지 않은 변수들
  latent = c("u1", "u2")
)

ggdag(podcast_dag4, use_labels = TRUE, use_text = FALSE)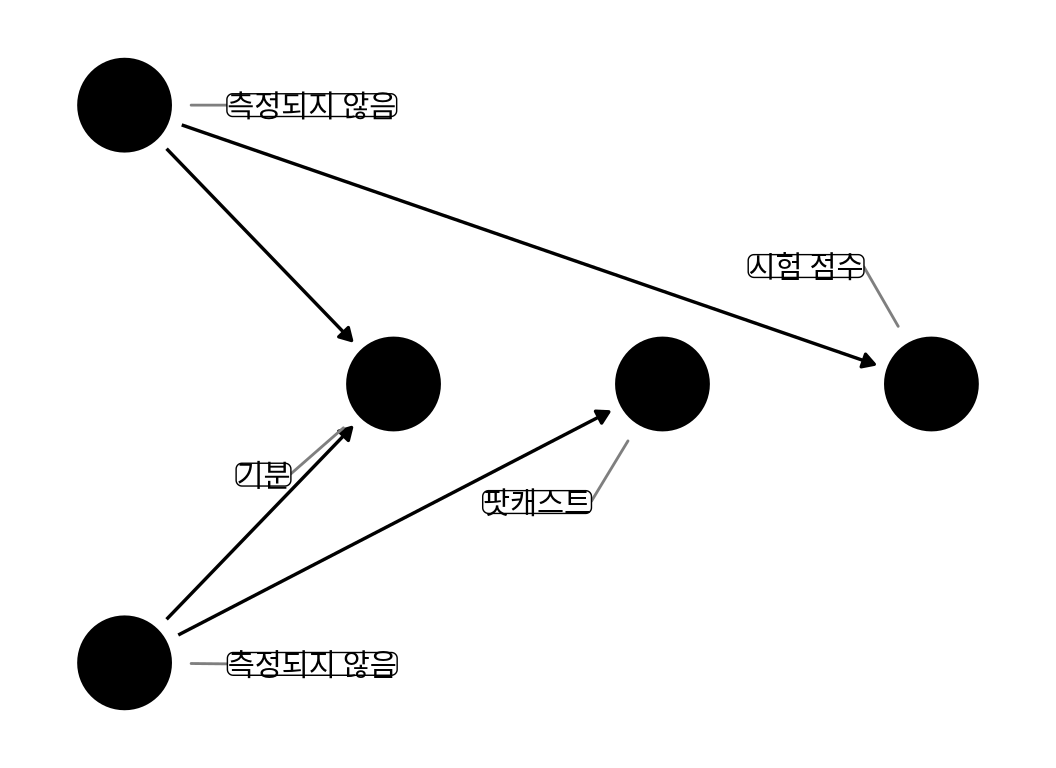
mood가 M자형 경로 상의 콜라이더인 상황을 나타내도록 그림 4.9 를 재구성한 DAG.
문제는 우리의 원래 DAG가 맞다고 생각할 때 발생합니다: mood가 조정 집합에 포함되어 있어서 이를 통제하게 됩니다. 하지만 이는 편향을 유발합니다! 그것은 u1과 u2 사이의 경로를 열어주어, 결과적으로 podcast에서 exam으로 가는 경로를 생성합니다. 만약 우리가 u1이나 u2 중 하나라도 측정했다면, 이 경로를 닫기 위해 조정할 수 있겠지만, 우리는 그렇지 못합니다. 이 열린 경로를 닫을 방법이 없습니다.
podcast_dag4 |>
  adjust_for("mood") |>
  ggdag_adjustment_set(use_labels = TRUE, use_text = FALSE)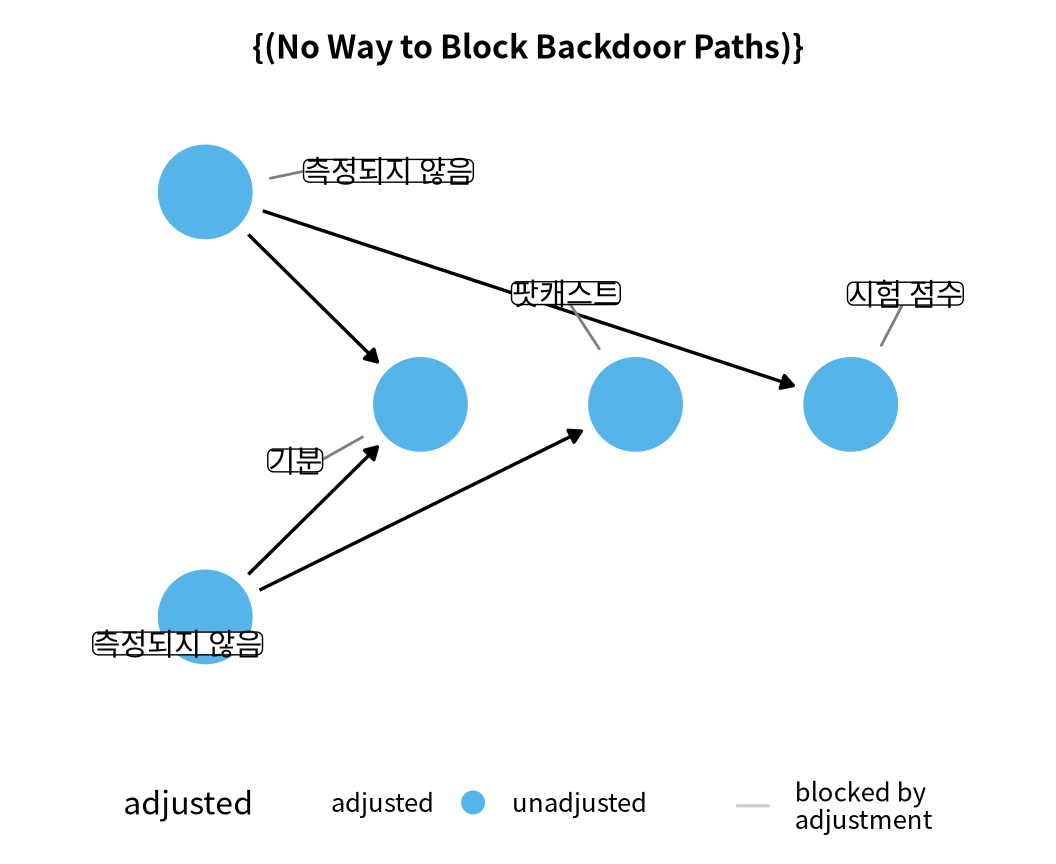
mood가 콜라이더인 경우의 조정 집합. 만약 우리가 mood를 통제하면서 mood를 유발하는 측정되지 않은 원인들에 대해 모르거나 가지고 있지 않다면, 콜라이더를 조정함으로써 열린 백도어 경로를 닫을 방법이 없습니다.
물론 여기서 가장 좋은 것은 mood를 전혀 통제하지 않는 것입니다. 하지만 때때로 그것이 선택 사항이 아닐 수도 있습니다. 만약 mood 대신 이것이 showed_up의 실제 구조라고 가정해 보십시오: 우리는 본질적으로 showed_up을 통제하고 있고 측정되지 않은 변수들이 없기 때문에, 우리 연구 결과는 항상 편향될 것입니다. 우리가 그러한 상황에 처해 있는지 이해하는 것은 필수적이며, 그래야만 민감도 분석을 통해 효과가 얼마나 편향될지 파악하고 대처할 수 있습니다.
mood가 podcast와 exam을 유발하고, u1과 u2가 mood와 노출 및 결과의 공동 원인인 M-편향의 변형을 고려해 봅시다. 이 배치는 그 모양 때문에 때때로 나비(butterfly) 또는 나비넥타이(bowtie) 편향이라고 불립니다.
butterfly_bias(x = "podcast", y = "exam", m = "mood", a = "u1", b = "u2") |>
  ggdag(use_text = FALSE, use_labels = TRUE)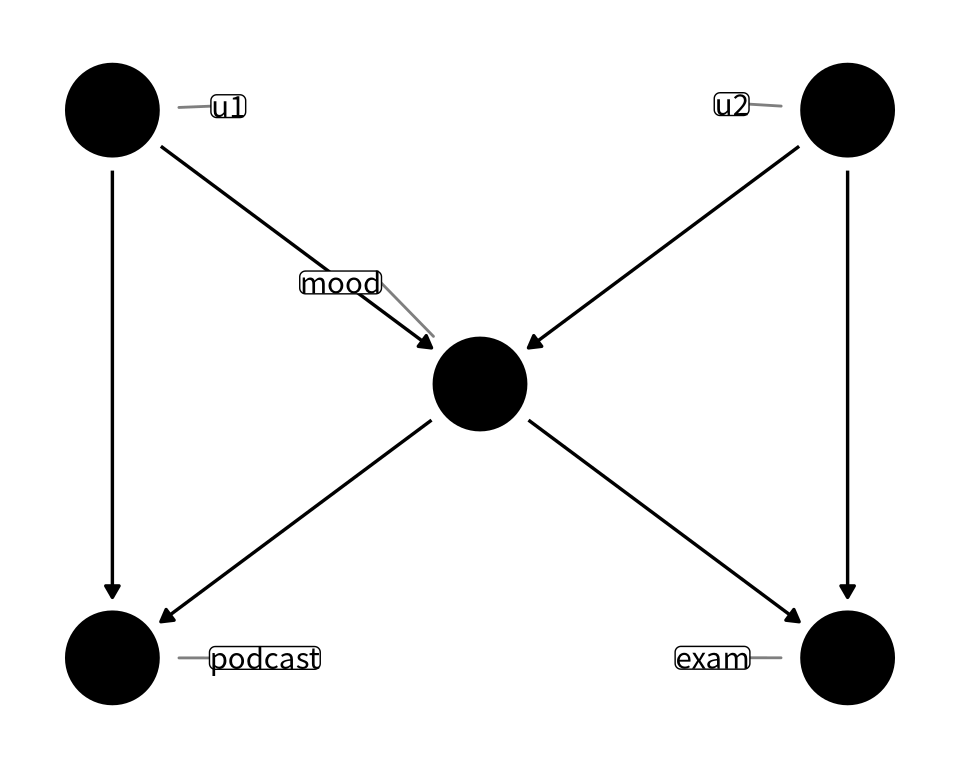
mood는 콜라이더이자 교란 요인입니다. mood에 의한 편향을 통제하는 것은 콜라이더를 조건부화했기 때문에 새로운 경로를 열게 됩니다. 우리는 u1이나 u2 없이는 모든 백도어 경로를 적절히 닫을 수 없습니다.
이제 우리는 어려운 상황에 처해 있습니다: mood가 교란 요인이기 때문에 통제해야 하지만, mood를 통제하면 u1에서 u2로 가는 경로가 열립니다. 우리는 두 변수 중 어느 것도 측정하지 않았기 때문에, mood에 대한 조건부화로 인해 열린 경로를 닫을 수 없습니다. 어떻게 해야 할까요? 의심스러울 때는 mood를 통제하는 것이 두 옵션 중 더 낫다는 것이 밝혀졌습니다: 교란 편향은 대개 콜라이더 편향보다 더 심각한 경향이 있고, 콜라이더의 M자형 구조는 미세한 편차에 민감하기 때문입니다(예: 이것이 정확한 구조가 아니라면 종종 편향이 그렇게 나쁘지 않습니다) (Ding 와/과 Miratrix 2015).
선택 편향의 또 다른 흔한 형태는 추적 관찰 소실(loss-to-follow-up)로 인한 것입니다: 사람들이 노출 및 결과와 관련된 방식으로 연구에서 중도 탈락하는 경우입니다. 우리는 장 18 에서 이 주제로 다시 돌아올 것입니다.
중요한 또 다른 유형의 인과 구조를 살펴봅시다: 노출의 원인이지만 결과의 원인은 아닌 경우와, 그 반대로 결과의 원인이지만 노출의 원인은 아닌 경우입니다. 원래의 DAG에 grader_mood(채점자의 기분)라는 변수를 추가해 보겠습니다.
podcast_dag5 <- dagify(
  podcast ~ mood + humor + prepared,
  exam ~ mood + prepared + grader_mood,
  coords = time_ordered_coords(
    list(
      # 시점 1
      c("prepared", "humor", "mood"),
      # 시점 2
      c("podcast", "grader_mood"),
      # 시점 3
      "exam"
    )
  ),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "학생의 기분",
    humor = "유머 감각",
    prepared = "준비 상태",
    grader_mood = "채점자의 기분"
  )
)
ggdag(podcast_dag5, use_labels = TRUE, use_text = FALSE)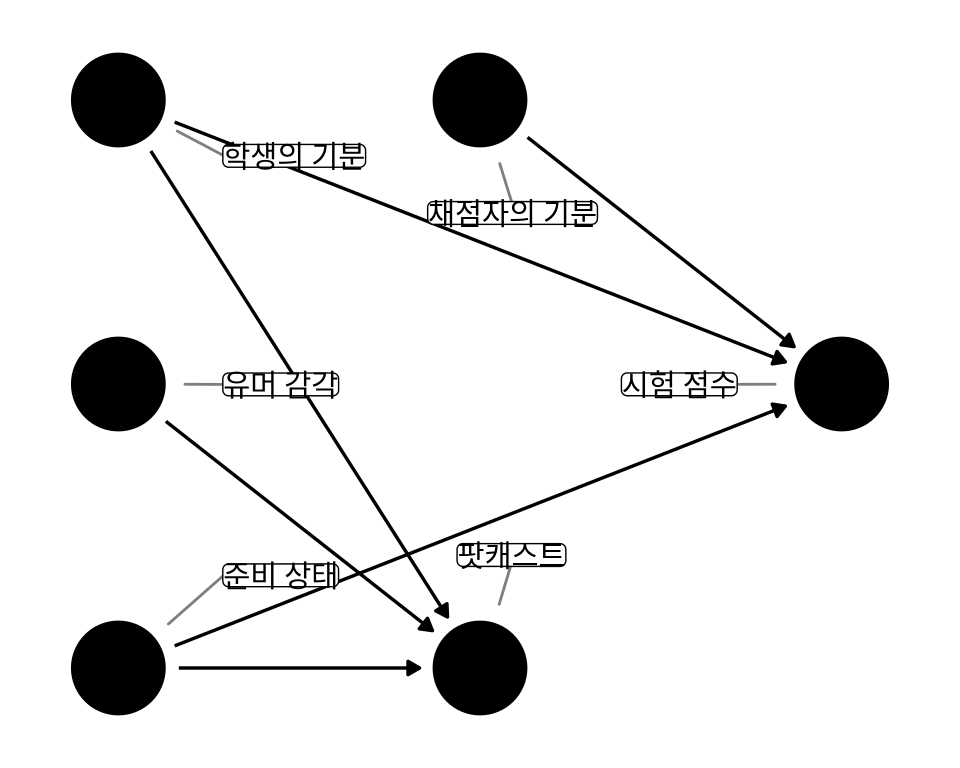
humor)와, 결과의 원인이지만 노출의 원인은 아닌 변수(grader_mood)를 포함하는 DAG.
이제 노출과 결과 둘 다와 관련되지는 않은 두 개의 변수가 있습니다: podcast를 유발하지만 exam은 유발하지 않는 humor, 그리고 exam을 유발하지만 podcast는 유발하지 않는 grader_mood입니다. 먼저 humor부터 살펴보겠습니다.
노출을 유발하지만 결과는 유발하지 않는 변수들을 도구 변수(instrumental variables, IVs)라고도 부릅립니다. IV는 특정 조건 하에서 이를 통제하면 다른 유형의 편향을 더 악화시킬 수 있는 특이한 상황입니다. 이 방식이 독특한 이유는, IV가 노출이 결과에 미치는 편향되지 않은 효과를 추정하기 위한 완전히 다른 접근 방식을 수행하는 데에도 사용될 수 있다는 점입니다. IV는 계량경제학에서 흔히 사용되며 다른 분야에서도 점점 더 인기를 얻고 있습니다. 요컨대, IV 분석은 지금까지 우리가 이야기한 접근 방식들과는 다른 가정 세트를 사용하여 인과 효과를 추정할 수 있게 해줍니다. 때때로 성향 점수 방법으로는 해결하기 힘든 문제를 IV를 사용하여 해결할 수 있으며, 그 반대의 경우도 마찬가지입니다. 우리는 장 22 에서 IV에 대해 더 자세히 이야기할 것입니다.
그렇다면 IV 방법을 사용하지 않는 경우, 교란을 해결하기 위해 고안된 모델에 IV를 포함해야 할까요? 그 변수가 IV인지 아닌지 확실하지 않다면, 아마도 모델에 추가해야 할 것입니다: 그것이 IV일 확률보다는 교란 요인일 확률이 더 높으며, 실제로 IV를 추가함으로써 발생하는 편향은 대개 작기 때문입니다. 따라서 잠재적인 M-구조 변수를 조정하는 것과 마찬가지로, 교란으로 인한 편향의 위험이 더 큽니다 (Myers 기타 2011).
이제 IV의 반대인, 노출의 원인은 아니지만 결과의 원인인 변수에 대해 이야기해 봅시다. 이러한 변수들은 때때로 경쟁 노출(competing exposures)(결과를 유발하기도 하기 때문) 또는 정밀도 변수(precision variables)(나중에 보겠지만, 인과 추정치의 정밀도를 높여주기 때문)라고 불립니다. 우리는 이 변수들이 다른 연구 질문에서는 노출일 수 있지만 현재 다루고 있는 연구 질문과의 관계에 집중하고 있으므로 정밀도 변수라고 부르겠습니다 (Brookhart 기타 2006).
IV와 마찬가지로, 정밀도 변수는 노출에서 결과로 가는 경로 상에 존재하지 않습니다. 따라서 이들을 포함하는 것이 필수적인 것은 아닙니다. 하지만 IV와 달리, 정밀도 변수를 포함하는 것은 유익합니다. 결과의 다른 원인들을 포함하는 것은 통계 모델이 결과의 변동성 중 일부를 포착하는 데 도움이 됩니다. 이것이 효과의 점 추정치에는 영향을 미치지 않지만, 분산을 감소시켜 표준 오차를 작게 하고 신뢰 구간을 좁게 만듭니다. 따라서 가능하면 이들을 포함할 것을 권장합니다.
그러므로 grader_mood를 통제할 필요는 없더라도, 데이터셋에 있다면 포함해야 합니다. 마찬가지로 humor는 그것이 정말로 교란 요인일 수 있다고 생각되지 않는 한 모델에 추가하는 것이 좋지 않습니다; 만약 그것이 유효한 도구 변수라면, 대신 IV 방법을 사용하여 효과를 추정하는 것을 고려해 볼 수 있습니다.
DAG는 또한 데이터의 오측정(mismeasurements)으로부터 발생하는 편향을 이해하는 데 도움을 줄 수 있습니다. 여기에는 가장 최악의 오측정인 ’전혀 측정하지 않음’도 포함됩니다. 우리는 장 15 에서 이러한 주제들을 다룰 것이지만, 기본 아이디어는 실제 값과 관찰된 값을 분리함으로써 그러한 편향들이 어떻게 작용하는지 더 잘 이해할 수 있다는 것입니다 (Hernan 와/과 Cole 2009). 여기에 회상 편향(recall bias)이라고 불리는 편향의 기본적인 예시가 있습니다. 회상 편향은 결과가 참가자의 노출에 대한 기억에 영향을 미칠 때 발생하며, 특히 결과가 발생한 후에야 이전의 노출이 기록되는 후향적 연구에서 문제가 됩니다. 이러한 현상이 발생할 수 있는 예로 암에 대한 환자-대조군 연구가 있습니다. 암에 걸린 사람은 암에 걸리지 않은 사람보다 과거의 노출에 대해 더 많이 반추하려는 동기가 강할 수 있습니다. 따라서 특정 노출에 대한 그들의 기억은 그렇지 않은 사람보다 더 정교해질 수 있습니다.
error_dag <- dagify(
  exposure_observed ~ exposure_real + exposure_error,
  outcome_observed ~ outcome_real + outcome_error,
  outcome_real ~ exposure_real,
  exposure_error ~ outcome_real,
  labels = c(
    exposure_real = "노출\n(실제값)",
    exposure_error = "측정 오차\n(노출)",
    exposure_observed = "노출\n(관찰값)",
    outcome_real = "결과\n(실제값)",
    outcome_error = "측정 오차\n(결과)",
    outcome_observed = "결과\n(관찰값)"
  ),
  exposure = "exposure_real",
  outcome = "outcome_real",
  coords = time_ordered_coords()
)

error_dag |>
  ggdag(use_text = FALSE, use_labels = TRUE)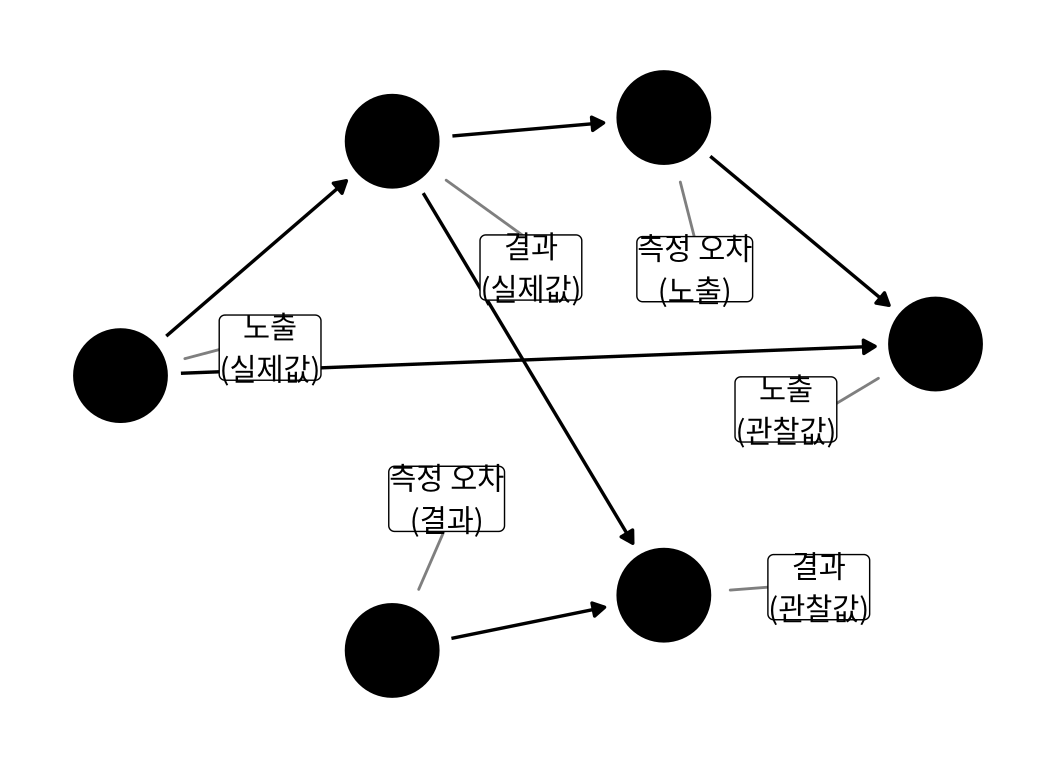
원칙적으로 DAG를 사용하는 것은 쉽습니다: 존재한다고 생각하는 인과 관계들을 명시하고, 유효한 조정 집합과 같은 정보를 위해 DAG를 쿼리하면 됩니다. 실무적으로 DAG를 구축하는 데는 상당한 시간과 노력이 필요합니다. 연구 질문 자체가 정의하는 것 다음으로, 이는 인과 추론을 하는 데 있어 가장 어려운 단계 중 하나입니다. DAG 구축의 모범 사례에 대한 지침은 거의 존재하지 않습니다. Tennant 기타 (2020) 은 연구자들이 DAG를 어떻게 사용하는지 더 잘 이해하기 위해 응용 건강 연구에서 사용된 DAG 데이터를 수집했습니다. 표 4.1 는 그들이 수집한 몇 가지 정보를 보여줍니다: DAG에 포함된 노드와 아크의 수의 중앙값, 그 비율, DAG의 포화도(saturation percent), 그리고 얼마나 많은 DAG가 완전히 포화되었는지 등입니다. DAG를 포화시킨다는 것은 시간상 앞으로 나아가는 모든 가능한 화살표를 추가하는 것을 의미합니다. 예를 들어, 완전히 포화된 DAG에서는 시점 1의 임의의 변수가 미래 시점의 모든 변수로 향하는 화살표를 갖게 됩니다. 대부분의 DAG는 약 절반 정도만 포화되었으며, 완전히 포화된 DAG는 거의 없었습니다.
DAG를 사용한 논문의 약 절반만이 사용된 조정 집합을 보고했습니다. 다시 말해, 연구자들은 연구 질문에 대한 자신들의 가정을 제시했지만, 모델링 단계를 어떻게 처리해야 하는지에 대한 함의나 유효한 조정 집합을 사용했는지 여부는 제시하지 않았습니다. 마찬가지로, 대다수의 연구가 관심 있는 추정 대상(estimand)을 보고하지 않았습니다.
추정 대상은 우리가 무엇을 추정하려고 하는지에 대한 목표이며, Chapter 2 에서 간략히 논의되었습니다. 우리는 Chapter 10 에서 추정 대상에 대해 자세히 다룰 것입니다.
| Characteristic | N = 1441 |
|---|---|
| DAG 속성 | |
| Number of Nodes | 12 (9, 16) |
| Number of Arcs | 29 (19, 42) |
| Node to Arc Ratio | 2.30 (1.75, 3.00) |
| Saturation Proportion | 0.46 (0.31, 0.67) |
| Fully Saturated | |
| Yes | 4 (3%) |
| No | 140 (97%) |
| 보고 현황 | |
| Reported Estimand | |
| Yes | 40 (28%) |
| No | 104 (72%) |
| Reported Adjustment Set | |
| Yes | 80 (56%) |
| No | 64 (44%) |
| 1 Median (Q1, Q3); n (%) | |
이 섹션에서는 Tennant 기타 (2020) 과 우리의 DAG 구축 경험을 바탕으로 몇 가지 조언을 드리고자 합니다.
연구 결과의 품질을 위해 할 수 있는 가장 좋은 일 중 하나는 연구를 수행하기 전, 이상적으로는 데이터를 수집하기 전에도 DAG를 만드는 것입니다. 이미 데이터를 가지고 작업 중이라면, 최소한 데이터 분석을 하기 전에 DAG를 구축하십시오. 이 조언은 사전 등록된 분석 계획(pre-registered analysis plans)과 맥락을 같이 합니다: 미리 가정을 선언하는 것은 여러분이 무엇을 해야 할지 명확히 하는 데 도움이 되고, 과적합(overfitting)의 위험(예: 데이터로부터 교란 요인을 잘못 결정하는 것)을 줄여주며, 여러분의 DAG에 대한 피드백을 받을 시간을 제공합니다.
이 마지막 이점은 매우 중요합니다: 이상적으로 여러분의 DAG를 민주화해야 합니다. 데이터, 도메인, 그리고 모델 전문가인 다른 사람들과 조기에 그리고 자주 공유하십시오. DAG를 만들고 동료들에게 제시했을 때, 중요한 것을 놓쳤다는 것을 깨닫는 것은 자연스러운 일입니다. 때때로 여러분은 구조의 일부 세부 사항에 대해서만 합의하게 될 것입니다. 그것은 좋은 일입니다: 이제 여러분은 DAG의 어디에 불확실성이 있는지 알게 된 것입니다. 그런 다음 여러 가능한 DAG로부터의 결과를 검토하거나 민감도 분석을 통해 불확실성을 다룰 수 있습니다.
후보 DAG가 하나 이상이라면, 그들의 조정 집합을 확인하십시오. 만약 두 DAG가 공통으로 가진 조정 집합이 있다면, 그 집합들에 집중하십시오; 그러면 여러분이 가진 그럴듯한 가정들을 충족하는 방식으로 나아갈 수 있습니다.
그림 4.19 에서 보았듯이, 어떤 질문들은 특정 데이터로 답하기 어려울 수 있는 반면, 다른 질문들은 더 접근하기 쉬울 수 있습니다. 여러분은 정확히 무엇을 추정하고 싶은지 고려해야 합니다. 목표 추정치(target estimate)를 정의하는 것은 중요한 주제이며 Chapter 10 의 주제이기도 합니다.
여러분의 DAG가 질문과 어떻게 관련되는지에 대한 또 다른 중요한 세부 사항은 인구(population)와 시간입니다. 많은 인과 구조는 시간과 공간에 따라 정지해 있지 않습니다. 폐암을 생각해 보십시오: 폐암의 원인 분포는 흡연이 확산되기 전에는 상당히 달랐습니다. 수 세기 전 아메리카 대륙으로부터 담배가 확산되기 전의 중세 일본에서 폐암의 인과 구조는 담배 사용과 기타 요인(인구 연령 등) 측면에서 오늘날의 일본과는 실질적으로 달랐을 것입니다.
교란 요인에 대해서도 마찬가지입니다. 어떤 것이 노출과 결과를 유발할 수 있다 하더라도, 분석 중인 인구 집단에서 그 요인의 유병률(prevalence)이 0이라면 그것은 인과적 질문과 무관합니다. 또한 어떤 인구 집단에서는 그것이 둘 중 하나에 영향을 미치지 않을 수도 있습니다. 그 반대도 마찬가지입니다: 어떤 것은 대상 인구 집단에만 고유할 수도 있습니다. 수 세기 전 북미에서의 담배 사용은 전 세계 인구 중에서 독특한 것이었습니다. 비록 당시의 의례적인 담배 사용은 현대의 기호용 사용과는 꽤 달랐지만 말입니다. 많은 변화가 수 세기에 걸쳐서처럼 극적으로 일어나지는 않겠지만, 때때로 그러한 일이 발생합니다. 예를 들어, 한 국가의 규제가 특정 요인에 대한 인구의 노출을 효과적으로 제거하는 경우가 그렇습니다.
앞서 논의했듯이, 변수들을 왼쪽에서 오른쪽으로 또는 위에서 아래로 시간 순서대로 배치할 것을 권장합니다. 여기에는 두 가지 이유가 있습니다. 첫째, 시간 순서는 여러분의 가정에서 필수적인 부분입니다. 결국, 어떤 것이 원인이 되기 위해서는 다른 것보다 먼저 일어나야 하기 때문입니다. 이를 신중하게 생각하는 것은 여러분의 DAG와 다루어야 할 변수들을 명확하게 해줄 것입니다.
둘째, 일정 수준 이상의 복잡성을 넘어서면 시간순으로 배치되었을 때 DAG를 읽기가 더 쉽습니다. 그 차원에 대해 덜 생각해도 되기 때문입니다; 그것은 레이아웃에 내재되어 있습니다. ggdag의 시간 순서 알고리즘은 이를 상당 부분 자동화해 주지만, 앞서 보았듯이 때때로 순서에 대한 더 많은 정보를 제공하는 것이 도움이 됩니다.
관련된 주제로 피드백 루프(feedback loops)가 있습니다 (Murray 와/과 Kunicki 2022). 종종 우리는 서로를 유발하는 두 가지 요인이 지구 온난화와 에어컨 사용처럼 원을 그리며 일어난다고 생각합니다(에어컨 사용은 지구 온난화를 증가시키고, 이는 날씨를 더 덥게 만들며, 다시 에어컨 사용을 증가시키는 식입니다). 그 관계를 다음과 같이 시각화하고 싶은 유혹이 생깁니다:
Warning in tidy_dagitty(.dagitty, ...): Graph contains a cycle and is not a valid DAG.
! Cycle detected: ac_use -> global_temp -> ac_use
ℹ Causal diagram algorithms require acyclic graphs.
ℹ Consider revising your DAG specification.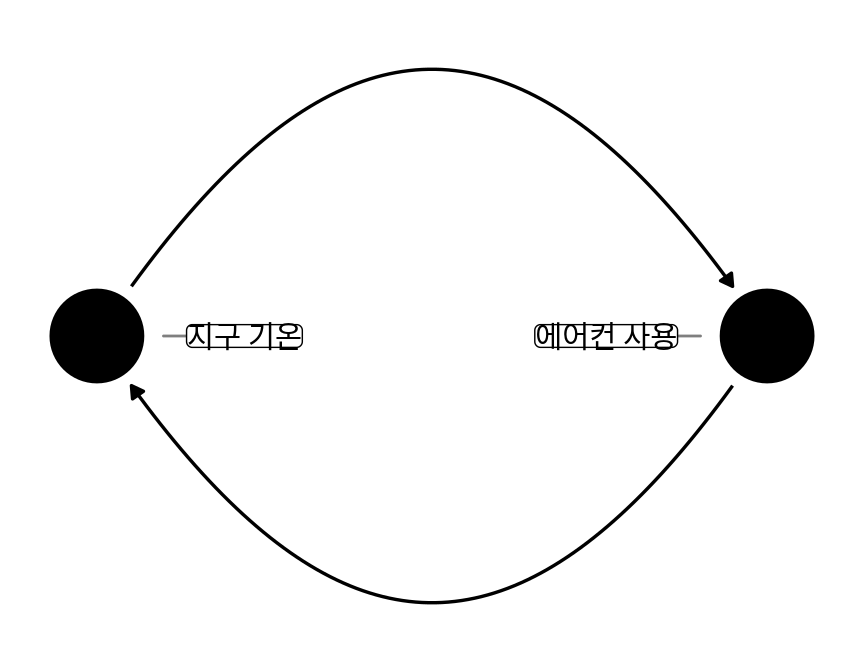
DAG의 관점에서 볼 때, 이것은 DAG의 A(비순환) 부분 때문에 문제가 됩니다: 그것은 순환적입니다! 하지만 중요한 것은, 인과적 관점에서도 이것이 옳지 않다는 점입니다. 피드백 루프는 실제로 일어나는 일에 대한 속기일 뿐이며, 실제로는 두 변수가 시간에 따라 서로에게 영향을 미치는 것입니다. 인과 관계는 오직 시간상 앞으로만 나아가기 때문에, 그림 4.28 처럼 앞뒤로 왔다 갔다 하는 것은 말이 되지 않습니다.
실제 DAG는 다음과 같은 모습일 것입니다:
dagify(
  global_temp_2000 ~ ac_use_1990 + global_temp_1990,
  ac_use_2000 ~ ac_use_1990 + global_temp_1990,
  global_temp_2010 ~ ac_use_2000 + global_temp_2000,
  ac_use_2010 ~ ac_use_2000 + global_temp_2000,
  global_temp_2020 ~ ac_use_2010 + global_temp_2010,
  ac_use_2020 ~ ac_use_2010 + global_temp_2010,
  coords = time_ordered_coords(),
  labels = c(
    ac_use_1990 = "에어컨 사용\n(1990)",
    global_temp_1990 = "지구 기온\n(1990)",
    ac_use_2000 = "에어컨 사용\n(2000)",
    global_temp_2000 = "지구 기온\n(2000)",
    ac_use_2010 = "에어컨 사용\n(2010)",
    global_temp_2010 = "지구 기온\n(2010)",
    ac_use_2020 = "에어컨 사용\n(2020)",
    global_temp_2020 = "지구 기온\n(2020)"
  )
) |>
  ggdag(use_text = FALSE, use_labels = TRUE)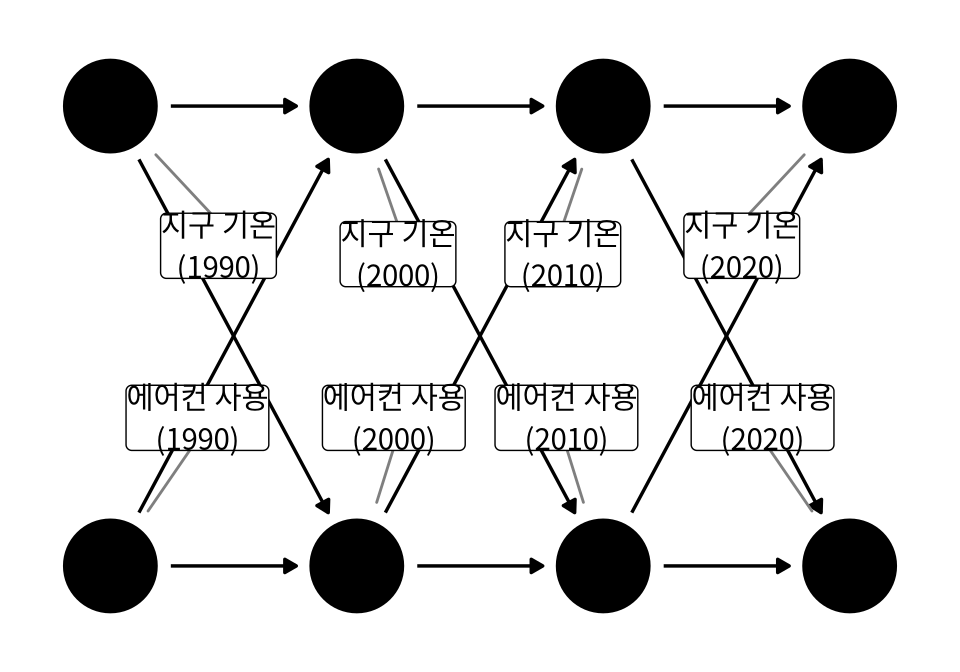
두 변수는 피드백 루프에 있는 것이 아니라, 실제로는 피드포워드 루프에 있습니다: 그들은 시간에 따라 함께 진화합니다. 여기서는 네 개의 불연속적인 시점(1990년부터 2020년까지의 10년 단위)만 보여주었지만, 질문과 데이터에 따라 훨씬 더 세밀하게 나눌 수도 있습니다.
다른 모든 DAG와 마찬가지로, 적절한 분석 접근 방식은 질문에 달려 있습니다. 2000년의 에어컨 사용이 2020년의 지구 기온에 미치는 효과는, 2000년의 지구 기온이 2020년의 에어컨 사용에 미치는 효과와는 다른 조정 집합을 생성합니다. 마찬가지로, 우리가 이 변화를 시간의 흐름에 따라 모델링할지 아니면 단지 그 두 시점만 모델링할지 여부도 질문에 따라 달라집니다. 종종 이러한 피드포워드 관계는 여러분이 시간 가변적 교란(time-varying confounding)을 다루어야 함을 의미하며, 우리는 이에 대해 Chapter 18 에서 논의할 것입니다.
그림 4.19 가 보여주었듯이, 질문의 인과 구조만큼이나 우리가 데이터를 수집한 방법을 고려하는 것이 필수적입니다. 전체 데이터 수집 과정을 고려하는 것은 “발견된(found)” 데이터 — 연구 질문에 답하기 위해 의도적으로 수집되지 않은 데이터셋 — 로 작업할 때 특히 중요합니다. 우리는 항상 우리가 가진 데이터와 가지지 못한 데이터에 대해 본질적으로 조건부화하고 있습니다. 만약 인과 구조에서 데이터 수집 과정에 영향을 미친 다른 변수들이 있다면, 그 영향을 고려해야 합니다. 추가적인 변수들을 통제해야 할까요? 추정하고자 하는 효과를 변경해야 할까요? 그 질문에 답하는 것이 아예 가능하기는 할까요?
역학에서 표준적인 연구 설계 중 하나는 환자-대조군 연구(case-control study)입니다. 환자-대조군 연구는 연구 대상인 결과가 희귀하거나 발생하기까지 매우 오랜 시간이 걸릴 때(많은 종류의 암과 같이) 유익합니다. 참가자들은 그들의 결과에 따라 연구 대상으로 선택됩니다: 일단 어떤 사람에게 사건이 발생하면 그들은 ’환자(case)’로 등록되고, 사건이 발생하지 않은 ’대조군(control)’과 매칭됩니다. 종종 그들은 다른 요인들에 대해서도 매칭됩니다.
매칭된 환자-대조군 연구는 설계상 선택 편향(selection bias)을 갖습니다 (Mansournia, Hernán, 와/과 Greenland 2013). 그림 4.30 에서 우리가 연구 대상으로의 선택에 대해 조건부화할 때, 우리는 confounder를 통제하더라도 모든 백도어 경로를 닫을 수 있는 능력을 잃게 됩니다. DAG로만 보면, 전체 설계가 무효인 것처럼 보일 것입니다!
dagify(
  outcome ~ confounder + exposure,
  selection ~ outcome + confounder,
  exposure ~ confounder,
  exposure = "exposure",
  outcome = "outcome",
  coords = time_ordered_coords()
) |>
  ggdag(edge_type = "arc", text_size = 2.2)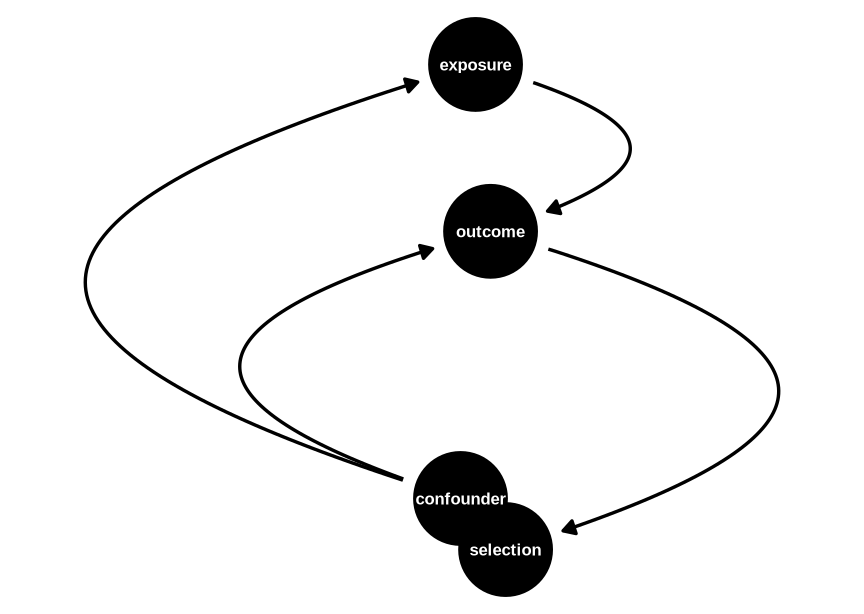
다행히도 이것이 전적으로 사실은 아닙니다. 환자-대조군 연구는 추정할 수 있는 인과 효과의 유형에 제한이 있지만(특정 상황에서 인과적 위험비에 근사하는 인과적 오즈비), 신중한 연구 설계와 샘플링을 통해 수학적으로 이러한 추정치들이 여전히 유효하도록 작동합니다. 환자-대조군 연구가 정확히 어떻게 그리고 왜 작동하는지는 이 책의 범위를 벗어나지만, 그것은 매우 영리한 설계 방식입니다.
데이터에서 측정한 변수들뿐만 아니라 인과 구조에 중요한 모든 변수들을 포함하는 것이 매우 중요합니다. ggdag는 측정되지 않은 변수들을 “잠재적(latent)” 변수로 표시할 수 있습니다; 그러면 측정되지 않은 변수가 없는 사용 가능한 조정 집합들만 반환할 것입니다. 물론 가장 좋은 것은 처음부터 무엇을 측정해야 할지 이해하는 데 DAG를 사용하는 것이지만, 데이터가 그와 다를 수 있는 많은 이유가 있습니다. 연구 질문을 위해 의도적으로 수집된 데이터조차도 데이터 수집 후에야 교란 요인으로 밝혀진 변수를 포함하지 못할 수 있습니다.
예를 들어, exposure와 outcome 사이에 confounder1과 confounder2로 구성된 교란 경로가 있는 DAG가 있다면, 우리는 추정치의 편향을 성공적으로 제거하기 위해 둘 중 하나를 통제할 수 있습니다:
dagify(
  outcome ~ exposure + confounder1,
  exposure ~ confounder2,
  confounder2 ~ confounder1,
  exposure = "exposure",
  outcome = "outcome"
) |>
  adjustmentSets()
{ confounder1 }
{ confounder2 }따라서 단 하나만 누락(latent)되었다면 괜찮습니다:
dagify(
  outcome ~ exposure + confounder1,
  exposure ~ confounder2,
  confounder2 ~ confounder1,
  exposure = "exposure",
  outcome = "outcome",
  latent = "confounder1"
) |>
  adjustmentSets()
{ confounder2 }하지만 둘 다 누락되었다면 유효한 조정 집합이 존재하지 않습니다.
변수를 측정하지 못했을 때도 여전히 몇 가지 옵션이 있습니다. 앞서 언급했듯이, 대안적인 조정 집합을 식별할 수 있을 수도 있습니다. 만약 누락된 변수가 모든 백도어 경로를 완전히 닫는 데 필수적이라면, 그 변수가 없을 때의 영향을 이해하기 위해 민감도 분석을 수행할 수 있고 또 수행해야 합니다. 이것이 Chapter 16 의 주제입니다.
운이 좋은 상황이라면, 대리 교란 요인 (proxy confounder)을 사용할 수도 있습니다 (Miao, Geng, 와/과 Tchetgen Tchetgen 2018). 대리 교란 요인은 누락된 변수의 효과 중 일부를 통제해 줄 수 있을 정도로 그 변수와 밀접하게 관련된 변수입니다. 그림 4.31 처럼 q가 원인 p를 갖는 기본적인 교란 관계의 확장을 고려해 봅시다. 엄밀히 말하면 q가 없다면 백도어 경로를 닫을 수 없고 우리의 효과는 편향될 것입니다. 하지만 실무적으로 p가 q와 높은 상관관계를 갖는다면, p는 q로부터의 교란을 줄이는 수단이 될 수 있습니다. 여러분은 p를 q가 오측정된 버전으로 생각할 수 있습니다; 그것이 q를 통한 편향을 완전히 통제해 주는 경우는 드물겠지만, 최소화하는 데는 도움을 줄 수 있습니다.
dagify(
  y ~ x + q,
  x ~ q,
  q ~ p,
  coords = time_ordered_coords()
) |>
  ggdag(edge_type = "arc")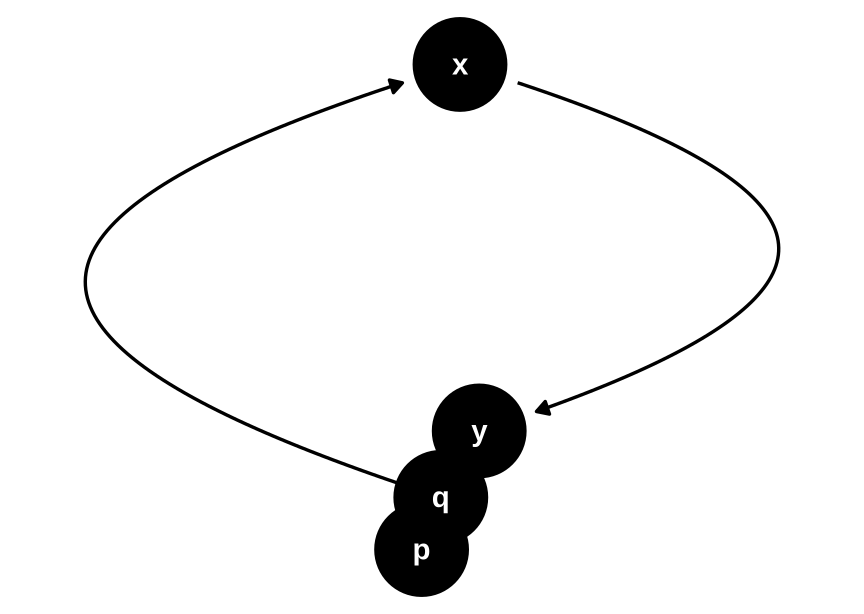
q와 대리 교란 요인 p가 포함된 DAG. 진정한 조정 집합은 q입니다. p가 q를 유발하므로, p는 q에 대한 정보를 포함하고 있으며 우리가 q를 측정하지 못했을 때 편향을 줄여줄 수 있습니다.
표 4.1 를 논의할 때 포화된 (saturated) DAG를 언급했습니다. 이들은 시간 순서에 기반하여 가능한 모든 화살표가 포함된 DAG입니다. 즉, 모든 변수가 시간상 그 이후에 나오는 변수들을 유발한다고 가정하는 것입니다.
화살표를 포함하지 않는 것이 포함하는 것보다 더 큰 가정입니다. 다시 말해, 여러분의 기본 설정은 한 변수에서 미래의 변수로 향하는 화살표가 있는 것이어야 합니다. 이 기본 설정은 많은 사람들에게 직관에 어긋납니다. 인과 효과를 평가할 때는 그토록 신중해야 하는데, 어떻게 DAG에서 인과적 가정을 적용할 때는 그토록 자유로워야 한다는 것일까요? 이에 대한 답은 원인의 강도와 유병률에 있습니다. 엄밀히 말하면, 화살표가 존재한다는 것은 적어도 단 하나의 관측치에 대해 이전 노드가 다음 노드를 유발한다는 것을 의미합니다. 화살표는 마찬가지로 관계의 강도에 대해서는 아무것도 말해주지 않습니다. 따라서 단 한 명의 개인에게 미치는 아주 미세한 인과 효과라도 화살표의 존재를 정당화합니다. 실무적으로 그러한 사례는 아마도 중요하지 않을 것입니다. 사실상 화살표가 없는 것이나 마찬가지입니다.
달리 말하면, 이 가정은 연구 대상 단위 중 적어도 하나가 개별 인과 효과를 갖는다는 것을 말합니다. 만약 Y로 향하는 화살표를 가진 변수 X가 있다면, 우리는 적어도 한 명의 사람에 대해 연구 중인 X 값에 따라 잠재적 결과 Y(X = x)에 변화가 있다고 말하는 것입니다. 표 3.2 의 용어로 말하면, 모든 개인에 대해 y_chocolate - y_vanilla가 0인 상태입니다.
연구 대상 단위 중 단 하나도 개별 인과 효과를 갖지 않을 때, 우리는 이를 강한 무효(sharp null)라고 부릅니다.
더 중요한 점은 여러분이 화살표를 추가하는 데 자신감을 가져야 한다는 것입니다. 정당화의 기준은 생각보다 훨씬 낮습니다. 대신, 1) 시간 순서를 결정하고, 2) DAG를 포화시킨 다음, 3) 비현실적인 화살표들을 쳐내는(pruning) 방식이 유용합니다.
팟캐스트-시험 DAG의 포화된 버전을 작업하며 실험해 봅시다.
먼저 시간 순서입니다. 아마도 학생의 유머 감각은 시험 당일보다 훨씬 이전부터 형성되었을 것입니다. 아침의 기분 또한 팟캐스트 청취나 시험 점수보다 앞서며, 준비 상태도 마찬가지입니다. 이 순서가 주어졌을 때 포화된 DAG는 다음과 같습니다:
podcast_dag_sat <- dagify(
  podcast ~ mood + humor + prepared,
  exam ~ mood + prepared + humor,
  prepared ~ humor,
  mood ~ humor,
  coords = time_ordered_coords(
    list(
      "humor",
      c("prepared", "mood"),
      "podcast",
      "exam"
    )
  ),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "기분",
    humor = "유머 감각",
    prepared = "준비 상태"
  )
)

curvatures <- rep(0, 8)
curvatures[1] <- .25

podcast_dag_sat |>
  tidy_dagitty() |>
  ggplot(aes(x, y, xend = xend, yend = yend)) +
  geom_dag_point() +
  geom_dag_edges_arc(curvature = curvatures) +
  geom_dag_label_repel()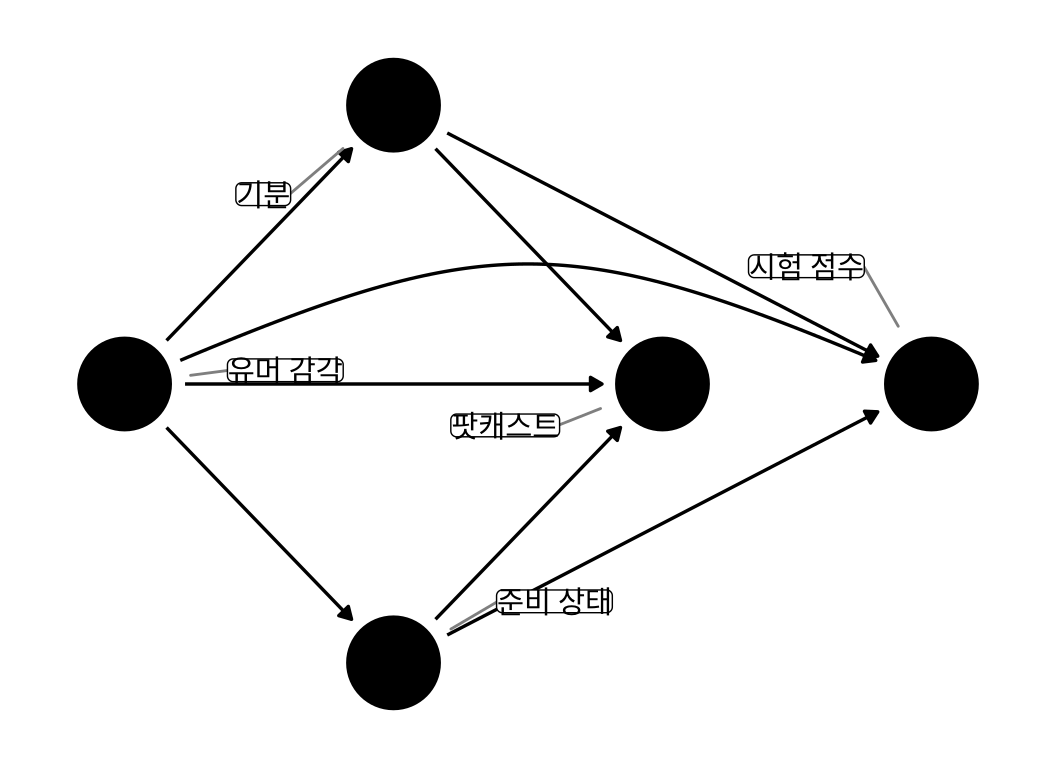
podcast_dag의 포화된 버전: 변수들이 시간이 지남에 따라 다른 변수들로 향하는 모든 가능한 화살표를 갖습니다.
여기에 몇 가지 새로운 화살표들이 있습니다. 유머 감각(humor)이 이제 다른 두 교란 요인과 시험 점수의 원인이 됩니다. 이들 중 일부는 일리가 있습니다. 유머 감각은 어떤 사람들에게는 기분에 영향을 줄 수 있습니다. 준비 상태(prepared)는 어떨까요? 이 관계는 조금 덜 그럴듯해 보입니다. 마찬가지로, 우리는 이 사례에서 채점이 블라인드로 진행되기 때문에 유머 감각이 시험 점수에 영향을 미치지 않는다는 것을 알고 있습니다. 이 두 화살표를 제거해 봅시다.
podcast_dag_pruned <- dagify(
  podcast ~ mood + humor + prepared,
  exam ~ mood + prepared,
  mood ~ humor,
  coords = time_ordered_coords(
    list(
      "humor",
      c("prepared", "mood"),
      "podcast",
      "exam"
    )
  ),
  exposure = "podcast",
  outcome = "exam",
  labels = c(
    podcast = "팟캐스트",
    exam = "시험 점수",
    mood = "기분",
    humor = "유머 감각",
    prepared = "준비 상태"
  )
)

ggdag(podcast_dag_pruned, use_text = FALSE, use_labels = TRUE)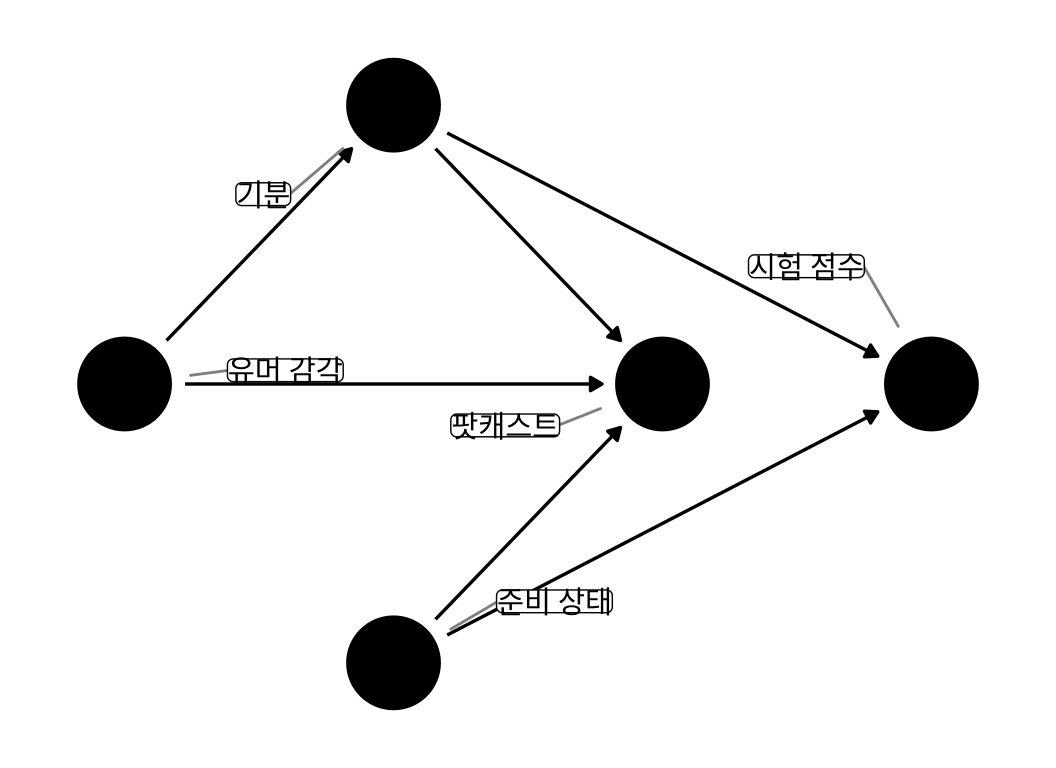
이 DAG가 더 합리적으로 보입니다. 그렇다면 우리의 원래 DAG가 틀렸던 것일까요? 그것은 여러 요인에 달려 있습니다. 특히, 두 DAG 모두 동일한 조정 집합을 생성합니다: 두 DAG 중 어느 것이 옳든 간에 mood와 prepared를 통제하면 편향되지 않은 효과를 얻을 수 있습니다. 설령 새로운 DAG가 다른 조정 집합을 생성하더라도, 결과가 유의미하게 달라질지 여부는 교란의 강도에 달려 있습니다.
엄밀히 말하면, DAG에 도구 변수나 정밀도 변수를 포함할 필요는 없습니다. 이들이 있든 없든 조정 집합은 동일할 것이기 때문입니다. 하지만 이들을 추가하는 것은 두 가지 이유에서 도움이 됩니다. 첫째, 이 변수들과 연구 대상 변수들 사이의 관계에 대한 여러분의 가정을 보여줍니다. 앞서 논의했듯이, 화살표를 포함하지 않는 것이 포함하는 것보다 더 큰 가정이며, 따라서 이는 여러분이 인과 구조가 어떻게 작동한다고 생각하는지에 대한 귀중한 정보입니다. 둘째, 모델링 결정에 영향을 미칩니다. 추정치의 가변성을 줄이기 위해 모델에 정밀도 변수를 항상 포함해야 하므로, DAG에 이들을 표시하는 것이 변수 식별에 도움이 됩니다. 도구 변수 또한 장 24 에서 논의할 것처럼 대안적이거나 보완적인 모델링 전략을 안내할 수 있기 때문에 시각화하는 것이 유용합니다.
위에서 보았듯이, 누락과 측정 오차는 편향의 원인이 될 수 있습니다. 장 15 에서 보겠지만, 우리는 그러한 상황에 대처하기 위한 여러 전략을 가지고 있습니다. 그럼에도 불구하고 우리가 측정하는 거의 모든 것은 어느 정도 부정확합니다. 현재 가지고 있는 데이터에 대한 진정한 DAG는 본질적으로 변수의 측정된 버전에 조건부화되어 있습니다. 그런 의미에서 여러분의 데이터는 항상 미묘하게 잘못되어 있으며, 일종의 신뢰할 수 없는 화자(unreliable narrator)와 같습니다. DAG에 언제 이 정보를 포함해야 할까요? 우리는 먼저 각 변수를 완벽하게 측정했다고 가정하고 DAG의 인과 구조에 집중할 것을 권장합니다 (Hernán 와/과 Robins 2021). 그 후에 오측정이나 누락이 실제 데이터에 어떻게 영향을 미칠지, 특히 노출, 결과, 그리고 중요한 교란 요인들과 관련하여 고려해 보십시오. 누락된 데이터 대치(imputation)나 민감도 분석과 같이 이러한 원인들로부터 발생하는 편향을 해결하기 위한 전략을 고려하기 위해 이를 대안적인 DAG로 제시하는 것을 선호할 수도 있습니다. 결국 그림 4.27 의 DAG는 모든 백도어 경로를 닫을 수 있는 방법이 없기 때문에 질문에 답할 수 없다는 생각을 갖게 합니다. 모든 열린 경로와 마찬가지로, 이는 편향의 심각성과 그것을 계산해낼 수 있는 우리의 능력에 달려 있습니다.
측정 오차가 중요한 고려 사항이 되는 한 분야는 조정 집합을 선택할 때입니다. 이론적으로 DAG가 옳다면, 어떤 조정 집합을 사용하더라도 편향되지 않은 결과를 얻을 수 있습니다. 하지만 실제로는 변수마다 품질이 다릅니다. 정확한 변수들을 포함하고 있어 성공할 가능성이 가장 높은 조정 집합을 선택하십시오. 마찬가지로 최소 조정 집합이 아닌 것들도 고려해 볼 만합니다. 백도어 경로 상에 측정 오차가 있는 여러 변수들이 함께 있다면 해당 경로로 인한 실질적인 편향을 최소화하기에 충분할 수 있기 때문입니다.
특정한 핵심 변수들을 측정하지 못해 유효한 조정 집합을 갖지 못한 경우는 어떨까요? 그럴 때는 다른 백도어 경로로부터의 편향을 최소화할 가능성이 가장 큰 조정 집합을 선택해야 합니다. 모든 교란 요인을 측정하지 못했다고 해서 모든 것을 잃은 것은 아닙니다: 여러분이 할 수 있는 가장 높은 품질의 추정치를 얻은 다음, 측정되지 않은 변수들에 대해 민감도 분석을 수행하여 그 영향을 파악하십시오.
마지막으로, 여러분의 DAG에 대해 강건성 체크를 수행할 것을 권장합니다. 대부분의 조건에서 DAG의 정확성을 결코 검증할 수 없지만, DAG의 함의들을 사용하여 이를 뒷받침할 수는 있습니다. 상황에 따라 세 가지 유형의 강건성 체크가 도움이 될 수 있습니다.
우리는 장 16 에서 이들을 자세히 다룰 것입니다. 여기서 주의할 점은 이들이 여러분의 초기 DAG를 보완하는 것이어야지, 그것을 대체하는 수단이 되어서는 안 된다는 것입니다. 사실 분석 중에 하나 이상의 조정 집합을 사용한다면, 데이터에 결과를 과적합(overfitting)시키는 것을 피하기 위해 그 모든 결과를 보고해야 합니다. 그 모든 결과를 보고해야 합니다.
필수적이지만 드물게 관찰되는 세부 사항은 ’dag’가 양의 똥 묻은 털인 daglock을 지칭하는 애정 어린 호주식 비속어이기도 하다는 점입니다.↩︎