노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 기반 내용은 작성되었으나 여전히 수정이 진행 중입니다.
부트스트랩(bootstrap)은 복원 추출(resampling with replacement)을 사용하여 통계량을 계산하는 단순하면서도 유연한 알고리즘입니다. 어떤 값을 계산하기 위한 닫힌 형태의 해(closed-form solution)가 존재하지 않을 때 매우 유용하며, 인과 추론에서(특히 표준 오차 계산 시) 흔히 발생하는 경우입니다. 또한 특정 상황에서 모수적 접근법(parametric approach)에 사용된 가정이 유효하지 않다고 의심될 때도 유용합니다.
R에서의 부트스트래핑은 고전적인 boot 패키지를 시작으로, 관심 있는 통계량을 계산하는 함수를 작성하는 오랜 전통을 가지고 있습니다. 이 책 전반에 걸쳐 우리는 재표본 추출을 위한 더 현대적인 대안인 rsample을 사용할 것이지만, 일반적으로는 우리가 관심 있는 추정치를 계산하는 함수를 작성하는 것부터 시작합니다.
this_data에 대해 some_statistic()을 계산하고 싶다고 가정해 봅시다. R번의 재표본 추출을 위해 부트스트랩을 수행하려면 다음 단계를 따릅니다:
this_data를 복원 추출로 재표본 추출합니다. 동일한 행이 주어진 부트스트랩 재표본에 여러 번 나타나거나 전혀 나타나지 않을 수 있으며, 이는 기저 모집단에서의 샘플링 과정을 시뮬레이션합니다.
bootstrap_resample에 대해 some_statistic()을 적합시킵니다.
estimate <- some_statistic(bootstrap_resample)R번 반복합니다.
그러면 우리는 estimate들의 분포를 얻게 되며, 이를 통해 점 추정치, 표준 오차, 신뢰 구간과 같은 모집단 통계량을 계산할 수 있습니다.
rsample은 tidymodels 프레임워크의 재표본 추출 패키지이지만, tidymodels 밖의 문제들에도 잘 작동합니다. boot 패키지보다 오버헤드가 조금 더 있지만, 그 결과로 더 유연합니다.
x, z, y라는 세 가지 변수를 가진 샘플링된 데이터가 있고, y를 결과로 하는 선형 회귀에서 x와 z 계수의 신뢰 구간을 계산하고 싶다고 가정해 봅시다. 우리는 부트스트랩을 사용하여 이를 계산할 수 있습니다(R에서 제공하는 닫힌 형태의 해 외에도).
Call:
lm(formula = y ~ x + z, data = sampled_data)

Coefficients:
(Intercept)            x            z
     0.0162       1.0220       1.0270
먼저, bootstraps() 함수를 사용하여 각 재표본 추출된 데이터셋이 rsplit 객체로 저장된 중첩된(nested) 데이터셋을 생성합니다.
bootstrapped_resamples <- bootstraps(sampled_data, times = 10)

bootstrapped_resamples$splits[[1]]
<Analysis/Assess/Total>
<1000/373/1000>여기서 첫 번째 부트스트랩 데이터셋에는 원래 행의 627개가 포함되어 있고, 373개는 포함되지 않았습니다. 결과 데이터 프레임을 살펴보면 원래 데이터셋과 동일한 1000개의 행이 있음을 알 수 있습니다. 이는 포함된 일부 행이 두 번 이상 나타난다는 것을 의미하며, 각 행은 복원 추출되었습니다. 이 분포는 우리가 평균적으로 기대하는 바와 가깝습니다: 원래 데이터셋의 약 2/3가 각 부트스트랩 데이터셋에 포함됩니다.
boot_resample <- bootstrapped_resamples$splits[[1]] |>
  as.data.frame()

boot_resample
# A tibble: 1,000 × 3
z x y
<dbl> <dbl> <dbl>
1 0.244 0.742 0.194
2 0.984 0.971 2.84
3 -1.59 -2.33 -3.66
4 -0.0109 -1.47 -0.885
5 0.391 0.373 2.99
6 -0.737 -2.64 -3.34
7 0.992 1.53 1.92
8 0.525 -1.12 -3.17
9 0.0773 0.927 -0.801
10 -1.28 -1.84 -4.69
# ℹ 990 more rows섹션 A.1 의 알고리즘에 설명된 대로, 각 부트스트랩 데이터셋에 대해 모델을 적합시킬 것입니다.
lm(y ~ x + z, data = boot_resample)
Call:
lm(formula = y ~ x + z, data = boot_resample)

Coefficients:
(Intercept)            x            z
     0.0245       0.9812       1.0559
이를 함수로 표현해 봅시다.
fit_lm <- function(.split) {
  .df <- as.data.frame(.split)
  lm(y ~ x + z, data = .df)
}

bootstrapped_resamples$splits[[1]] |>
  fit_lm()
Call:
lm(formula = y ~ x + z, data = .df)

Coefficients:
(Intercept)            x            z
     0.0245       0.9812       1.0559
하나씩 차례대로 수행하는 대신, 반복문(iteration)을 사용하여 각 재표본에 대해 회귀 분석을 실행할 것입니다. bootstrapped_resamples$splits는 리스트이므로, 우리는 map()을 사용하여 이를 반복 처리하고 리스트를 결과로 받을 수 있습니다. bootstrapped_resamples$splits는 구체적으로 리스트-열(list-column)로, 데이터 프레임의 한 열로 존재하는 리스트입니다. 우리는 bootstrapped_resamples의 기존 구조를 활용하여 결과도 또 다른 리스트-열에 저장할 것입니다.
이제 lm_results의 각 요소는 lm 객체 — 즉, 부트스트랩 재표본에 적합된 회귀 결과 — 입니다. 다음은 마지막 재표본으로부터 얻은 모델입니다.
bootstrapped_resamples$lm_results[[10]]
Call:
lm(formula = y ~ x + z, data = .df)

Coefficients:
(Intercept)            x            z
     0.0341       1.0381       1.0005
이제 모델의 세 가지 계수(절편, x, z) 각각에 대해 10개의 추정치를 갖게 되었습니다. 그림 A.1 은 이들의 분포를 보여줍니다.
# A tibble: 30 × 6
   id      term  estimate std.error statistic   p.value
   <chr>   <chr>    <dbl>     <dbl>     <dbl>     <dbl>
 1 Bootst… (Int…  0.0245     0.0321    0.762  4.46e-  1
 2 Bootst… x      0.981      0.0313   31.4    6.66e-151
 3 Bootst… z      1.06       0.0443   23.8    1.15e- 99
 4 Bootst… (Int…  0.0275     0.0329    0.834  4.04e-  1
 5 Bootst… x      1.04       0.0311   33.3    4.86e-164
 6 Bootst… z      0.997      0.0448   22.3    2.03e- 89
 7 Bootst… (Int…  0.00339    0.0340    0.0997 9.21e-  1
 8 Bootst… x      1.08       0.0318   33.9    5.10e-168
 9 Bootst… z      0.968      0.0466   20.8    5.88e- 80
10 Bootst… (Int…  0.00546    0.0321    0.170  8.65e-  1
# ℹ 20 more rows
unnested_results |>
ggplot(aes(estimate)) +
geom_density(fill = "steelblue", color = NA) +
facet_wrap(~term, scales = "free")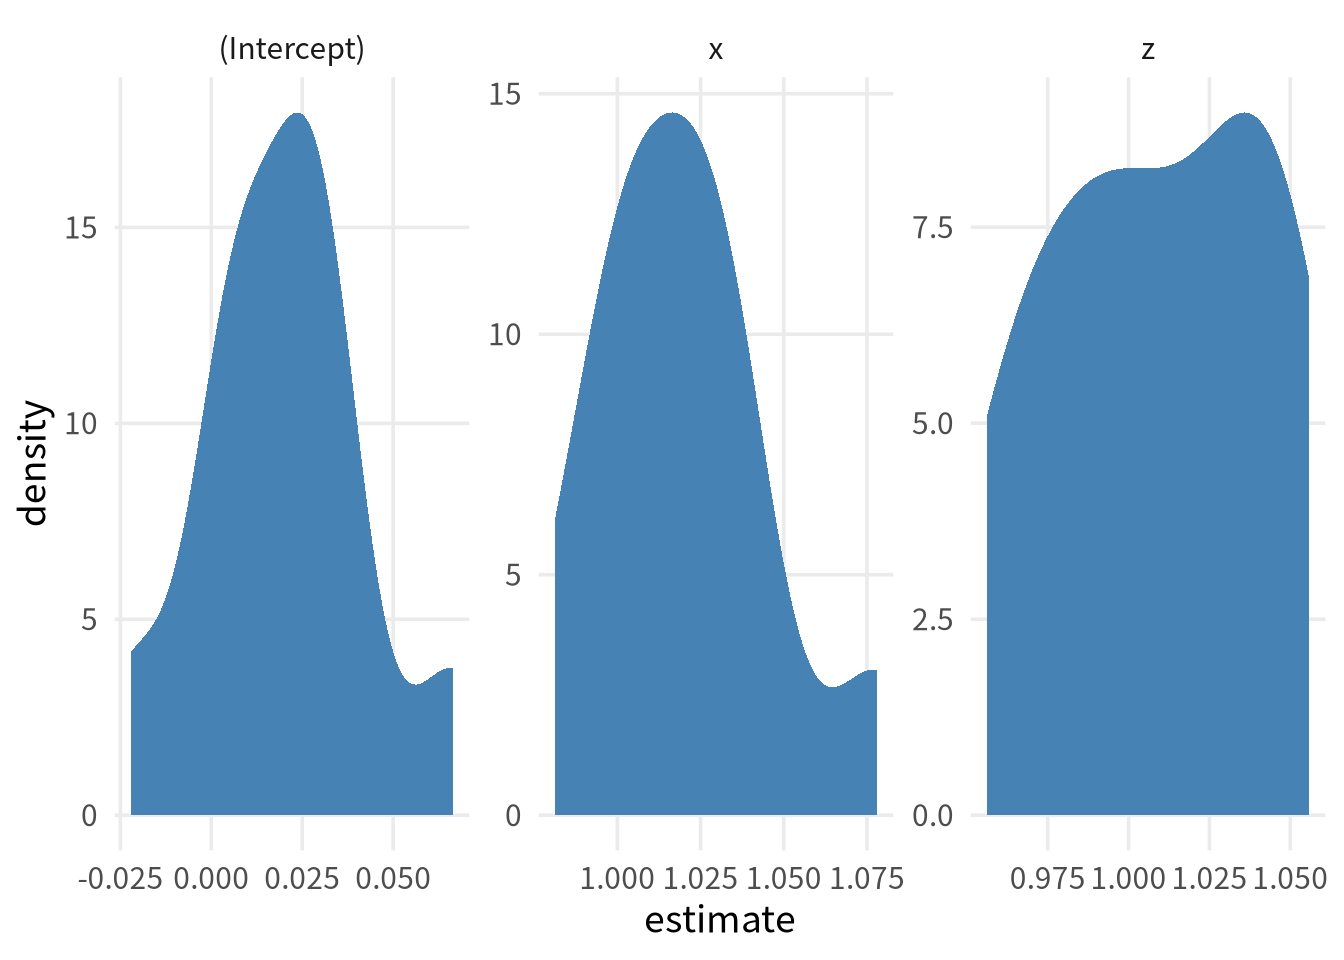
lm(y ~ x + z, data = .df) 모델로부터 얻은 계수들의 부트스트랩 분포. 10개의 부트스트랩 재표본으로 계산되었습니다.
재표본 추출 횟수가 많아질수록 추정치들의 분포는 더 매끄러워집니다. 다음은 1,000번 반복한 결과입니다 (그림 A.2).
bootstrapped_resamples_1k <- bootstraps(
  sampled_data,
  times = 1000
) |>
  mutate(
    lm_results = map(splits, fit_lm),
    tidy_results = map(lm_results, tidy)
  )

bootstrapped_resamples_1k |>
  select(id, tidy_results) |>
  unnest(tidy_results) |>
  ggplot(aes(estimate)) +
  geom_density(fill = "steelblue", color = NA) +
  facet_wrap(~term, scales = "free")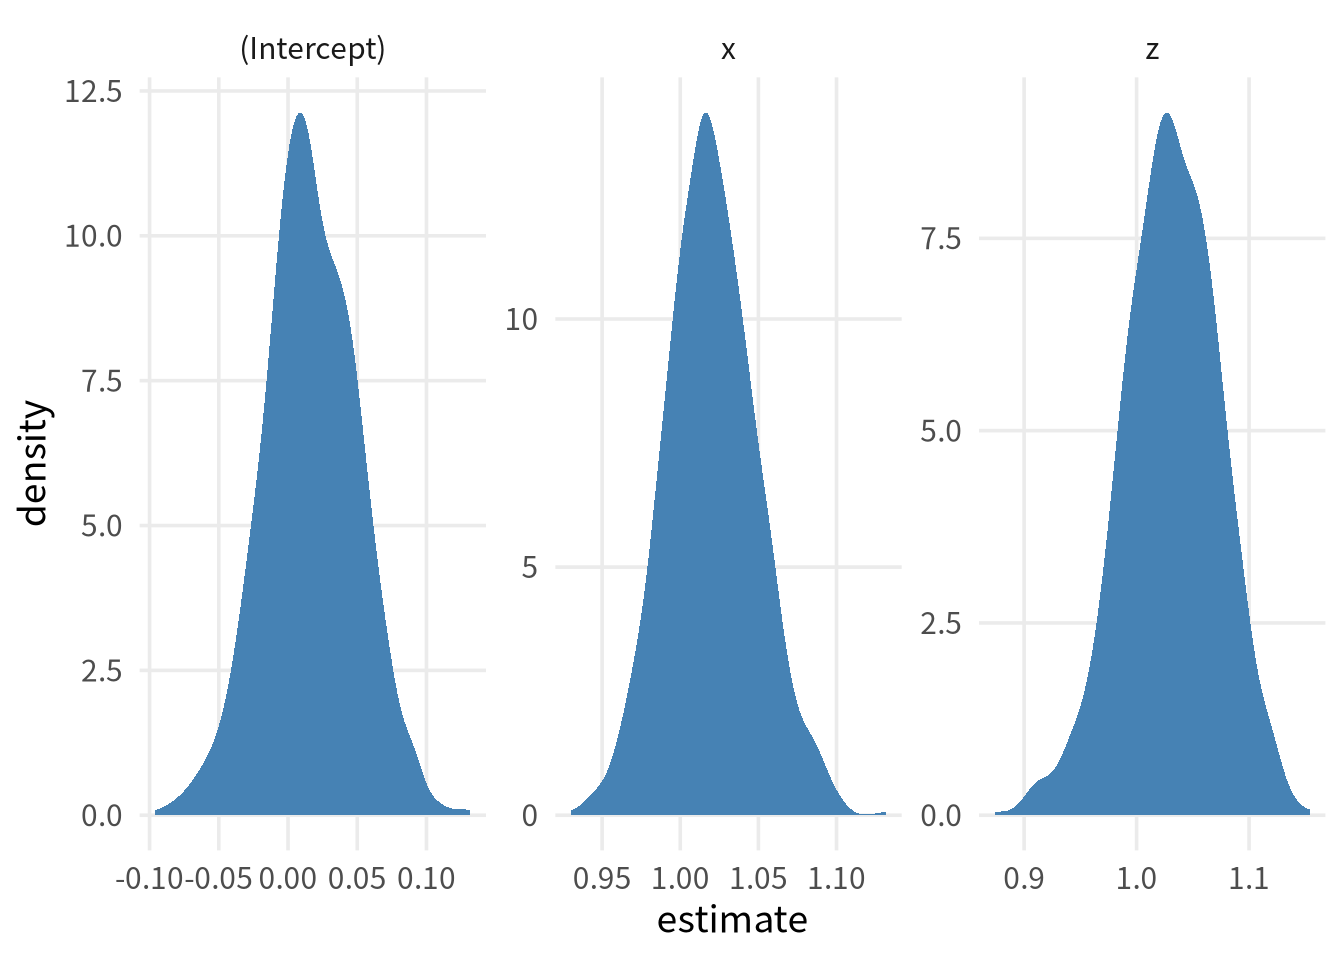
lm(y ~ x + z, data = .df) 모델로부터 얻은 계수들의 부트스트랩 분포. 1,000개의 부트스트랩 재표본으로 계산되었습니다.
우리는 int_*(nested_results, list_column_name) 패턴을 따르는 rsample의 신뢰 구간 함수들을 사용하여 이러한 계수들의 퍼짐 정도에 관한 정보를 계산할 수 있습니다. rsample은 결과가 broom::tidy()의 결과물이거나 유사한 열들을 가진 데이터 프레임일 것을 기대합니다.
int_pctl()을 사용하여 간단한 백분위수 기반의 신뢰 구간을 구해 봅시다. 이는 하위 2.5%와 상위 97.5% 분위수를 구할 것입니다.
int_pctl(bootstrapped_resamples_1k, tidy_results)# A tibble: 3 × 6
term .lower .estimate .upper .alpha .method
<chr> <dbl> <dbl> <dbl> <dbl> <chr>
1 (Intercept) -0.0511 0.0164 0.0824 0.05 percenti…
2 x 0.965 1.02 1.08 0.05 percenti…
3 z 0.941 1.03 1.11 0.05 percenti…이제 각 추정치와 그에 대한 부트스트랩 신뢰 구간이 포함된 데이터 프레임을 갖게 되었습니다. 부트스트랩의 놀라운 점은 이 레시피를 다른 방식으로는 해결하기 불가능했을 문제들을 포함하여, 놀라울 정도로 다양한 통계적 문제들에 적용할 수 있다는 것입니다.
왜 이 놀랍도록 간단한 알고리즘이 그토록 많은 문제들에 대해 잘 작동할까요? 기술적인 세부 사항에 대해서는 부트스트랩에 관한 원본 논문과 서적(Efron 1979; Efron 와/과 Tibshirani 1993)을 참조하시기 바랍니다. 여기서는 어떤 일이 일어나고 있는지에 대한 직관을 길러 봅시다.
우리가 이해하고자 하는 모집단(population)을 생각해 봅시다. 때때로 우리는 모집단의 모든 관측치에 대한 데이터를 가지고 있지만, 종종 필요에 의해서나 효율성을 위해 모집단을 샘플링해야 합니다.
population은 100만 개의 관측치를 가지고 있지만, 우리는 전체 모집단에서 무작위로 200개의 관측치를 샘플링할 것입니다. 만약 더 많은 샘플링을 수행해야 한다면, 원래의 샘플과는 독립적으로 수행합니다. 특정 관측치는 둘 이상의 연구에 포함될 수 있습니다. 동일한 모집단으로부터 20개의 그러한 연구가 수행되었다고 가정해 봅시다.
samples <- map(1:20, ~ population[sample(n, size = 200), ]) |>
  bind_rows(.id = "sample") |>
  mutate(sample = as.numeric(sample))
무작위 샘플링 변동(random sampling variation) 때문에, 각 샘플의 x의 평균은 population의 평균인 -6.8199^{-4}와 약간씩 다릅니다. 각각의 샘플 추정치는 모집단 추정치 주변을 맴돕니다 (그림 A.3).
sample_means <- samples |>
  group_by(sample) |>
  summarize(across(everything(), mean))

samples |>
  ggplot(aes(x = x)) +
  geom_histogram() +
  geom_vline(
    data = sample_means,
    aes(xintercept = x),
    color = "firebrick"
  ) +
  facet_wrap(~sample)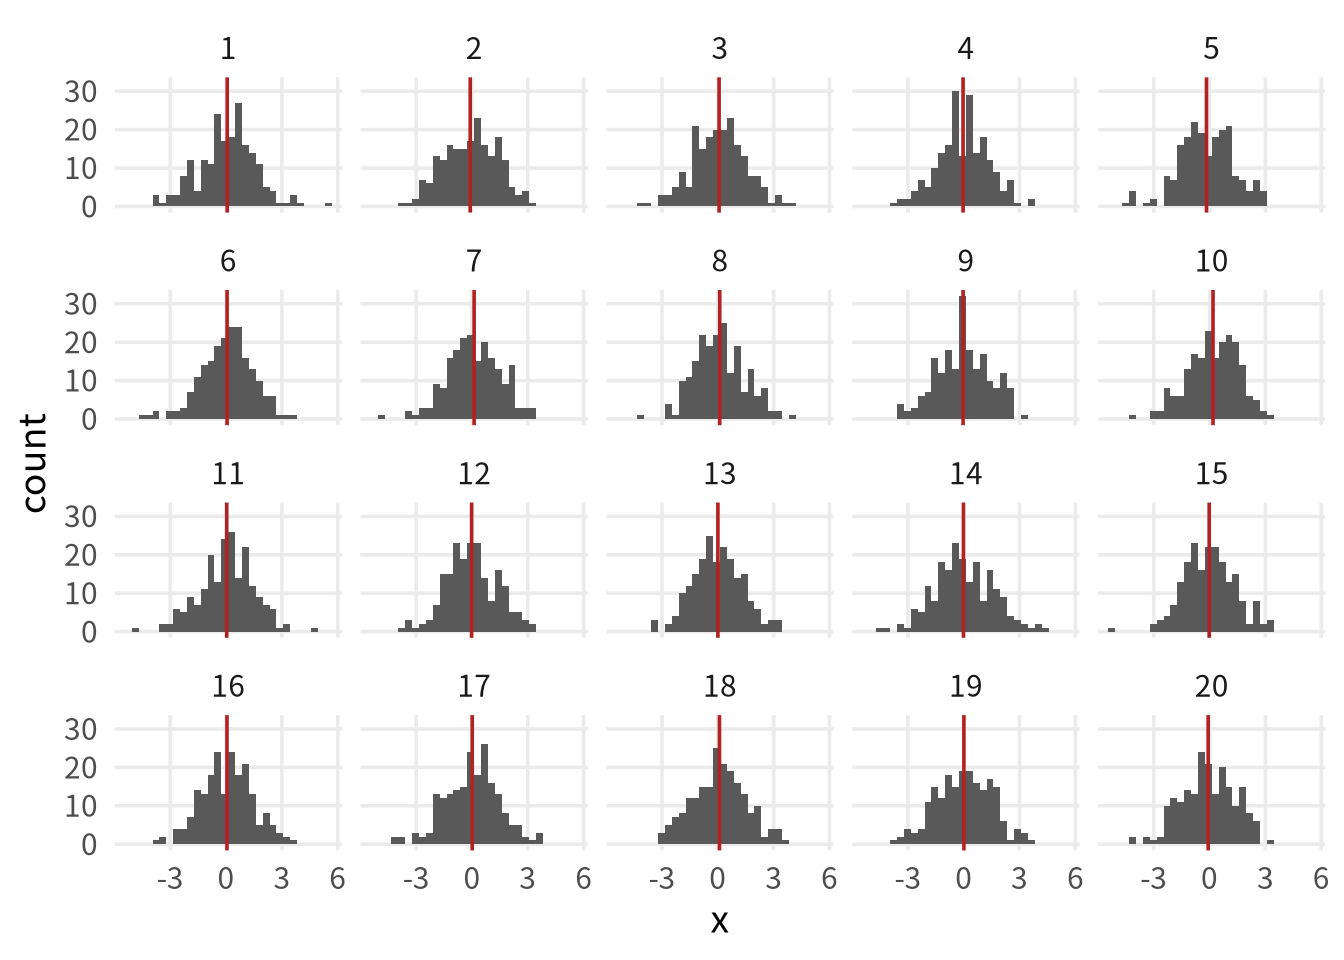
x의 표본 평균 분포. 각 샘플은 population으로부터 샘플링되었으며 표본 크기는 200입니다.
모집단으로부터 샘플링하는 것이 부트스트랩에서 수행하는 샘플링과 유사하다는 점을 눈치채셨을 것입니다. 우리는 재표본(resample)을 그것이 나온 모집단을 대표하는 것으로 취급합니다. 이는 우리가 모수적 신뢰 구간(parametric confidence intervals)을 사용할 때와 마찬가지로, 우리가 관찰하는 분포를 원래 모집단의 관점에서 해석하는 데 도움을 줍니다. 모집단 샘플링과 부트스트랩의 핵심적인 차이점은, 부트스트랩은 모집단 추정치가 아닌 표본 추정치 주변의 퍼짐 정도를 결정한다는 점입니다. 샘플 8을 좀 더 자세히 살펴봅시다.
sample_8 <- samples |>
  filter(sample == "8")

sample_8 |>
  summarize(across(everything(), mean))
# A tibble: 1 × 4
sample z x y
<dbl> <dbl> <dbl> <dbl>
1 8 -0.0406 0.100 0.0476x의 샘플 평균은 0.1입니다. 이제 이 샘플을 부트스트랩하고 각 부트스트랩 재표본에 대해 x의 평균을 계산해 봅시다. 그림 A.4 의 부트스트랩 추정치 분포는 샘플 평균을 중심으로 대칭적으로 나타납니다.
calculate_mean <- function(.split, what = "x", ...) {
  .df <- as.data.frame(.split)
  t <- t.test(.df[[what]])

  tibble(
    term = paste("mean of", what),
    estimate = as.numeric(t$estimate),
    std.error = t$stderr
  )
}

s8_boots <- bootstraps(sample_8, times = 1000, apparent = TRUE)
s8_boots <- s8_boots |>
  mutate(boot_mean_x = map(splits, calculate_mean))

s8_boots |>
  mutate(boot_mean_x = map_dbl(boot_mean_x, \(.df) .df$estimate)) |>
  ggplot(aes(x = boot_mean_x)) +
  geom_histogram() +
  geom_vline(
    data = sample_means |> filter(sample == "8"),
    aes(xintercept = x),
    color = "firebrick"
  )
`stat_bin()` using `bins = 30`. Pick better value
`binwidth`.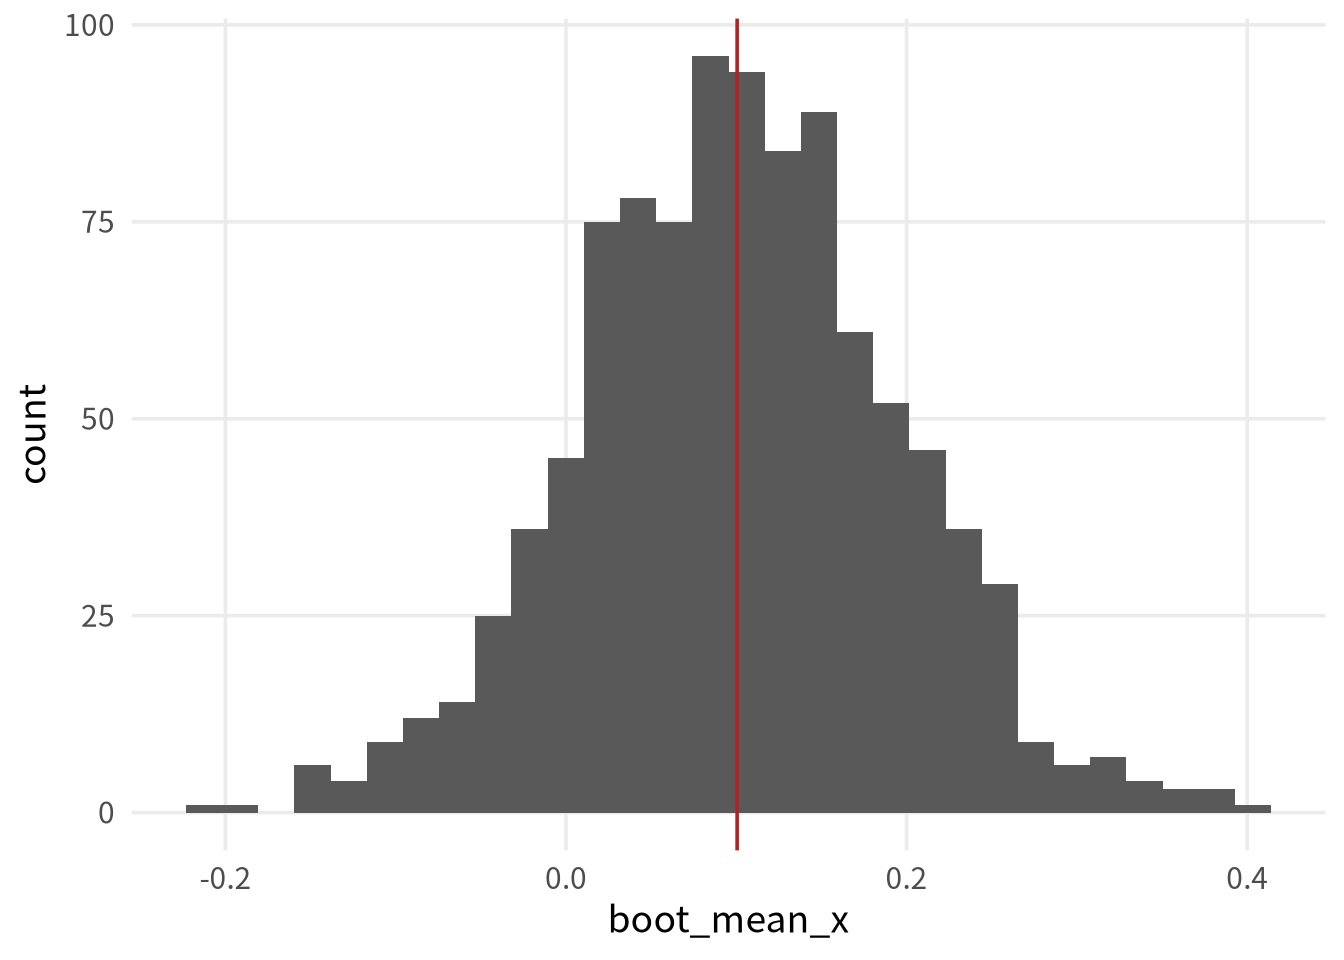
추정치들의 분포가 샘플 평균을 중심으로 형성되어 있음에도 불구하고, 부트스트랩은 모집단으로부터의 샘플링 과정을 시뮬레이션함으로써 우리에게 신뢰 구간에 대한 모집단 해석을 가능하게 해줍니다. 신뢰 구간은 동일한 모집단으로부터의 여러 번의 샘플링과 관련된 빈도주의적(frequentist) 개념입니다. 95% 신뢰 구간의 경우, 샘플들로부터 추정된 신뢰 구간의 95%가 실제 모집단 추정치를 포함하게 됩니다. 이것이 참일 때(예: 모집단으로부터 샘플링된 100개의 연구 중 95개가 모집단 추정치를 포함하는 신뢰 구간을 추정한 경우), 우리는 신뢰 구간이 명목상(nominal) 커버리지를 갖는다고 말합니다. 95% 신뢰 구간의 경우, 샘플들로부터 추정된 신뢰 구간의 95%가 실제 모집단 추정치를 포함하게 됩니다. 예를 들어, 모집단 평균 x를 포함하는 신뢰 구간의 비율을 구해 봅시다. 커버리지를 더 잘 근사하기 위해 샘플 수를 늘려보겠습니다. (샘플 수를 늘릴수록 95%에 더 가까워질 것입니다.)
n_samples <- 1000

samples <- map(seq_len(n_samples), ~ population[sample(n, size = 200), ]) |>
  bind_rows(.id = "sample") |>
  mutate(sample = as.numeric(sample))

cis <- samples |>
  group_by(sample) |>
  group_modify(~ t.test(.x$x) |> tidy())

between(
  rep(mean(population$x), n_samples),
  cis$conf.low,
  cis$conf.high
) |>
  mean()
[1] 0.959부트스트래핑은 위에서 본 잘 정의된 모수적 접근법과 마찬가지로 많은 상황에서 명목상 커버리지를 갖는 신뢰 구간을 얻게 해줍니다. 이 코드는 1000 * n_samples번의 계산이 필요하기 때문에 여기서는 직접 실행하지 않겠지만, 결과는 비슷하게 나타납니다.
bootstrap_ci <- function(.sample_df, ...) {
  sample_boots <- bootstraps(.sample_df, times = 1000)
  sample_boots <- sample_boots |>
    mutate(boot_mean_x = future_map(splits, calculate_mean))

  sample_boots |>
    int_pctl(boot_mean_x)
}

boot_cis <- samples |>
  group_by(sample) |>
  group_modify(bootstrap_ci)

coverage <- between(
  rep(mean(population$x), n_samples),
  boot_cis$.lower,
  boot_cis$.upper
) |>
mean()부트스트랩을 처음 접하는 사람들은 우리가 복원 추출(resampling with replacement)을 한다는 점과 동일한 관측치가 부트스트랩 샘플에 두 번 이상 나타날 수 있다는 점에 종종 놀라곤 합니다. 수학적인 세부 사항은 위에서 인용한 출처들에 나와 있지만, 왜 복원 추출이 효과가 있는지에 대한 직관을 기르는 데 도움이 될 몇 가지 실무적인 이유가 있습니다. 첫째, 만약 비복원(without replacement) 추출을 한다면, 매번 원래의 데이터셋을 그대로 얻게 되므로 매번 동일한 추정치를 얻게 될 것입니다. 샘플들을 뒤섞음으로써(jittering) 추정치에 변동을 주는 것입니다. 또한 하위 샘플링(sub-sampling)을 할 수도 있습니다: 원래 데이터셋보다 작은 크기로 비복원 추출을 하는 것입니다. 하지만 이는 다른 문제들에는 유용할 수 있어도 복원 추출만큼 잘 작동하지는 않습니다. 그 이유는 원래의 모집단과 그것이 샘플링되는 방식과 관련이 있습니다. 각 샘플은 서로 독립적이며, 이는 한 개인이 하나 이상의 샘플에 포함될 수 있음을 의미합니다. 만약 이전 샘플에 포함된 개인을 제외하도록 샘플링을 제한한다면, 여러분의 샘플링 계획은 더 이상 독립적이지 않게 될 것입니다; 각 샘플이 이전 샘플들에 의존하게 되기 때문입니다. 재표본 추출에서 각 관측치를 독립적으로 허용하는 것은, 마치 역확률 가중치 부여에서 샘플들의 가중치를 높이는 것과 비슷하게( 섹션 8.2 참조), 해당 관측치가 원래 모집단에서 자신과 유사한 다른 관측치들을 대리할 수 있게 해줍니다.
이 책에서는 안정성과 계산 속도의 균형을 맞추기 위해 대부분의 문제에 1,000번의 부트스트랩 재표본을 사용합니다. 여러분의 실제 분석에서는 몇 번을 사용해야 할까요?
수십 번이나 수백 번의 재표본을 권장하는 오래된 지침들을 자주 보게 되지만, 이는 처리 능력이 더 제한적이었던 시절의 이야기입니다. 현대적인 컴퓨터(개인용 노트북조차도)에서는 훨씬 더 많이 수행하는 것이 실용적입니다. Hesterberg (2015) 는 대략적인 추정치를 위해서는 1,000번의 재표본을, 정확도가 중요할 때는 10,000~15,000번의 재표본을 권장합니다. 여기서 “정확도”란 부트스트랩 시뮬레이션 자체로 인한 분산을 최소화하는 것을 의미합니다. 이에 대한 실무적인 테스트 방법은 R번의 재표본 추출을 여러 번 시도해보고, 결과의 안정성 정도에 만족할 때까지 R을 늘려보는 것입니다.
각 부트스트랩 계산은 서로 독립적이므로, 재표본 횟수가 많을 경우 병렬 처리(parallel processing)를 사용하는 것이 좋습니다. 우리가 보여준 rsample 방식에서는 map() 대신 병렬화된 대체 함수로 furrr 패키지를 사용할 수 있습니다. furrr는 future 프레임워크에 대한 purrr 스타일의 API입니다.
library(future)
library(furrr)
n_cores <- availableCores() - 1
plan(multisession, workers = n_cores)

s8_boots <- s8_boots |>
mutate(boot_mean_x = future_map(splits, calculate_mean))지금까지 우리는 백분위수 기반의 신뢰 구간(percentile-based confidence intervals)을 사용해 왔습니다. 이는 말 그대로 부트스트랩 추정치 분포의 2.5%와 97.5% 백분위수입니다. 빠르고, 단순하며, 직관적입니다. 하지만 부트스트랩 신뢰 구간에는 여러 다른 유형이 존재하며, 특정 상황에서는 이들이 더 나은 명목상 커버리지(nominal coverage)를 가질 수 있습니다. 이 글을 쓰는 시점에 rsample은 두 가지를 추가로 포함하고 있습니다: int_t()와 int_bca()입니다. int_t()는 부트스트랩 T-통계량으로부터 신뢰 구간을 계산합니다. int_bca()는 편향 수정 및 가속(bias-corrected and accelerated, BCa) 신뢰 구간을 계산합니다.
이러한 유형의 신뢰 구간을 위해서는 원래 데이터셋에서의 추정치가 필요합니다. bootstraps(data, times = 1000, apparent = TRUE)와 같이 apparent = TRUE를 사용하여 원래 데이터셋을 포함하도록 rsample에 지시할 수 있습니다(우리는 이미 s8_boots에 대해 그렇게 했습니다). 그러면 원래 데이터셋 1개와 1,000개의 부트스트랩 데이터셋을 합쳐 총 1,001개의 데이터셋이 생성됩니다. int_bca()의 경우, 추정치를 계산하는 데 사용한 함수(이 경우 calculate_mean)를 .fn 인자에 제공해야 합니다.
# A tibble: 3 × 6
  term       .lower .estimate .upper .alpha .method
  <chr>       <dbl>     <dbl>  <dbl>  <dbl> <chr>
1 mean of x -0.0875     0.102  0.286   0.05 percentile
2 mean of x -0.0829     0.102  0.295   0.05 student-t
3 mean of x -0.0876     0.102  0.286   0.05 BCa
이 사례에서 신뢰 구간들은 매우 비슷합니다. x와 같이 정규 분포를 따르는 데이터에 대해서는 모두 잘 작동하기 때문입니다.
신뢰 구간의 명목상 커버리지에 대한 미묘한 세부 사항은, 구간 밖에 떨어지는 추정치의 비율이 구간의 양쪽에서 대략적으로 같아야 한다는 점입니다. 예를 들어 x에 대한 전통적인 t-테스트의 신뢰 구간에서 이를 확인할 수 있습니다.
[1] 0.020 0.021이러한 대칭성은 데이터가 비대칭(skewed)일 때 많은 유형의 신뢰 구간에서 유지되지 않습니다. 예를 들어, 오른쪽으로 꼬리가 긴 분포는 95%의 명목상 커버리지를 가질 수 있지만, 하한값 아래(분포의 왼쪽)에 1%의 값이 있고 상한값 위(분포의 오른쪽)에 4%의 값이 있을 수 있습니다.
BCa 구간과 부트스트랩 t-통계량 구간은 비대칭 데이터에서 더 잘 작동합니다. 주목할 점은, 데이터의 분포와 관계없이 중심 극한 정리(central limit theorem)에 의해 표본 크기가 커질수록 평균은 정규 분포에 접근한다는 것입니다(비록 비대칭 분포의 경우 필요한 표본 크기가 흔히 언급되는 30개가 아니라 수천 개가 될 수도 있지만요). 조건부 평균인 회귀 모델의 계수들에 대해서도 흔히 이와 같은 현상이 나타납니다. 중심 극한 정리가 효과를 발휘했다면, 백분위수 및 다른 유형의 신뢰 구간들도 아마 좋은 커버리지를 가질 것입니다.
평균이 정규 분포를 따르는 것과 같이 부트스트랩 분포가 특정한 모양을 가져야 한다고 믿을 만한 이유가 있는 결과가 있다면, 이는 여러분의 분석에 대한 잠재적인 진단 도구를 제공합니다. 예를 들어, 인과 추론에서 계수가 비대칭이거나 예상치 못한 다른 분포를 보인다면, 이는 긍정성 가정(positivity assumption)이 위배되었다는 신호일 수 있습니다(장 3 를 참조하십시오). 부트스트랩 재표본 사이의 예상치 못한 불안정성을 주의 깊게 살펴보십시오.
백분위수 구간과 BCa 구간은 변환 불변성(transformation invariant)을 가집니다. 즉, 부트스트랩한 추정치를 변환한 결과가 변환된 추정치를 부트스트랩한 결과와 같다는 뜻입니다. 이에 대한 예로 로그 오즈비 대 오즈비가 있습니다. 부트스트랩 t-통계량 구간의 경우, 실제로 어떤 것을 부트스트랩했느냐에 따라 결과가 달라질 수 있습니다. 따라서 하나 이상의 척도에서 보고 싶은 데이터를 다루고 있다면, 백분위수나 BCa 구간 중 하나를 사용하는 것이 좋습니다.
마지막 고려 사항은 계산 속도입니다. 백분위수 방식은 매우 빠르며 추가 정보가 필요하지 않습니다. 부트스트랩 t-구간과 BCa 구간은 원래 데이터셋의 정보가 필요합니다. BCa 방식은 세 가지 중 계산 집약도가 가장 높습니다. 현대적인 컴퓨터에서는 많은 문제에 대해 속도 차이가 미미하지만, 백분위수 신뢰 구간이 잘 작동할 것으로 생각되고 BCa가 특히 오래 걸릴 때는 백분위수 방식을 사용하는 것이 유용할 수 있습니다.
여기서 제시한 알고리즘은 많은 계산에 있어 단순하고 강력하지만, 일부 유형의 추정치는 부트스트랩으로 작동하지 않거나 명목 신뢰 구간을 계산하기 위해 알고리즘의 변형이 필요한 것으로 알려져 있습니다. 전형적인 예로 최솟값이나 최댓값과 같은 극단값(extrema)이 있습니다. 예를 들어, x의 최솟값을 부트스트래핑하면 이상한 분포가 나타납니다.
calculate_min <- function(.split, what = "x", ...) {
  .df <- as.data.frame(.split)

  tibble(
    term = paste(what, "의 최솟값"),
    estimate = min(.df[[what]])
  )
}

s8_boots <- s8_boots |>
  mutate(boot_min_x = map(splits, calculate_min))

s8_boots |>
  mutate(boot_min_x = map_dbl(boot_min_x, \(.df) .df$estimate)) |>
  ggplot(aes(x = boot_min_x)) +
  geom_histogram()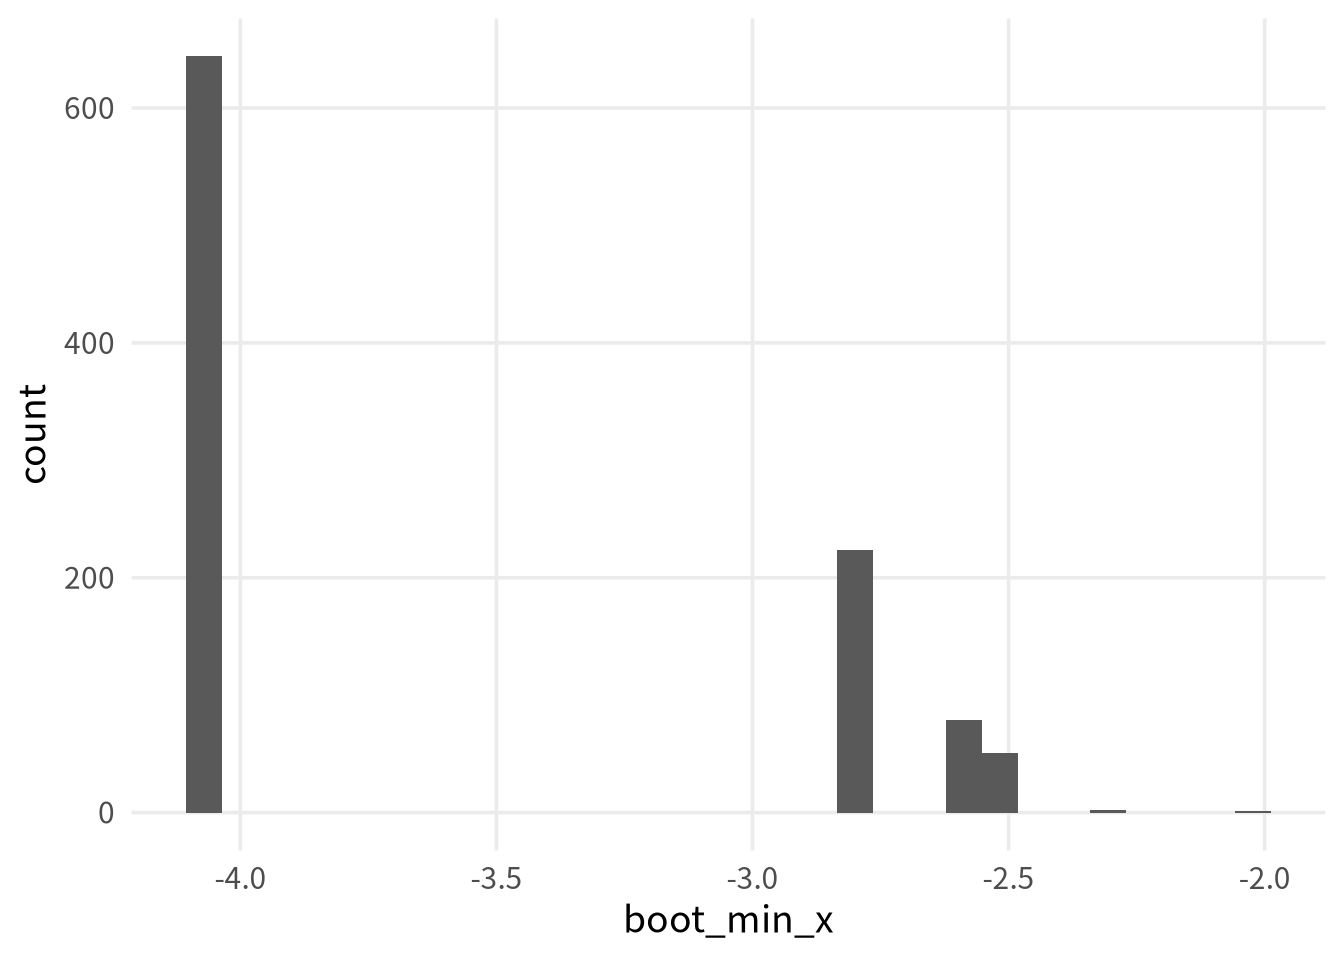
x의 최솟값에 대한 부트스트랩 분포. 부트스트랩은 극단값에 대한 분포를 계산하는 데 어려움을 겪습니다.
부트스트랩이 바로 작동하지 않는 다른 흔한 상황으로는 규제 회귀(lasso 회귀 등)와 시계열과 같이 강한 상관 구조를 가진 데이터가 있습니다. 종종 그러한 문제들에 대해 작동하는 부트스트랩의 변형 버전이 존재합니다. survey 패키지의 저자이자 R 코어 멤버인 Thomas Lumley는 부트스트랩이 바로 작동하지 않는 흔한 상황들(그리고 그러한 시나리오에서 작동하는 변형된 부트스트랩의 예시들)에 대한 훌륭한 요약을 제공합니다 (Lumley 2017). 또한 Hesterberg (2015) 도 참조하십시오.