노트작업 진행 중 🚧
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
여러분은 현재 작성 중인 R을 이용한 인과 추론의 초판본을 읽고 계십니다. 이 장은 거의 완성되었으나, 작은 수정이나 문구 교정이 있을 수 있습니다.
매칭된 데이터셋으로 결과 모델을 적합할 때는 원본 데이터를 매칭된 관측치로만 부분 집합화(subset)한 뒤 평소처럼 모델을 적합하면 됩니다. 예를 들어 sec-using-ps에서 했던 것처럼 매칭을 다시 수행하고, 다음과 같이 matched_data라는 데이터셋에 매칭된 관측치를 추출할 수 있습니다.
library(broom)
library(touringplans)
library(MatchIt)

seven_dwarfs_9 <- seven_dwarfs_train_2018 |>
  filter(wait_hour == 9)

m <- matchit(
  park_extra_magic_morning ~ park_ticket_season + park_close + park_temperature_high,
  data = seven_dwarfs_9
)
matched_data <- get_matches(m)
그런 다음 이 데이터에 대해 결과 모델을 적합시킬 수 있습니다. 이 분석에서 우리는 아침 엑스트라 매직 아워가 오전 9시에서 10시 사이의 평균 게시 대기 시간에 미치는 영향에 관심이 있습니다. 아래의 선형 모델은 매칭된 코호트(cohort)에서 이를 추정할 것입니다.
# A tibble: 2 × 7
  term   estimate std.error statistic  p.value conf.low
  <chr>     <dbl>     <dbl>     <dbl>    <dbl>    <dbl>
1 (Inte…    67.0       2.37     28.3  1.94e-54    62.3
2 park_…     7.87      3.35      2.35 2.04e- 2     1.24
# ℹ 1 more variable: conf.high <dbl>MatchIt은 기본적으로 처치군에 대한 평균 처치 효과(ATT)를 추정한다는 점을 기억하십시오. 이는 엑스트라 매직 아워가 있는 날들 중에서, 엑스트라 매직 아워가 오전 9시에서 10시 사이의 평균 게시 대기 시간에 미치는 기대 영향이 7.9분(95% CI: 1.2-14.5)임을 의미합니다.
이제 성향 점수 가중치를 사용하여 동일한 추정 대상을 추정해 봅시다. 앞서 수행한 매칭 분석과 일치하도록 ATT 가중치를 사용할 것입니다.
library(propensity)

propensity_model <- glm(
    park_extra_magic_morning ~ park_ticket_season + park_close + park_temperature_high,
    data = seven_dwarfs_9,
    family = binomial()
  )

seven_dwarfs_9_with_ps <- propensity_model |>
  augment(type.predict = "response", data = seven_dwarfs_9)
seven_dwarfs_9_with_wt <- seven_dwarfs_9_with_ps |>
  mutate(w_att = wt_att(.fitted, park_extra_magic_morning))
우리는 weights 인자를 사용하여 가중(weighted) 결과 모델을 적합시킬 수 있습니다.
# A tibble: 2 × 5
  term           estimate std.error statistic   p.value
  <chr>             <dbl>     <dbl>     <dbl>     <dbl>
1 (Intercept)       68.7       1.45     47.3  1.69e-154
2 park_extra_ma…     6.23      2.05      3.03 2.62e-  3
가중치 부여를 사용하여, 엑스트라 매직 아워가 있는 날들 중에서 엑스트라 매직 아워가 오전 9시에서 10시 사이의 평균 게시 대기 시간에 미치는 기대 영향이 6.2분이라고 추정합니다. 이 접근 방식은 점 추정치(point estimate)에 대해서는 원하는 값을 얻게 해주지만, 불확실성(표준 오차 및 신뢰 구간)에 대한 lm 함수의 기본 출력값은 정확하지 않습니다.
이 간단한 예시에서 가중 결과 모델은 가중 평균의 차이를 구하는 것과 동일합니다.
wt_means <- seven_dwarfs_9_with_wt |>
  group_by(park_extra_magic_morning) |>
  summarize(average_wait = weighted.mean(wait_minutes_posted_avg, w = w_att))
Warning: There were 2 warnings in `summarize()`.
The first warning was:
ℹ In argument: `average_wait =
weighted.mean(wait_minutes_posted_avg, w = w_att)`.
ℹ In group 1: `park_extra_magic_morning = 0`.
Caused by warning in `vec_ptype2.psw.double()`:
! Converting psw to numeric
ℹ Class-specific attributes and metadata have been
dropped
ℹ Use explicit casting to numeric to avoid this
warning
ℹ Run `dplyr::last_dplyr_warnings()` to see the 1
remaining warning.wt_means# A tibble: 2 × 2
park_extra_magic_morning average_wait
<dbl> <dbl>
1 0 68.7
2 1 74.9차이는 6.23분이며, 이는 가중 결과 모델의 결과와 같습니다.
가중치가 적용된 인구는 성향 점수에 포함된 변수들에 의한 교란이 없는 가상 인구(pseudo-population)입니다. 철학적으로나 실무적으로나 우리는 이 인구의 데이터를 사용하여 계산을 수행할 수 있습니다. 이미 가중치에서 교란 요인을 고려했기 때문에, 이제 group_by()와 summarize()를 이용한 인과 추론이 잘 작동합니다.
불확실성을 추정하는 데는 세 가지 방법이 있습니다:
첫 번째 옵션은 계산 집약적일 수 있지만, 정확한 추정치를 제공할 것입니다. 두 번째 옵션은 계산상 가장 간단하지만, 변동성을 과대 추정하는 경향이 있습니다. 세 번째 옵션에 대해서는 (직접 코딩하는 것 외에) 현재 R에서 제공되는 솔루션이 많지 않지만, propensity 패키지의 ipw() 함수가 이를 지원합니다.
fit_ipw <- function(.split, ...) {
  # 부트스트랩된 데이터 프레임 가져오기
  .df <- as.data.frame(.split)

  # 성향 점수 모델 적합시키기
  propensity_model <- glm(
    park_extra_magic_morning ~ park_ticket_season + park_close + park_temperature_high,
    data = .df,
    family = binomial()
  )

  # 역확률 가중치 계산하기
  .df <- propensity_model |>
    augment(type.predict = "response", data = .df) |>
    mutate(wts = wt_att(
      .fitted,
      park_extra_magic_morning,
      exposure_type = "binary"
    ))

  # 올바르게 부트스트랩된 ipw 모델 적합시키기
  lm(
    wait_minutes_posted_avg ~ park_extra_magic_morning,
    data = .df,
    weights = wts
  ) |>
    tidy()
}# Bootstrap sampling with apparent sample
# A tibble: 1,001 × 3
splits id boot_fits
<list> <chr> <list>
1 <split [354/134]> Bootstrap0001 <tibble [2 × 5]>
2 <split [354/131]> Bootstrap0002 <tibble [2 × 5]>
3 <split [354/122]> Bootstrap0003 <tibble [2 × 5]>
4 <split [354/129]> Bootstrap0004 <tibble [2 × 5]>
5 <split [354/130]> Bootstrap0005 <tibble [2 × 5]>
6 <split [354/133]> Bootstrap0006 <tibble [2 × 5]>
7 <split [354/135]> Bootstrap0007 <tibble [2 × 5]>
8 <split [354/129]> Bootstrap0008 <tibble [2 × 5]>
9 <split [354/122]> Bootstrap0009 <tibble [2 × 5]>
10 <split [354/131]> Bootstrap0010 <tibble [2 × 5]>
# ℹ 991 more rows결과를 살펴봅시다.
ipw_results |>
  mutate(
    estimate = map_dbl(
      boot_fits,
      \(.fit) .fit |>
        filter(term == "park_extra_magic_morning") |>
        pull(estimate)
    )
  ) |>
  ggplot(aes(estimate)) +
  geom_histogram(bins = 30, fill = "#D55E00FF", color = "white", alpha = 0.8) +
  theme_minimal()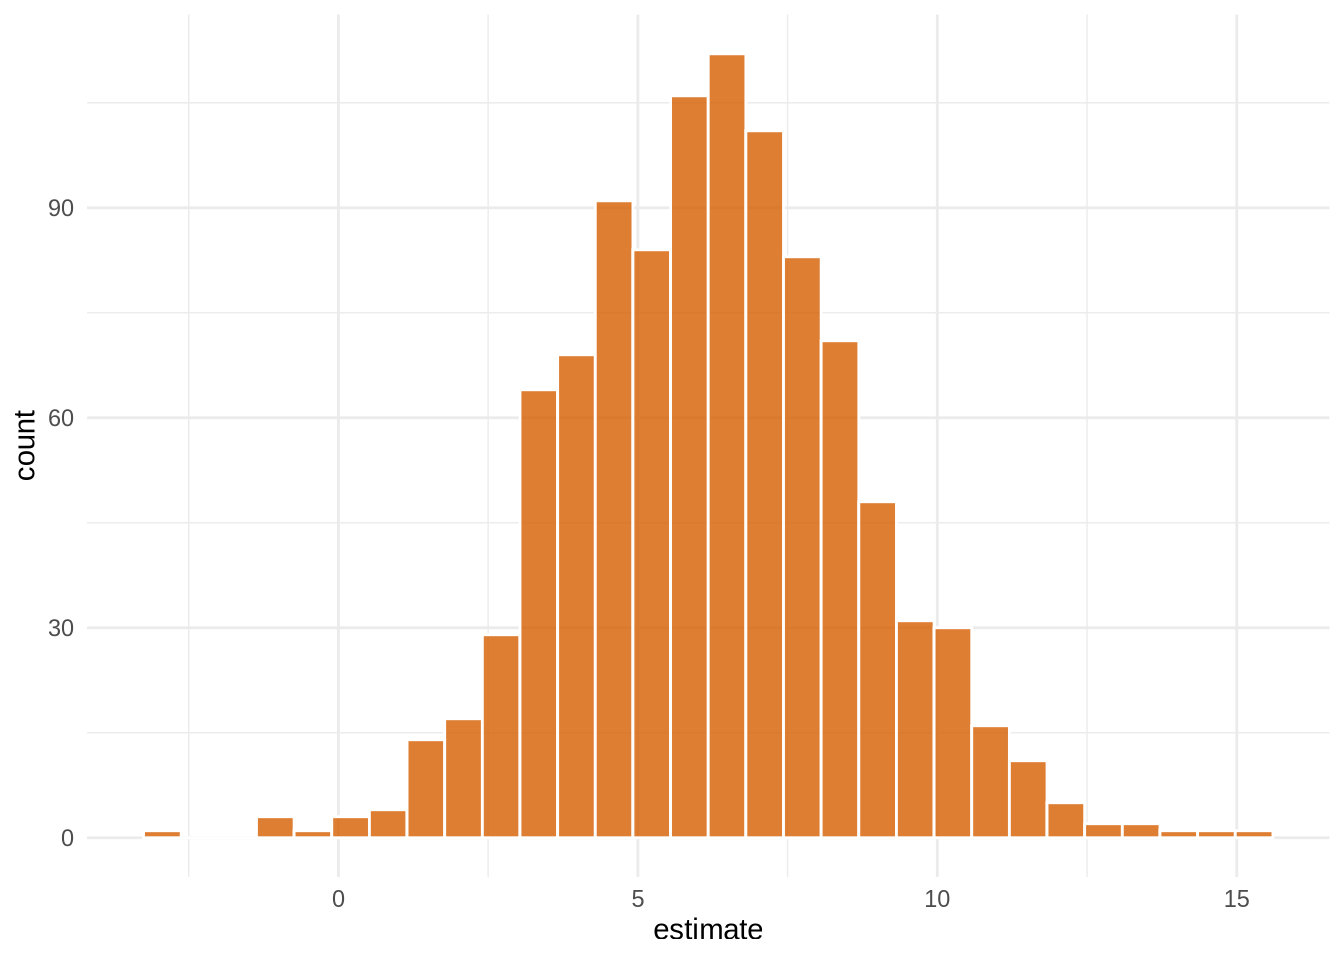
# A tibble: 1 × 6
  term           .lower .estimate .upper .alpha .method
  <chr>           <dbl>     <dbl>  <dbl>  <dbl> <chr>
1 park_extra_ma…   1.52      6.28   11.1   0.05 studen…
우리는 엑스트라 매직 아워가 있는 날들 중에서, 엑스트라 매직 아워가 오전 9시에서 10시 사이의 평균 게시 대기 시간에 미치는 기대 영향이 6.3분(95% CI: 1.5, 11.1)인 것으로 추정합니다.
샌드위치 추정량을 구하는 데는 두 가지 방법이 있습니다. 첫 번째는 위의 가중 결과 모델과 함께 sandwich 패키지를 사용하는 것입니다. 아래에 나타난 것처럼, sandwich 함수를 사용하여 관심 있는 파라미터에 대한 로버스트(robust) 분산 추정치를 얻을 수 있습니다.
                         (Intercept)
(Intercept)                    1.488
park_extra_magic_morning      -1.488
                         park_extra_magic_morning
(Intercept)                                -1.488
park_extra_magic_morning                    8.727
여기서 로버스트 분산 추정치는 8.727입니다. 우리는 이를 사용하여 로버스트 신뢰 구간을 구축할 수 있습니다.
park_extra_magic_morning
0.4383 ubpark_extra_magic_morning
12.02 우리는 엑스트라 매직 아워가 있는 날들 중에서, 엑스트라 매직 아워가 오전 9시에서 10시 사이의 평균 게시 대기 시간에 미치는 기대 영향이 6.2분(95% CI: 0.4, 12)인 것으로 추정합니다.
대안적으로, 우리는 survey 패키지를 사용하여 모델을 적합시킬 수도 있습니다. 이를 위해, 가중 표를 적합시킬 때 했던 것처럼 설계 객체(design object)를 생성해야 합니다.
그런 다음 svyglm을 사용하여 결과 모델을 적합시킬 수 있습니다.
# A tibble: 2 × 7
  term  estimate std.error statistic   p.value conf.low
  <chr>    <dbl>     <dbl>     <dbl>     <dbl>    <dbl>
1 (Int…    68.7       1.22     56.2  6.14e-178   66.3
2 park…     6.23      2.96      2.11 3.60e-  2    0.410
# ℹ 1 more variable: conf.high <dbl>가장 정확한 샌드위치 추정량은 성향 점수 모델을 추정할 때의 불확실성까지 고려하는 것입니다. ipw() 함수를 통해 이를 수행할 수 있습니다. 이를 위해 성향 점수 모델과 결과 모델을 모두 제공해야 합니다.
results <- ipw(propensity_model, weighted_mod)
results
Inverse Probability Weight Estimator
Estimand: ATT
Propensity Score Model:
Call: glm(formula = park_extra_magic_morning ~ park_ticket_season +
park_close + park_temperature_high, family = binomial(),
data = seven_dwarfs_9)
Outcome Model:
Call: lm(formula = wait_minutes_posted_avg ~ park_extra_magic_morning,
data = seven_dwarfs_9_with_wt, weights = w_att)
Estimates:
estimate std.err z ci.lower ci.upper
diff 6.23 2.34 2.66 1.64 10.8
conf.level p.value
diff 0.95 0.0078 **
---
Signif. codes:
0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1결과를 데이터 프레임으로 수집할 수도 있습니다.
results |>
  as.data.frame()
effect estimate std.err z ci.lower ci.upper
1 diff 6.228 2.339 2.663 1.644 10.81
conf.level p.value
1 0.95 0.007753우리가 다룬 예시에서 결과 변수인 게시 대기 시간은 연속형입니다. 가중 선형 회귀를 사용하면, ATE와 그 일족들은 평균의 차이로 계산됩니다. 평균 차이는 추정하기에 가치 있는 효과이지만, 유일한 방법은 아닙니다. 예를 들어 ATT 가중치를 사용하고 결과 회귀에 가중치를 부여하여 게시 대기 시간의 상대적 변화를 계산한다고 합시다. 상대적 변화는 여전히 처치받은 집단에서의 처치 효과이지만, 상대적 척도 위에 있습니다. 중요한 점은 가중치를 통해 우리가 추정하고자 하는 특정 추정 대상에 맞춰 처치받은 집단의 공변량들에 대해 평균을 낼 수 있다는 것입니다. 때때로 사람들이 “평균 처치 효과”라고 말할 때 전체 샘플에서의 평균 결과 차이를 의미하기도 하므로, 구체적으로 명시하는 것이 좋습니다.
이진 결과의 경우, 우리는 세 가지 표준 옵션을 가집니다: 위험비(risk ratio), 위험 차이(risk difference), 그리고 오즈비(odds ratio). 이진 결과의 경우, 우리는 각 처치 그룹에 대한 평균 확률을 계산합니다. 이를 p_untreated와 p_treated라고 부릅시다. 이러한 확률들을 다룰 때, 위험 차이와 위험비를 계산하는 것은 간단합니다:
p_treated - p_untreated
p_treated / p_untreated
여기서 “위험(risk)”은 결과의 발생 위험을 의미합니다. 이는 질병 발생과 같이 결과가 부정적인 상황을 가정한 용어입니다. 때때로 이를 “반응비(response ratio)” 또는 “반응 차이(response difference)”라고 부르기도 합니다. 더 일반적인 방식은 이를 결과 확률의 차이 또는 비율로 생각하는 것입니다.
확률에 대한 오즈(odds)는 p / (1 - p)로 계산되므로, 오즈비는 다음과 같습니다:
(p_treated / (1 - p_treated)) / (p_untreated / (1 - p_untrtated))
결과가 희귀할 때 (1 - p)는 1에 가까워지며, 오즈비는 위험비에 근사합니다. 결과가 희귀할수록 이 근사는 더 정확해집니다.
로지스틱 회귀 모델의 한 가지 특징은 계수가 로그 오즈비(log-odds ratios)라는 점입니다. 따라서 이를 지수화(exponentiating)하면 오즈비가 생성됩니다. 그러나 로지스틱 회귀를 사용할 때, sec-g-comp장에서 보겠지만 예측 확률(predicted probabilities)을 사용하여 위험 차이와 위험비를 계산할 수도 있습니다.
연속형 결과와 마찬가지로, 이러한 각 추정 대상을 모집단의 다른 하위 집합에 대해 목표로 삼을 수 있습니다. 예를 들어 비노출군에서의 위험비, 균등하게 매칭 가능한 사람들 사이에서의 오즈비 등이 있습니다.
이러한 옵션들은 범주형 결과(categorical outcomes)로도 확장됩니다. 범주형 변수의 성격에 따라 이를 구성하는 방법은 다양합니다. 서열이 없는(non-ordinal) 범주형 변수에 대해 흔히 추정되는 효과는 결과의 한 수준을 기준 수준(reference level)으로 삼는 일련의 오즈비들입니다(예: 1 대 2의 OR, 1 대 3의 OR 등). 다항 로지스틱 회귀 모델(Multinomial regression models), 예를 들어 nnet::multinom()은 이러한 로그 오즈비들을 계수로 생성할 수 있으며, 이는 로지스틱 회귀의 확장입니다. 서열 결과(ordinal outcomes)의 경우, MASS::polr()와 같은 서열 로지스틱 회귀는 결과의 각 이전 값과 비교하는 일련의 로그 오즈비들을 계산합니다. 로지스틱 회귀와 마찬가지로, 이러한 확장 모델에서도 오즈비에만 국한되지 않으며, 각 범주의 예측 확률을 사용하여 관심 있는 효과를 계산할 수 있습니다.
환자-대조군 연구(Case-control studies)는 역학에서 전형적인 설계 방식으로, 참가자들을 결과 상태(outcome status)에 따라 샘플링합니다 (Schlesselman 1982). 결과가 발생한 ’사례(cases)’를 모집하고, 그 사례들이 나온 인구 집단으로부터 ’대조군(controls)’을 샘플링합니다. 이러한 유형의 연구는 결과가 희귀할 때 사용됩니다. 또한 노출 시점부터 사람들을 추적하는 연구보다 더 빠르고 저렴할 수 있습니다.
환자-대조군 연구에서의 샘플링 방식 때문에, 결과가 발생하지 않은 모든 개인을 파악할 수 없으므로 기준 위험(baseline risk)을 알 수 없습니다. 흥미롭게도, 여전히 오즈비는 복구할 수 있습니다. 결과가 희귀할 때 오즈비는 위험비에 근사합니다. 그러나 위험 차이는 계산할 수 없습니다.
위험 차이와 같은 절대적 척도(absolute measures)와 위험비 및 오즈비와 같은 상대적 척도(relative measures)는 처치 효과에 대해 서로 다른 관점을 제공합니다. 결과의 기준 확률(baseline probability)에 따라, 절대적 척도와 상대적 척도는 서로 다른 결론으로 이끌 수 있습니다.
기준 확률이 0.0001인 희귀한 결과(10,000개 관측치 당 1건 발생)를 생각해 봅시다. 이것이 비노출군의 확률입니다. 노출군의 결과 확률이 0.0008이라고 가정해 봅시다. 이는 비노출군보다 8배 높은 것으로, 상당한 상대적 효과입니다. 하지만 절대적 척도로 보면 0.0007에 불과합니다.
이제 기준 확률이 0.20인 더 흔한 결과를 생각해 봅시다. 노출군의 결과 확률은 0.40입니다. 이제 상대 위험도는 2인 반면, 위험 차이는 0.20입니다. 상대적 효과는 훨씬 작지만, 결과가 더 널리 퍼져 있기 때문에 더 많은 결과 사건을 만들어냅니다.
흡연이 건강에 미치는 영향이 이에 대한 훌륭한 예시입니다. 우리가 알다시피, 흡연은 폐암의 상대 위험도를 급격히 높입니다. 하지만 폐암은 꽤 희귀한 질병입니다. 흡연은 또한 심장병의 위험도 높이는데, 비록 상대적 효과는 폐암만큼 높지 않습니다. 하지만 심장병은 훨씬 더 흔합니다. 위험의 절대적 변화 때문에, 폐암으로 사망하는 사람보다 흡연 관련 심장병으로 사망하는 사람이 더 많습니다. 절대적 관점과 상대적 관점 모두 타당합니다.
확률 차이에 대한 또 다른 관점은 처치 필요 환자 수(number needed to treat, NNT) 지표입니다. 이는 단순히 위험 차이의 역수이며, 하나의 결과를 방지하거나 만들어내기 위해 필요한 노출된 개인의 수를 나타냅니다.
기준 구매 확률이 5%인 제품을 생각해 봅시다. 이는 100명 중 5명이 이 제품을 구매한다는 뜻입니다. 마케팅 팀이 광고를 만들었고, 광고를 본 사람들이 제품을 구매할 확률이 7%가 되었습니다. 제품 구매 확률의 절대적 차이는 0.02이며, 따라서 구매 횟수를 한 번 늘리기 위해 광고를 봐야 할 사람은 1 / 0.02 = 50명입니다.
NNT는 단순함 때문에 완벽한 척도는 아니지만, 처치 효과가 실제로 무엇을 의미하는지에 대해 또 다른 관점을 제공합니다.
오즈비는 로지스틱 회귀와의 연관성 때문에 편리합니다. 또한 독특한 성질을 가지고 있는데, 바로 비가산성(non-collapsible)입니다. 비가산성은 전체 표본에서의 오즈비(한계 오즈비)와 하위 그룹에서의 오즈비(조건부 오즈비)를 비교할 때, 한계 오즈비가 조건부 오즈비의 가중 평균이 아니라는 것을 의미합니다 (Didelez 와/과 Stensrud 2021; Greenland 2021a, 2021b). 이는 예를 들어 위험비가 가지고 있는 성질이 아닙니다. 예시를 살펴봅시다.
outcome, exposure, 그리고 covariate가 있다고 합시다. exposure가 outcome을 유발하고, covariate 또한 그렇습니다 1. 하지만 covariate는 exposure를 유발하지 않습니다; 즉, 교란 요인이 아닙니다. 다시 말해, outcome에 대한 exposure의 효과 추정치는 covariate를 고려하든 안 하든 동일해야 합니다.
library(ggdag)
dagify(
  outcome ~ exposure + covariate,
  coords = time_ordered_coords()
) |>
  ggdag(use_text = FALSE) +
  geom_dag_text_repel(aes(label = name), box.padding = 1.8, direction = "x") +
  theme_dag()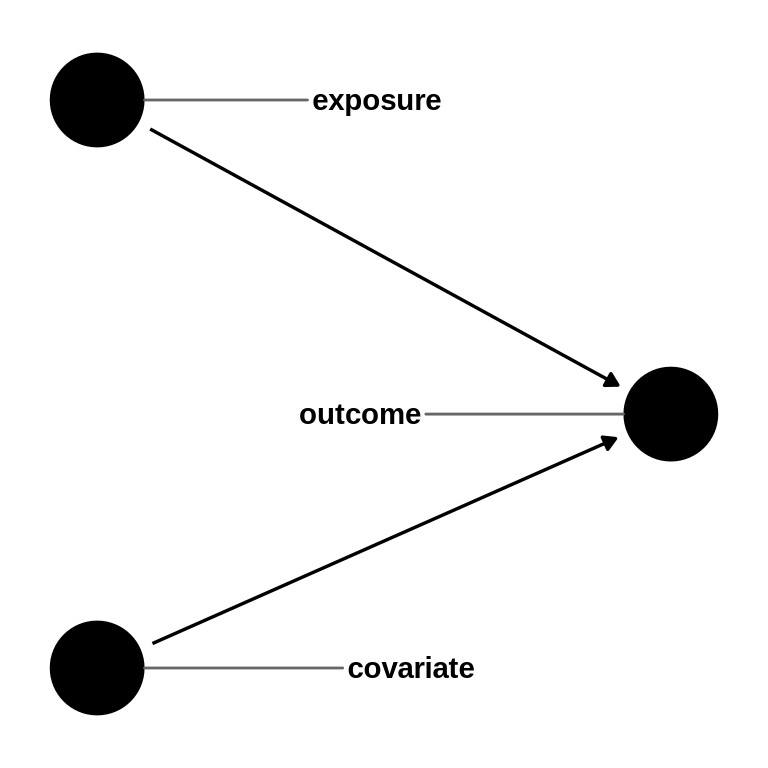
outcome, exposure, covariate 사이의 인과 관계를 보여주는 DAG. exposure와 covariate 모두 outcome을 유발하지만, exposure와 covariate 사이에는 아무런 관계가 없습니다. 로지스틱 회귀에서 노출에 대한 오즈비는 공변량의 층 전반에 걸쳐 비가산적일 것입니다.
이를 시뮬레이션해 봅시다.
먼저, 모든 사람에 대해 exposure와 outcome 사이의 관계를 살펴봅시다.
table(exposure, outcome) outcome
exposure 0 1
0 2036 3021
1 1115 3828이 빈도표를 사용하여 오즈비를 계산할 수 있습니다: ((3828 * 2036) / (3021 * 1115)) = 2.31.
이 오즈비는 로지스틱 회귀를 사용하고 결과를 지수화했을 때 얻는 결과와 같습니다.
# A tibble: 2 × 5
  term        estimate std.error statistic  p.value
  <chr>          <dbl>     <dbl>     <dbl>    <dbl>
1 (Intercept)     1.48    0.0287      13.8 4.33e-43
2 exposure        2.31    0.0445      18.9 2.87e-79
이는 시뮬레이션 모델 계수인 exp(1)에서 약간 벗어나 있습니다. 우리가 covariate를 추가하면 더 가까워집니다.
# A tibble: 3 × 5
  term        estimate std.error statistic   p.value
  <chr>          <dbl>     <dbl>     <dbl>     <dbl>
1 (Intercept)    0.614    0.0378     -12.9 6.07e- 38
2 exposure       2.78     0.0493      20.7 1.33e- 95
3 covariate 7.39 0.0529 37.8 1.04e-312covariate는 교란 요인이 아니므로, 원칙적으로 exposure에 대한 효과 추정치에 영향을 주어서는 안 됩니다. covariate에 따른 조건부 오즈비(conditional odds ratios)를 살펴봅시다.
table(exposure, outcome, covariate), , covariate = 0
outcome
exposure 0 1
0 1572 986
1 951 1589
, , covariate = 1
outcome
exposure 0 1
0 464 2035
1 164 2239covariate = 0인 사람들에 대한 오즈비는 2.66입니다. covariate = 1인 사람들에 대한 오즈비는 3.11입니다. 한계 오즈비인 2.31는 이 두 값 모두보다 작습니다!
한계 위험비(marginal risk ratio)는 1.3입니다. covariate = 0인 사람들의 위험비는 1.62입니다. covariate = 1인 사람들의 위험비는 1.14입니다. 이 경우, 한계 위험비는 covariate의 층(strata) 전반에 걸쳐 가산적(collapsible)인 가중 평균입니다 (Huitfeldt, Stensrud, 와/과 Suzuki 2019).
covariate를 추가했을 때 오즈비가 변하고 시뮬레이션의 모델 계수에 더 가까워지기 때문에 이를 반드시 포함해야 한다고 생각하기 쉽습니다. 여기서 중요한 세부 사항은 비가산성(non-collapsibility)이 편향이 아니라는 점입니다. 일부 저자들은 이를 누락 변수 편향(omitted variable bias)으로 설명하기도 하지만, covariate가 교란 요인이 아니기 때문에 한계 오즈비와 조건부 오즈비는 둘 다 옳습니다. 그들은 단순히 서로 다른 추정 대상일 뿐입니다. 조건부 오즈비는 covariate에 조건부화된 오즈비입니다. 이를 다른 오즈비와 유의미하게 비교하려면, 그 오즈비들도 covariate에 조건부화되어야 합니다. 비가산성은 오즈(odds)의 수치적 속성입니다; 그것은 편향을 만들기보다는 조금 더 미묘한 해석을 필요로 하게 만듭니다. 비가산성이 정확히 어떻게 작동하는지는 데이터 생성 메커니즘이 가산적(additive) 척도에서 일어나는지 아니면 승법적(multiplicative) 척도에서 일어나는지에 따라서도 달라집니다; 승법적 척도에서는(우리의 시뮬레이션처럼) 결과와 강하게 관련된 변수를 제거하면 효과 추정치가 변하는 반면, 가산적 척도에서는 결과와 강하게 관련된 변수를 추가하면 비록 그 정도는 작지만 효과가 변합니다 (Whitcomb 와/과 Naimi 2020). 어떤 버전의 오즈비가 맞는지 걱정하기보다는, 편향되지 않은 추정치를 위해 필수적인 교란 요인들과 분산 감소에 도움이 되는 결과의 예측 요인들에 집중할 것을 권장합니다.
오즈비와 위험비, 그리고 상대적 척도와 절대적 척도 사이의 논의는 활발히 이루어져 왔습니다. 우리는 이진 결과에서 오즈비, 위험비, 위험 차이라는 세 가지 측정치를 기준 확률과 함께 모두 제시하기를 제안합니다. 각각은 인과 효과에 대해 서로 다른 관점을 제공합니다. 추정치에 포함된 처치 그룹을 고려하여 이를 해석하도록 주의하십시오. 예를 들어 ATT 가중치로 구한 평균 위험 차이는 처치군에서의 평균 위험 차이를 뜻합니다.
선형 확률 모델(linear probability model)은 이진 결과에서 처치 효과를 추정하는 흔한 방법 중 하나입니다. 선형 확률 모델은 계량경제학 등 여러 분야에서 표준으로 사용됩니다. 기본적으로 OLS와 같지만 잔차의 분산에 이질성(heterogeneity)이 있어 보통 로버스트 표준 오차를 함께 활용합니다. 결과는 가산적 측정치인 위험 차이로 나타납니다.
lm(outcome ~ exposure)
Call:
lm(formula = outcome ~ exposure)

Coefficients:
(Intercept)     exposure
      0.597        0.177
선형 확률 모델은 가산적 척도에서 관계를 모델링하는 편리한 방법입니다. 하지만 로지스틱 회귀가 0과 1 사이로 결과가 제한되는 반면, OLS는 그렇지 않다는 중대한 문제점이 있습니다. 즉, 개별 예측값이 0보다 작거나 1보다 클 수 있는데 이는 확률상 불가능한 값입니다.
우리는 sec-g-comp장에서 로지스틱 회귀를 사용하여 위험 차이를 계산하는 대안적인 방법을 살펴볼 것입니다.
만약 exposure와 outcome 사이에 관계가 없다면, 둘 사이의 관계는 무효(null)가 될 것이고, covariate의 유무와 상관없이 오즈비는 가산적일 것입니다.↩︎