데이터 시각화를 하는 이유
동기
데이터 시각화는 데이터의 패턴을 식별하고 메시지를 전달하는 매우 효율적인 수단이 될 수 있습니다. 모든 시각화의 과학적 목표는 독자가 데이터를 이해하고 정보를 추출할 수 있도록 하는 것입니다:
직관적으로;
효율적으로; 그리고
정확하게.
시각화를 만들 때는 독자나 의도된 청중의 배경을 고려하는 것이 중요합니다(Krause 2013). 해석은 보는 사람의 눈에 달려 있으며, 시각화는 청중을 염두에 두고 디자인할 때만 메시지 전달에 성공할 수 있습니다.
성공적인 데이터 시각화는 다음과 같은 효과가 있습니다:
- 주의를 끕니다
-
수많은 텍스트 속에서 시각화는 눈에 띕니다. 독자가 시간이 부족하거나 문서가 흥미로운지 확신할 수 없는 경우, 시선을 사로잡는 시각화는 독서의 시작을 유도할 수 있습니다.
- 정보 접근성 향상
-
텍스트 설명은 길고 읽기 어려울 수 있는 반면, 능숙하게 만든 시각화는 핵심 정보를 더 효율적으로 추출할 수 있게 하여 정보 추출을 즐거운 작업으로 만듭니다.
- 정밀도 증가
-
텍스트 설명은 데이터 포인트와 해당 축을 보여주는 시각적 묘사보다 덜 정확한 경우가 많으며, 정확한 숫자가 너무 많은 텍스트는 논의의 흐름을 따라가기 어렵게 만들 수 있습니다.
- 신뢰성 강화
-
텍스트 요약은 이야기를 제공하지만, 데이터 시각화는 입증되지 않은 주장에 신뢰성을 더할 수 있습니다. 독자는 숫자를 직접 확인하고 (동일한?) 결론에 도달할 수 있습니다.
- 콘텐츠 요약
-
시각적 디스플레이는 복잡한 텍스트 콘텐츠를 요약할 수 있게 하여 독자가 요점을 기억하는 데 도움을 줍니다.
이러한 이유로 데이터 시각화는 과학 논문, 언론 보도, 컨퍼런스 발표, 소셜 미디어 게시물, 비디오 요약 등 거의 모든 종류의 간행물에서 핵심 요소입니다.
표 역시 데이터나 통계를 시각화하는 방법이며, 간행물의 유사하게 중요한 구성 요소가 될 수 있습니다. 어떤 경우에는 표가 그래픽보다 데이터를 더 잘 시각화할 수도 있습니다. 예를 들어, 5개의 숫자는 색상, 각도, 그리고 경우에 따라 음영과 2차원 이상을 사용하는 복잡한 파이 차트보다는 표에 표시하는 것이 더 나을 것입니다.
데이터 시각화의 간략한 역사
데이터 시각화는 오랫동안 과학 연구 주제이자 다양한 고부가가치 응용 분야를 가진 진화하는 예술 형식이었습니다.
1859년 현대 간호학의 창시자인 플로렌스 나이팅게일(Florence Nightingale)은 러시아와의 전쟁 중 영국군의 위생 상태에 대한 연구 결과를 발표했습니다. 그녀는 표와 차트로 원본 데이터와 요약 통계를 보여주었습니다(Nightingale, 1859). 특히 하나의 차트가 오늘날까지 기념되고 있는데, 바로 “동부 군대의 사망 원인에 대한 다이어그램”이라는 극좌표 영역 차트(polar area chart)입니다.
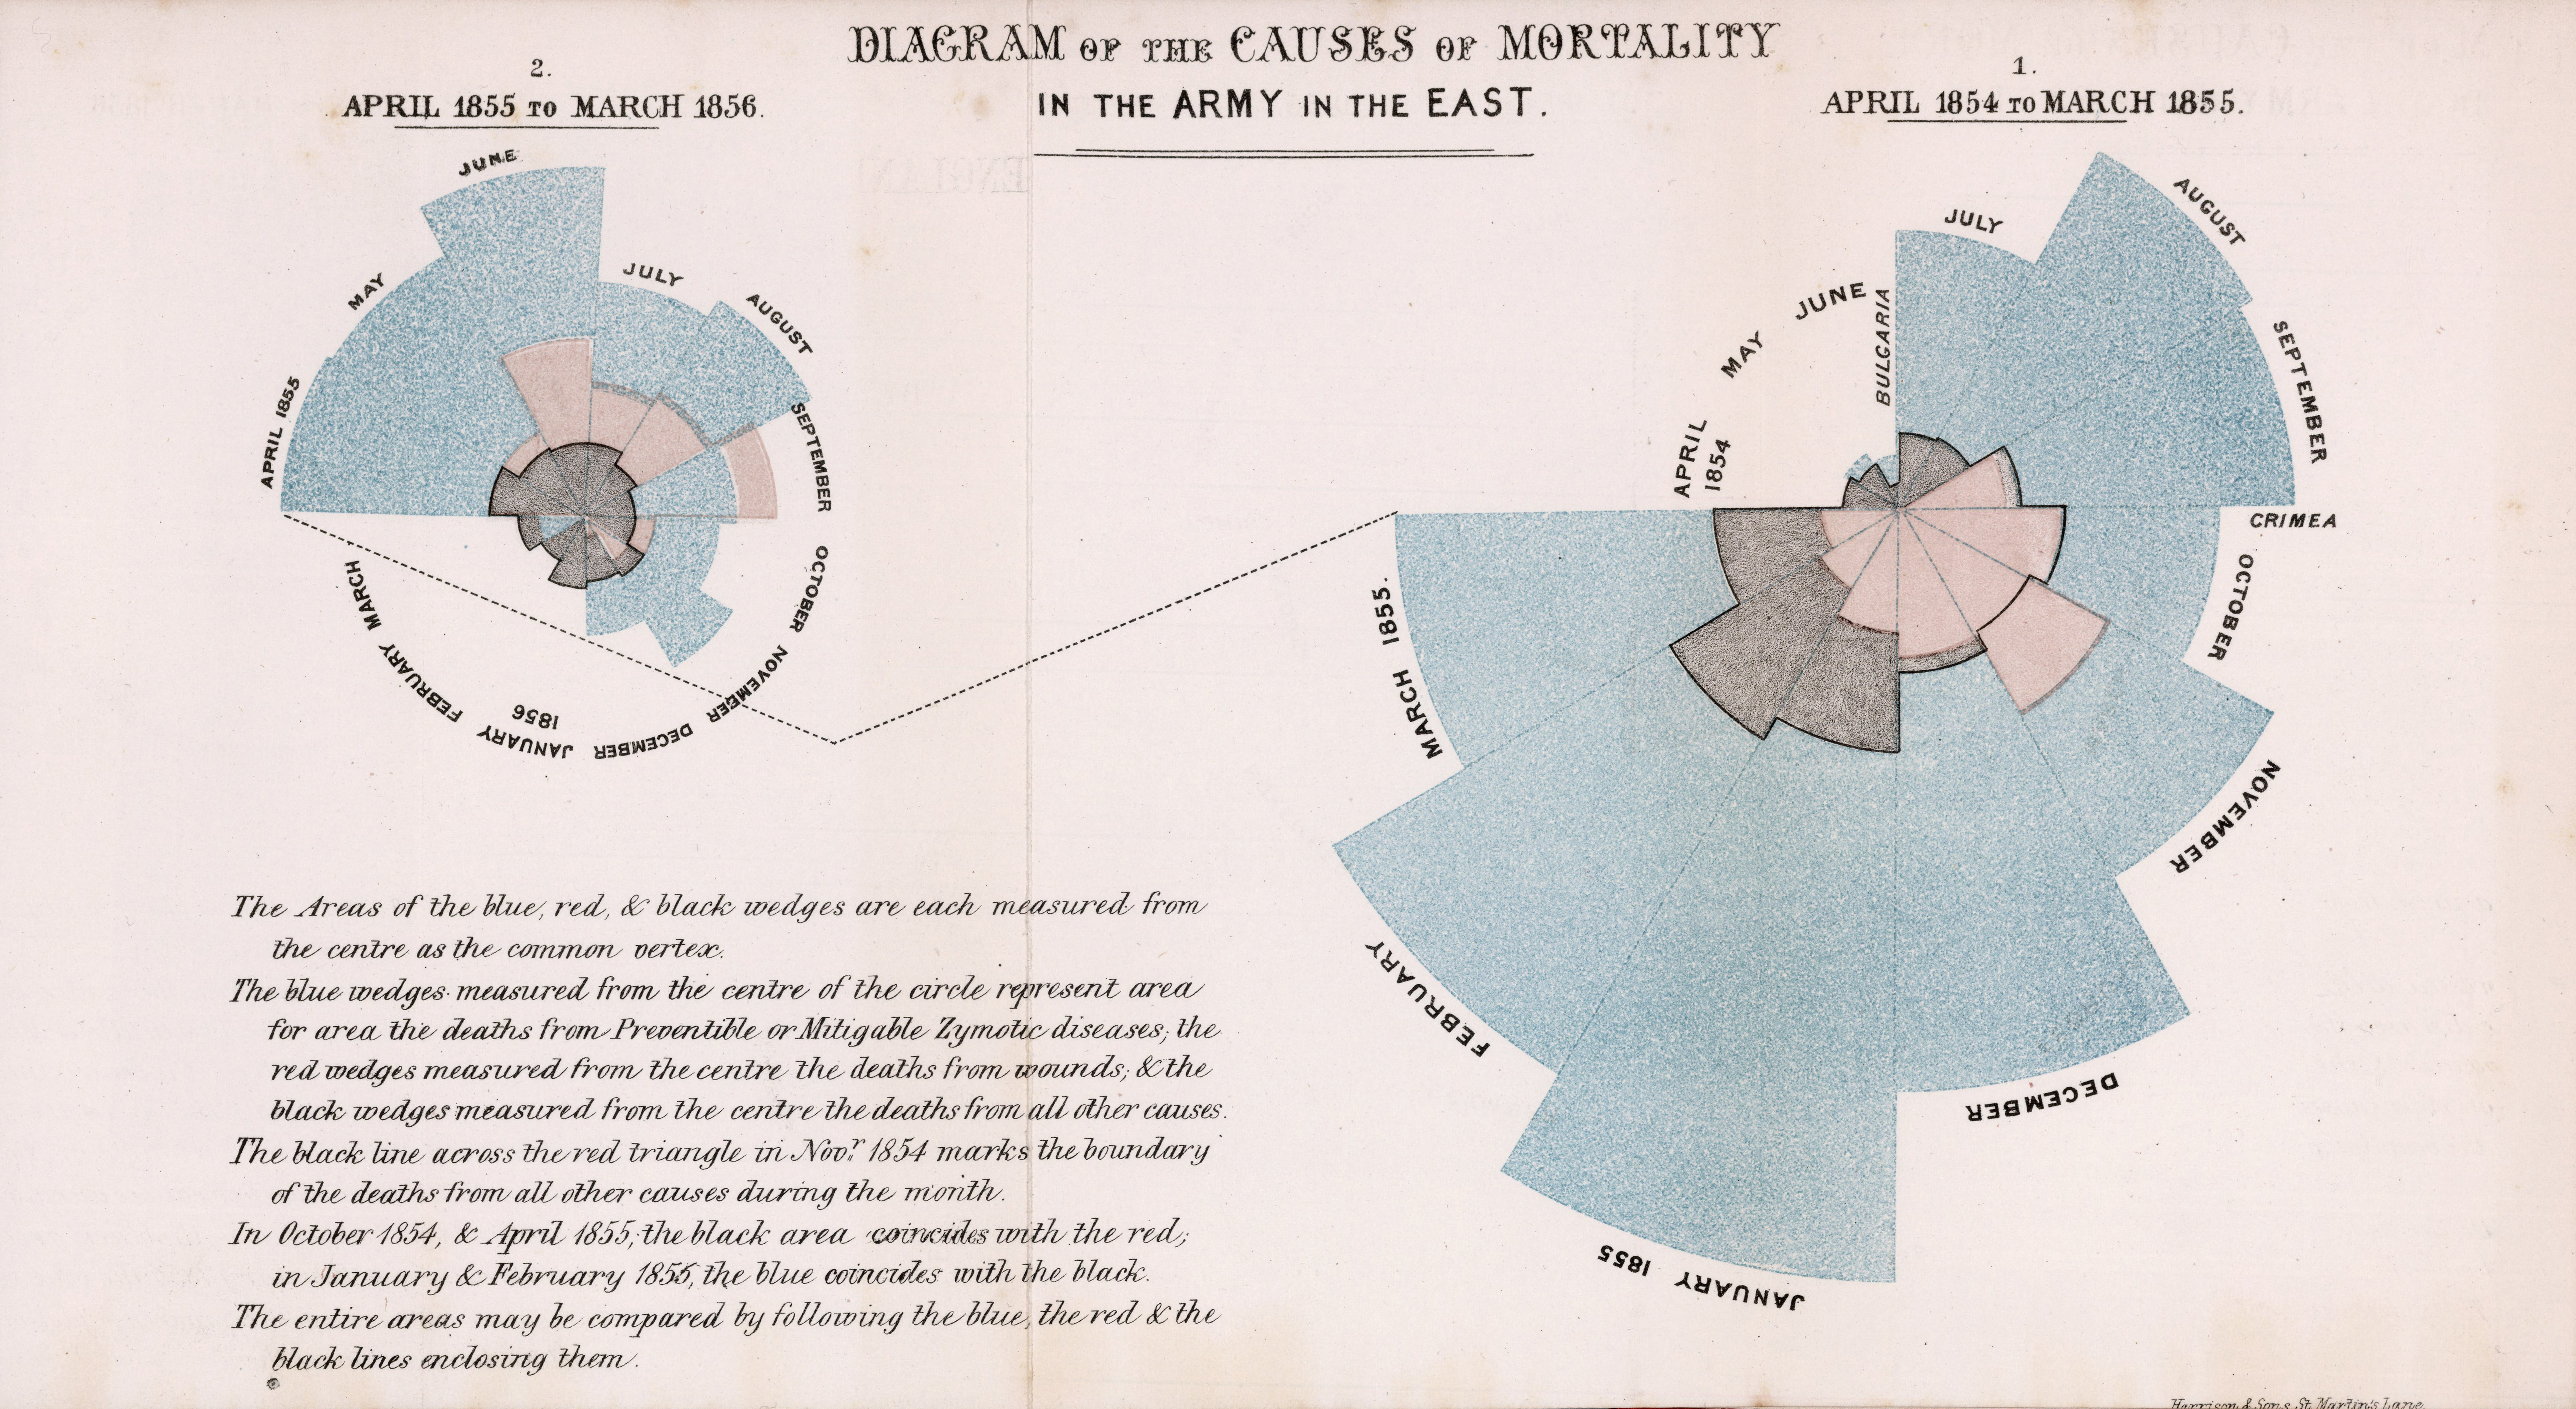
나이팅게일의 그래프를 “특히 상징적으로 만든 것은 데이터에 대한 주장을 펼치기 위해 시각적 수사학을 강력하게 사용했다는 점”입니다(Hedley 2020). 이러한 특성은 나이팅게일의 동시대인들이 만든 다른 시각화에서도 분명하게 나타납니다.
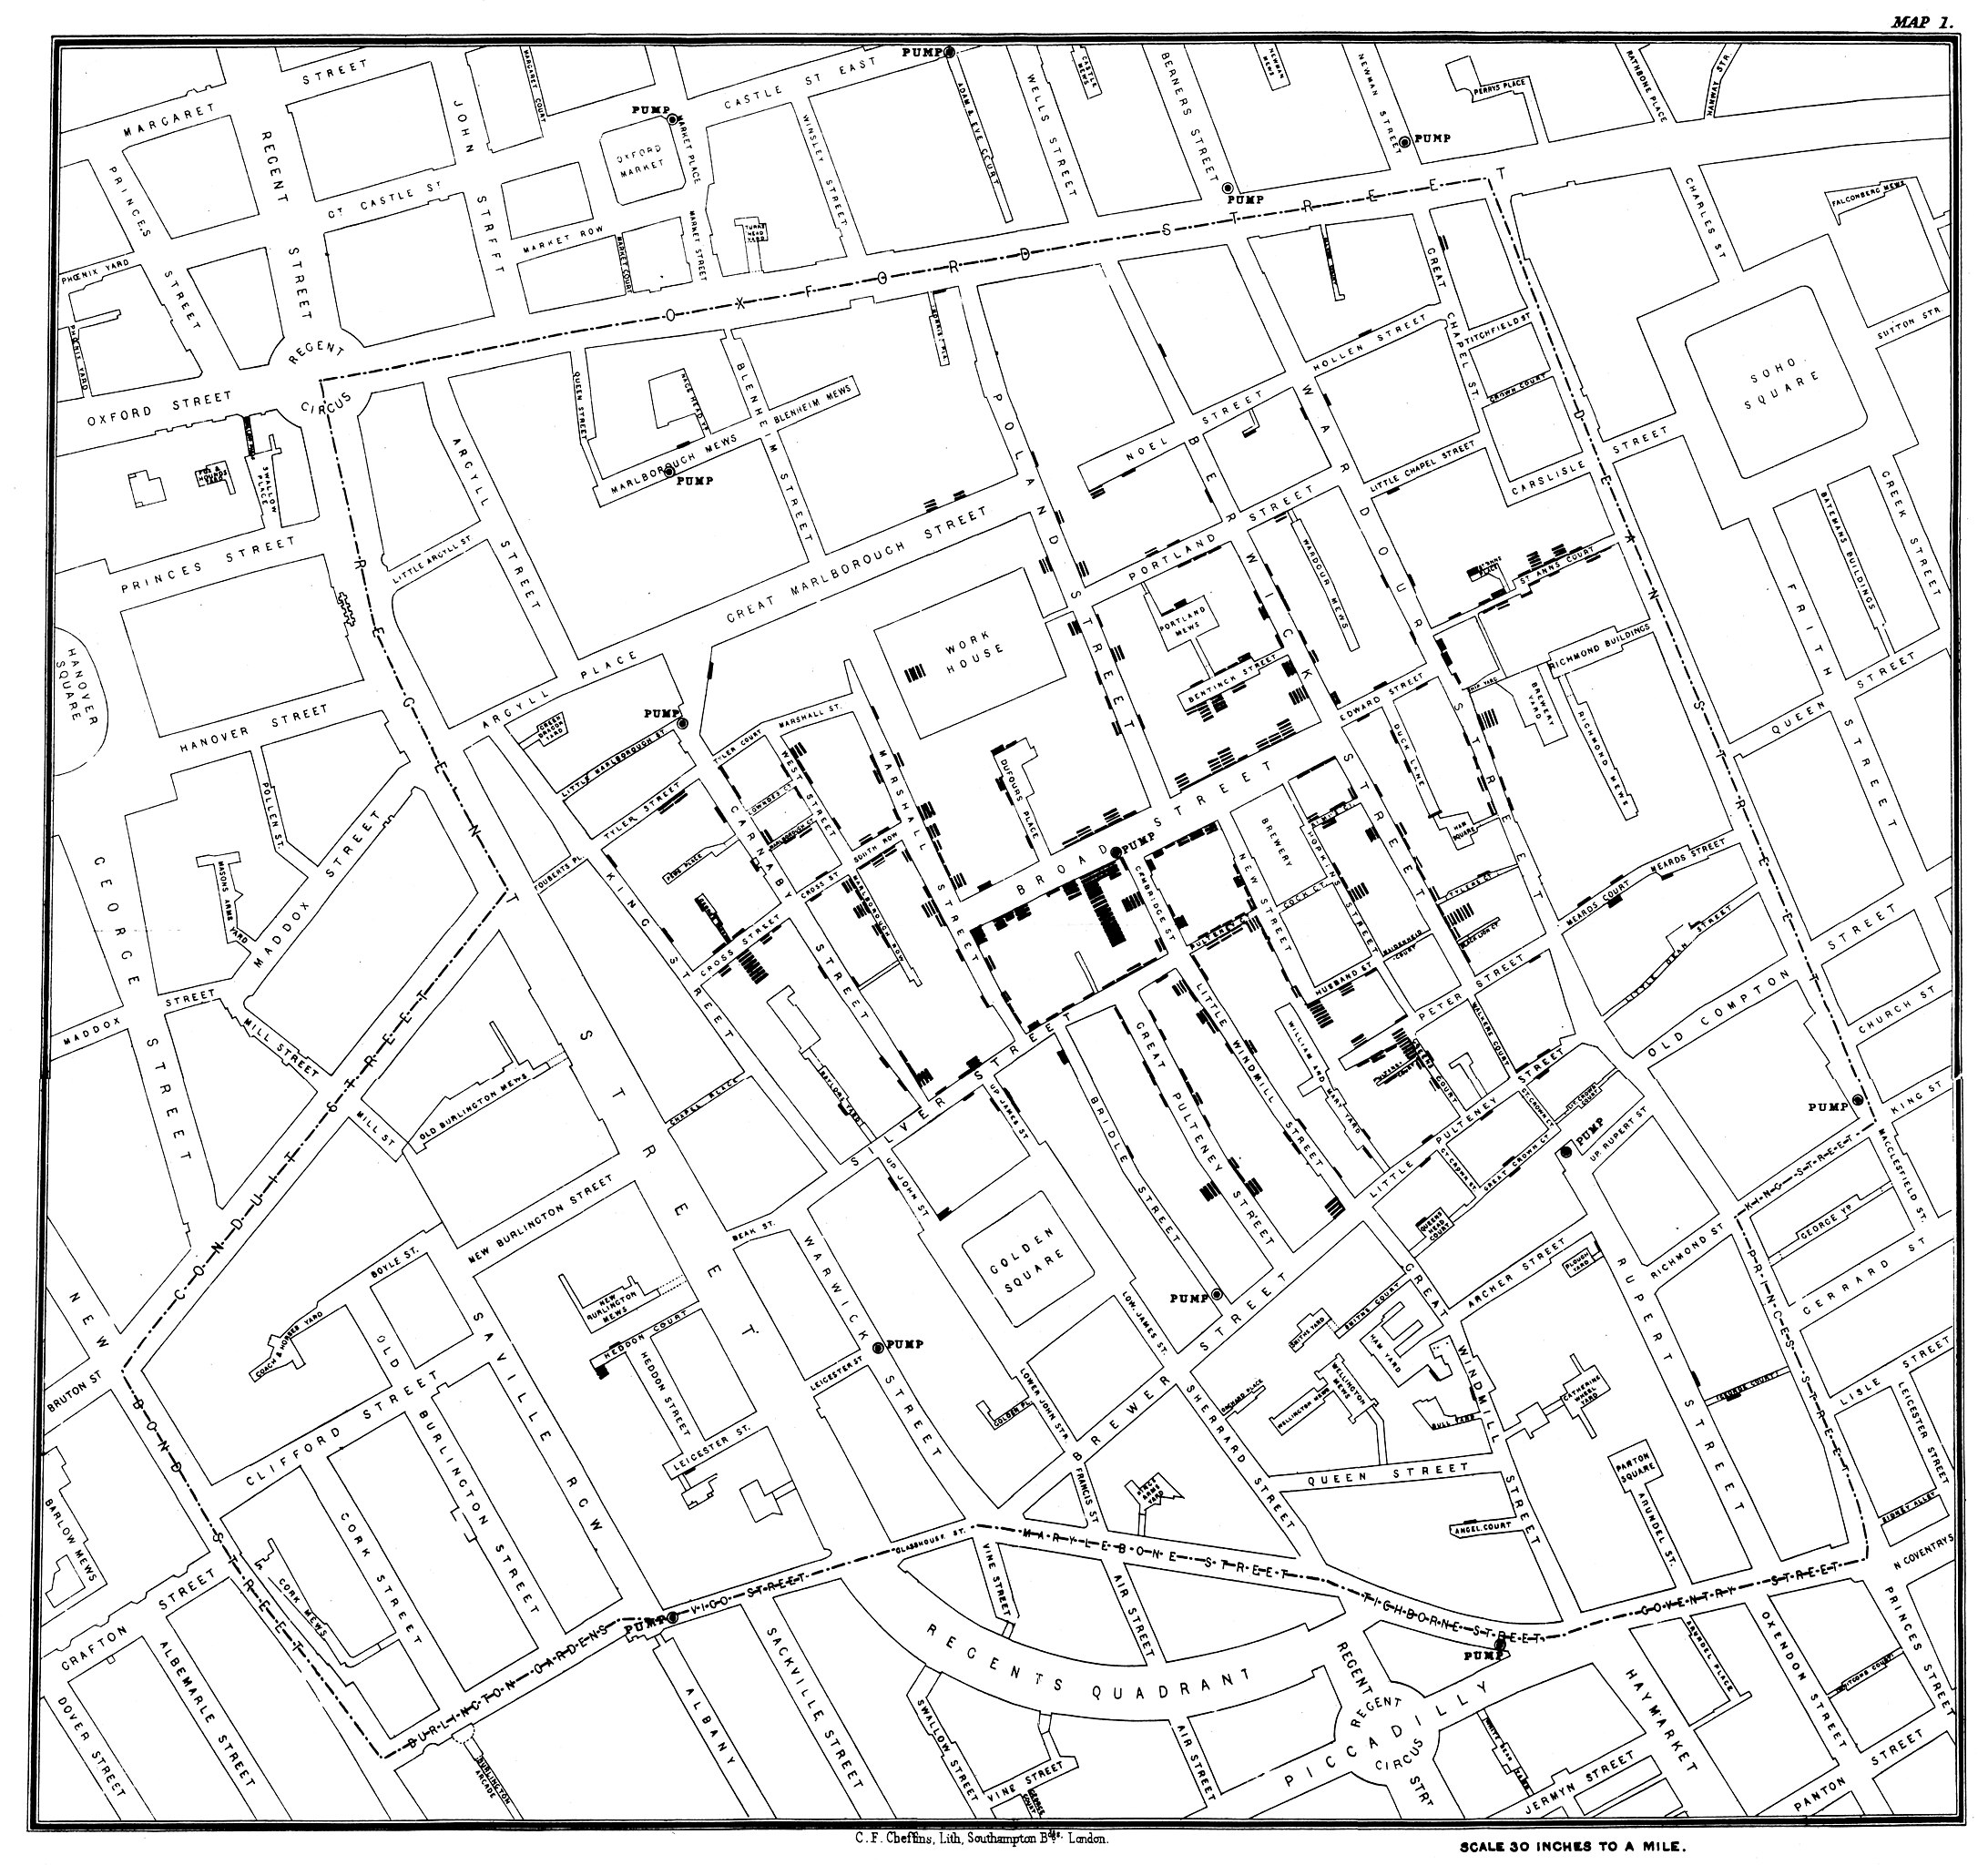
콜레라 전파와 관련된 런던의 물 펌프에 대한 단순하지만 꽤 영향력 있는 시각화는 근본 원인 규명의 길을 열었습니다. 의사 존 스노우(John Snow)는 콜레라 사망자에 대한 데이터를 수집하고 해당 런던 주소에 사망자 수를 막대 높이로 나타낸 시각화를 만들었습니다. 이 시각화는 사망자가 브로드 스트리트(Broad Street) 주변에 밀집되어 있음을 보여주었고, 이를 통해 콜레라 전파의 원인인 브로드 스트리트 물 펌프를 식별하는 데 도움을 주었습니다(Snow 1854; Wikipedia contributors 2023).
초기의 복잡한 시각화는 1861년 미나르(Minard)가 1812/13년 나폴레옹의 모스크바 진군과 이후의 퇴각 데이터를 묘사하여 만들었습니다.

지도는 군대가 이동함에 따라 위도와 경도를 보여줍니다. 선은 이동 방향을 나타내며 선의 너비는 군대의 규모(생존한 군인 수)를 나타냅니다. 특정 위치는 군대가 있었던 날짜로 표시되었으며 온도도 함께 표시됩니다. 6개의 변수가 단일 디스플레이에 우아하게 엮여 있습니다(Tufte 2001; Corbett 2001; Robinson 1967).
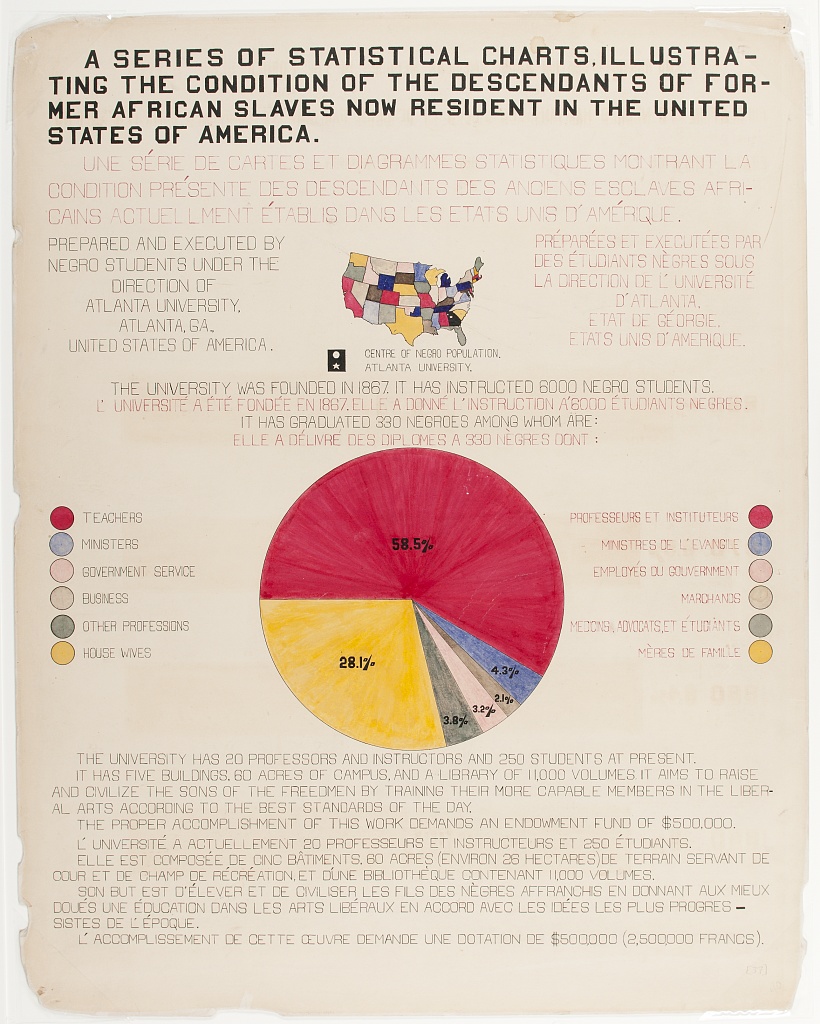
1900년 파리 박람회에서 W. E. B. Du Bois는 흑인 미국인들의 생활상을 보여주는 그래프, 차트, 지도를 전시했습니다(Du Bois 1900; Battle-Baptiste and Rusert 2018).
현대 시각화의 획기적인 작업은 튜키의 책 탐색적 데이터 분석(Exploratory Data Analysis)(Tukey 1977)과 에드워드 터프티(Edward Tufte)(Tufte 1990, 2004, 2006)에 의해 제공되었습니다.
시각화의 역사적 발전은 마이클 프렌들리(Michael Friendly)의 다양한 간행물(Friendly and Denis 2005; Friendly 2018, 2022)에서 제공됩니다.
컴퓨터가 등장하기 전까지 데이터는 손으로 시각화했습니다. 최초의 모니터와 프린터는 텍스트 모드로만 작동했으며 25행 80열 정도의 해상도로 많은 세부 사항이나 정밀도를 허용하지 않았습니다. 그래픽 터미널과 도트 매트릭스 프린터가 뒤를 이었고 레이저 프린터의 개발과 함께 해상도는 계속 증가했습니다.
SAS와 같은 통계 시스템은 일찍부터 데이터 시각화 생성을 가능하게 했습니다(“Documentation” n.d.).
아마도 가장 일관된 그래픽 시스템의 구현은 윌킨슨(Wilkinson)의 The Grammar of Graphics(Wilkinson 2005)에 기반한 ggplot(Wickham 2011, 2016)으로 실현되었을 것입니다.
ggplot2의 핵심 구성 요소는 조건부 디스플레이를 생성하는 기능입니다. 이를 통해 하나 이상의 변수 값으로 데이터를 부분 집합화할 수 있습니다. 이 개념은 클리블랜드(Cleveland)(Cleveland 1993, 1994)가 도입했으며, 널리 알려진 보리 데이터 세트를 선보였습니다. 이 데이터 세트는 6개 농장 중 한 곳에서 두 해 동안의 작물 수확량이 실수로 뒤바뀐 사실이 시각화를 통해 강력하게 시사될 때까지 수십 년 동안 교과서에서 분석되었습니다. 수많은 수치 분석이 놓친 것을 시각화가 밝혀낸 것입니다!
클리블랜드는 자신의 정원에 있는 격자 구조물(trellis)에서 영감을 받아 디스플레이 유형을 “trellis”라고 명명했습니다(Cleveland 1993). Trellis 개념은 S(Becker and Chambers 1984)와 S-PLUS(Becker and Cleveland 1996)에서 처음 구현되었습니다. 1980년대 뉴질랜드 오클랜드에서 로버트 젠틀맨(Robert Gentleman)과 로스 이하카(Ross Ihaka)가 R(R Core Team 2021)을 개발했을 때, “trellis”가 상표(Lucent와 이후 MathSoft)로 등록되어 있었기 때문에 lattice라는 패키지가 개발되었습니다(Sarkar 2008). ggplot의 등장으로 패싯(faceting, facet_grid 및 facet_wrap 함수 사용)이라는 용어가 “lattice”와 그 “패널(panels)”을 대체했습니다.